何ができるか
たとえば、顧客ごとの売上データがあったとします。予測対象は売上で、属性として職業、性別、年齢の列があります。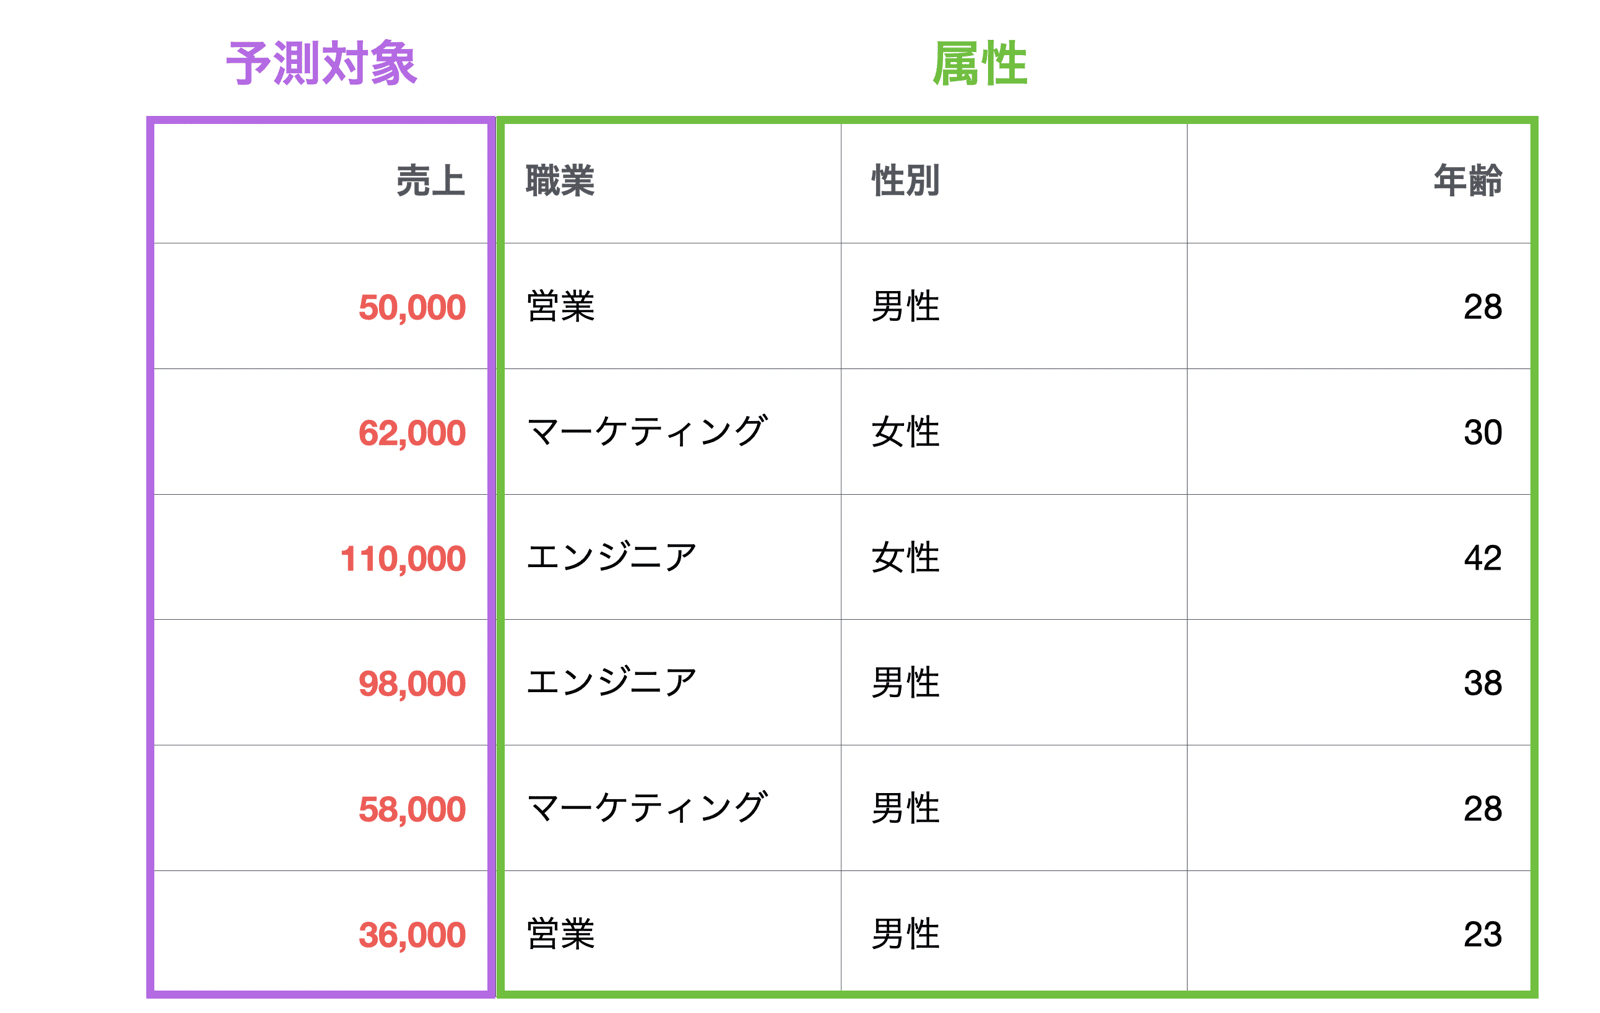
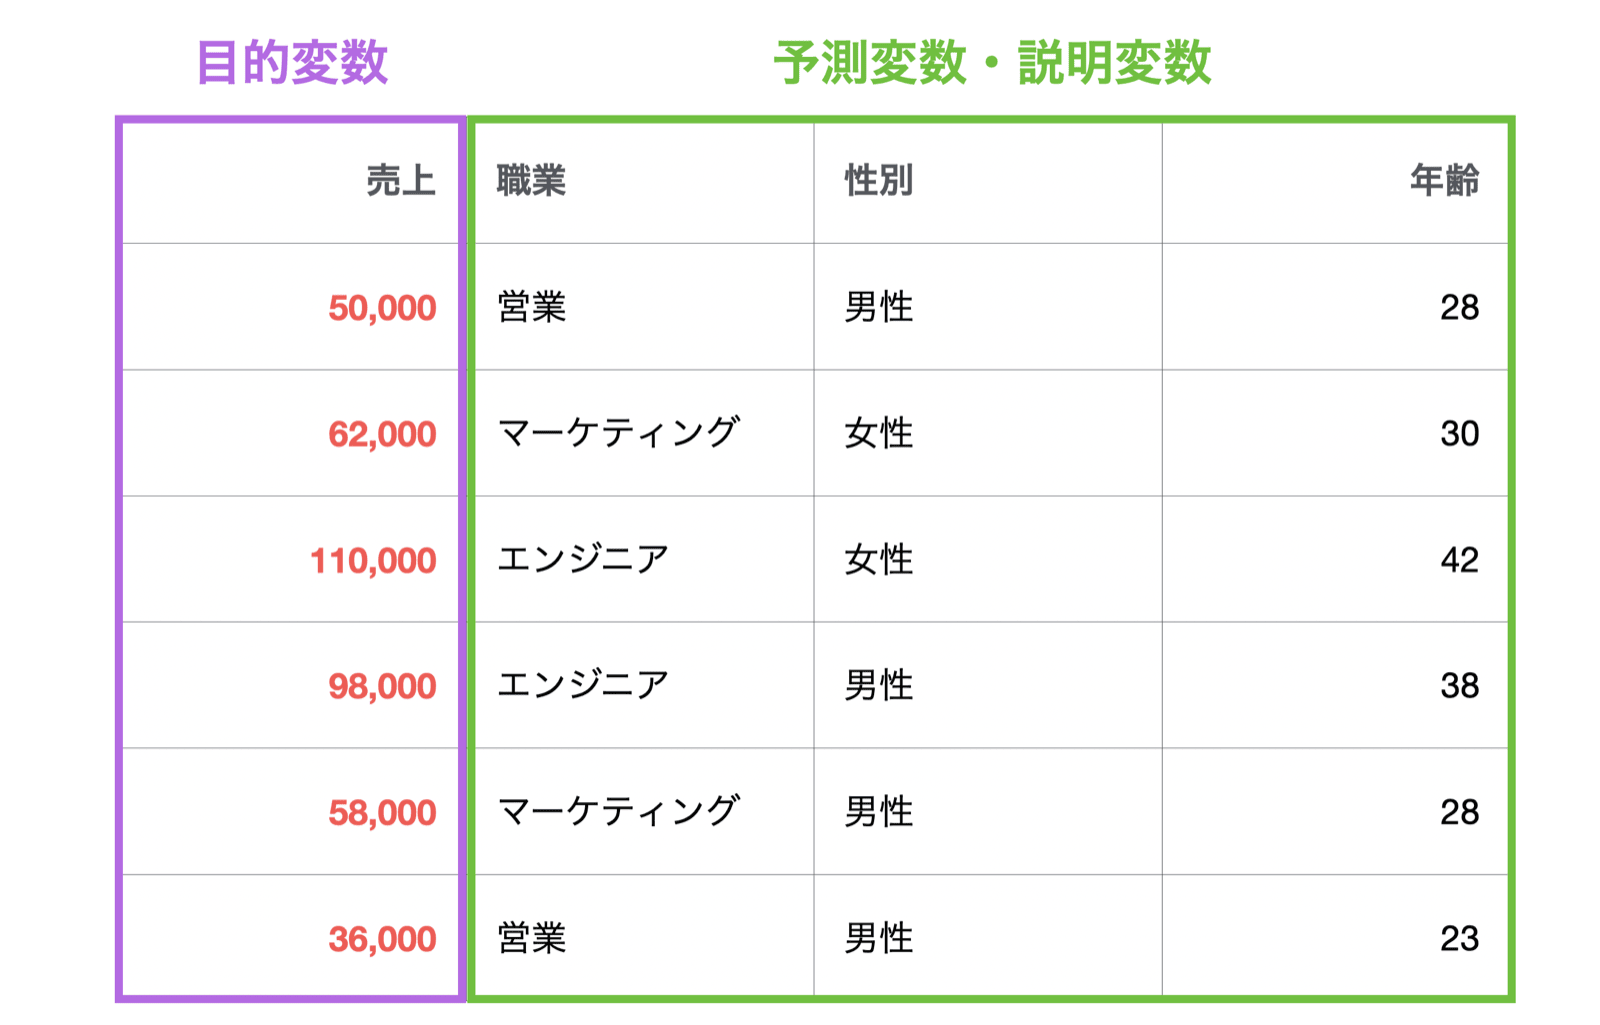
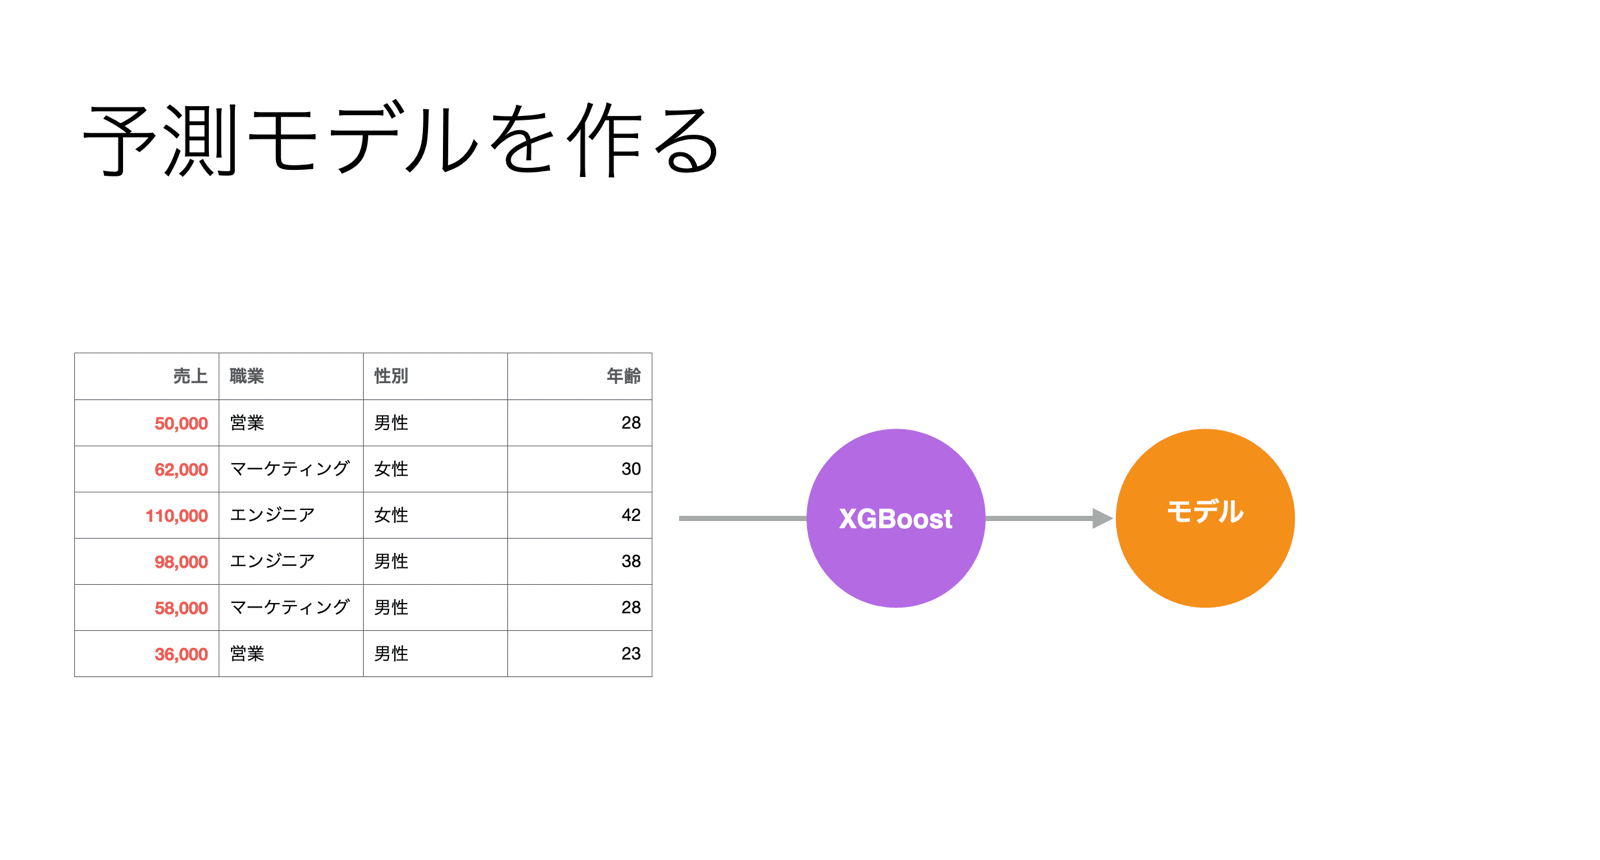
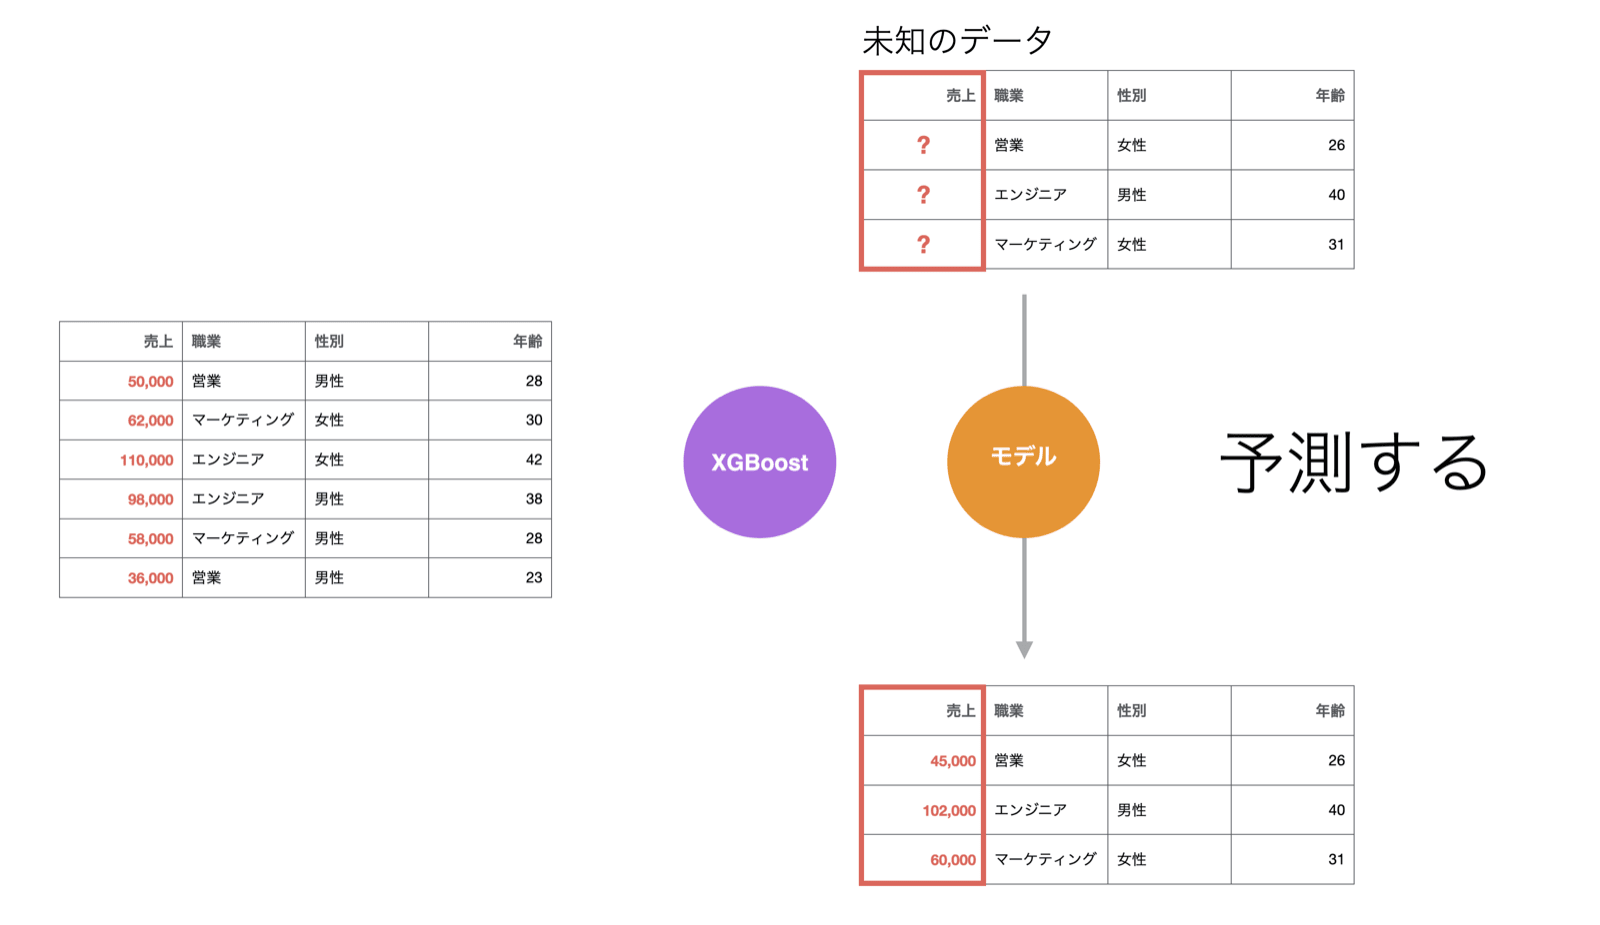
- 目的変数と関係の強い変数はどれか。
- 変数の値が変わると、目的変数の値はどのように変わるか。
- このモデルでは、目的変数の動きのどれくらいを説明できるのか。
必要なデータの形式
XGBoostを実行する際には、1行が1観測対象となっているデータを使う必要があります。 目的変数には数値型、ロジカル型のどちらも扱うことができます。説明変数におけるデータタイプには特に縛りはありません。しかし、説明変数同士の相関が強い場合は影響度を取り合ってしまい、変数重要度の順番が低く見積もられることがあります。サンプルデータ
今回はサンプルデータとして、従業員データを使用していきます。 このデータは1行が1従業員のデータで、列には年齢や給料、職種など従業員の属性を表す列があります。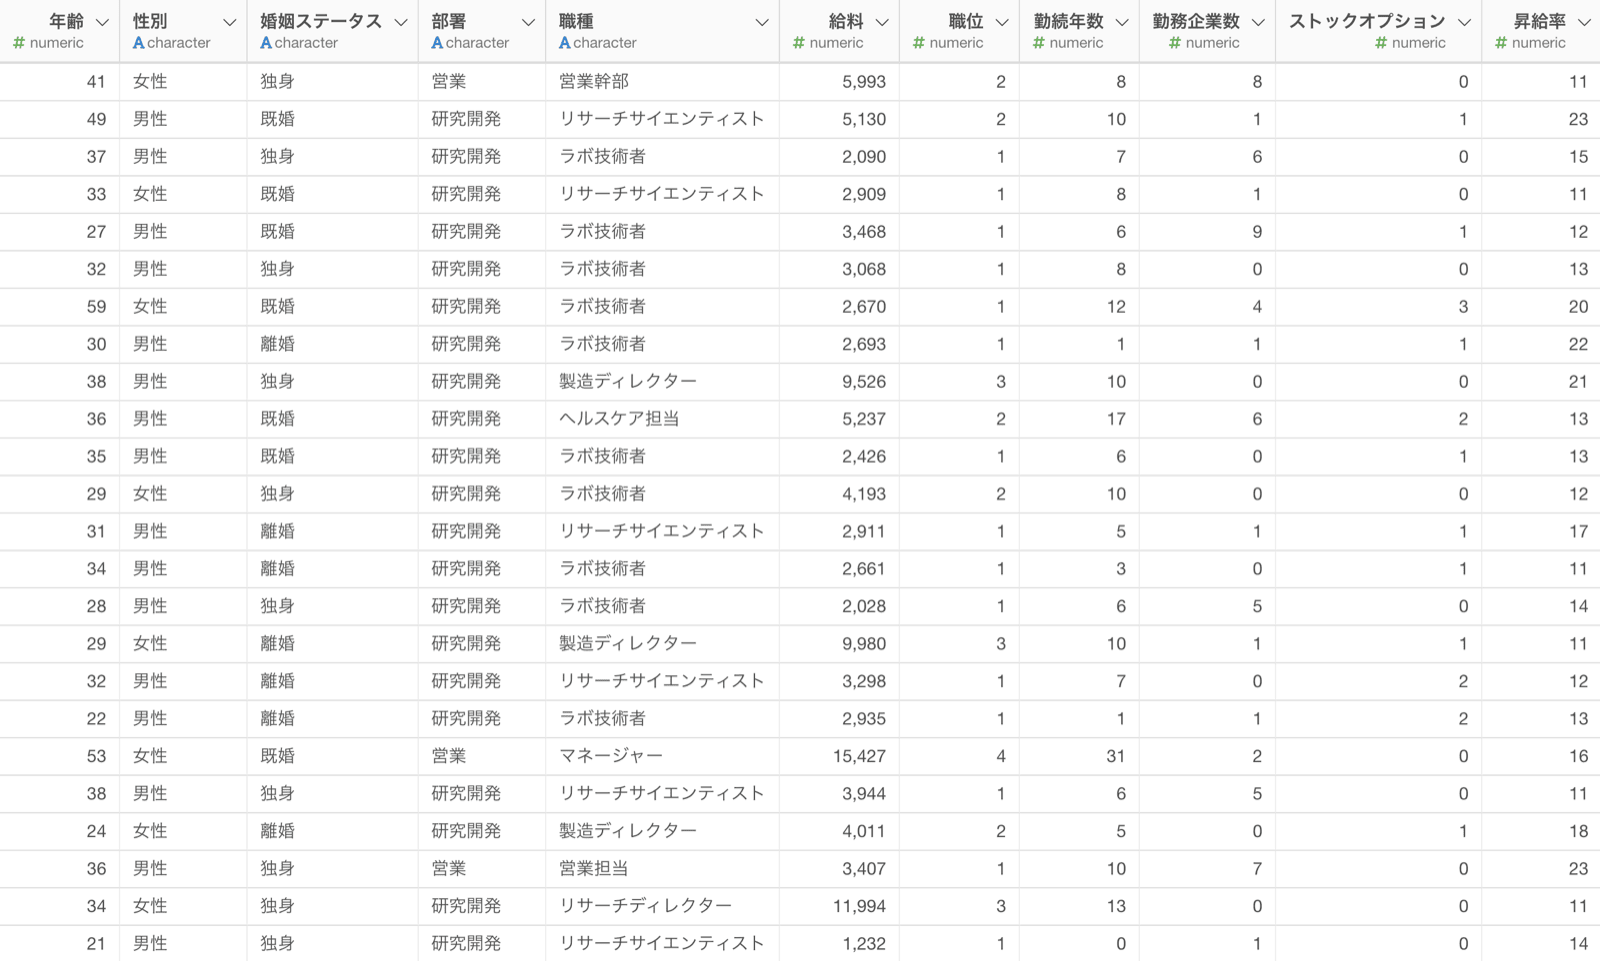
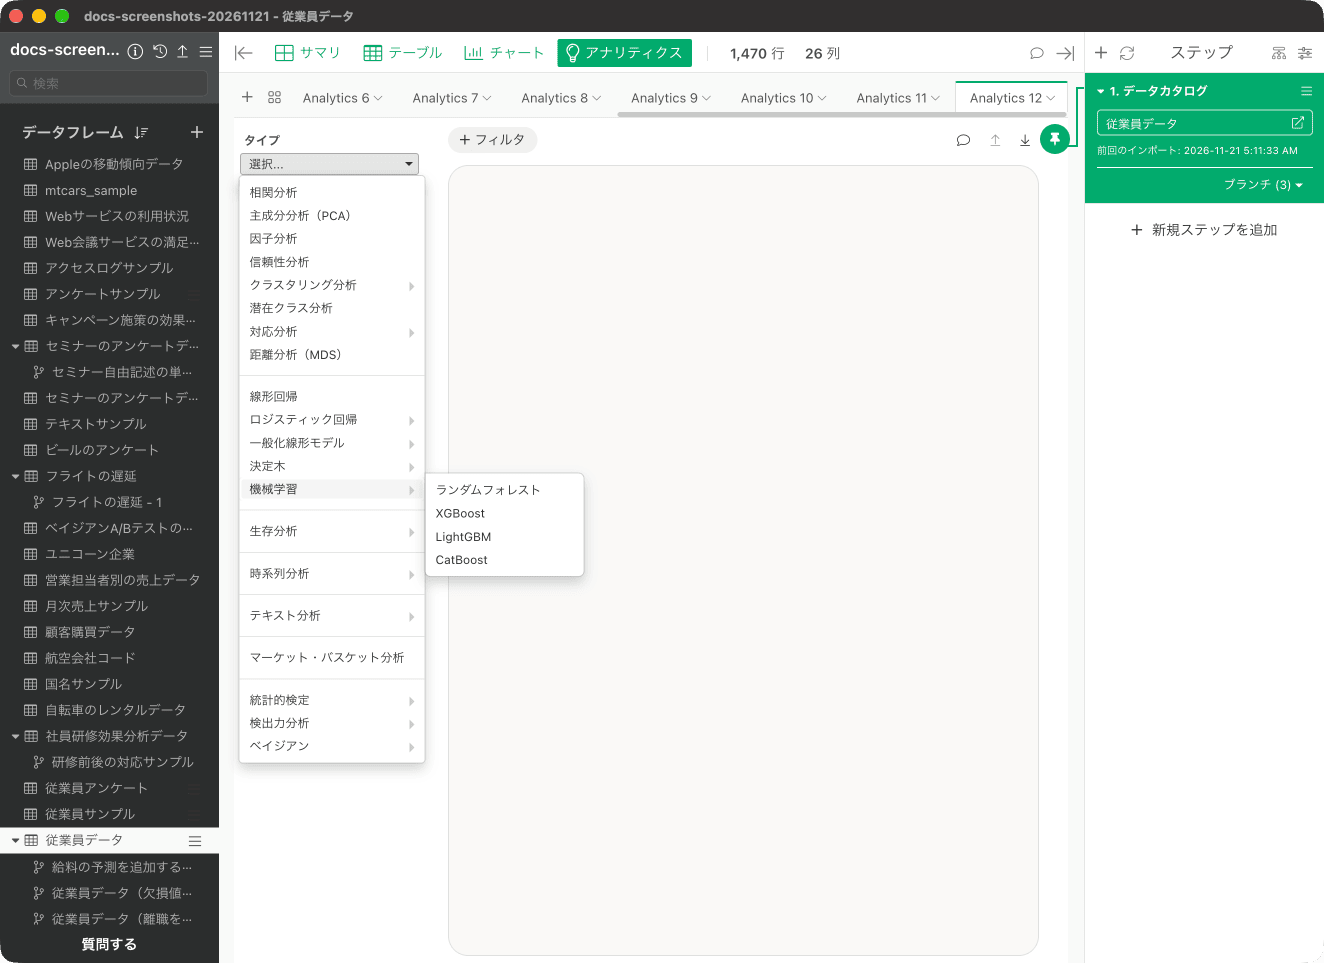
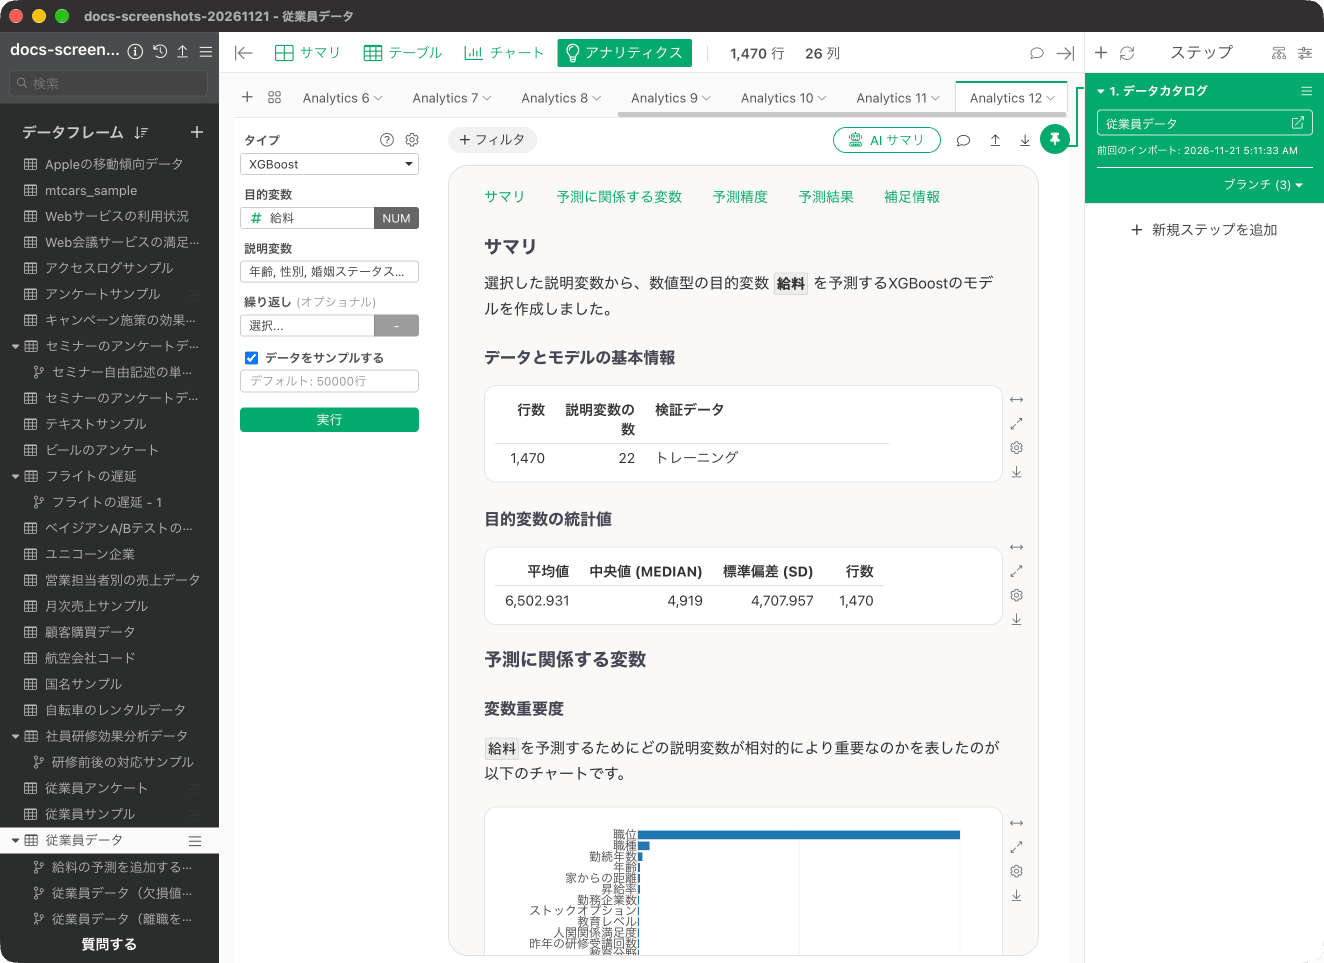
XGBoostを実行する
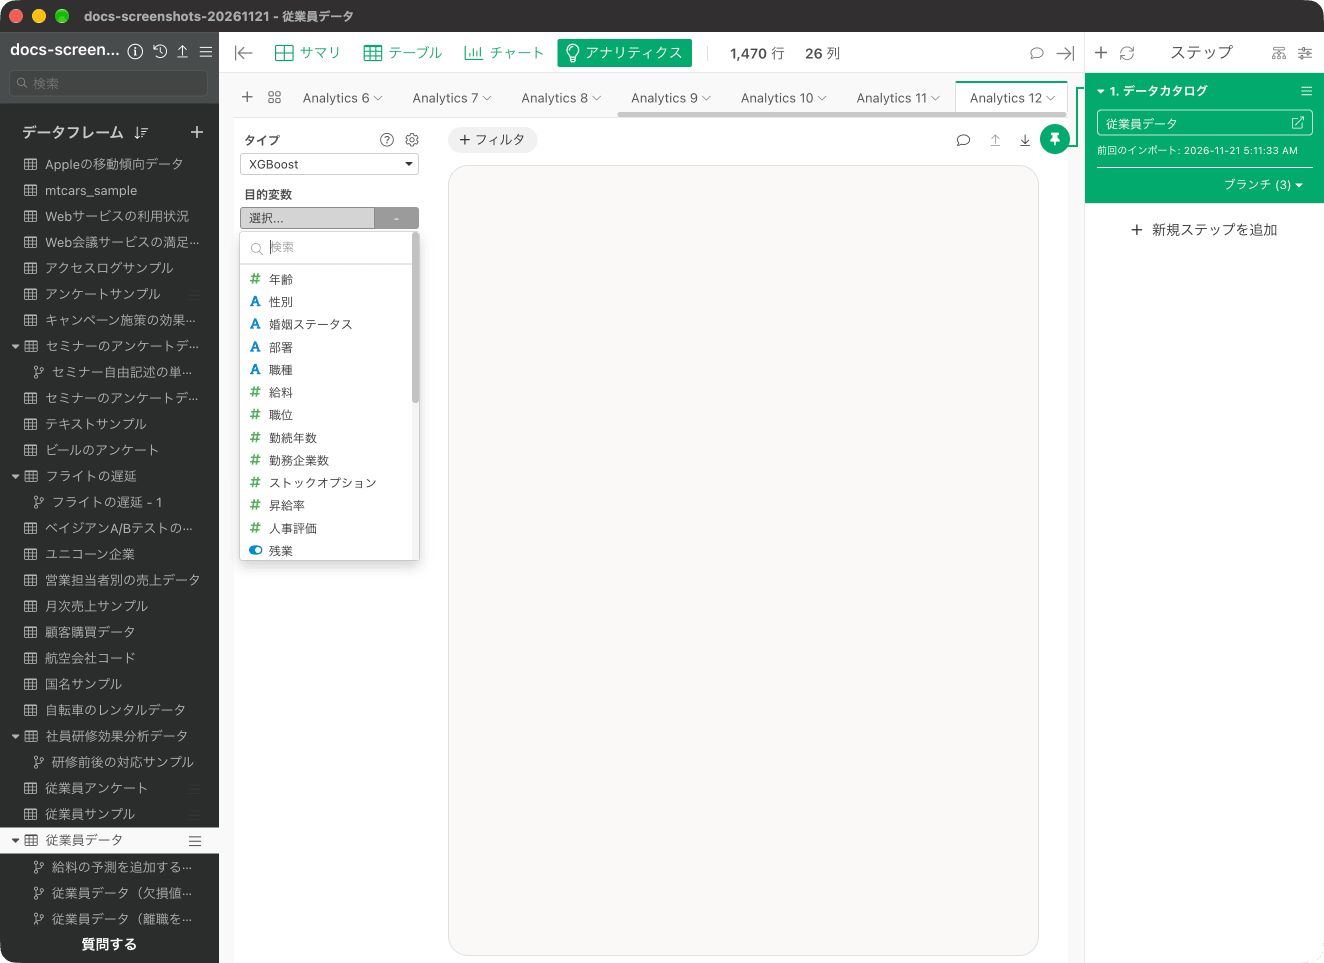
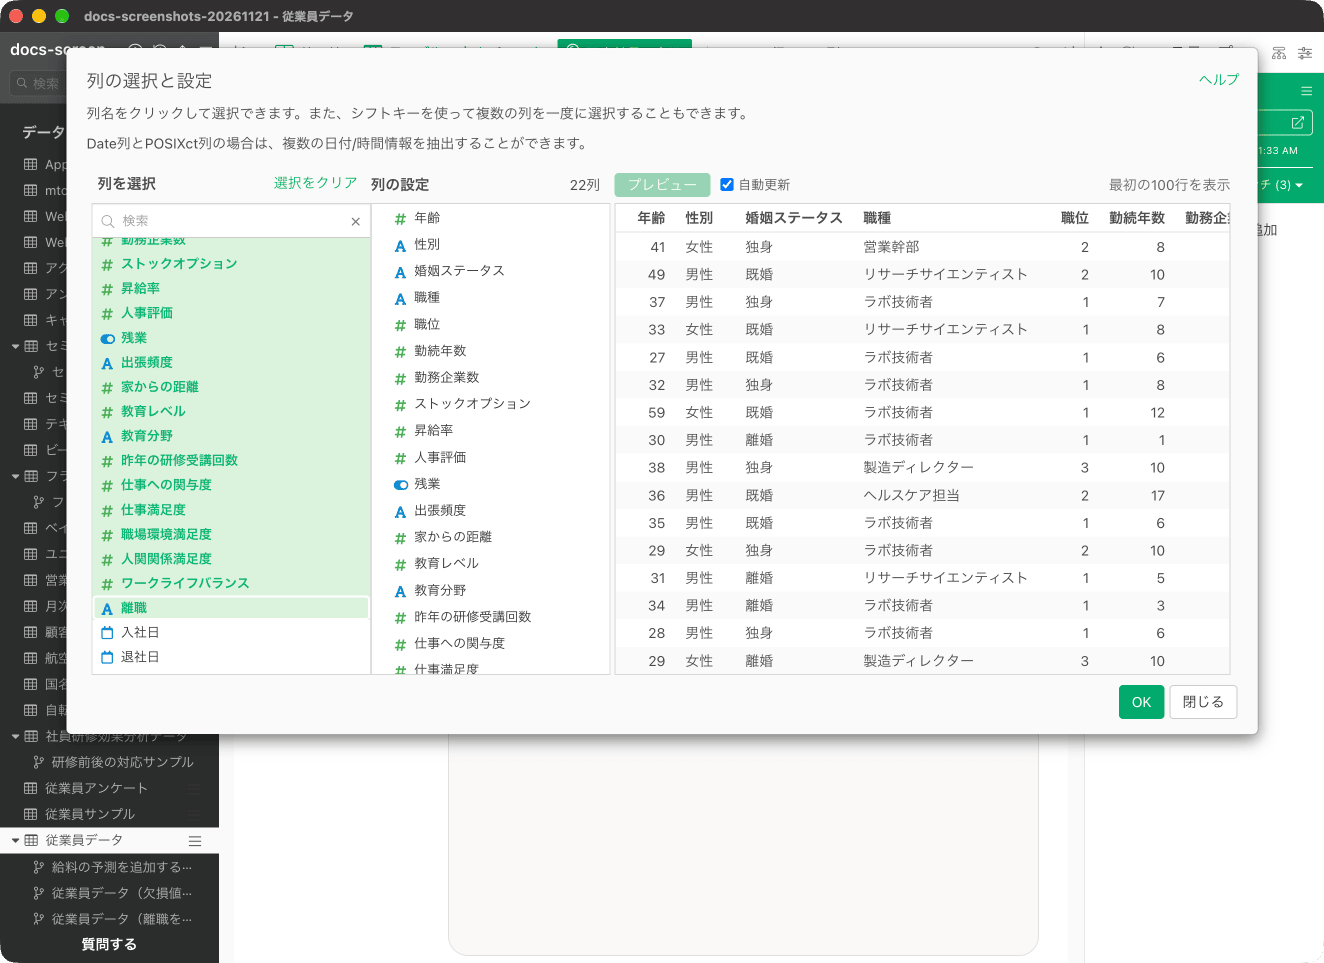
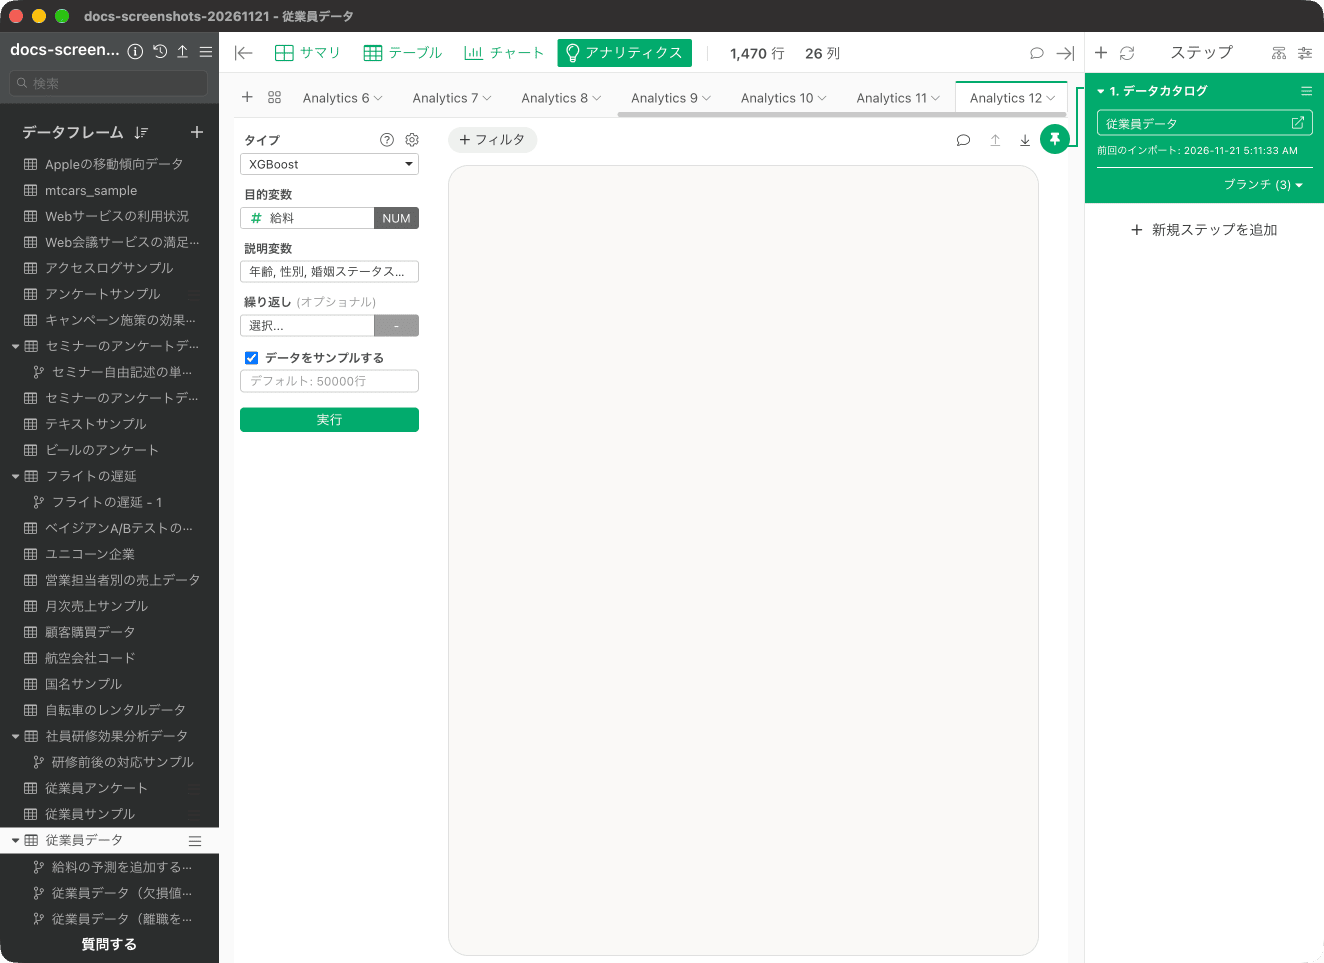
今回は、従業員の「給料」を予測するXGBoostのモデルを作成します。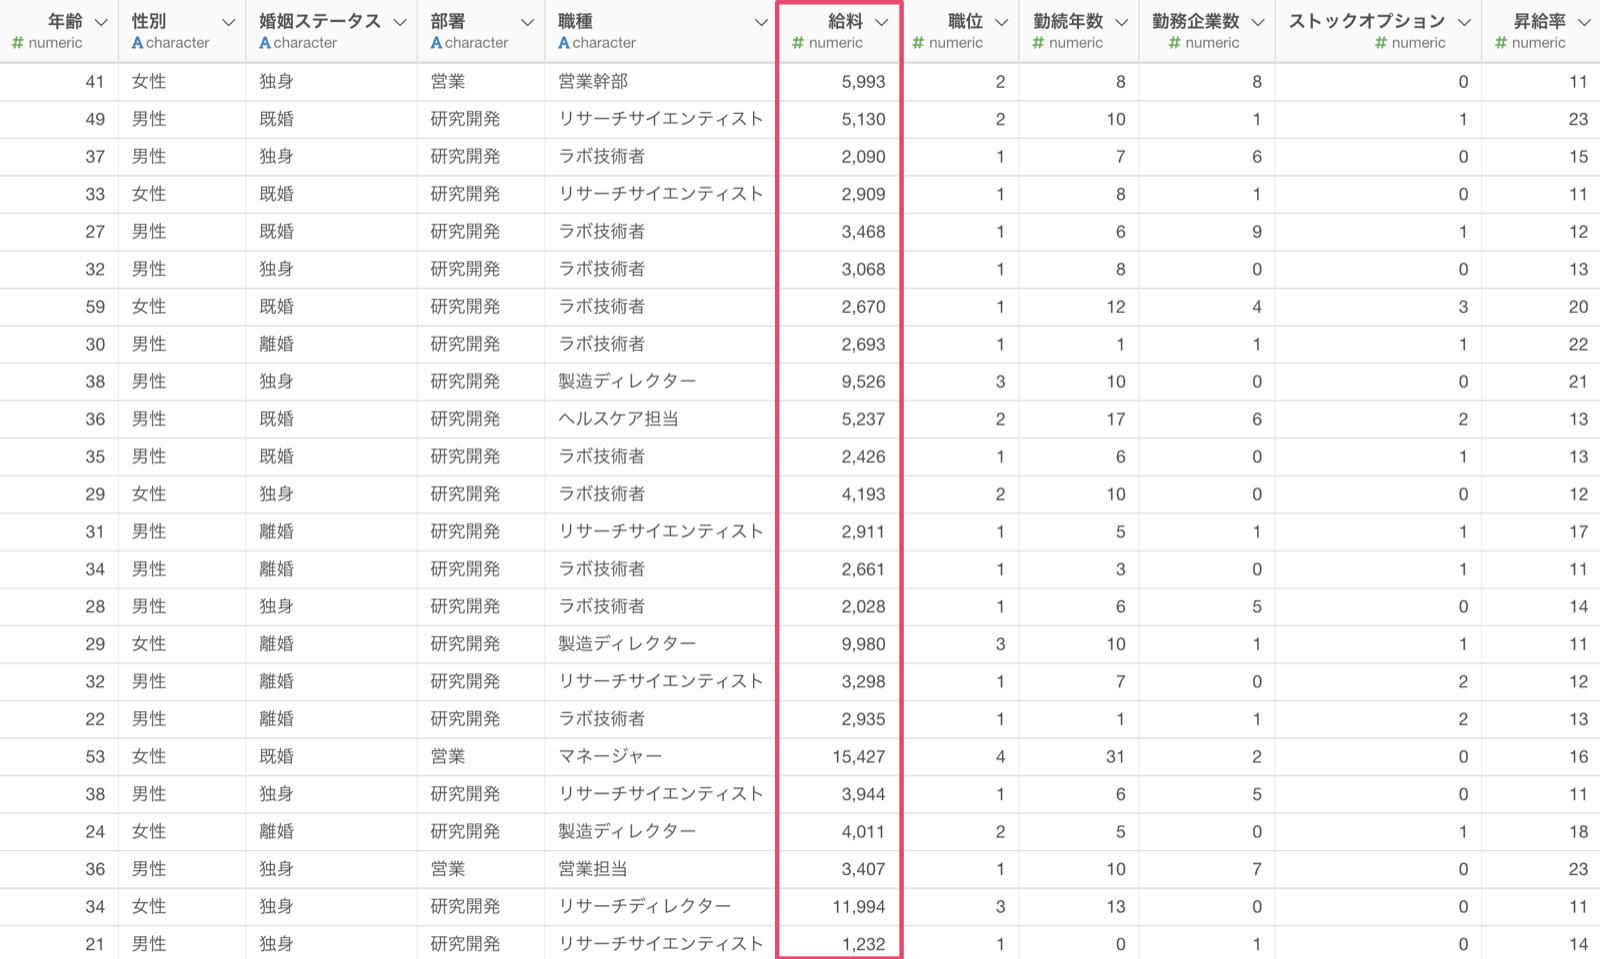
結果の解釈
変数重要度
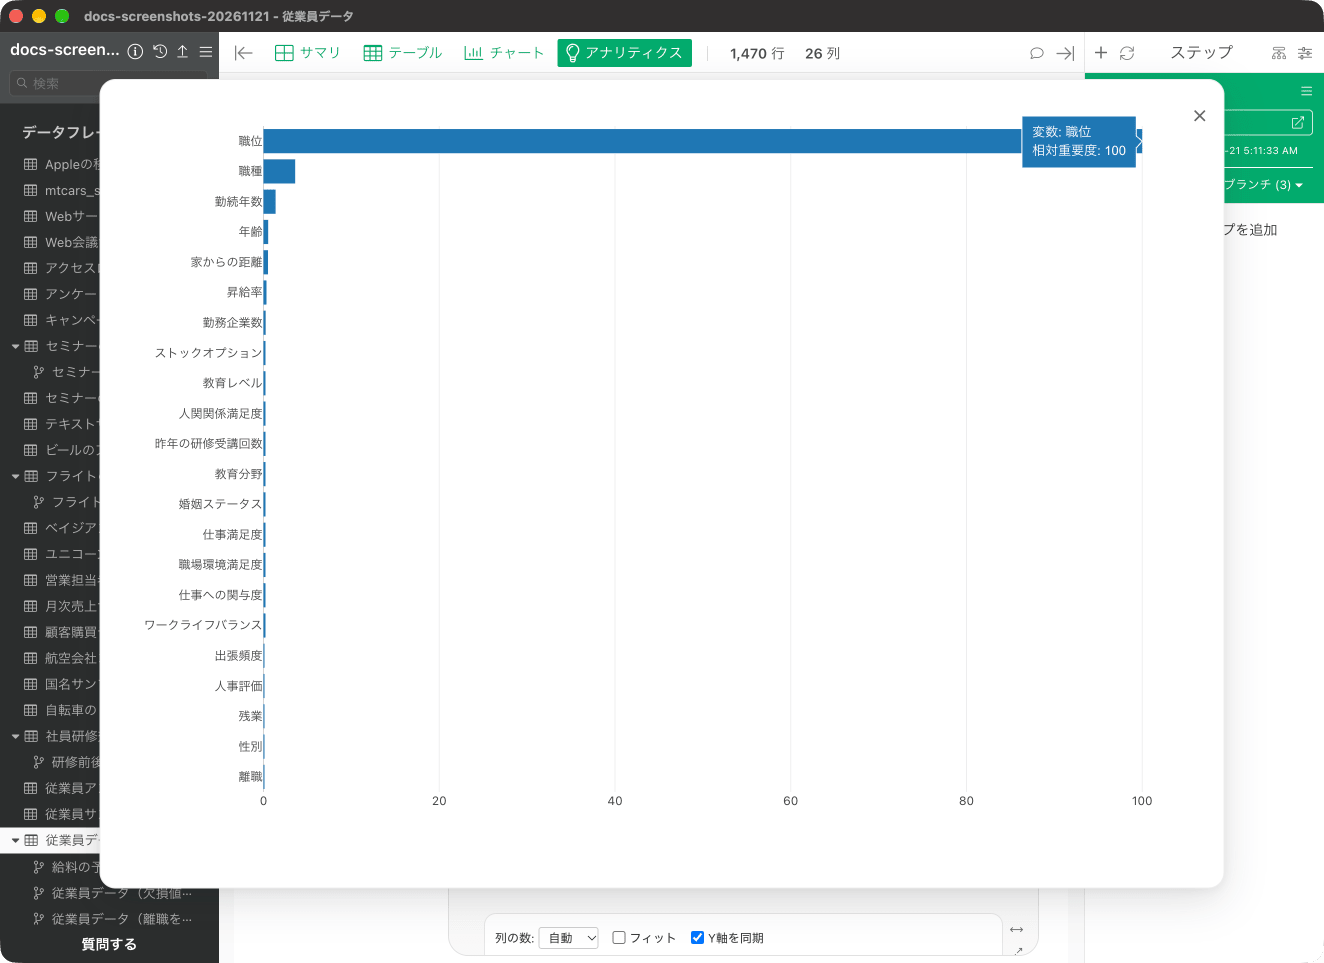
「予測に関係する変数」の「変数重要度」では、どの変数が目的変数とより相関が強いのか、予測する時により重要なのかを調べることができます。各変数の重要度は予測性能の低下量(Permutation)で計算され、最大値が100になるよう正規化されています。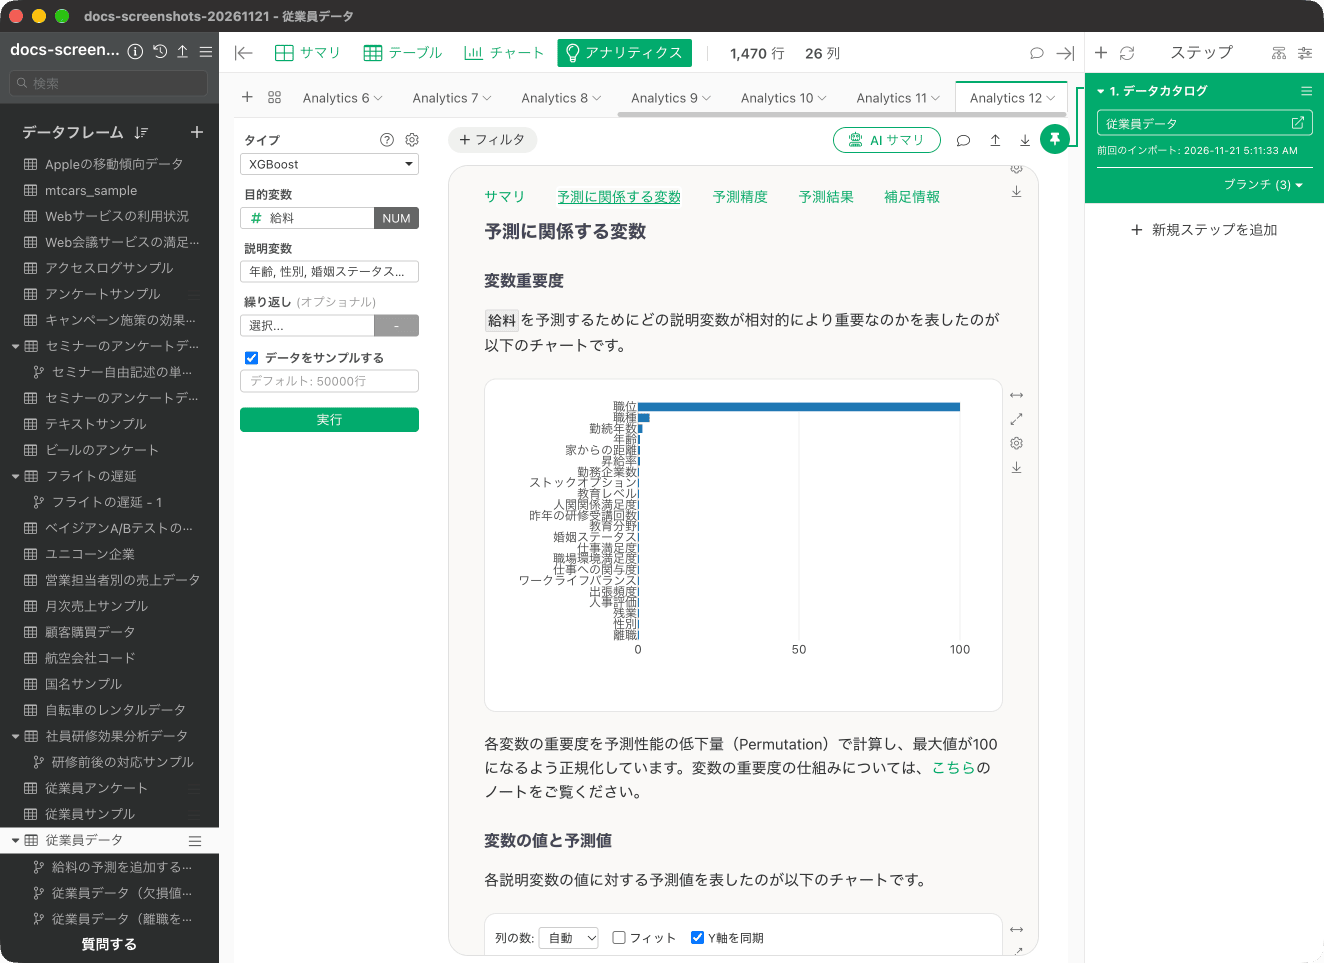
変数の値と予測値
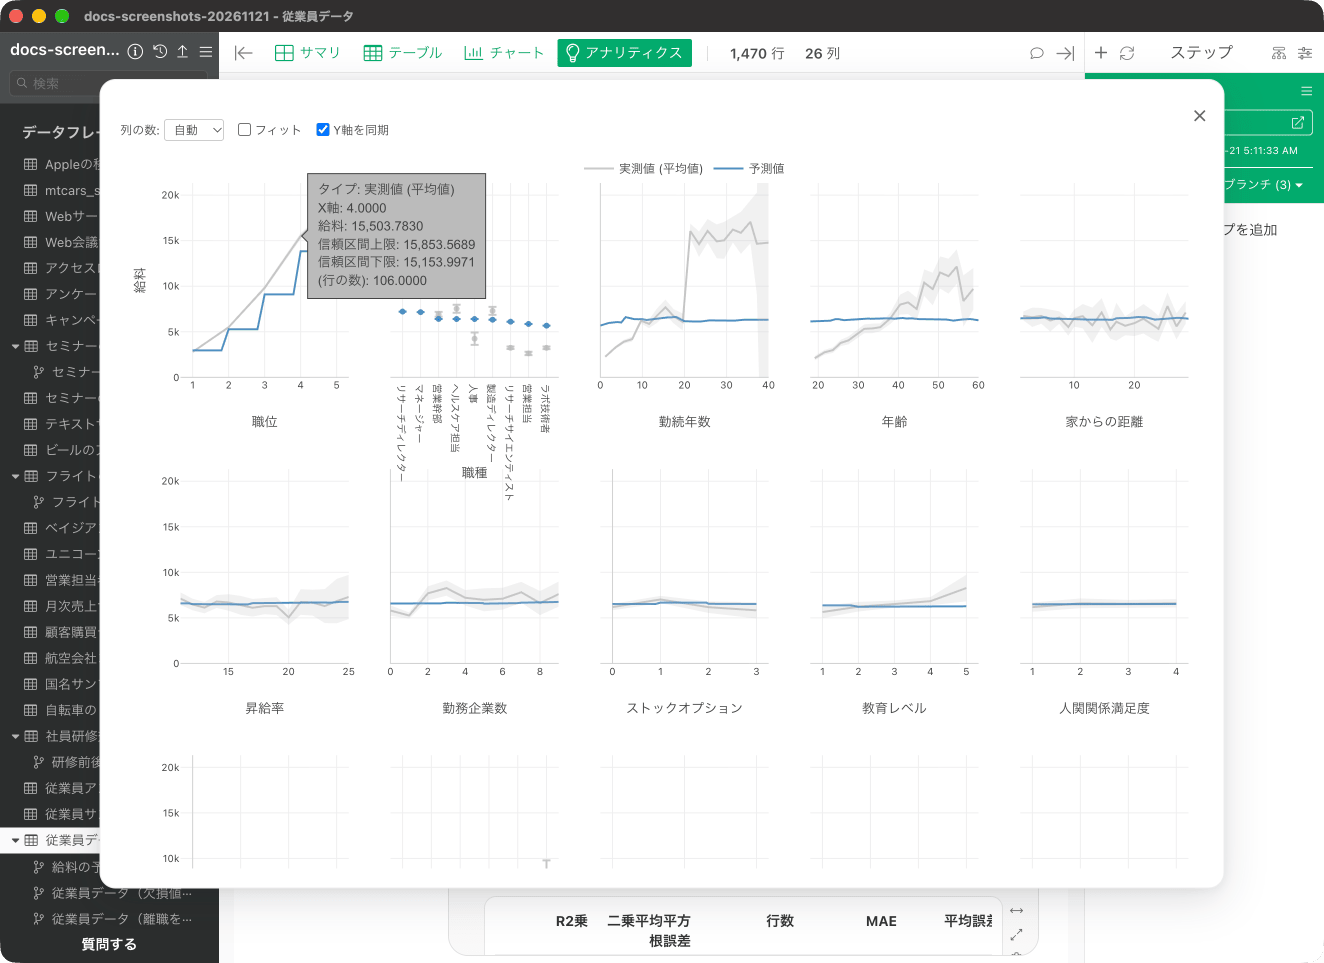
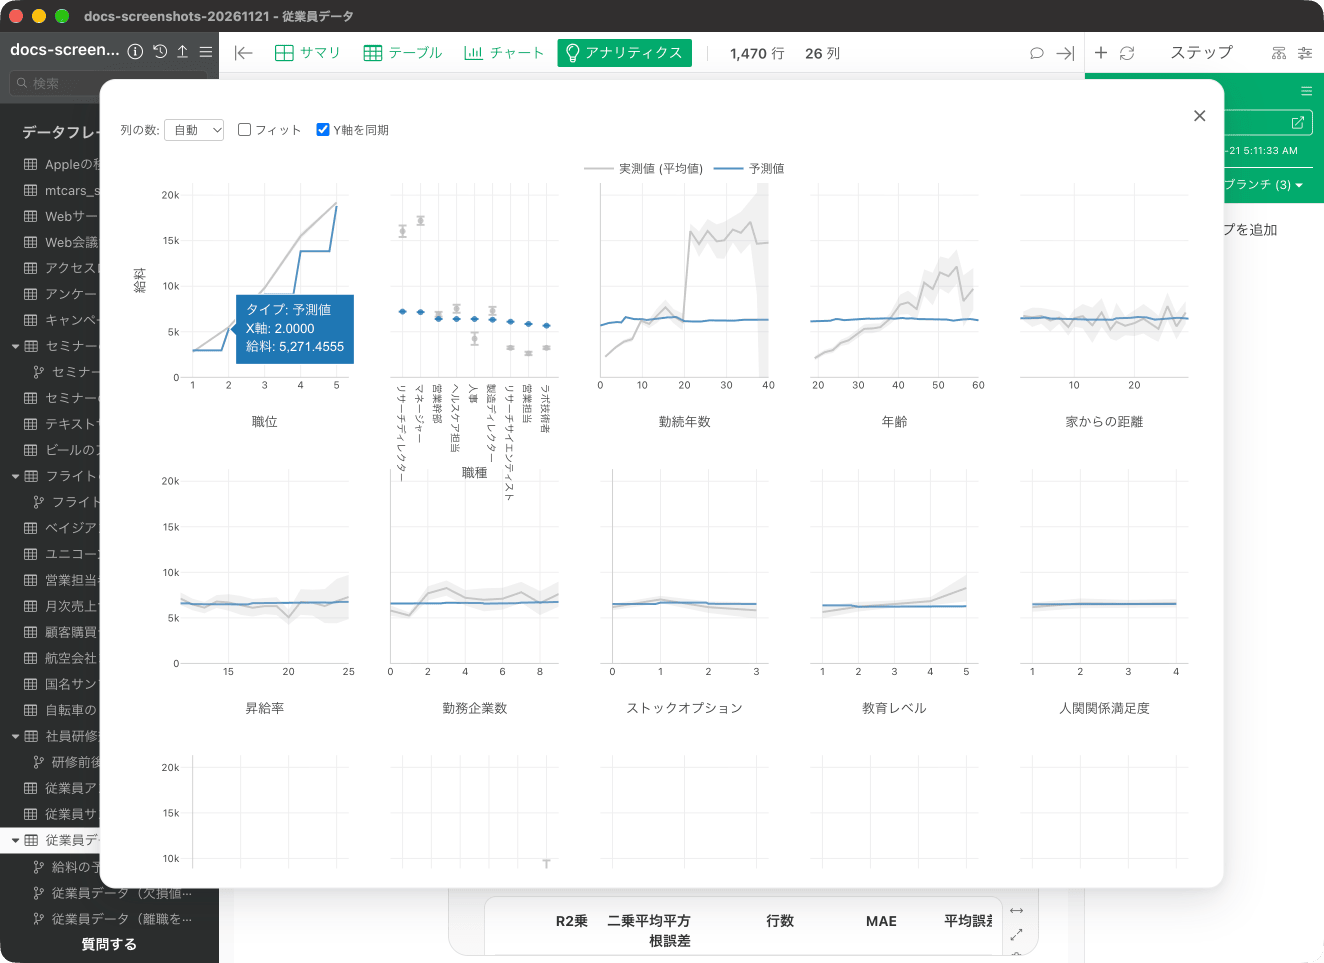
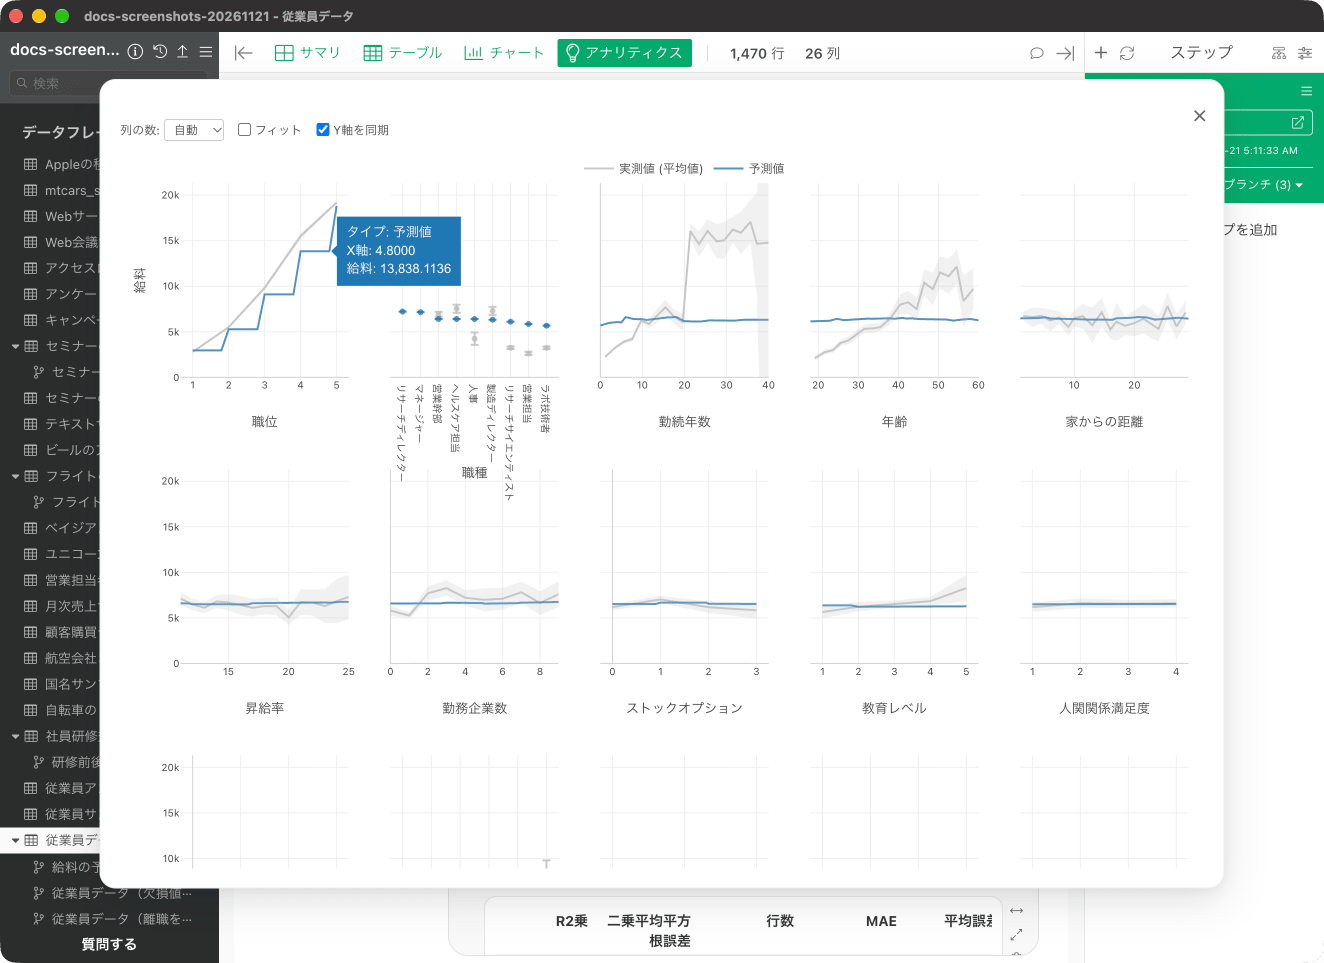
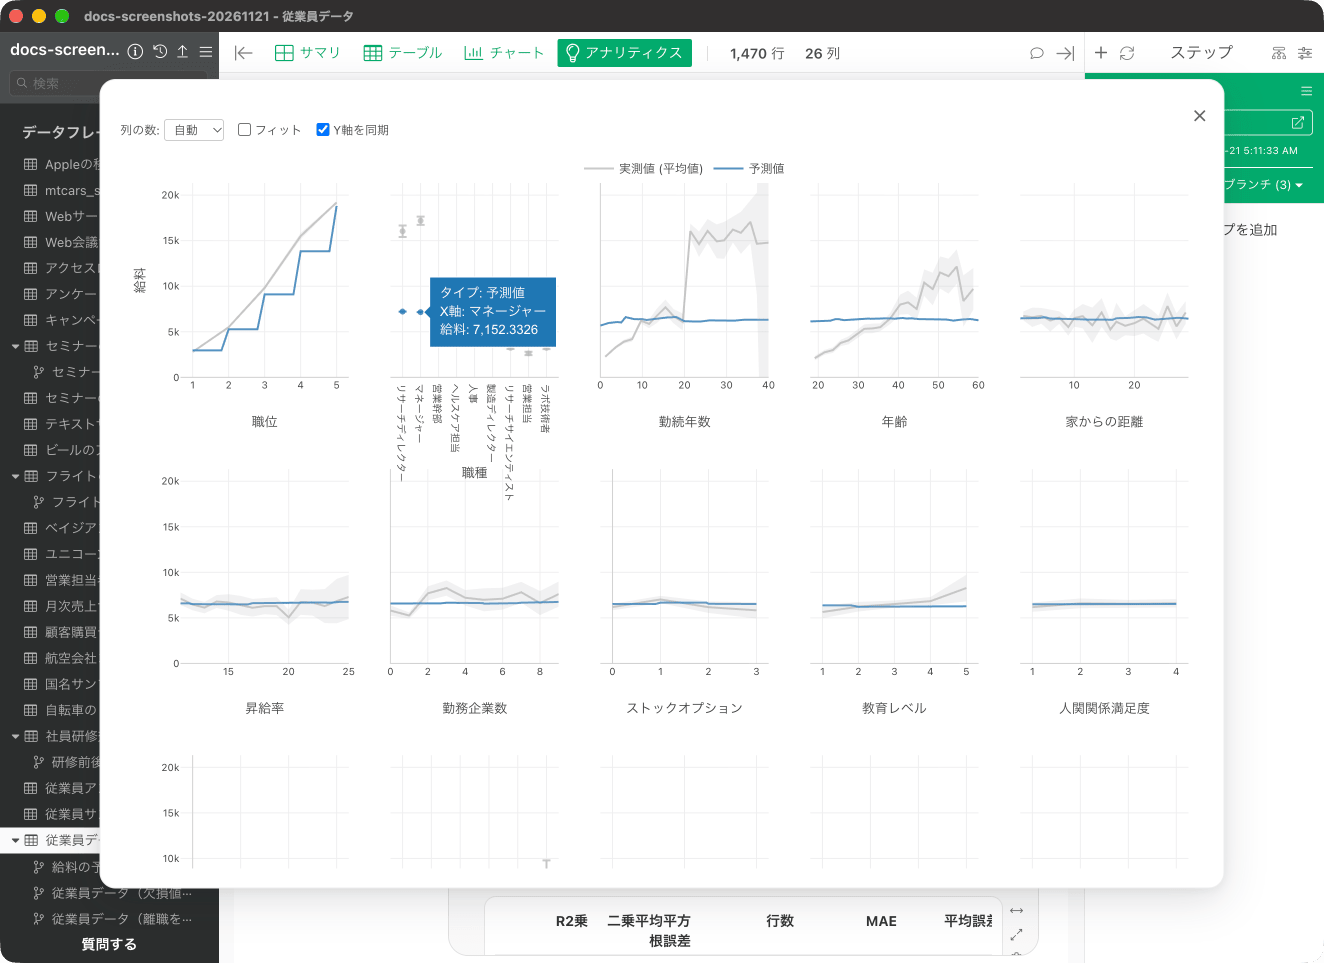
「予測に関係する変数」の「変数の値と予測値」では、それぞれの変数の値が変わると、目的変数の値はどのように変わるのかがわかります。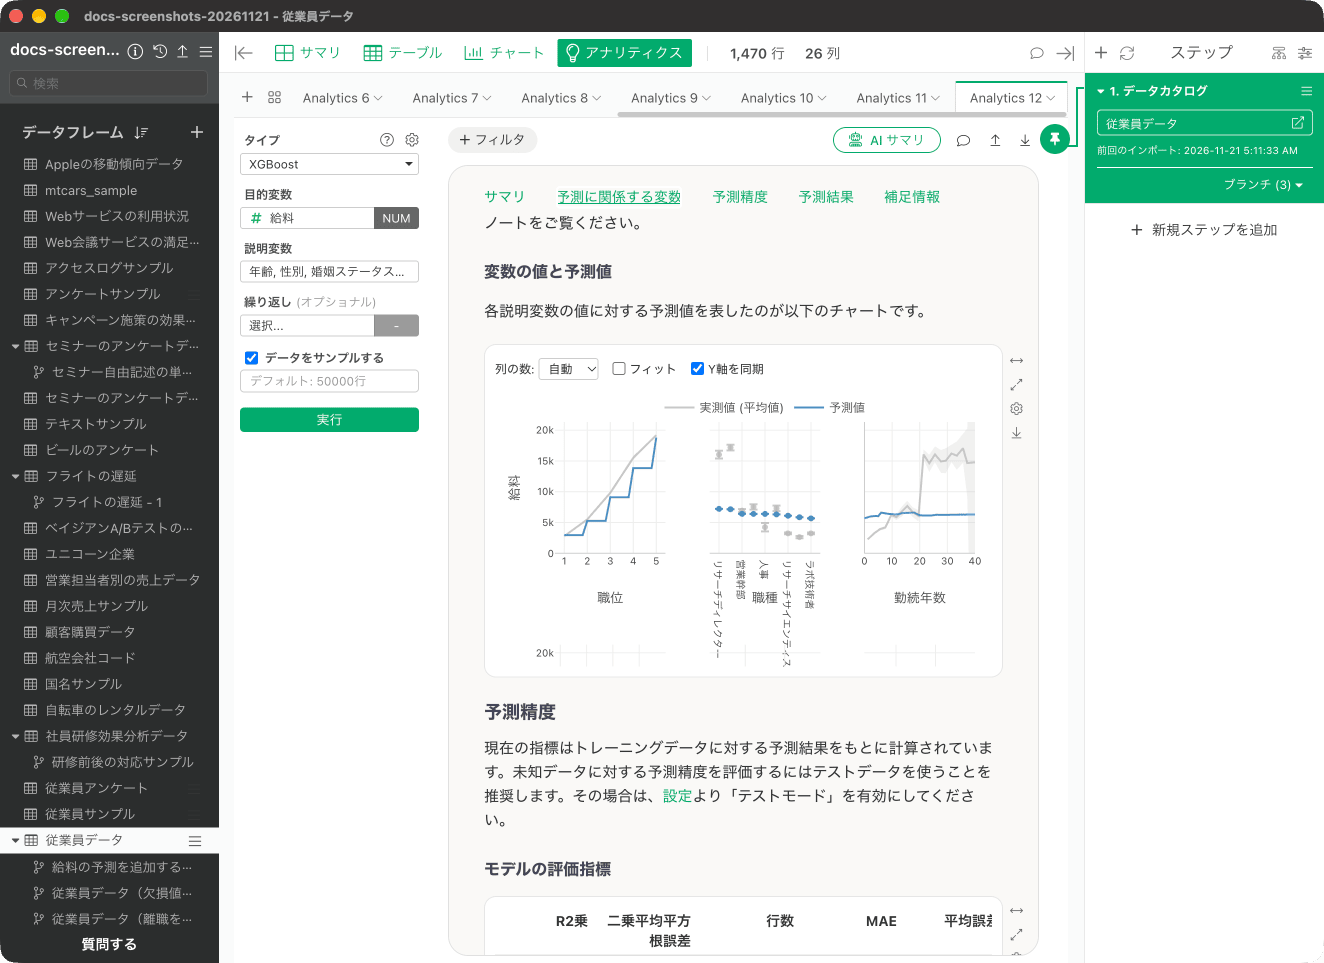
学習回数と精度の向上
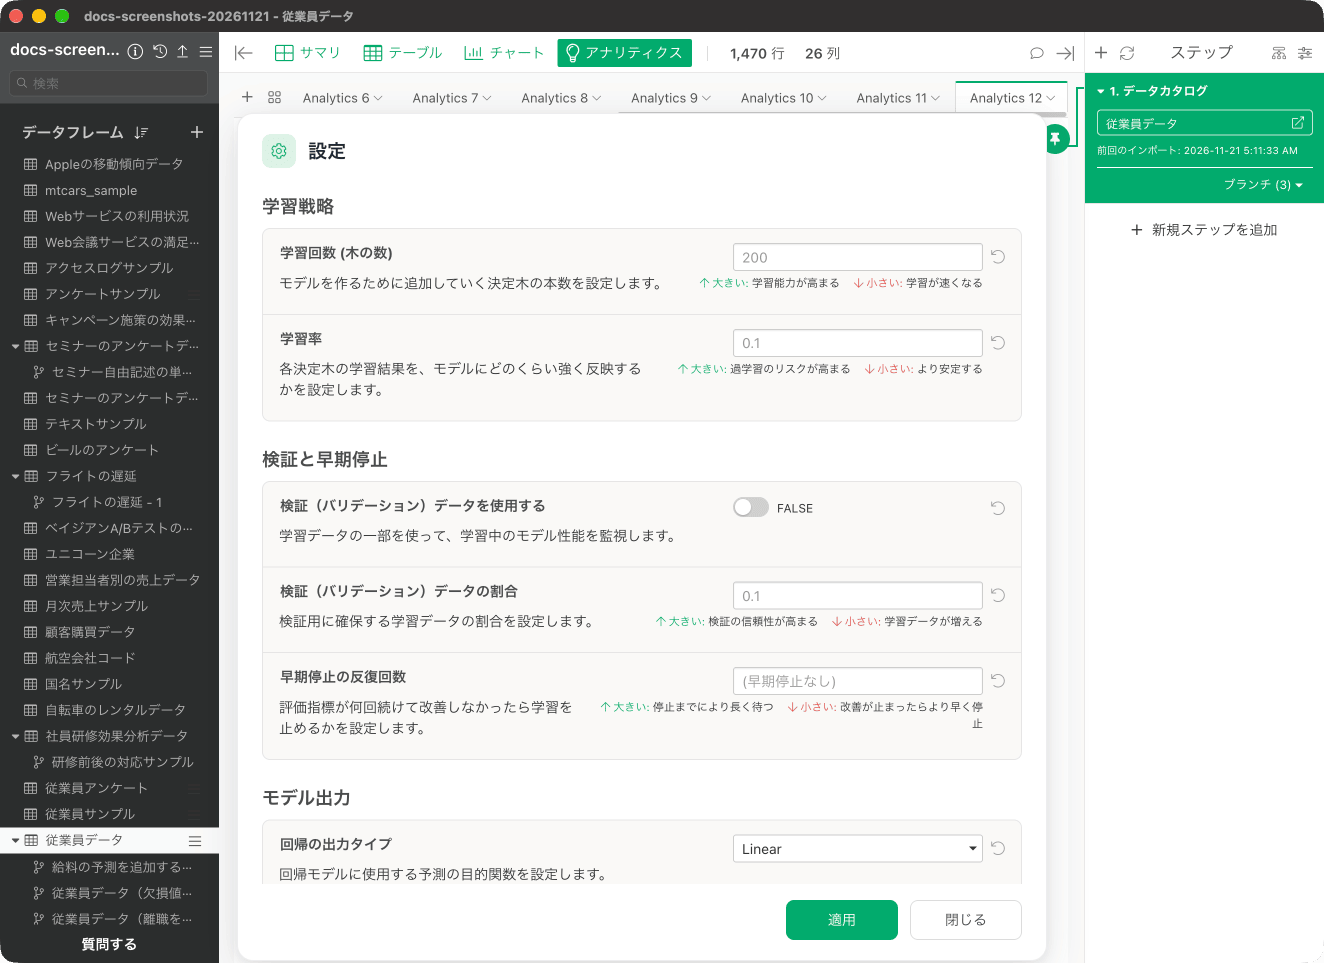
「予測精度」の「学習回数と精度の向上」では、学習回数(作成された決定木の数)によって、評価指標がどのように変化したかが確認できます。「+ チャート」を開くと、横軸が学習回数、縦軸がRMSEのチャートが表示されます。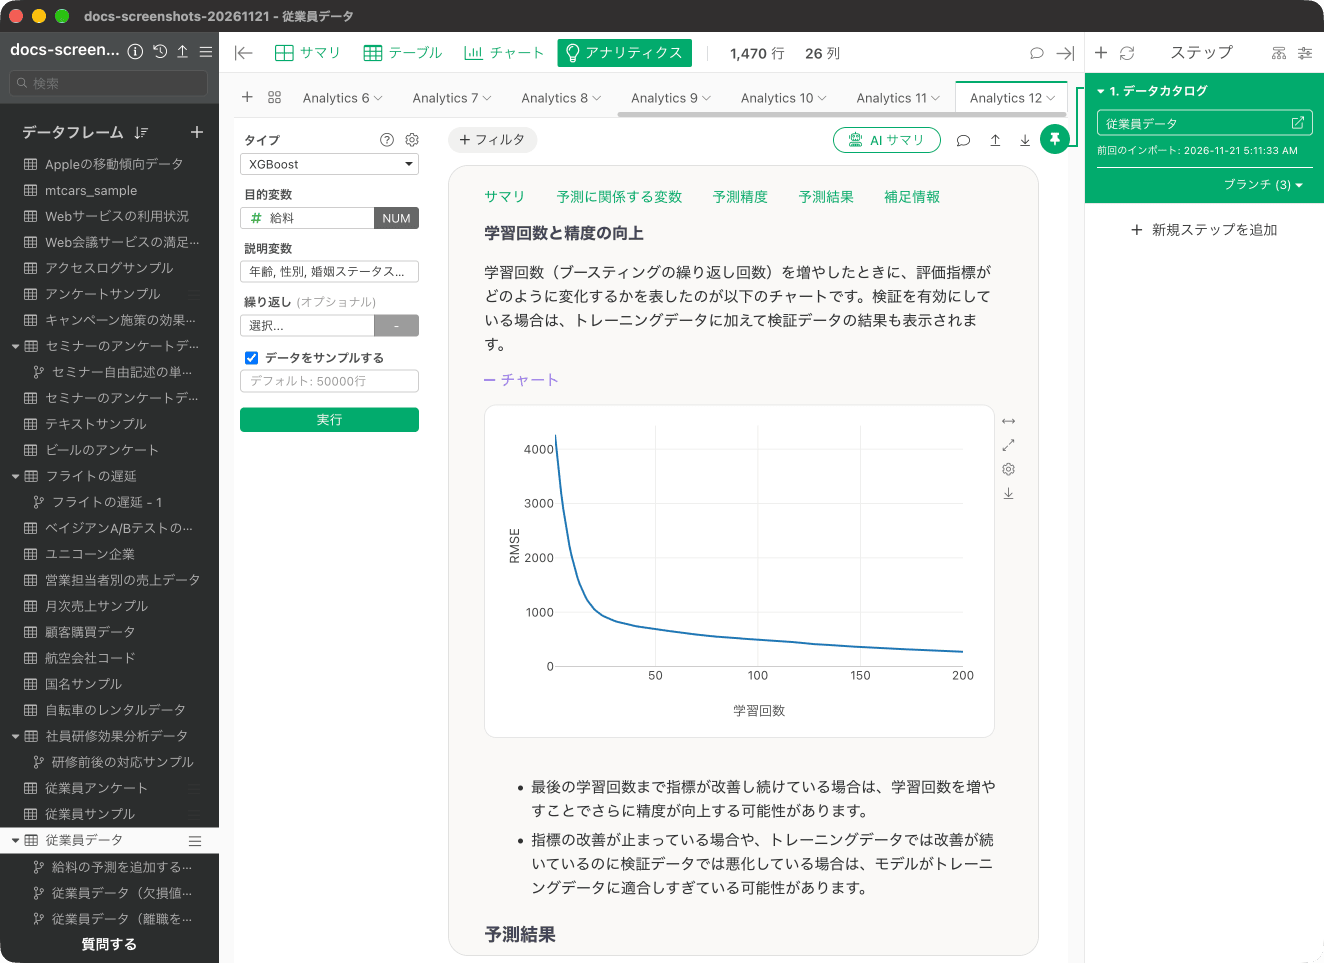
モデルの評価指標
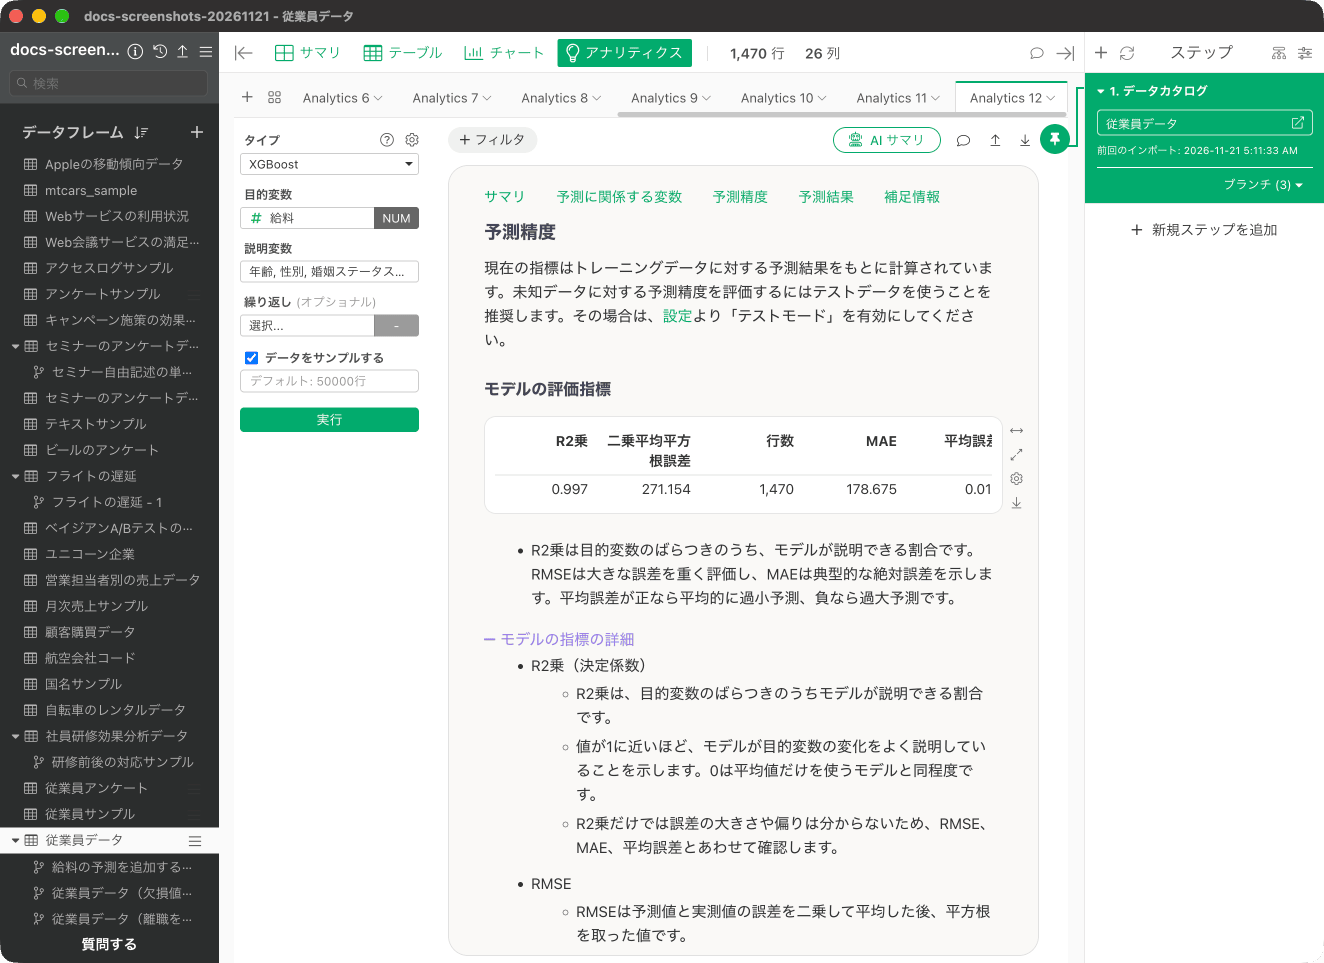
「予測精度」の「モデルの評価指標」では、この予測モデルの評価を確認できます。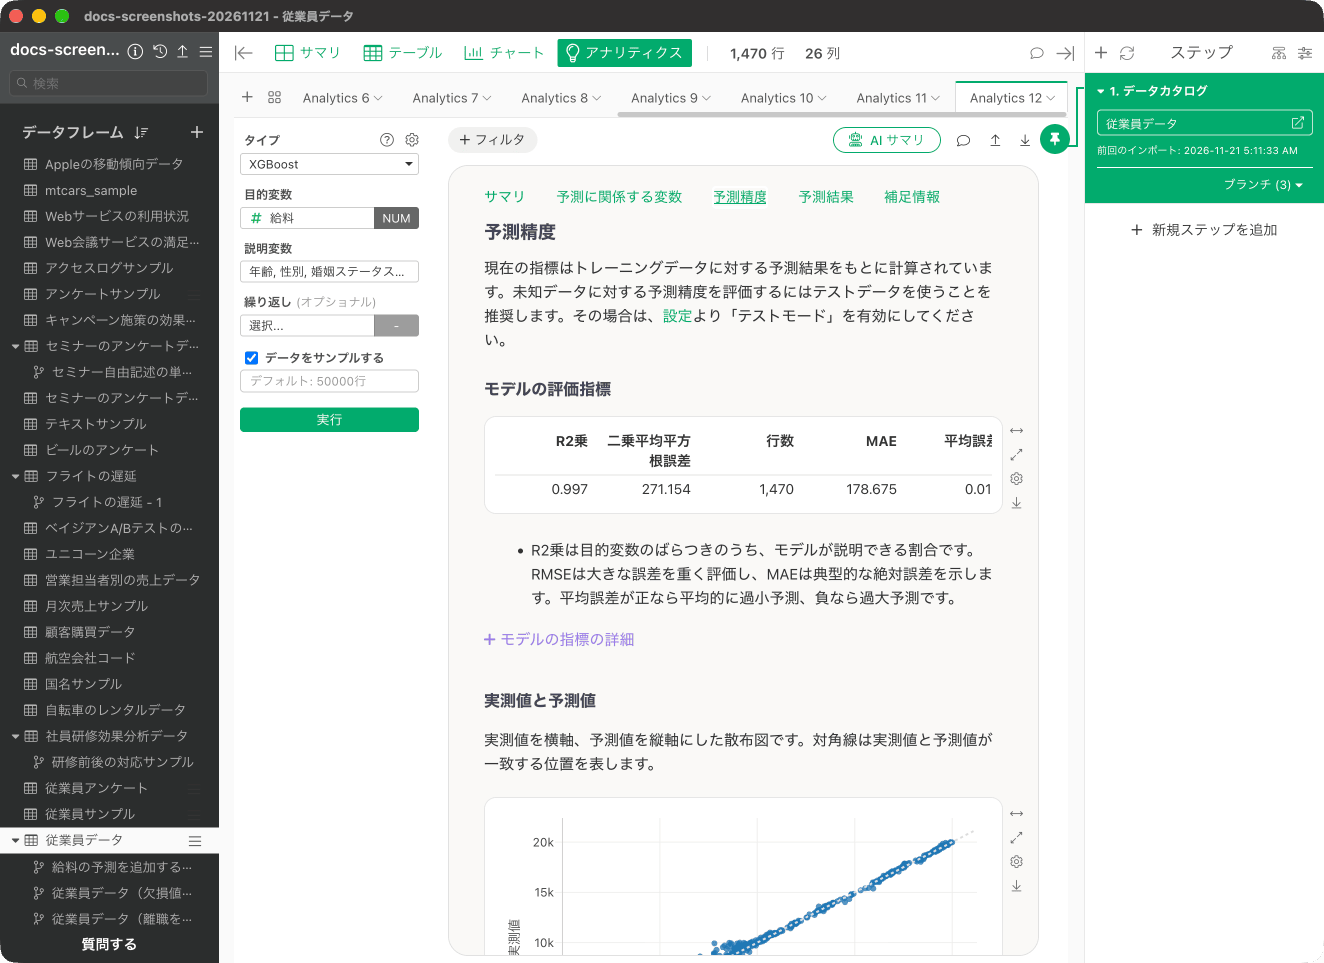
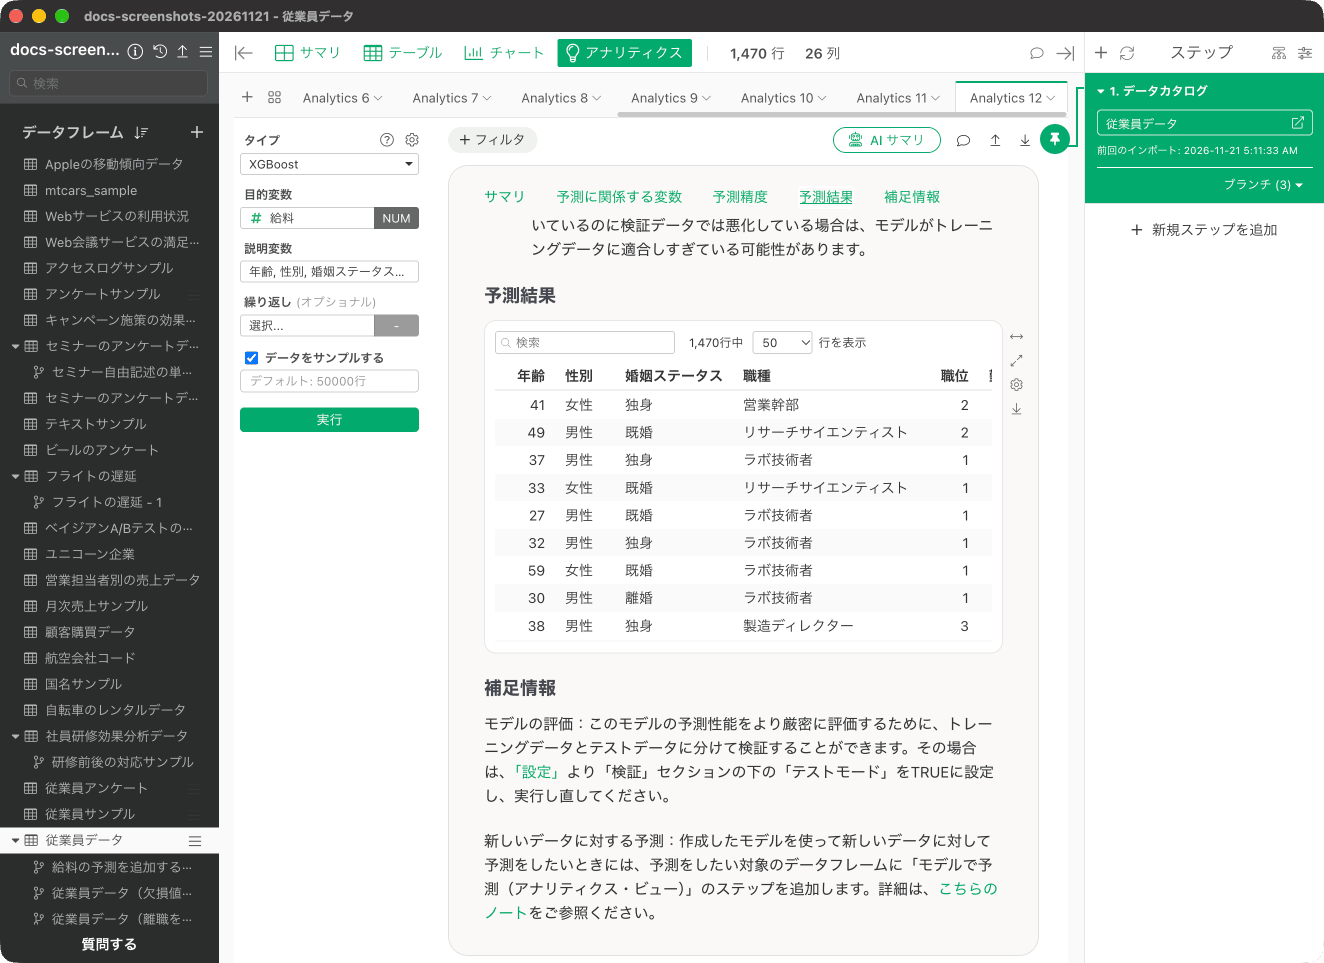
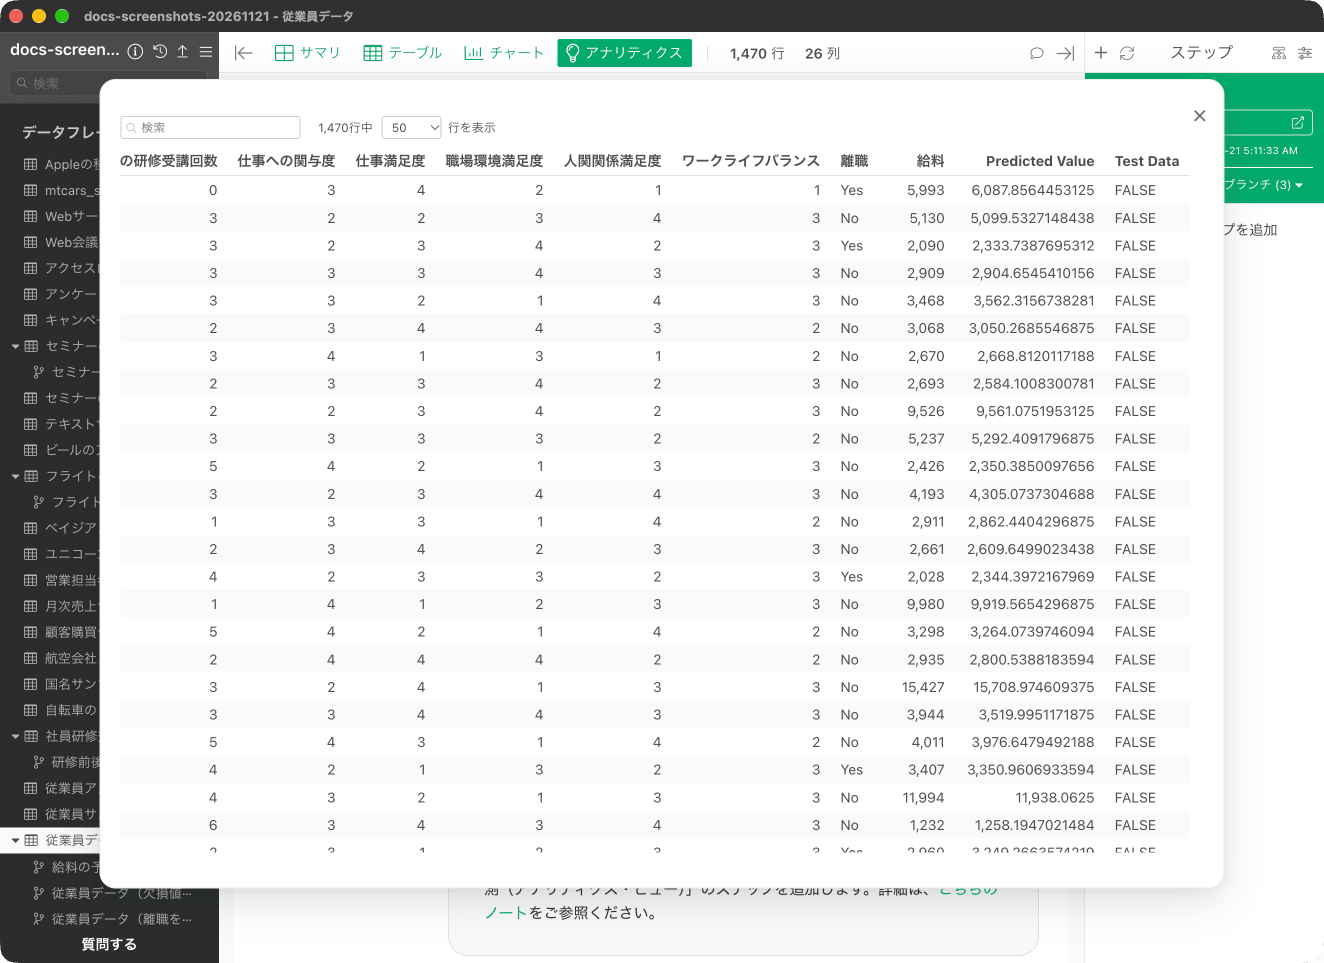
予測結果
「予測結果」では、モデルに使用したデータと予測値をテーブル形式で表示されます。