メインコンテンツへスキップ
コックス回帰は、生存分析のアルゴリズムの一つで、観察対象の生存時間とイベント(例:サービスのキャンセル)の発生の関係を、説明変数をもとにモデル化します。サブスクリプション型のビジネスで顧客のキャンセルを考えるときのように、「どれくらいの期間でイベントが発生したのか」が重要な場面で使います。

何ができるか

コックス回帰を使うと、次の質問に答えられます。
  • このデータ(説明変数)を使うことで、あるタイミング(例:サービスの利用開始から1年後)における生存状態(例:サービスのキャンセル)のTRUE/FALSEをどれだけうまく分けられているか。
  • どの変数が、あるタイミングにおける生存状態を予測するうえで重要か。
  • 説明変数の値が変わると、生存曲線はどのように変わるか。

必要なデータ

コックス回帰のモデルを作成するためには、**1行が1観察対象(例:1行が1顧客)**のデータが必要です。 また、以下の情報も列に必要です。
  • 開始時期:観察対象の観察の開始時期を表す、Date(日付)型、またはPOSIXct(日付時間)型の列
  • 終了時期:観察対象の観察の終了時期を表す、Date(日付)型、またはPOSIXct(日付時間)型の列
  • 生存状態:観察対象のイベントのステータスを表す、ロジカル型の列(例:チャーン、解約、離職、死亡など)
  • 説明変数:生存状態を予測するための列(データタイプに制限はありません)

サンプルデータ

今回は、動画視聴のサブスクリプション・サービスを想定したサンプルデータを使います。この例のデータは説明用に作った架空のものです。 データは800行・18列で、1行が1顧客です。列は次のとおりです。
  • 顧客ID、最初の利用日、最後の利用日、チャーン
  • 視聴時間を表す、アクション、アニメ、コメディ、ドラマ、ヒューマン、SF
  • 利用デバイス(Mobile または PC)、オフライン機能、いいね、SNSへの投稿数
  • 年齢、性別、婚姻ステータス
  • 生存時間(日数)

コックス回帰のモデルを作成する

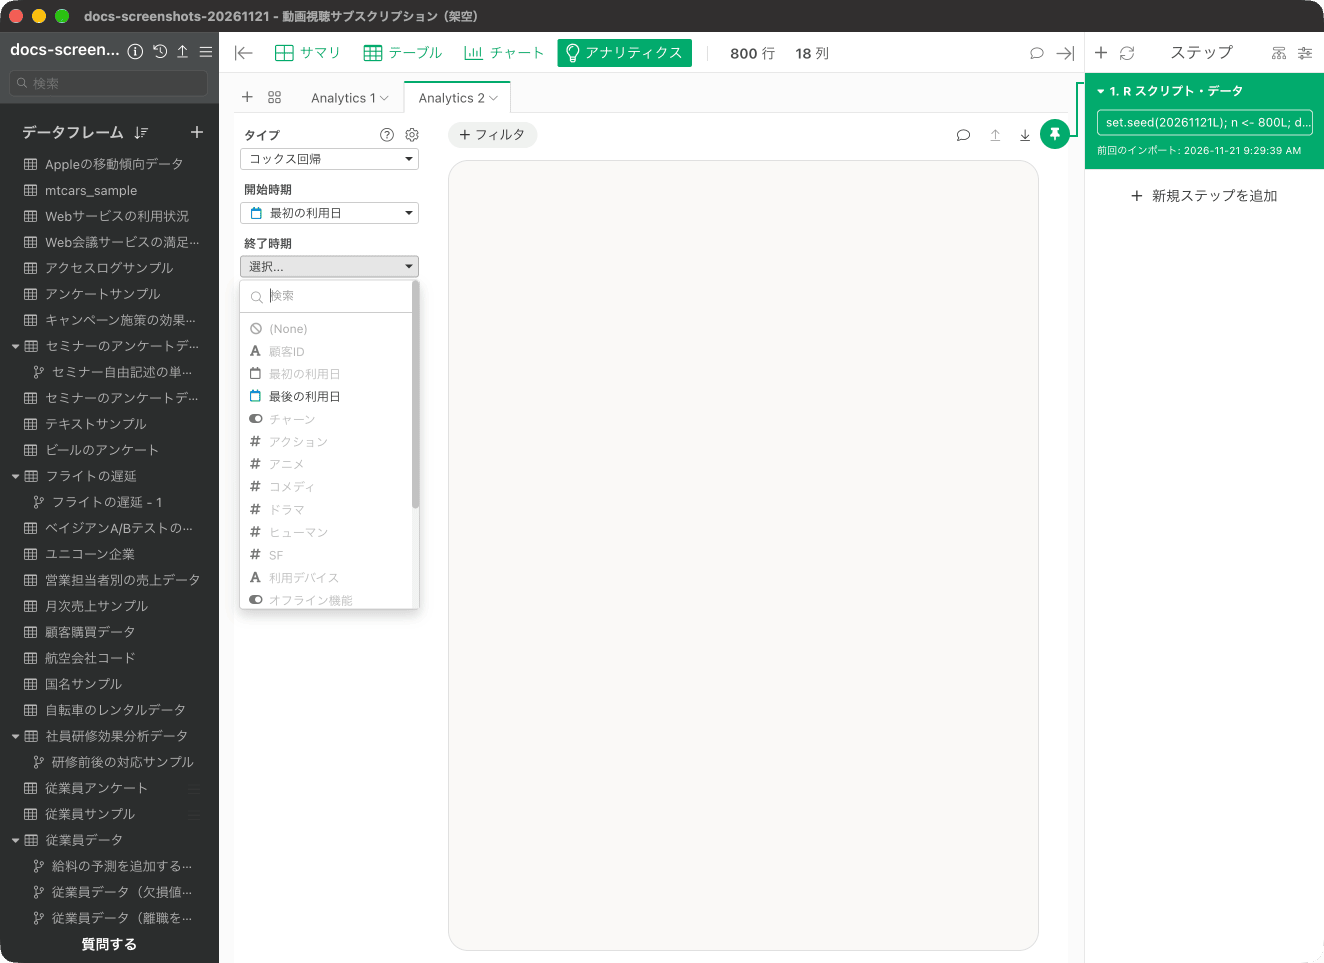
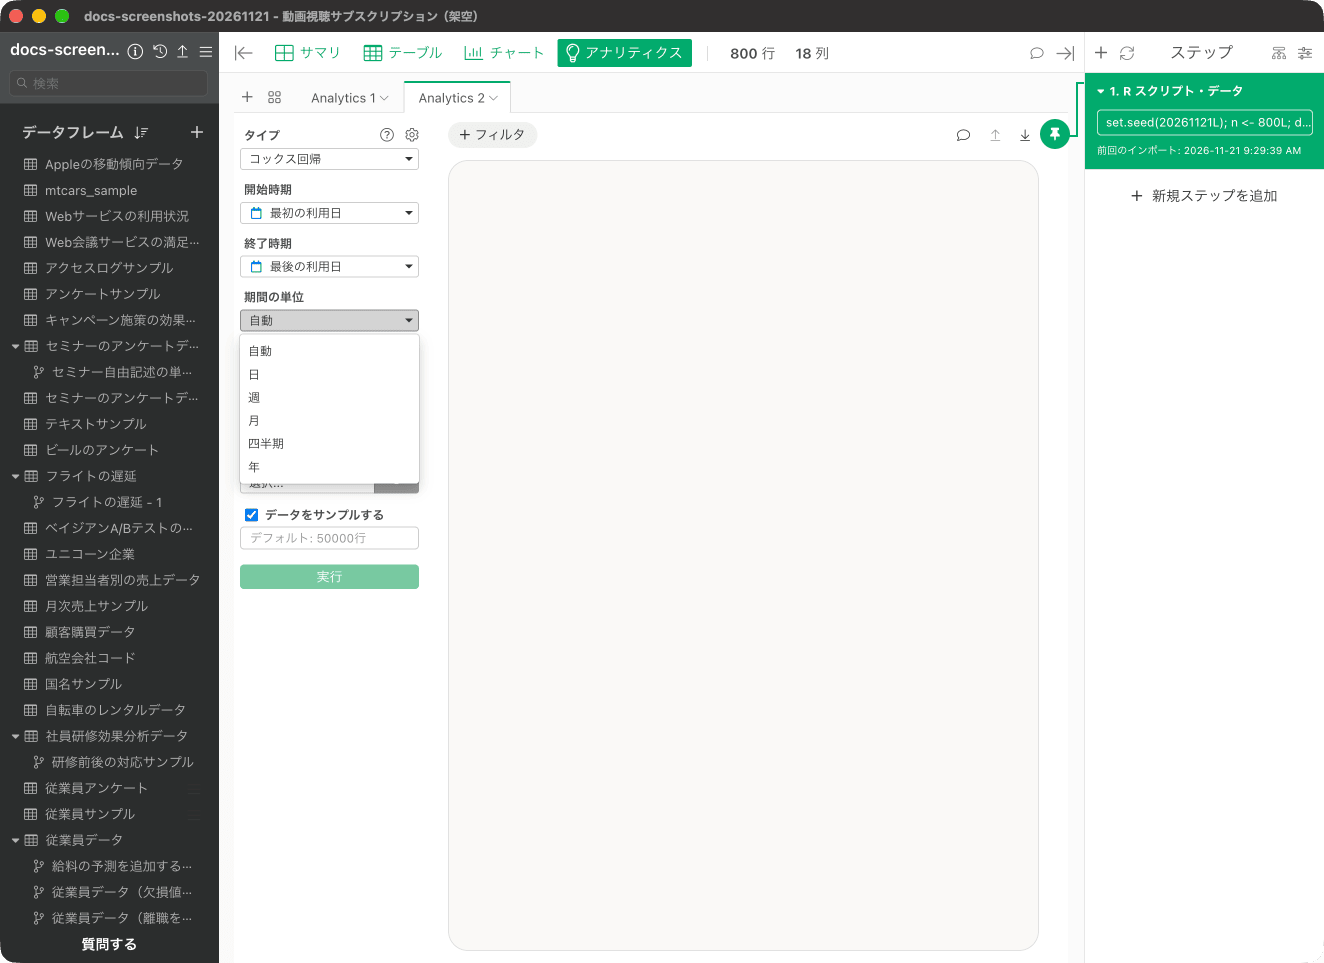
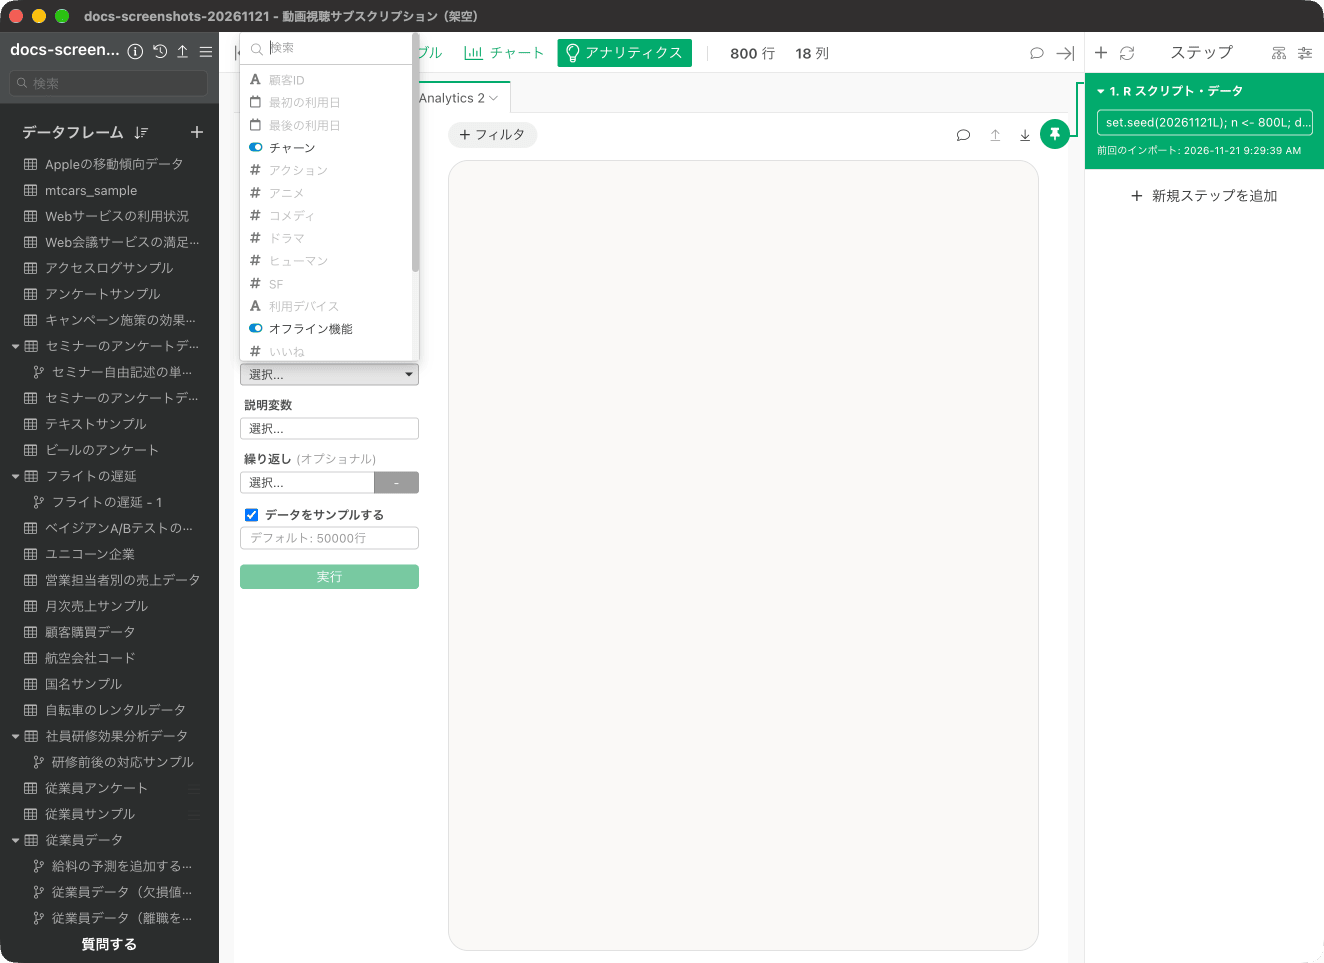
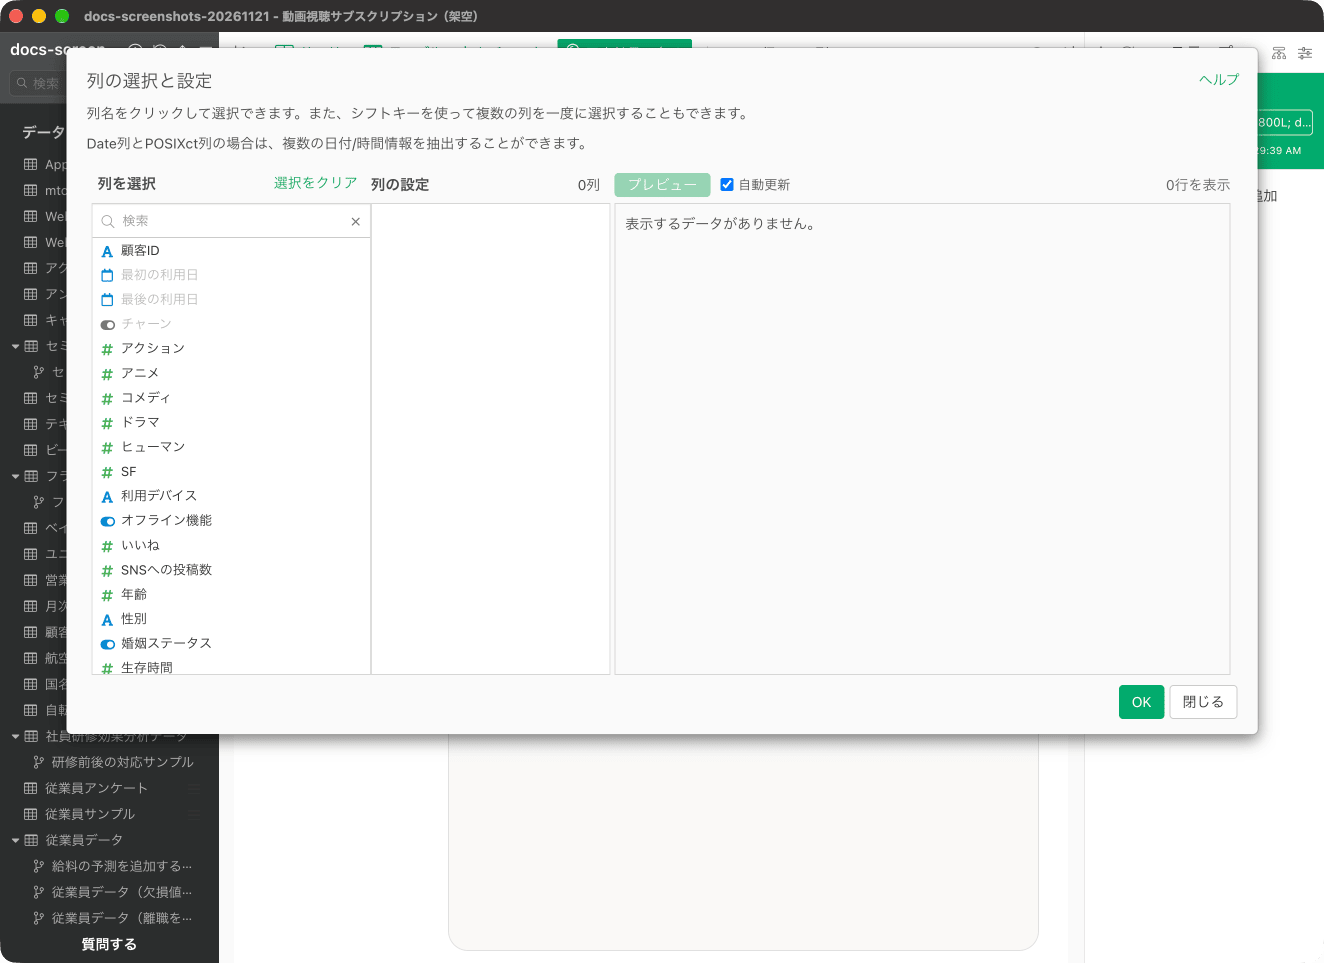
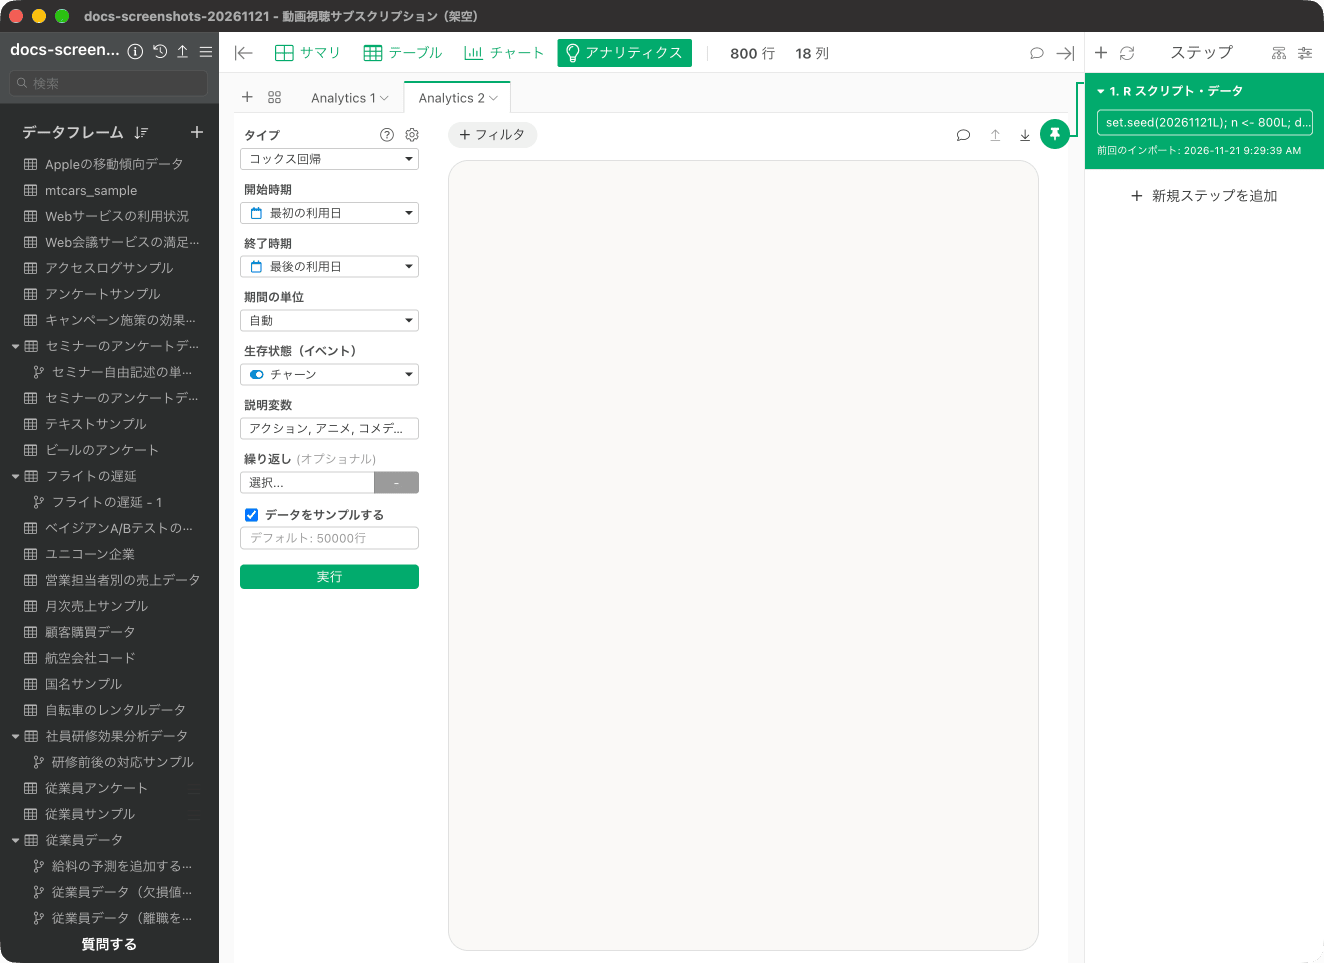
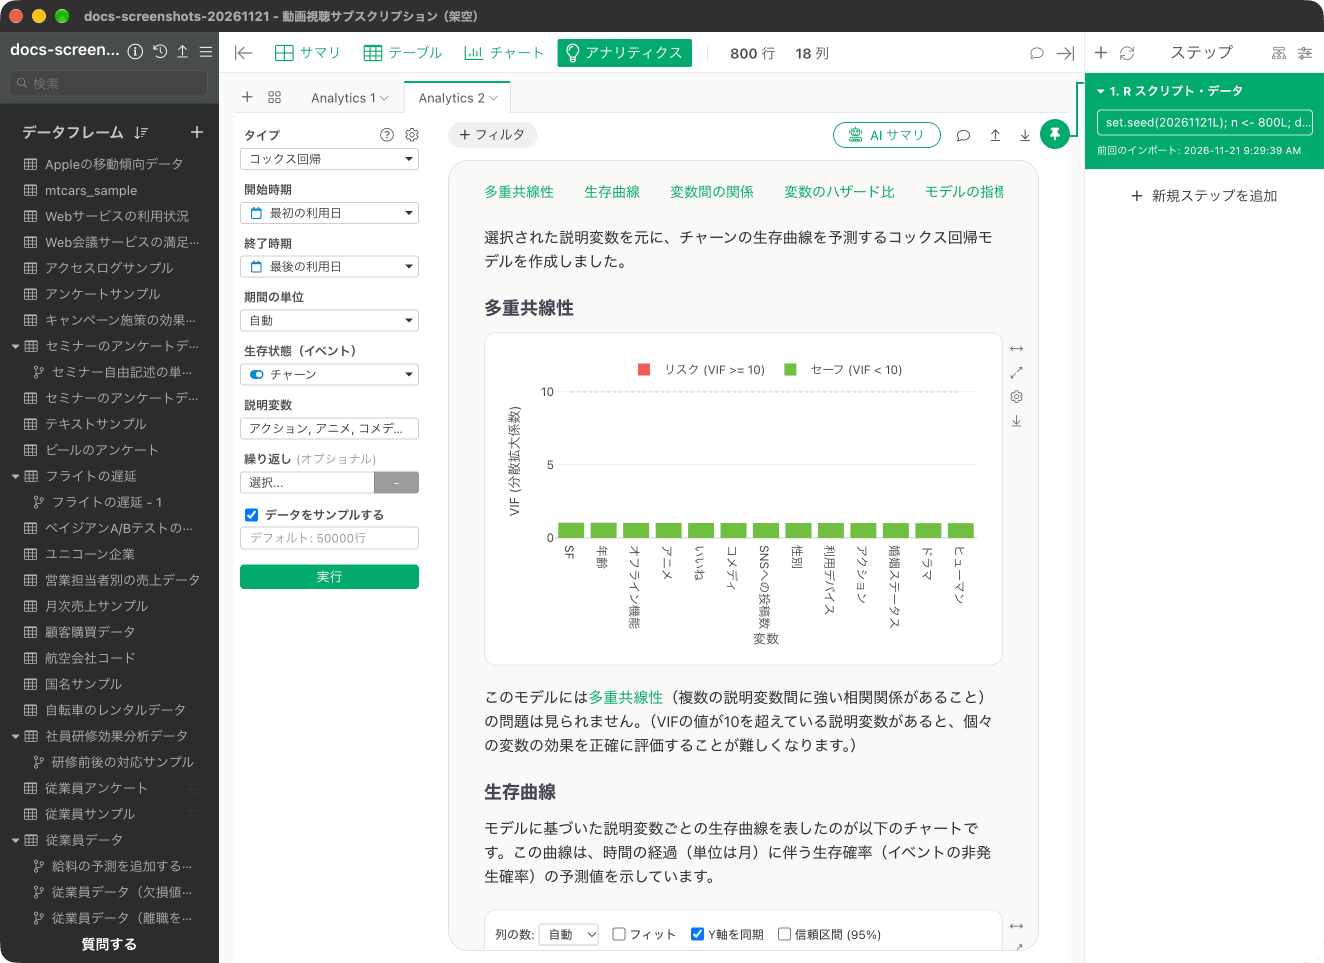
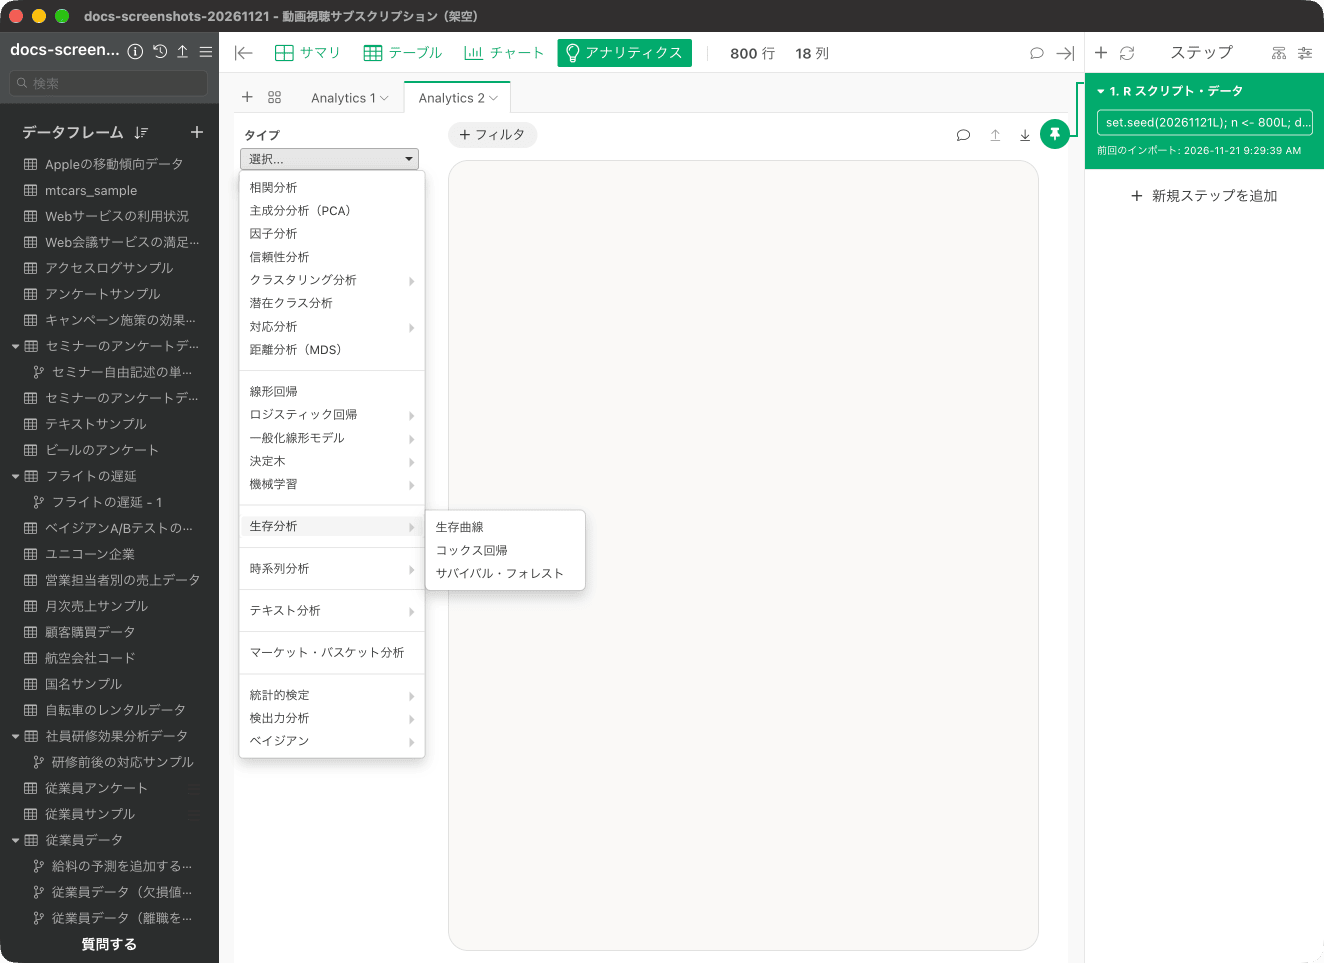
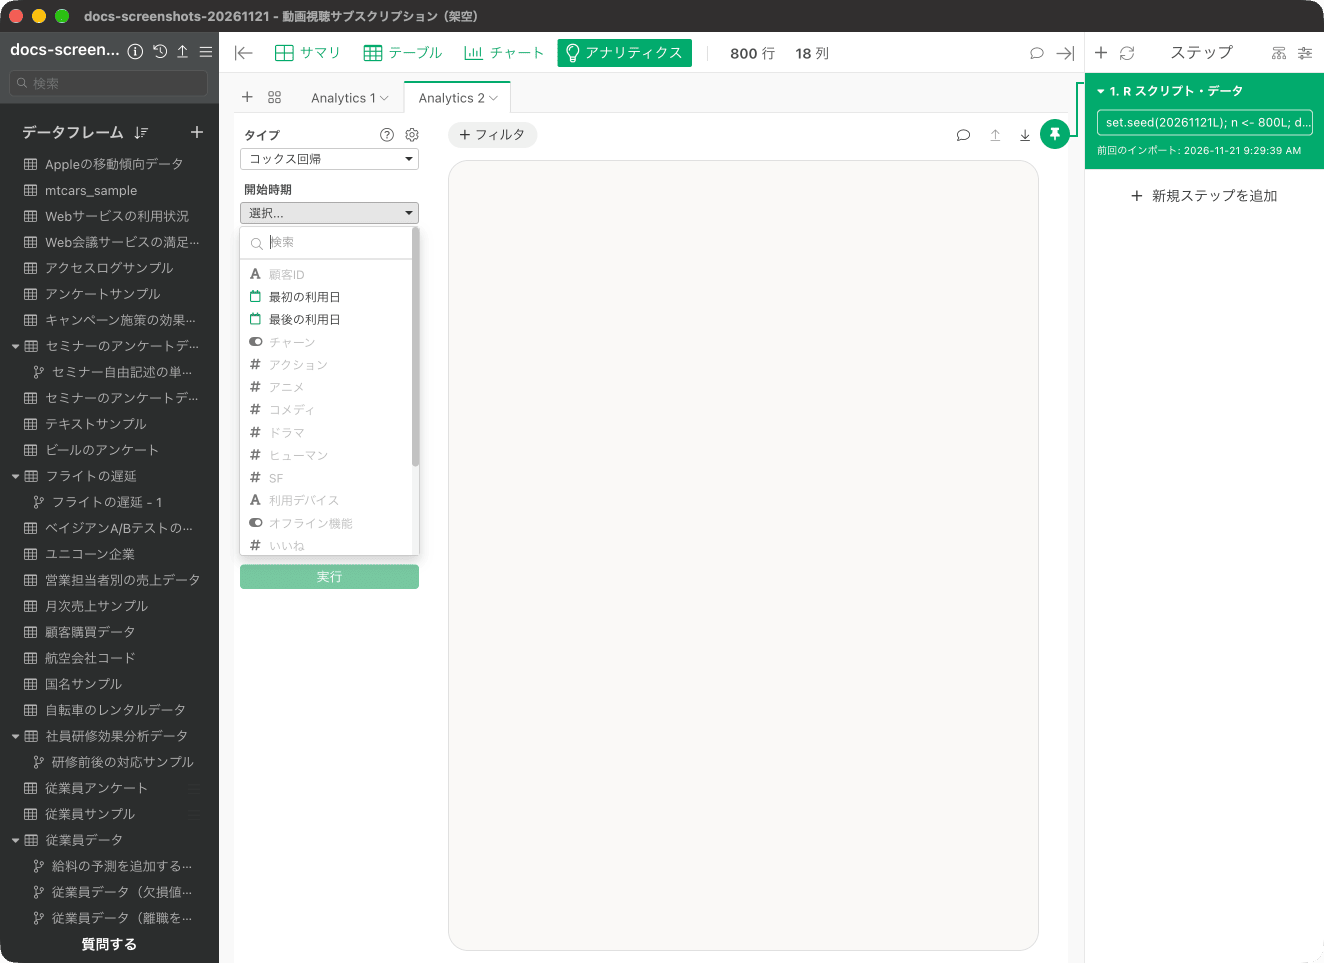
今回は顧客のある時点での生存確率を予測するコックス回帰のモデルを作成します。 アナリティクス・ビューで、タイプの「生存分析」から「コックス回帰」を選択します。 「開始時期」に「最初の利用日」を選択します。 「終了時期」に「最後の利用日」を選択します。 「期間の単位」からは生存期間の単位を設定できます。選べるのは「自動」「日」「週」「月」「四半期」「年」で、初期値は「自動」です。 「生存状態(イベント)」に「チャーン」を選択します。 続いて、「説明変数」の「列の選択と設定」を開き、列名をクリックして選択します。Shiftキーを押しながら列を選ぶことで、一度に複数の列を選択できます。今回は「顧客ID」と「生存時間」を除く、アクションから婚姻ステータスまでの13列を選びます。 選んだらダイアログ右下の「OK」で確定し、分析画面に戻って「実行」ボタンをクリックします。 コックス回帰のモデルが作成されました。結果の上部には「多重共線性」「生存曲線」「変数間の関係」「変数のハザード比」「モデルの指標」のリンクが並びます。
結果の解釈

説明変数の重要度

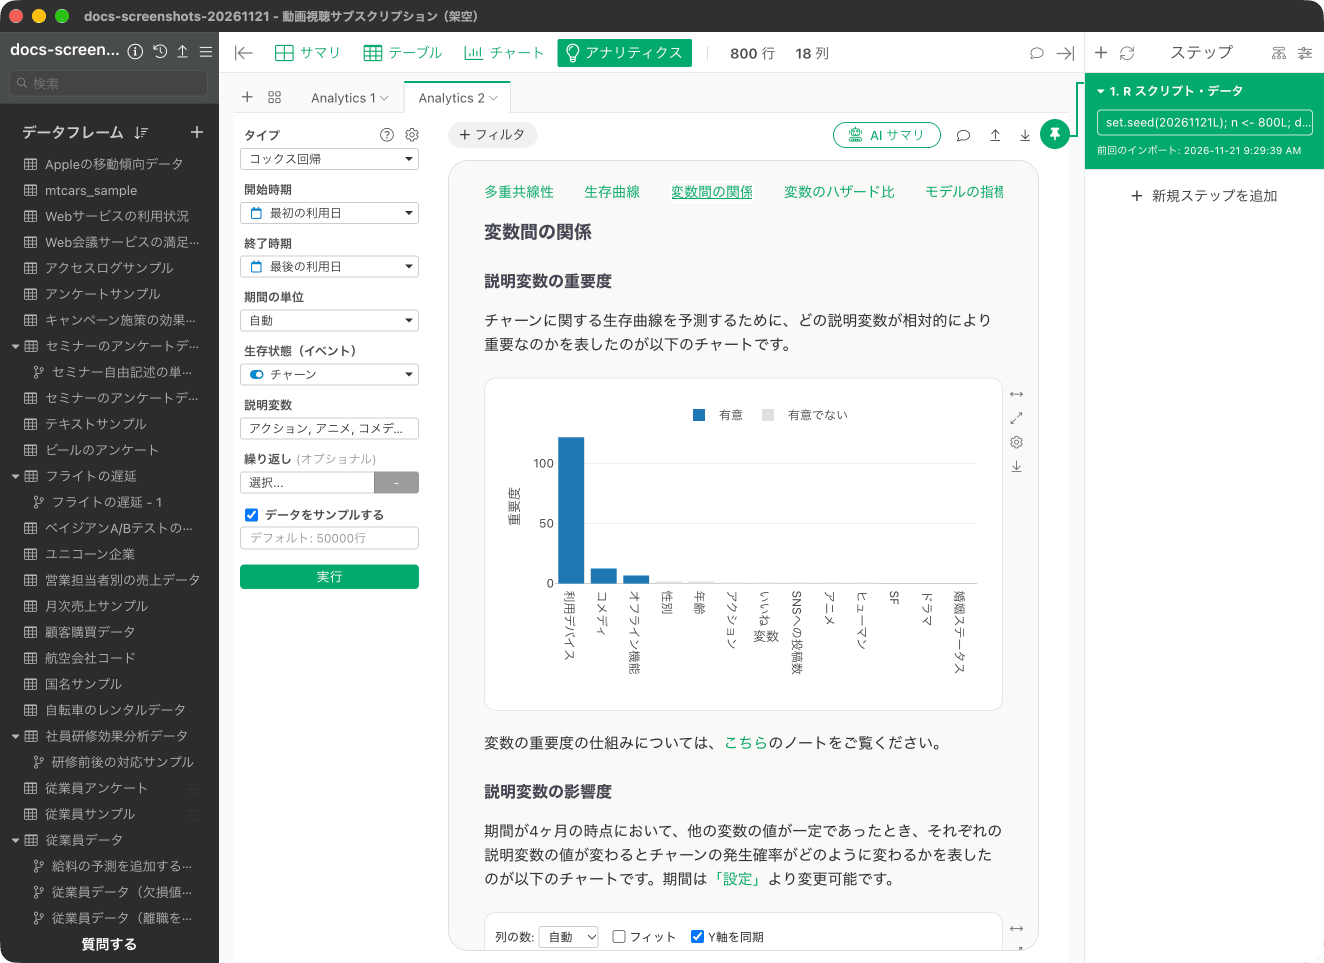
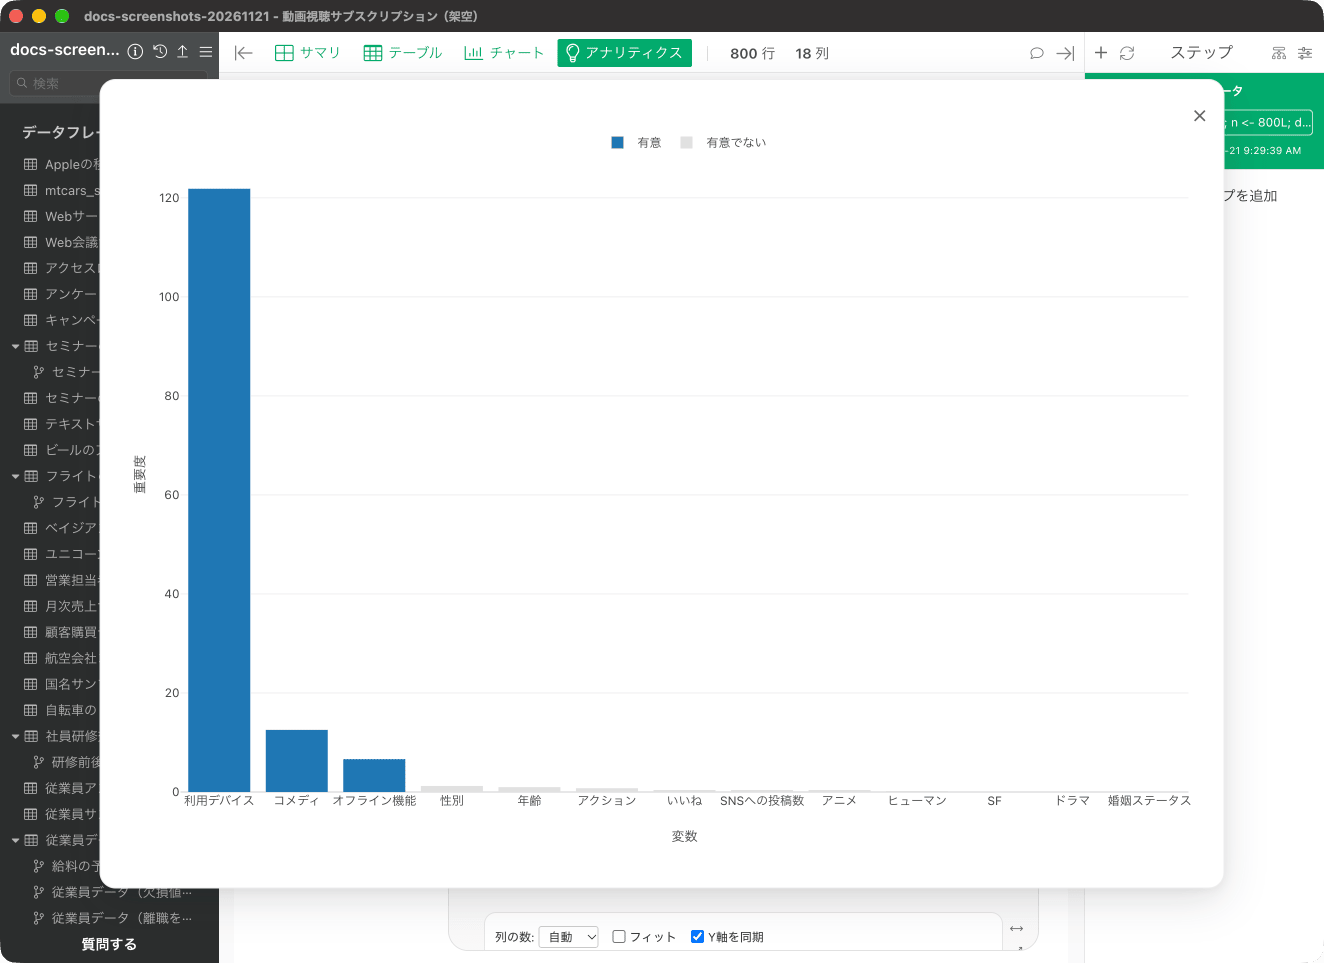
「変数間の関係」の「説明変数の重要度」では、チャーンに関する生存曲線を予測するために、どの説明変数が相対的により重要なのかがチャートで表示されます。凡例は「有意」と「有意でない」です。 拡大すると、「利用デバイス」が最も大きく、次に「コメディ」、「オフライン機能」が続きます。それ以外の変数は小さく、「有意でない」を示すグレーで表示されています。 変数重要度の詳しい説明については、こちらの「機械学習モデル - 変数重要度の仕組みと解釈」のノートをご覧下さい。
説明変数の影響度

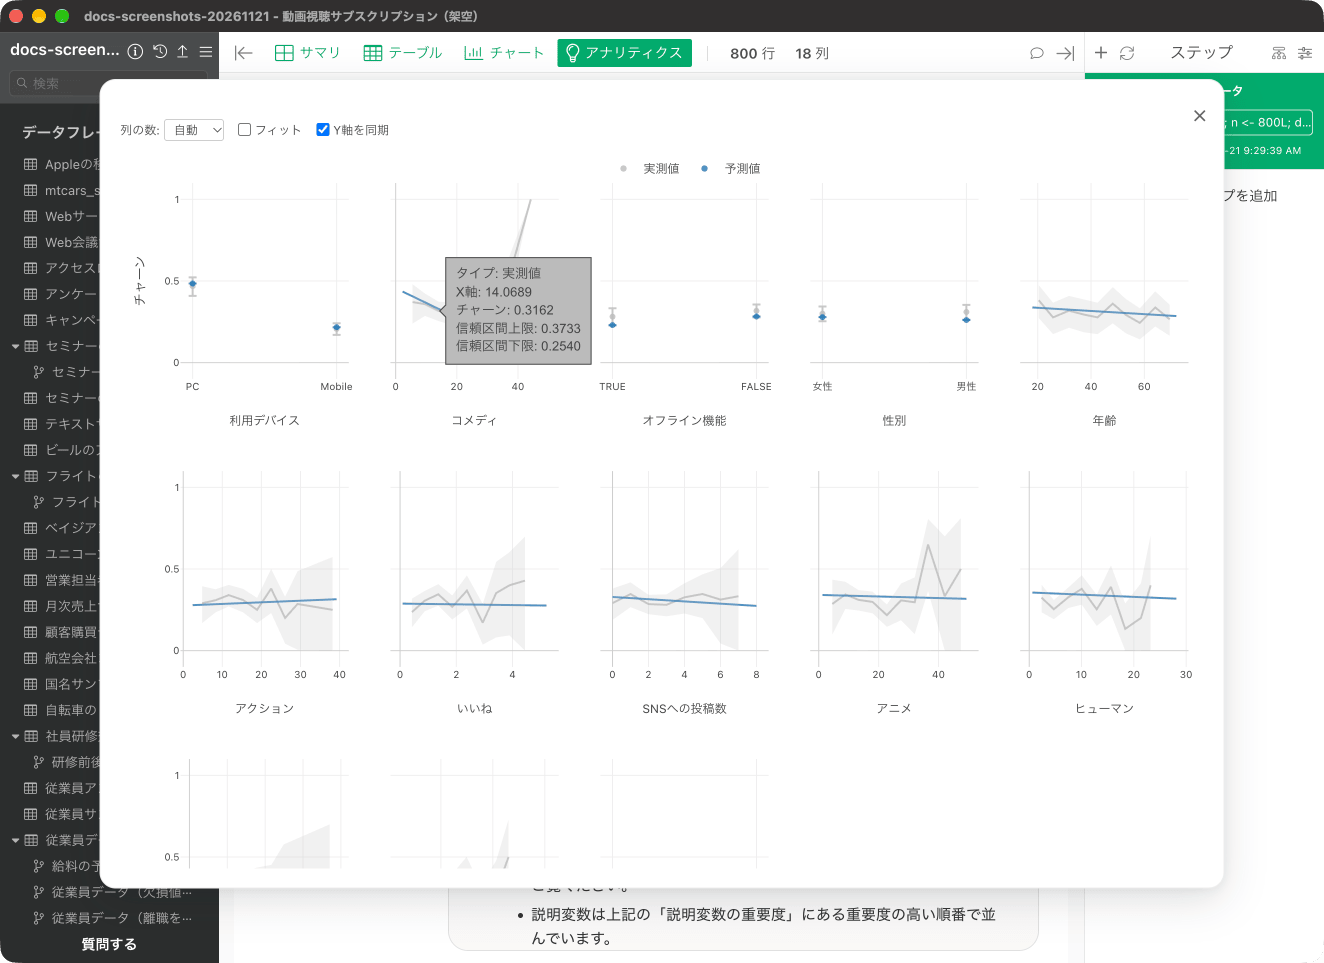
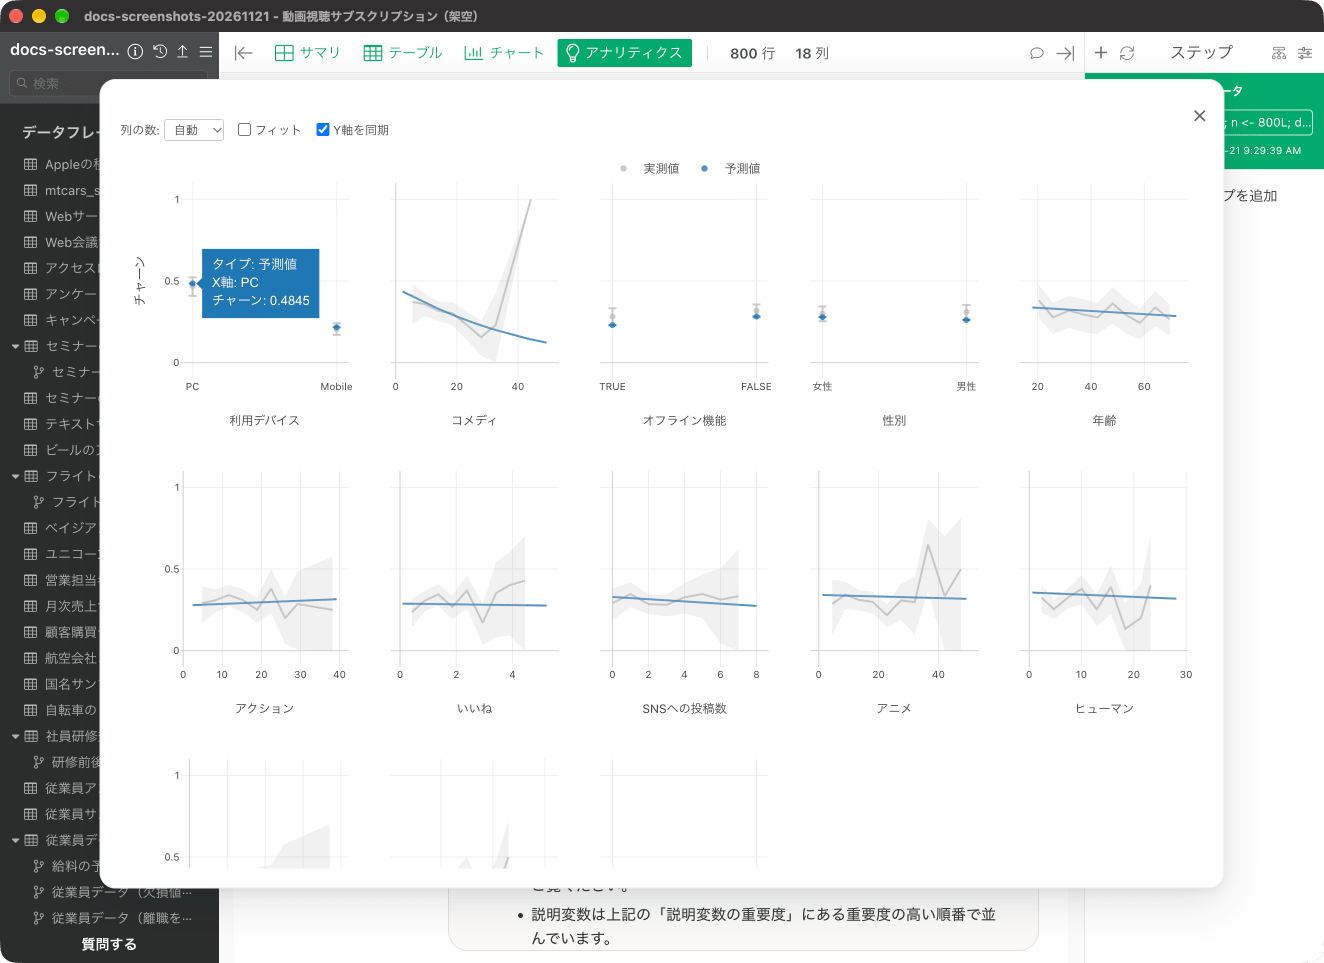
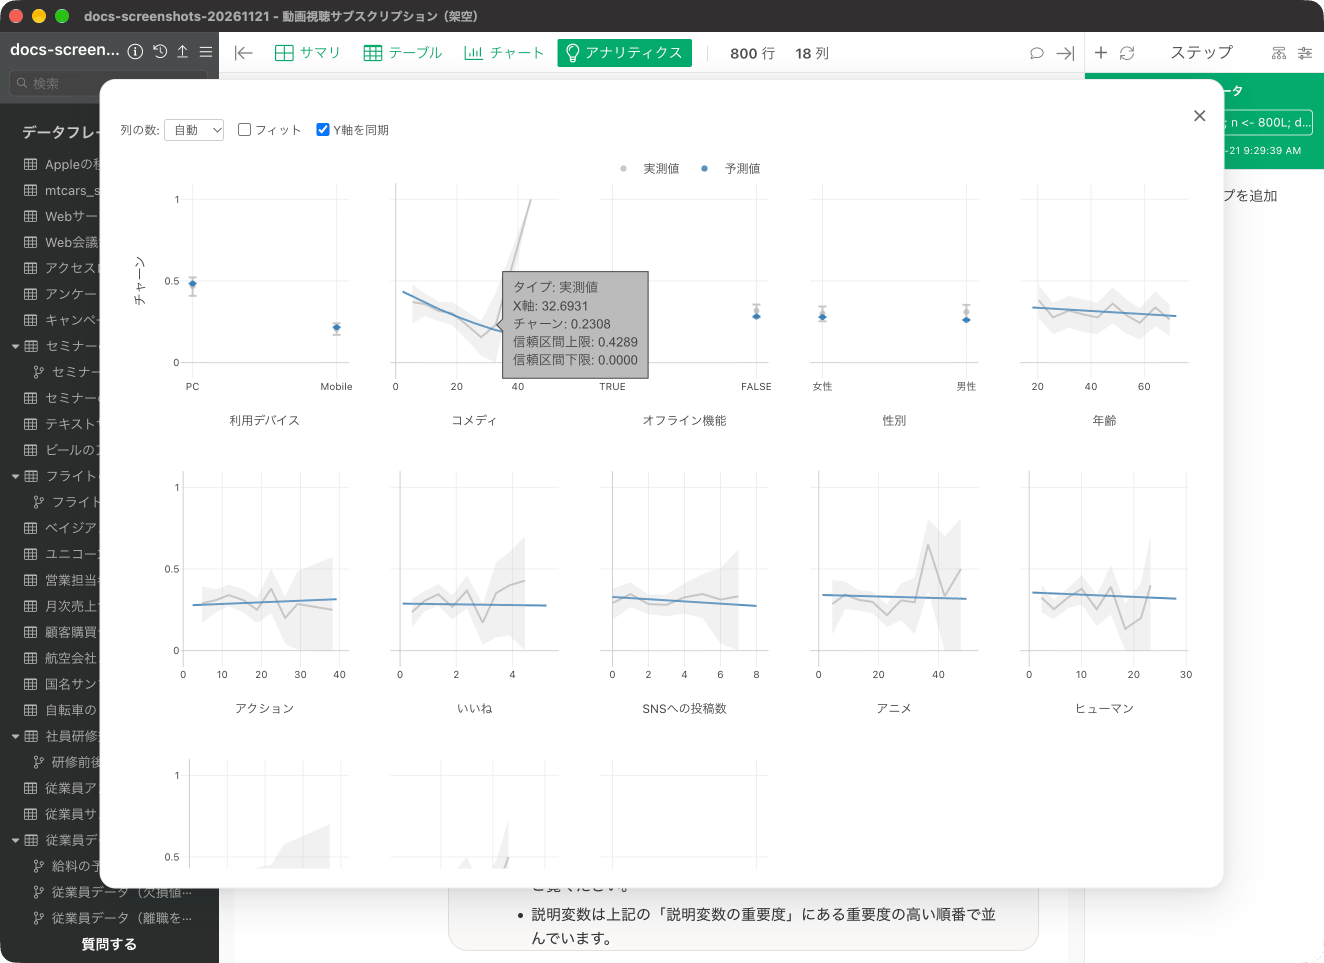
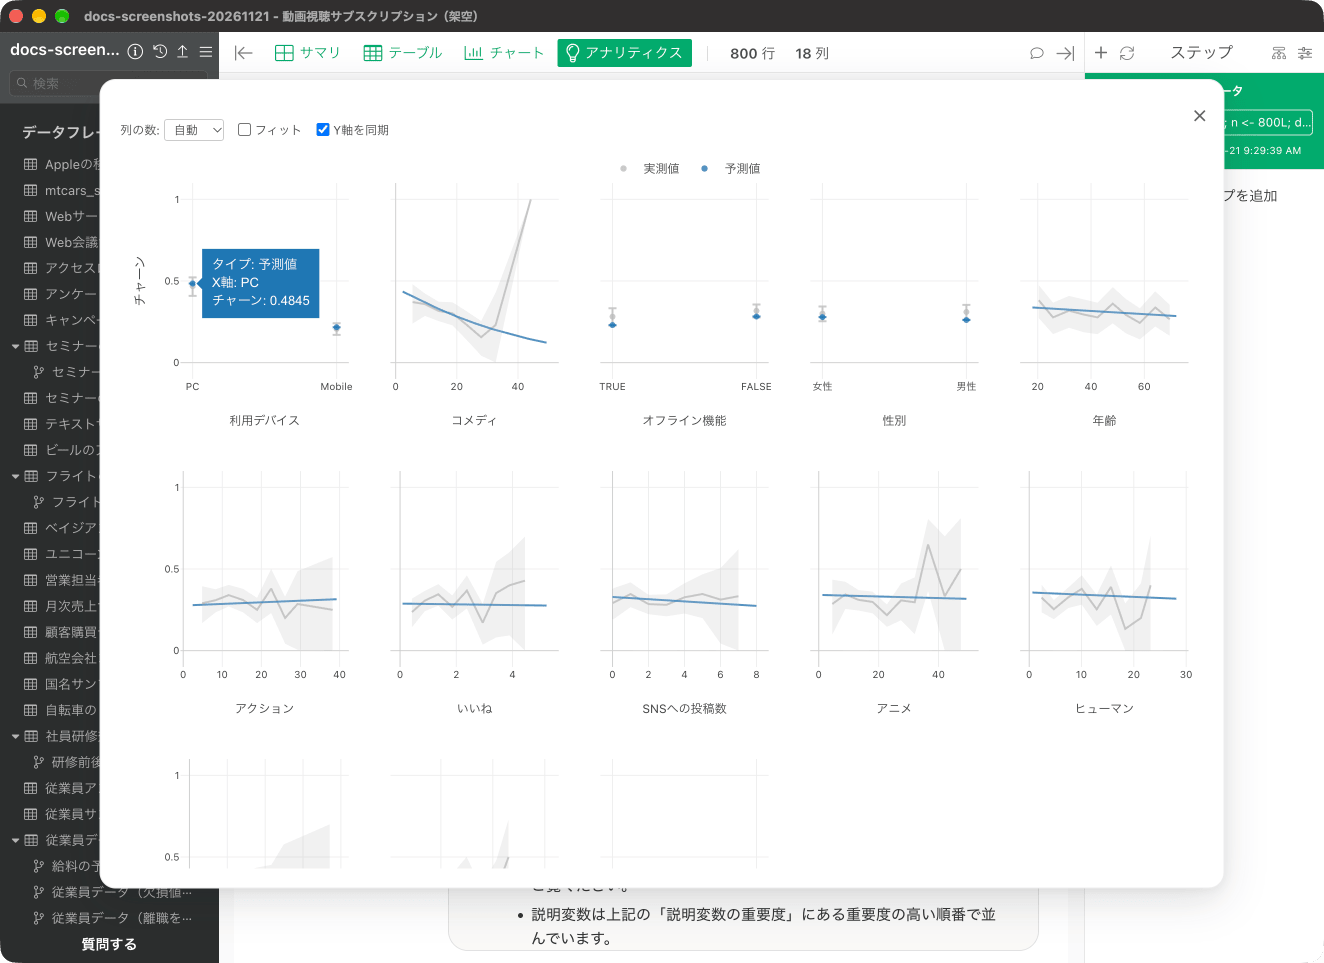
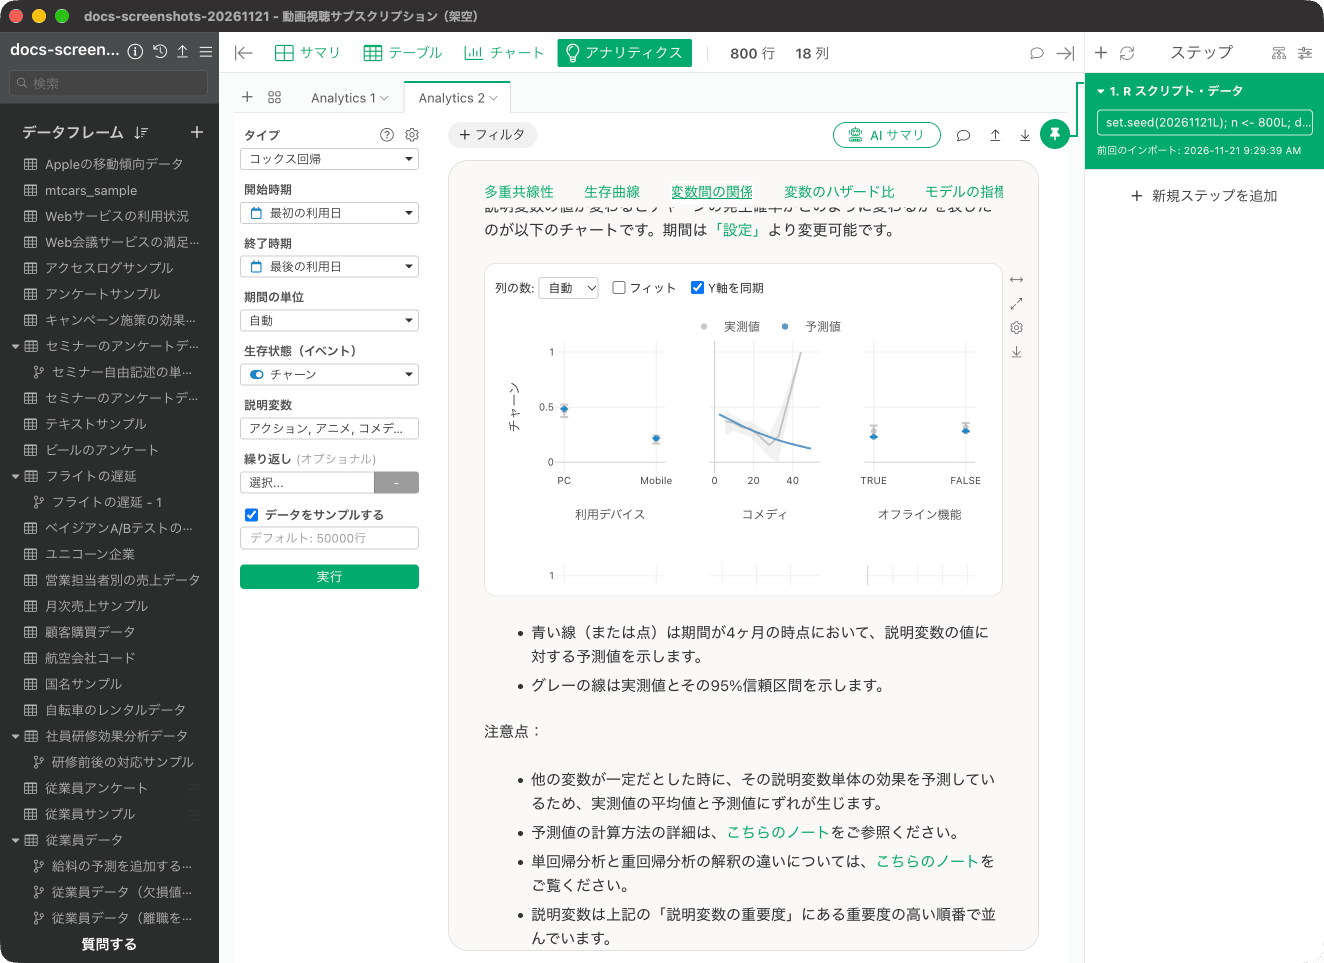
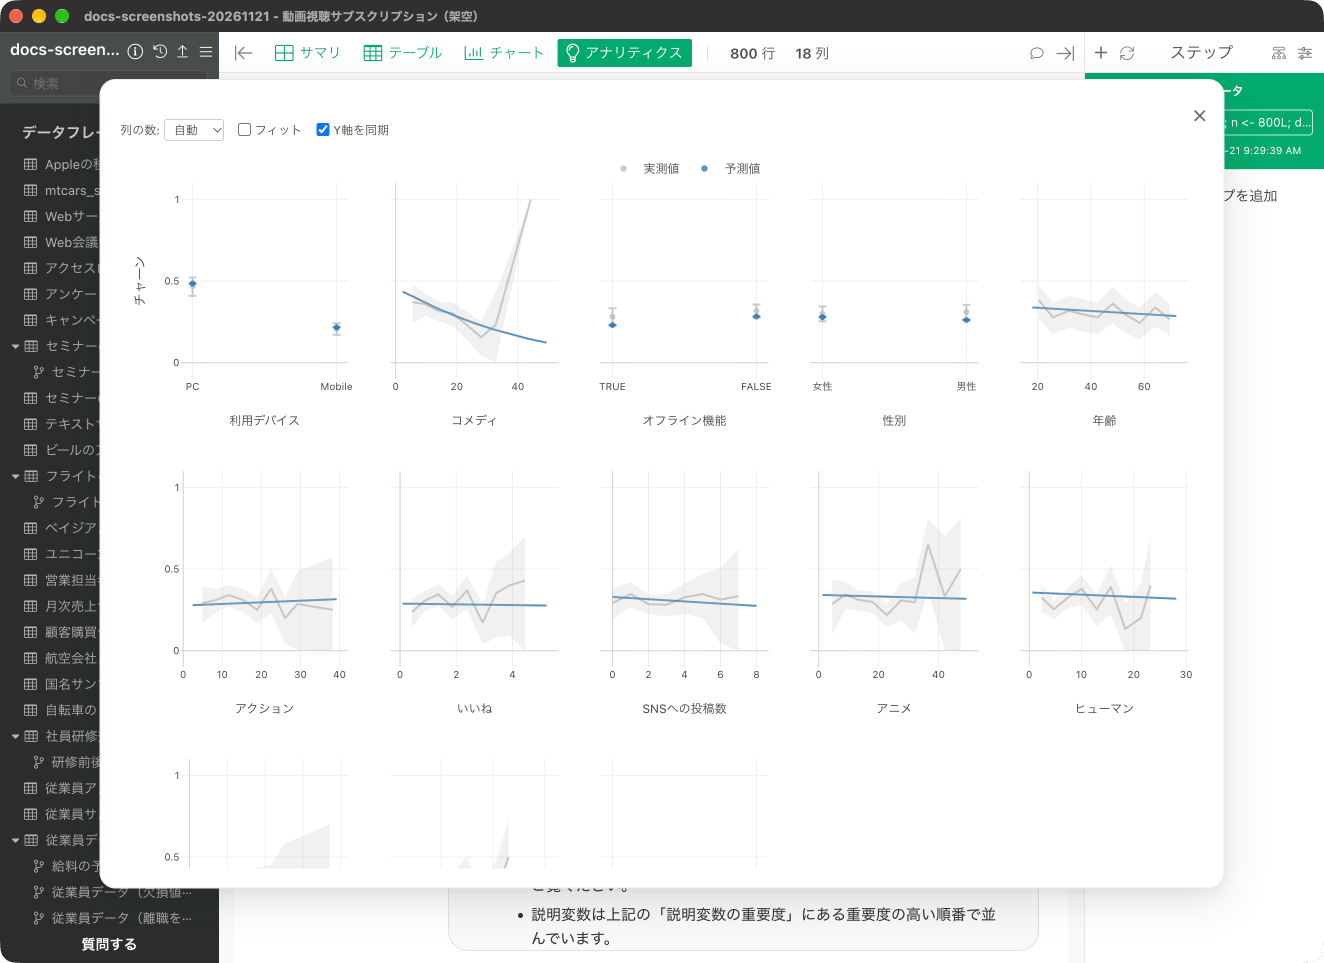
「説明変数の影響度」では、期間が4か月の時点において、他の変数が一定であったとき、それぞれの説明変数の値が変わるとチャーンの発生確率がどのように変わるかが表示されます。画面の説明によると、青い線(または点)は説明変数の値に対する予測値、グレーの線は実測値とその95%信頼区間です。 拡大したチャートです。 グレーの線にポインタを合わせると、実測値が表示されます。たとえば「コメディ」のX軸14.0689では、チャーンが0.3162で、信頼区間は上限0.3733、下限0.2540です。 青い点にポインタを合わせると、予測値が表示されます。「利用デバイス」では、PCのチャーンが0.4845です。 「コメディ」のグレーの線は、X軸32.6931でチャーンが0.2308です。「コメディ」の視聴時間が長いほど、予測値の青い線は下がっており、チャーンが起こりにくい関係がうかがえます。 「利用デバイス」では、PCの予測値(0.4845)は、Mobileの予測値より高く表示されています。
生存曲線

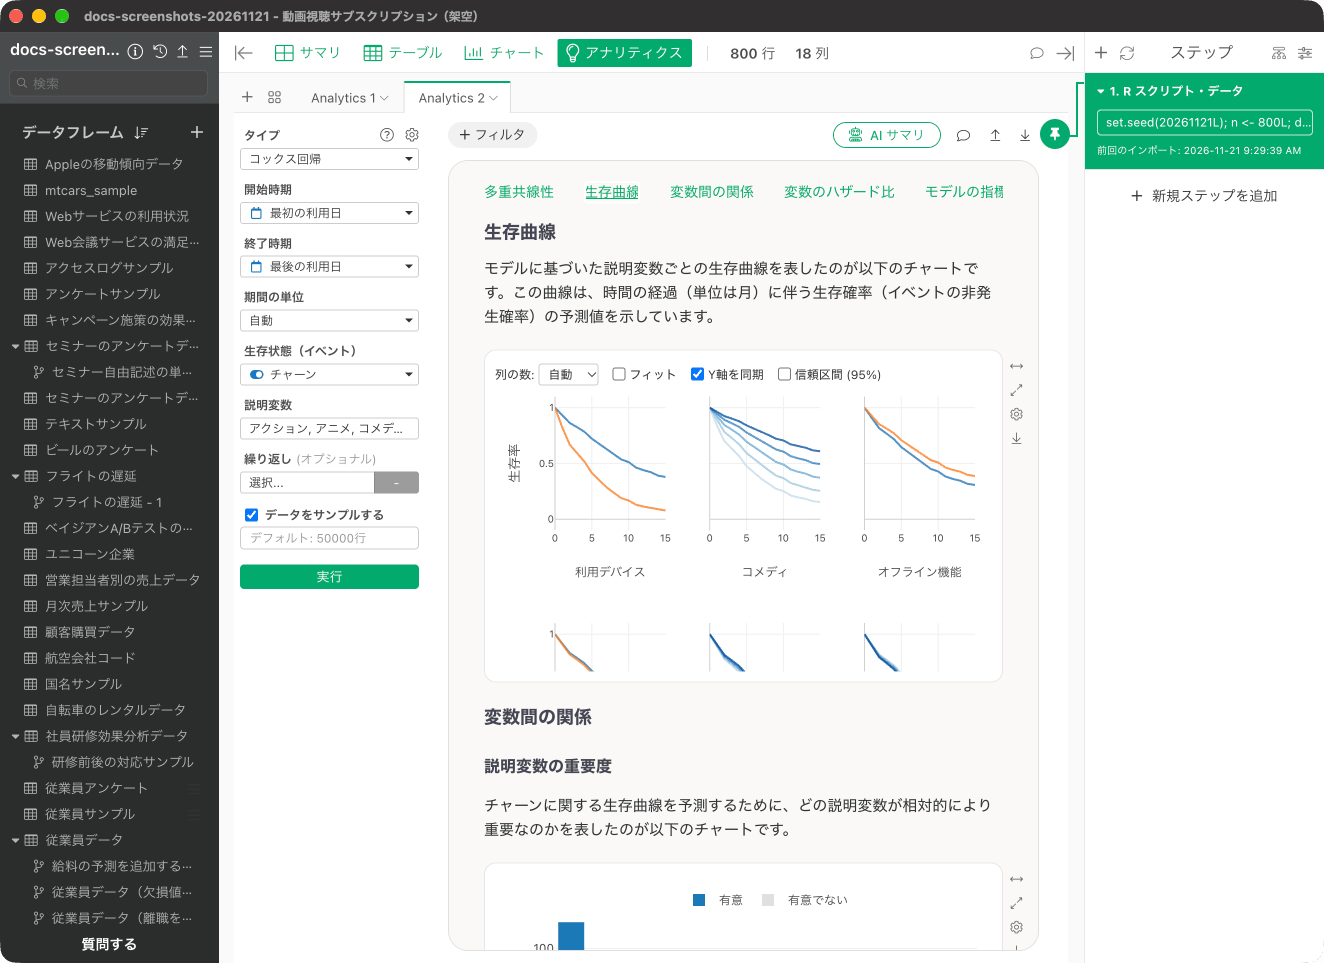
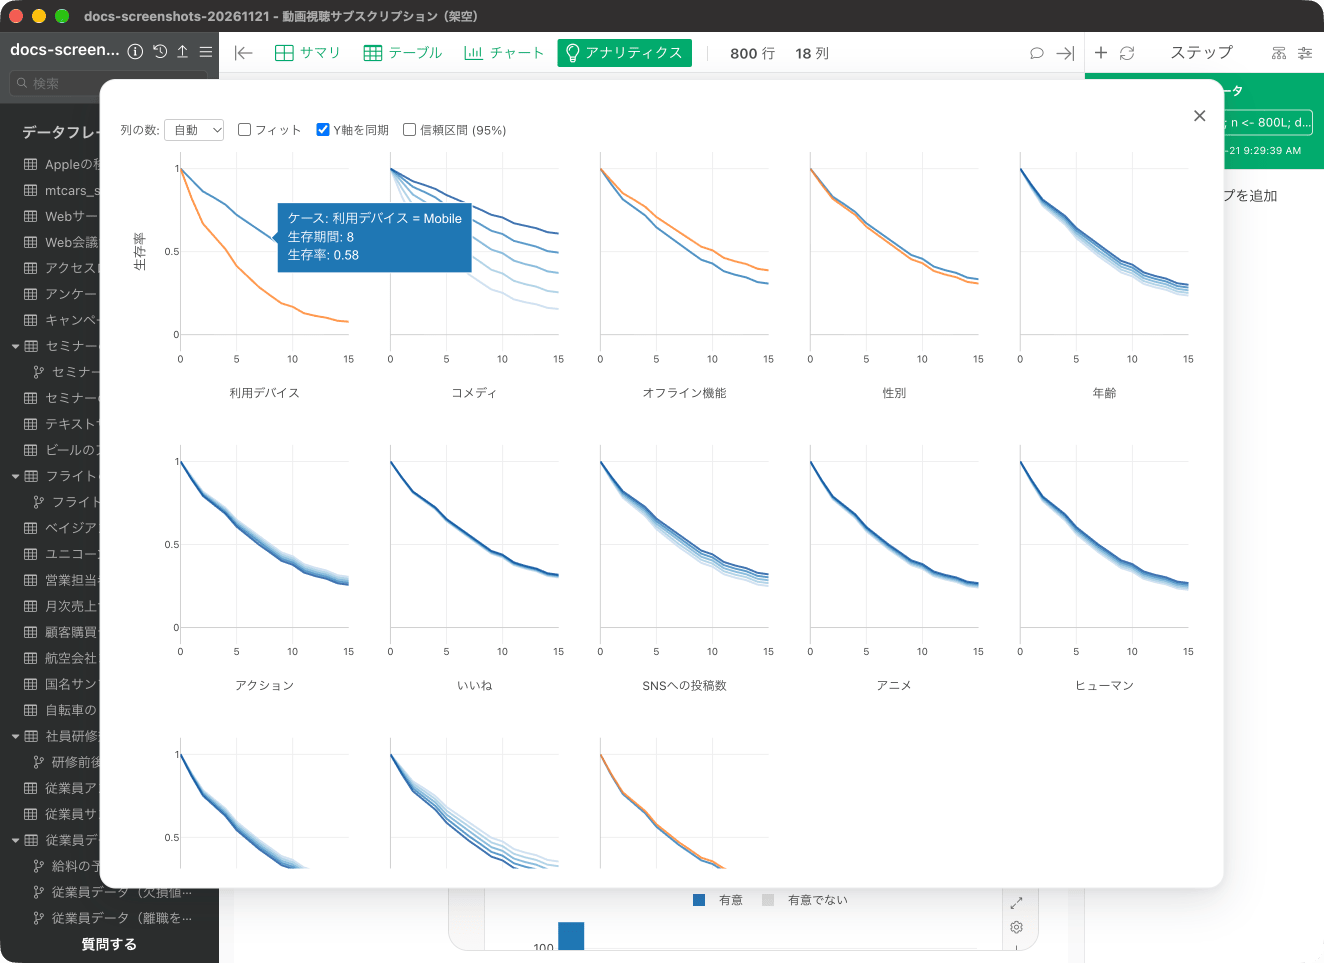
「生存曲線」では、予測される生存曲線が説明変数によってどう変化するのかがわかります。時間の経過の単位は月です。 拡大して「利用デバイス」の曲線にポインタを合わせると、「利用デバイス = Mobile」の曲線は、8か月の時点で生存率が0.58です。もう一方の曲線はそれより低い位置にあり、Mobileのほうが生存曲線が緩やかなため、チャーンが発生しづらいことがわかります。
変数のハザード比

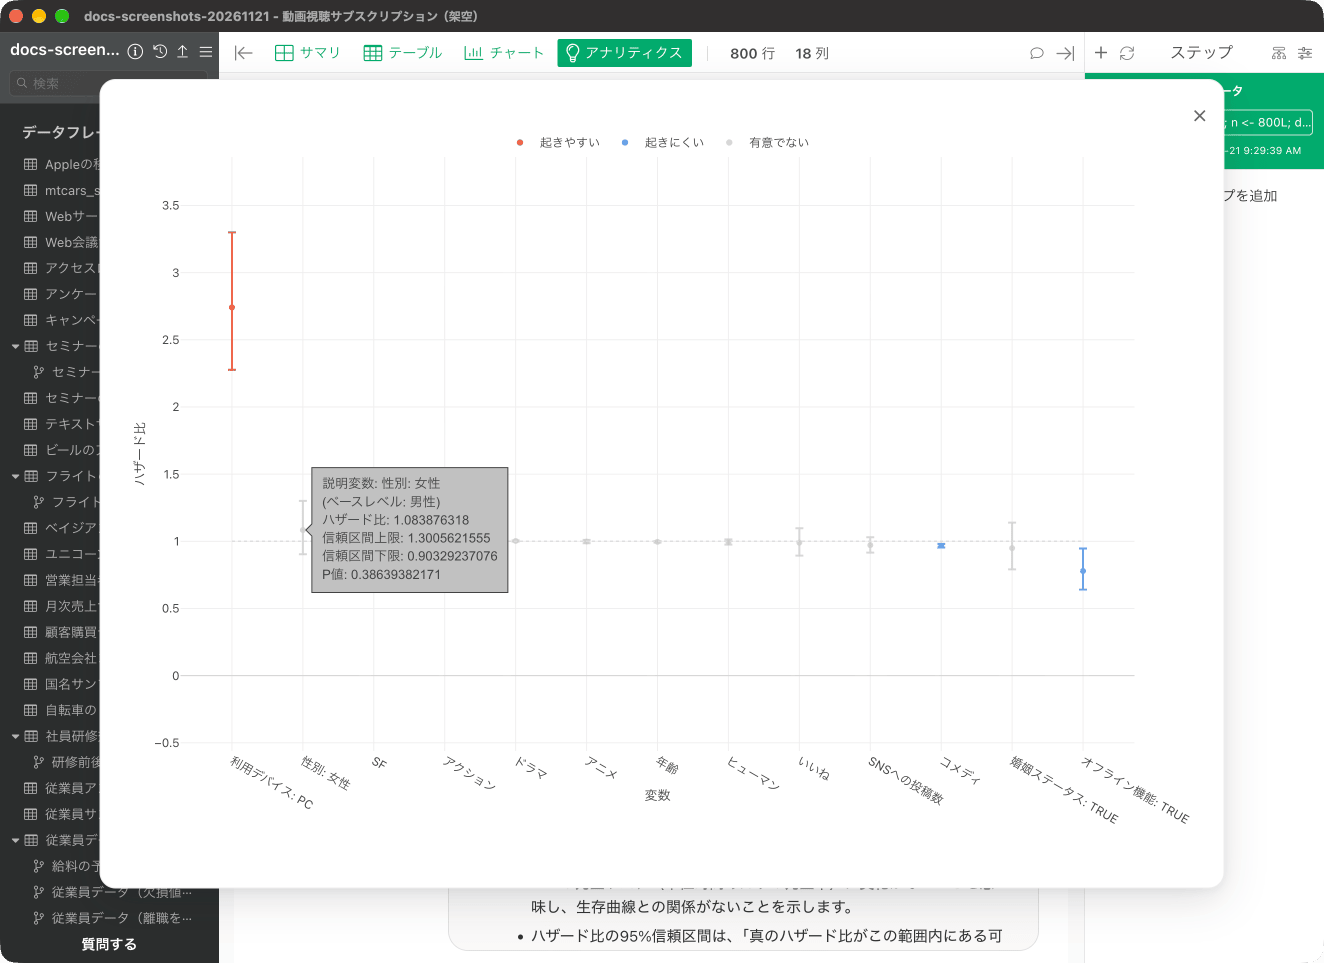
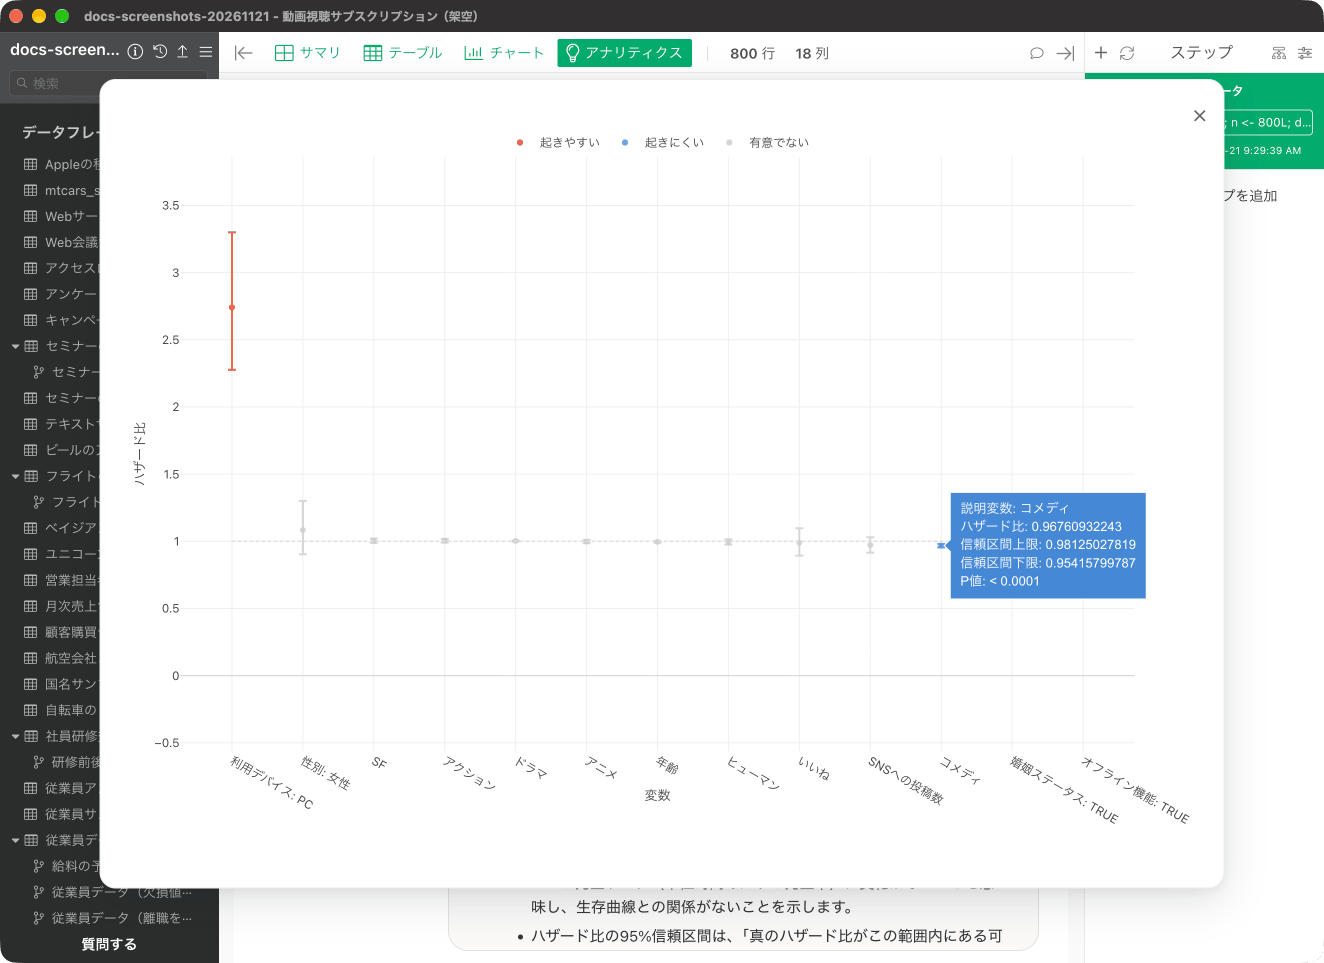
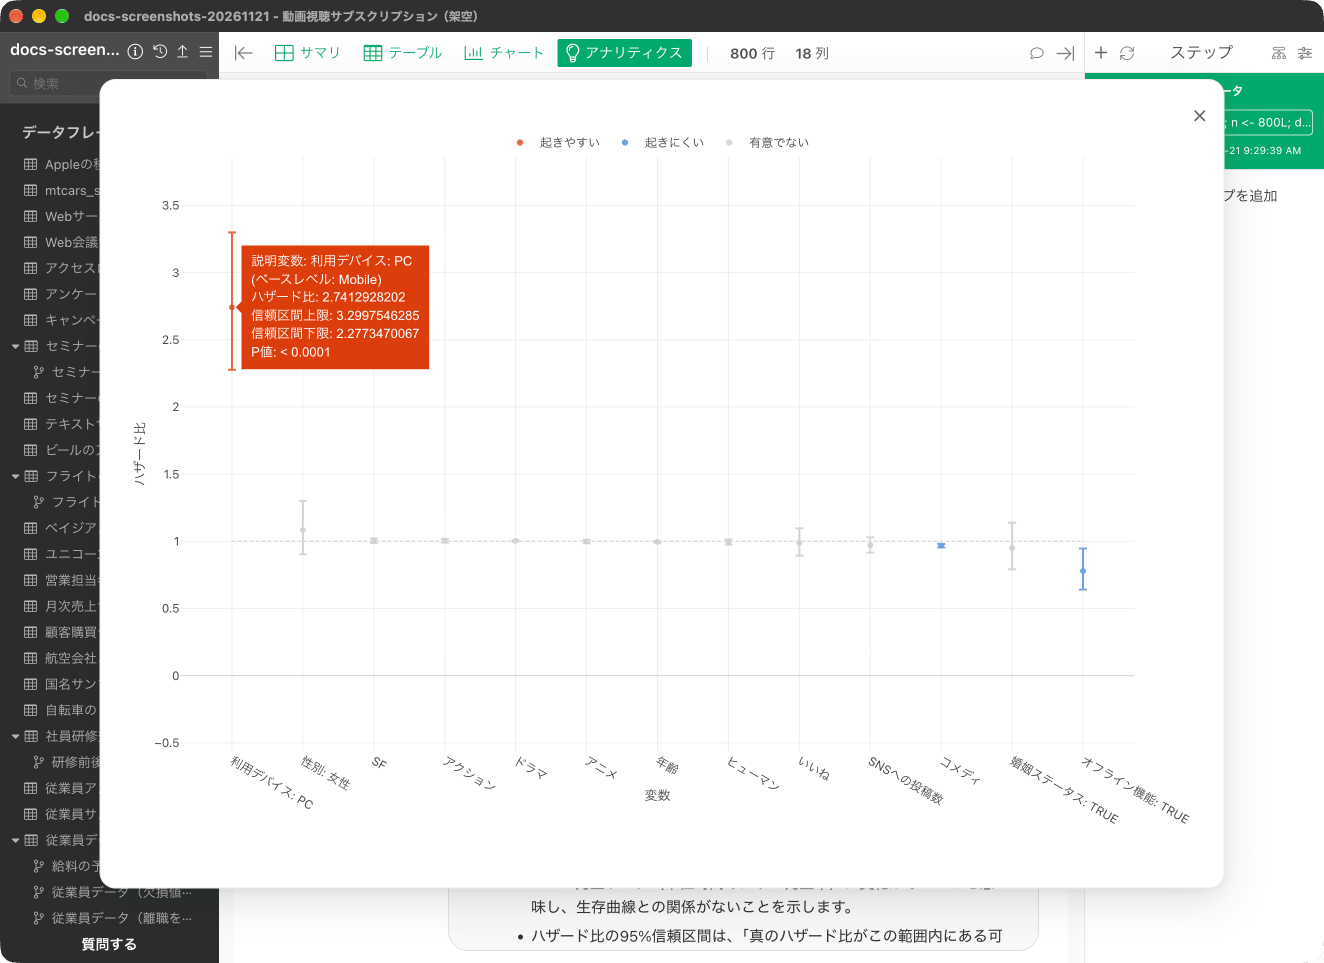
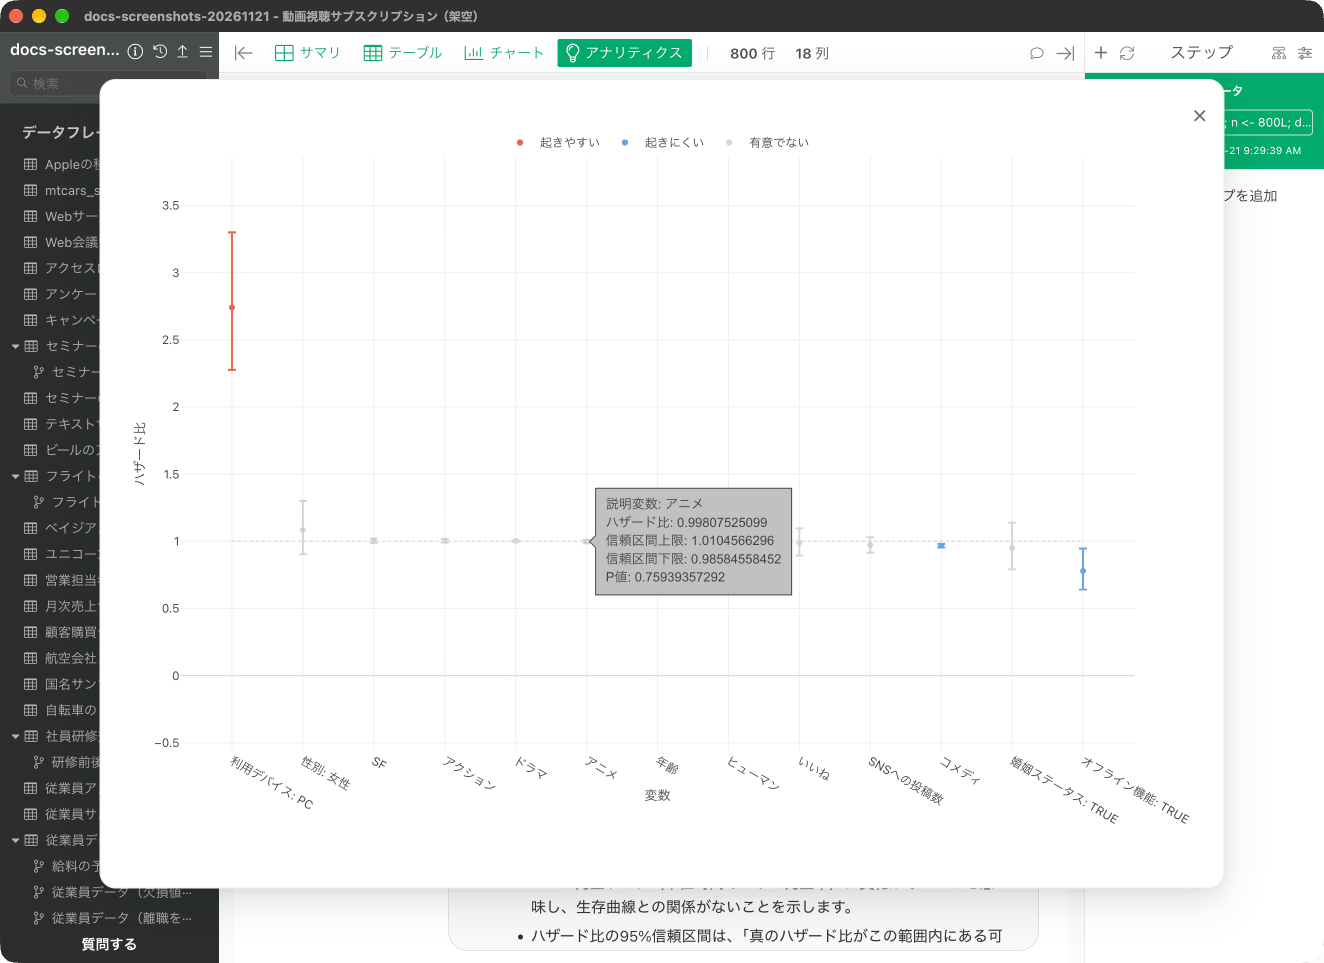
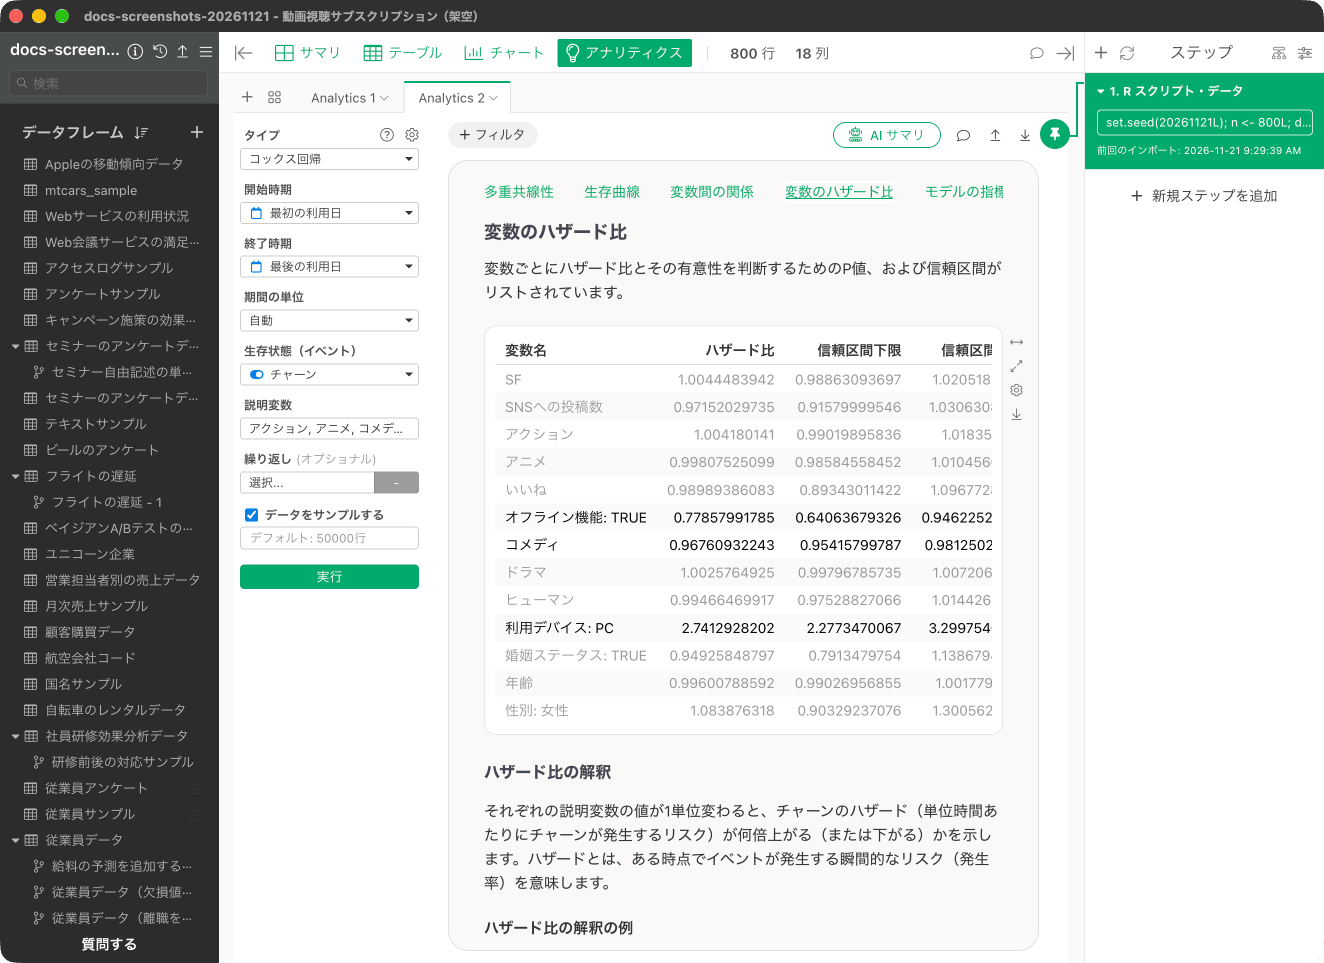
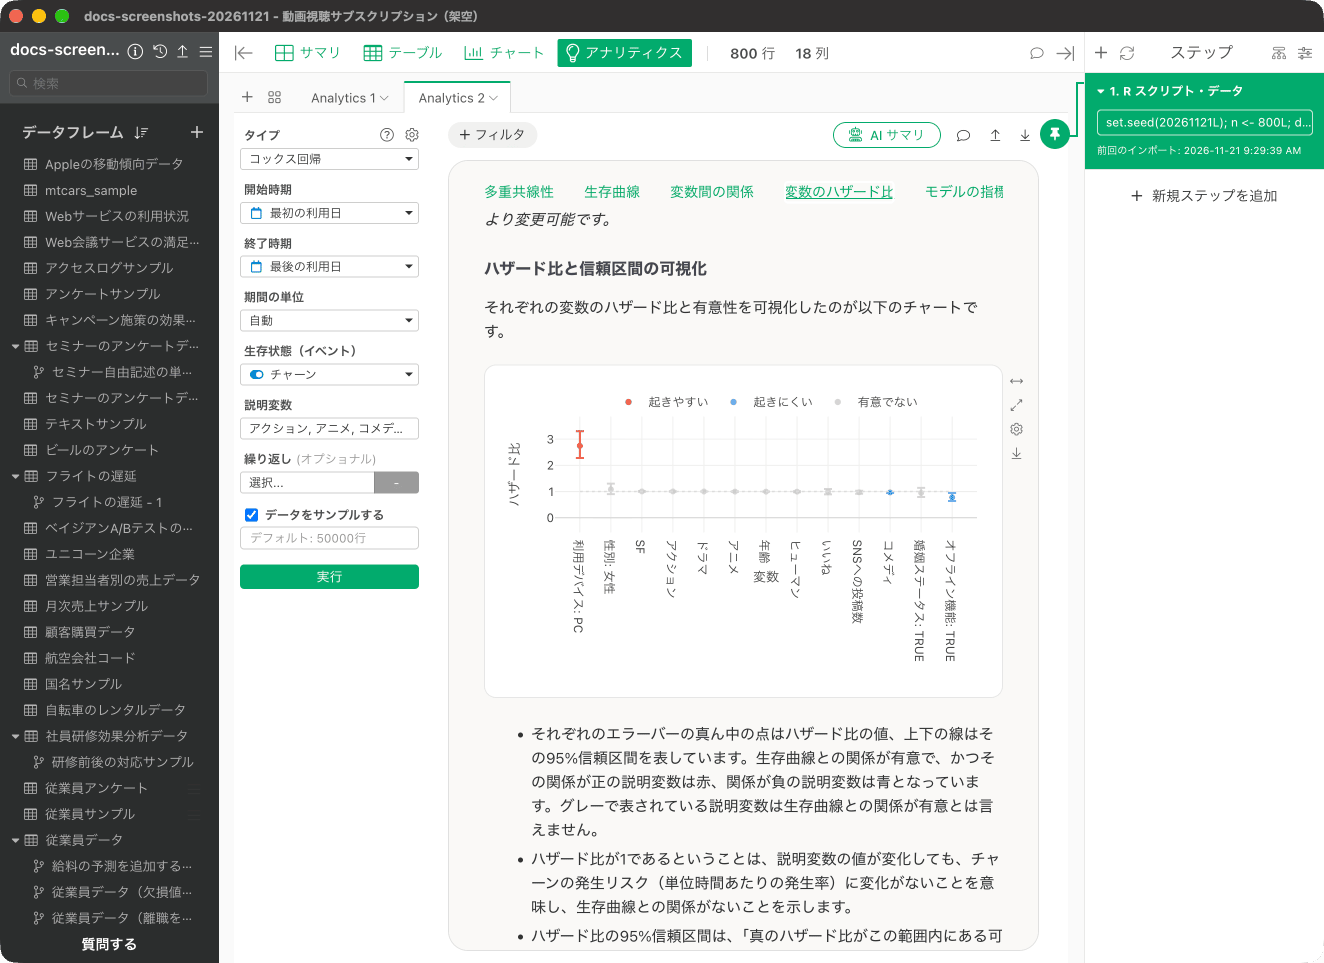
「変数のハザード比」では、説明変数ごとのハザード比と、その有意性を判断するためのP値、信頼区間が表で表示されます。 その下の「ハザード比と信頼区間の可視化」では、それぞれの変数のハザード比と有意性がチャートで表示されます。エラーバーの真ん中の点がハザード比の値、上下の線が95%信頼区間です。有意な変数は、ハザード比が1より大きいと赤(チャーンが起きやすい)、1より小さいと青(起きにくい)で表示され、関係が有意とは言えない変数はグレーで表示されます。 有意でない変数(グレー)は、信頼区間が1にかかっているため、ハザード比が1である可能性があります。たとえば「性別: 女性」(ベースレベルは男性)は、ハザード比が1.0839、信頼区間が0.9033から1.3006で、P値は0.3864です。 「コメディ」は、他の変数が一定だったとき、視聴時間が1上がるとハザード(チャーンが発生するリスク)が0.9676倍になると期待されます。信頼区間は0.9542から0.9813で、P値は0.0001未満です。この場合はチャーンしにくくなるという解釈になります。 続いて、「利用デバイス: PC」に注目します。ベースレベルは「Mobile」で、他の変数が一定だったとき、Mobileから PCになるとハザードが2.7413倍になると期待されます。信頼区間は2.2773から3.2998で、P値は0.0001未満です。 「アニメ」に注目します。他の変数が一定だったとき、視聴時間が1上がるとハザードが0.9981倍になると期待されます。ただし信頼区間は0.9858から1.0105と1をまたいでおり、P値も0.7594と高いため、チャーンに関係があるとは言いきれません。
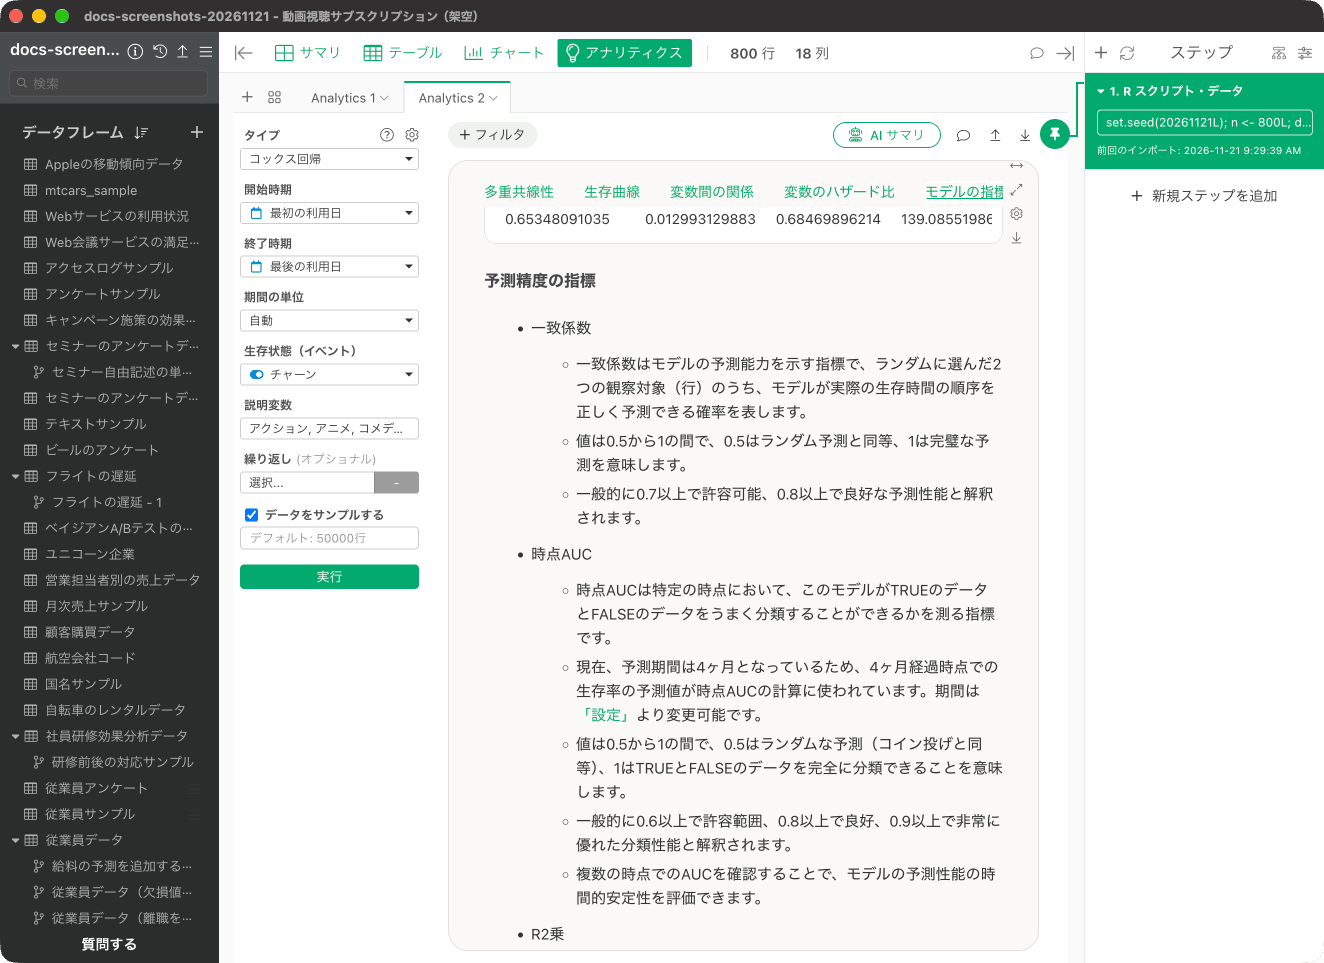
モデルの指標

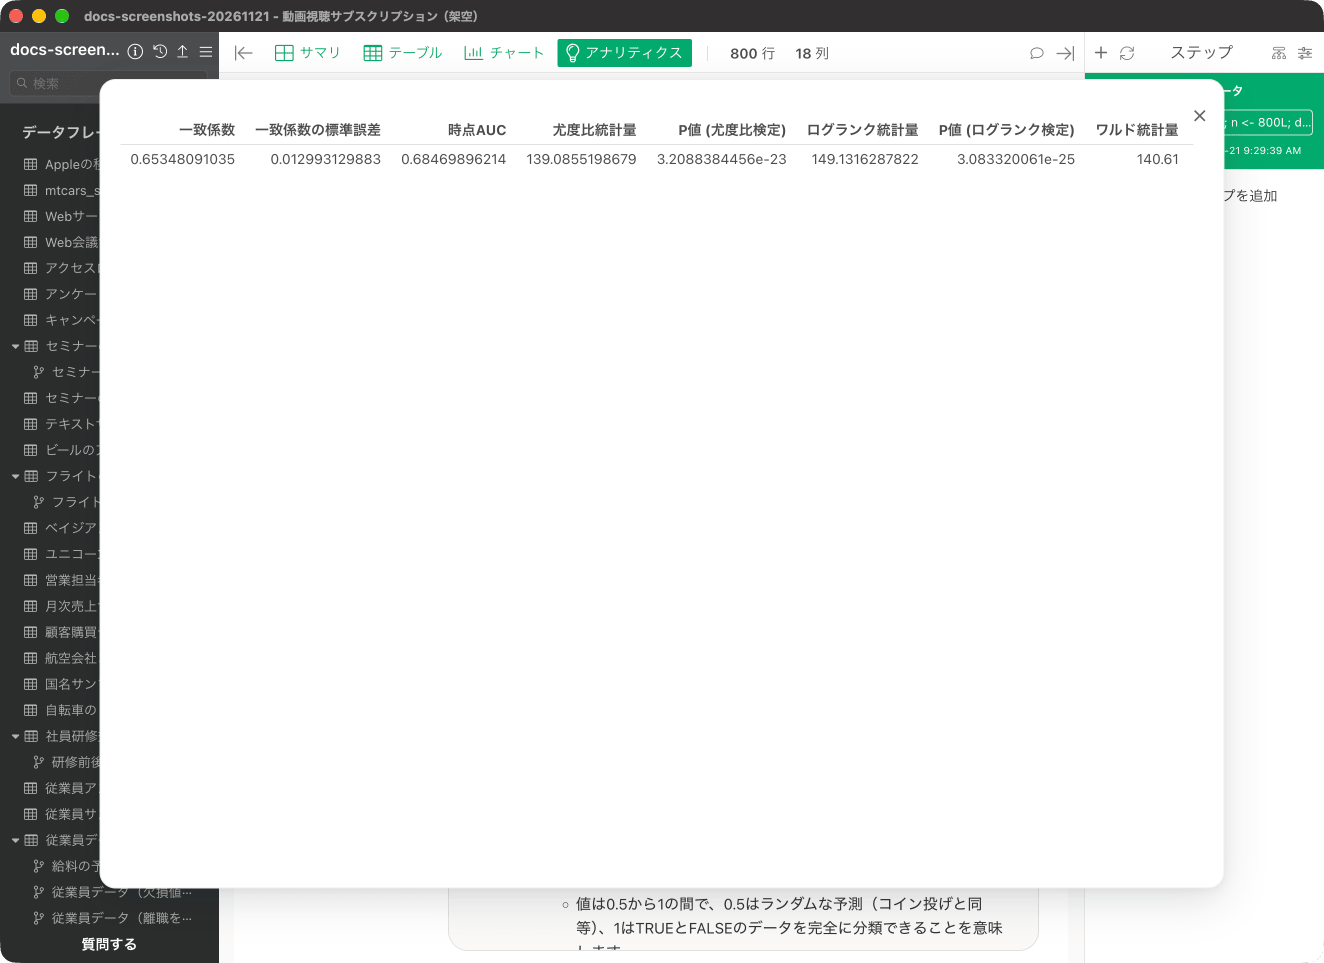
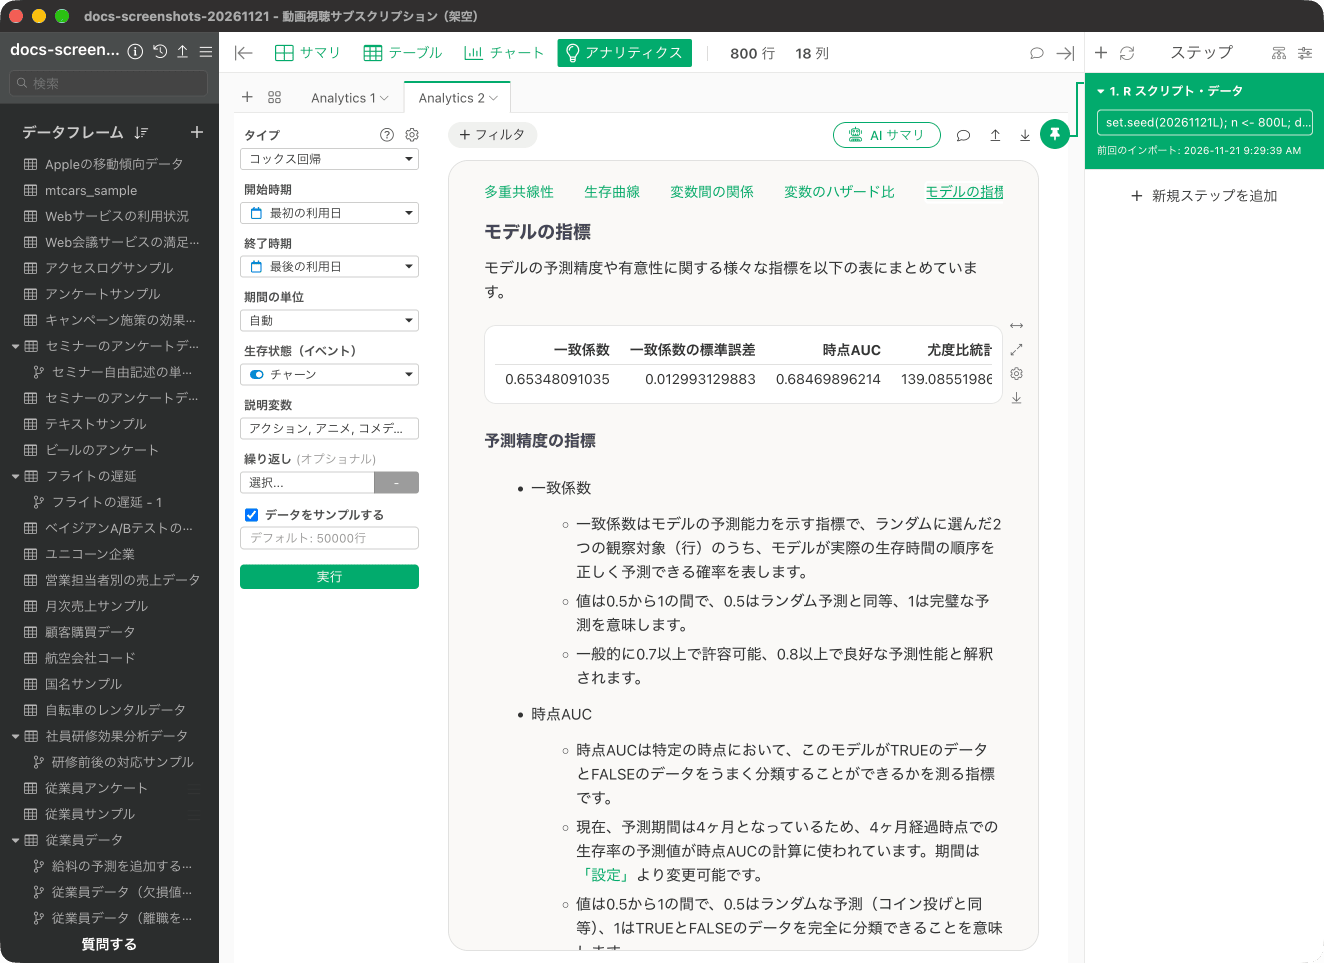
「モデルの指標」では、この予測モデルの評価を確認できます。 表には、一致係数(0.6535)、一致係数の標準誤差(0.0130)、時点AUC(0.6847)、尤度比統計量(139.09)などが並びます。 拡大すると、「P値(尤度比検定)」「ログランク統計量」「P値(ログランク検定)」「ワルド統計量」も確認できます。 時点AUCは、ある時点におけるチャーンのTRUE/FALSEをこのモデルでどれだけ上手く分けられているかの指標で、0から1の間の値を取ります。0.5はランダムに順位を付けた場合の目安で、1に近ければ近いほど、モデルがデータのTRUE/FALSEを上手く分けられていることを示します。画面では、予測期間が4か月のため、4か月経過時点での生存率の予測値が時点AUCの計算に使われると説明されています。 今回の4か月時点の時点AUCは0.6847で、1には近くありません。0.5よりは大きいので、ランダムな予測よりは分けられていますが、TRUEとFALSEをそこまで上手く分けられているとは言えません。 一致係数は、データの各観察対象に対して、イベントの起きやすさ(チャーンの確率)をモデルで予測して、イベントが起きやすいと予測される順に観察対象を並べ、実際にイベントが起きた順番と比較して、どれほど一致しているかを数値化したもので、0から1の間の値を取ります。一致係数の値が1に近いほど、モデルで予測した結果と実際のイベントが起きた順番が一致していることを示します。今回は一致係数が0.653で、1に近くはありません。
ROC曲線

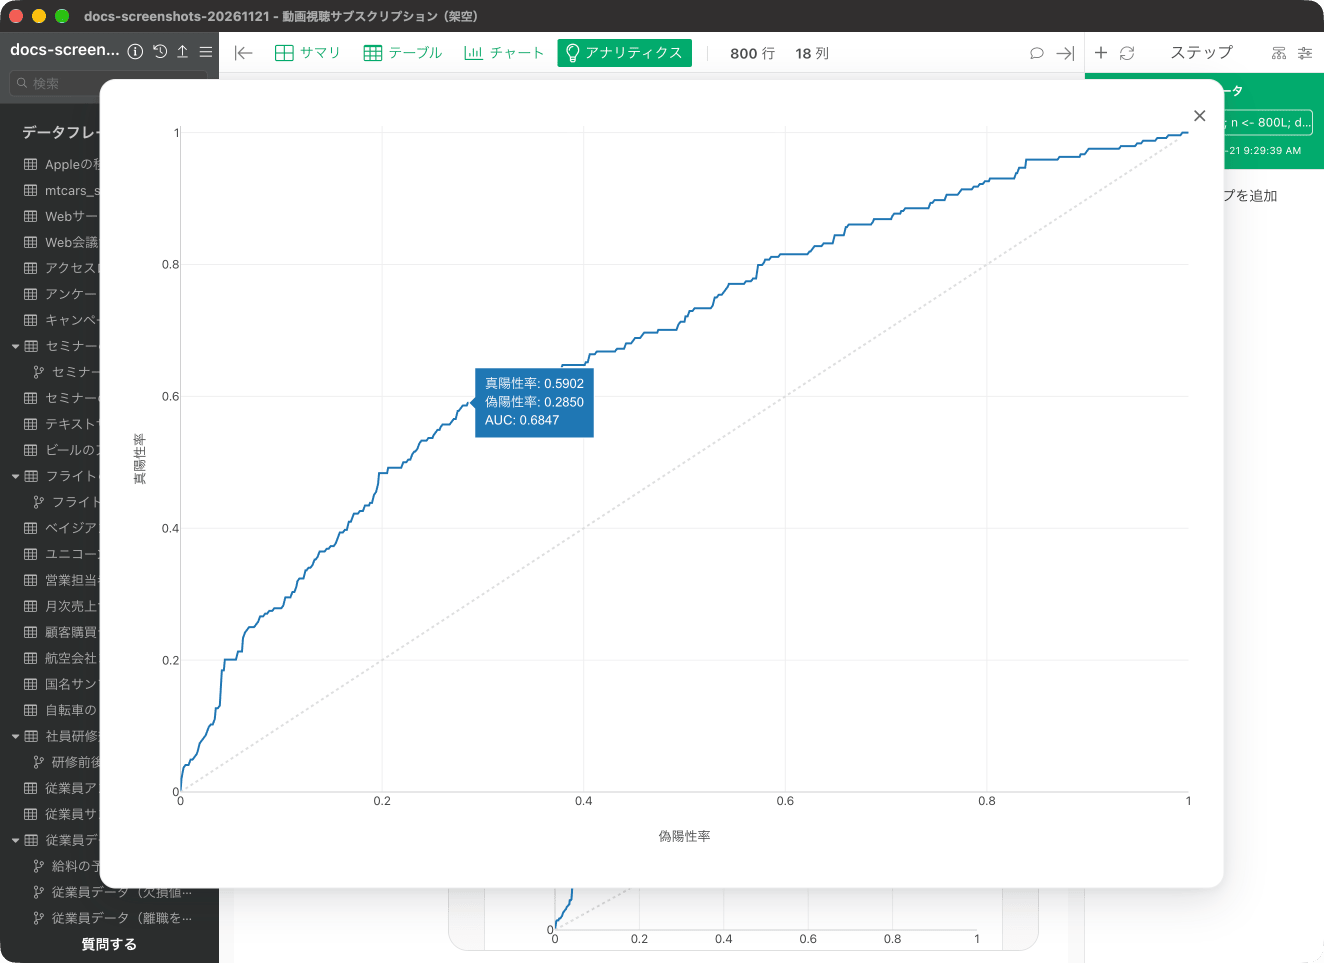
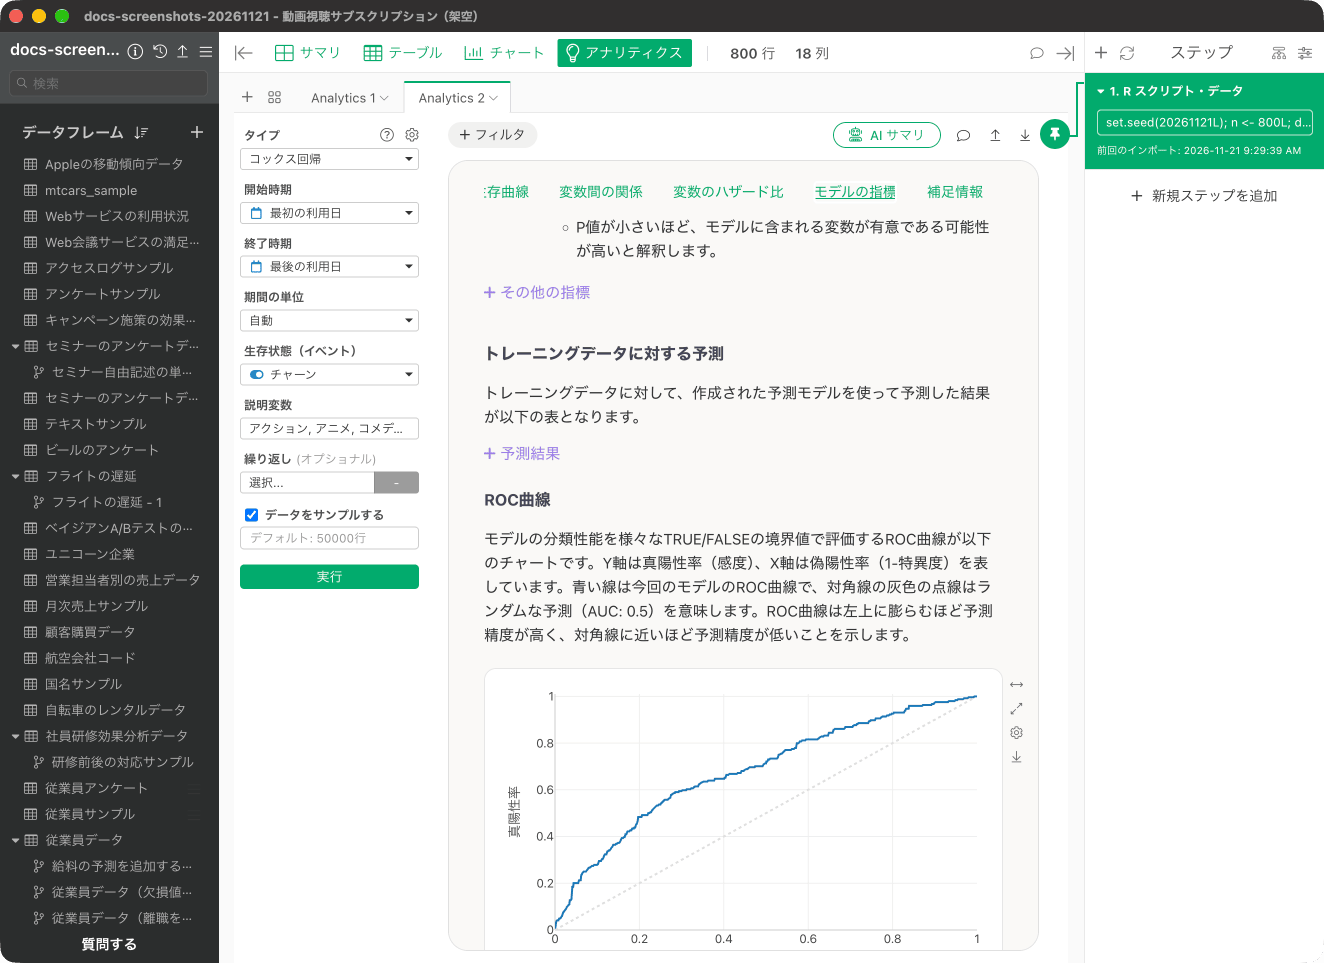
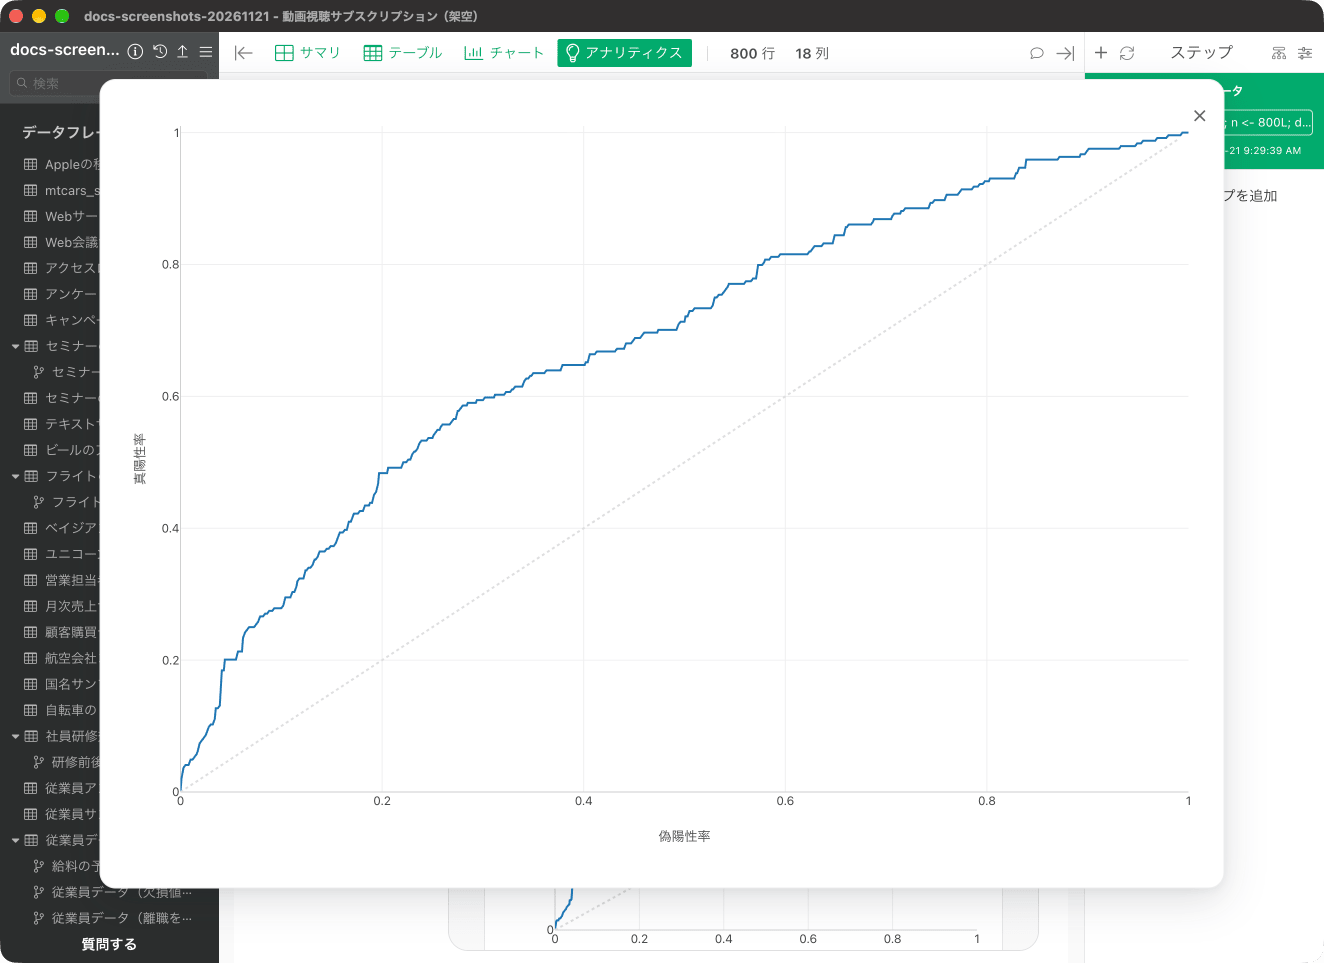
「ROC曲線」では、時点AUCの元となる面積をROC曲線から確認できます。Y軸は真陽性率、X軸は偽陽性率で、青い線が今回のモデル、対角線の点線がランダムな予測(AUC: 0.5)です。 拡大したチャートです。 曲線にポインタを合わせると、真陽性率0.5902、偽陽性率0.2850、AUC 0.6847と表示されます。対角線はAUCが0.5のランダムな予測を表し、時点AUCが高いほど曲線は左上に膨らみます。今回の4か月時点のAUCは0.6847で、曲線はランダムな予測の対角線より上にありますが、大きくは膨らんでいません。
予測結果

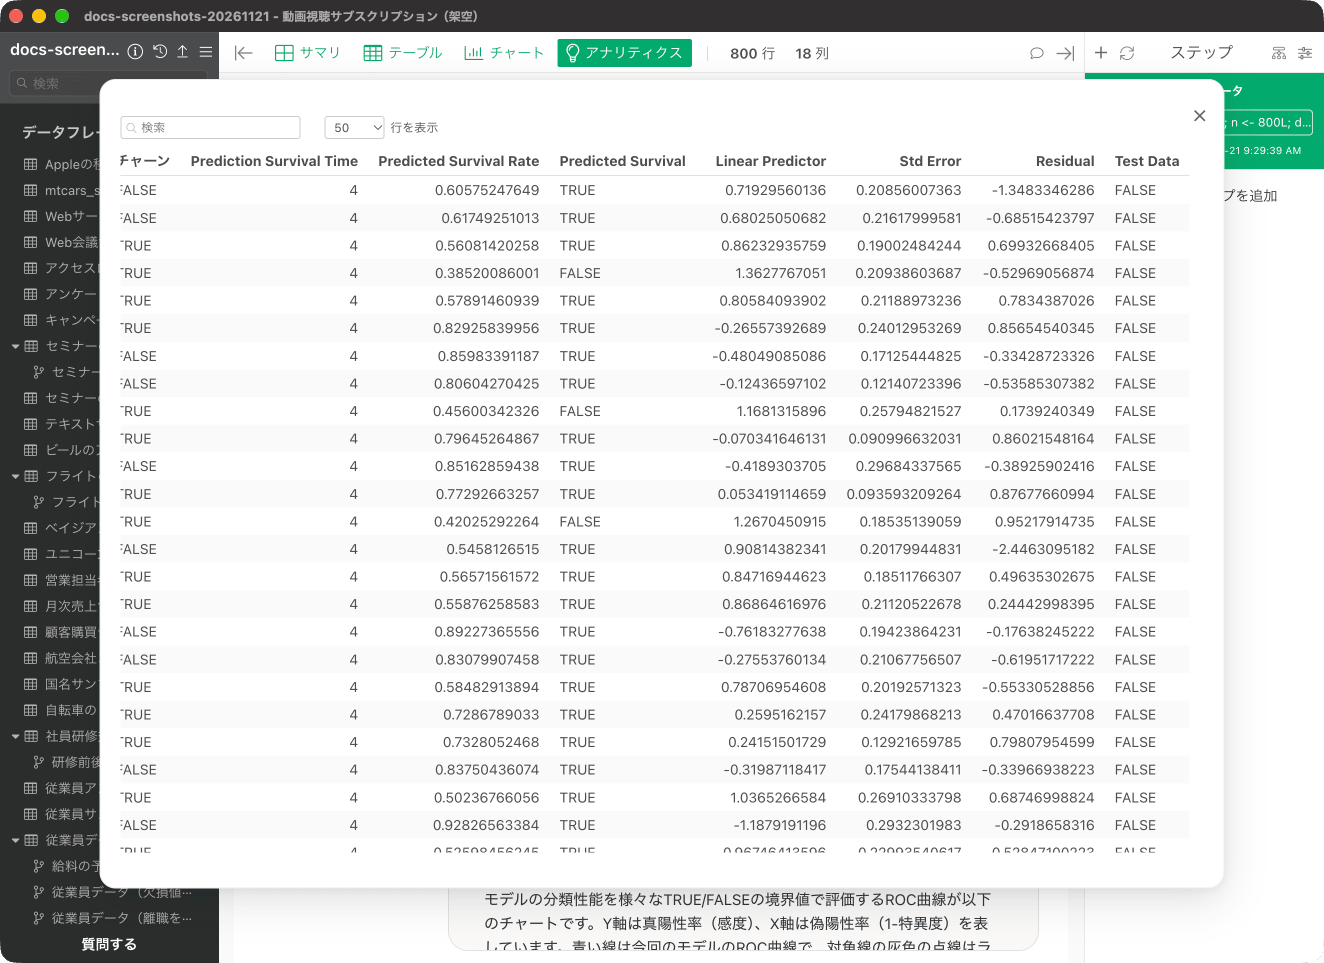
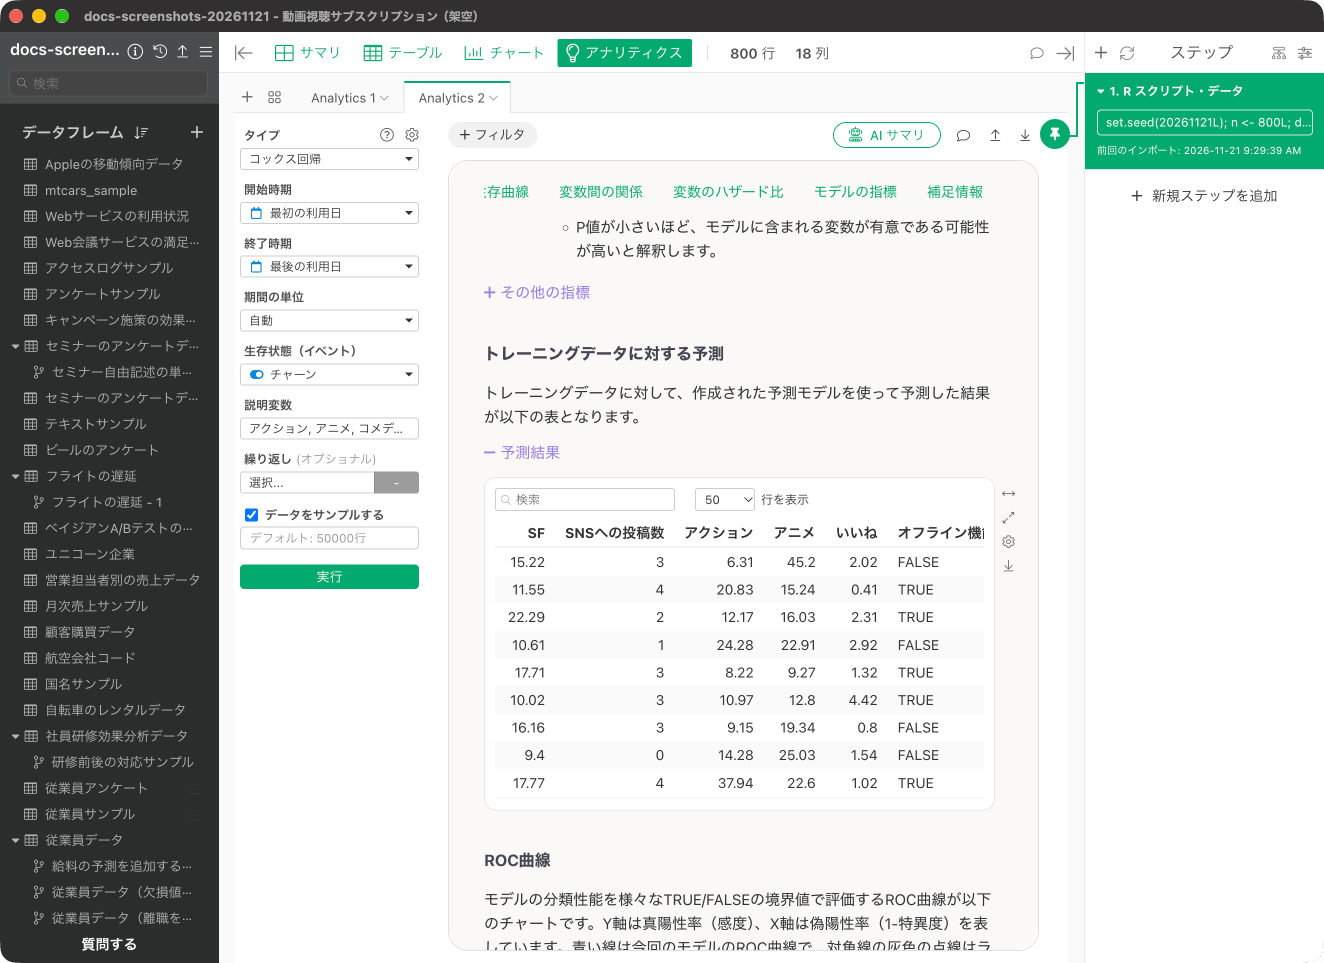
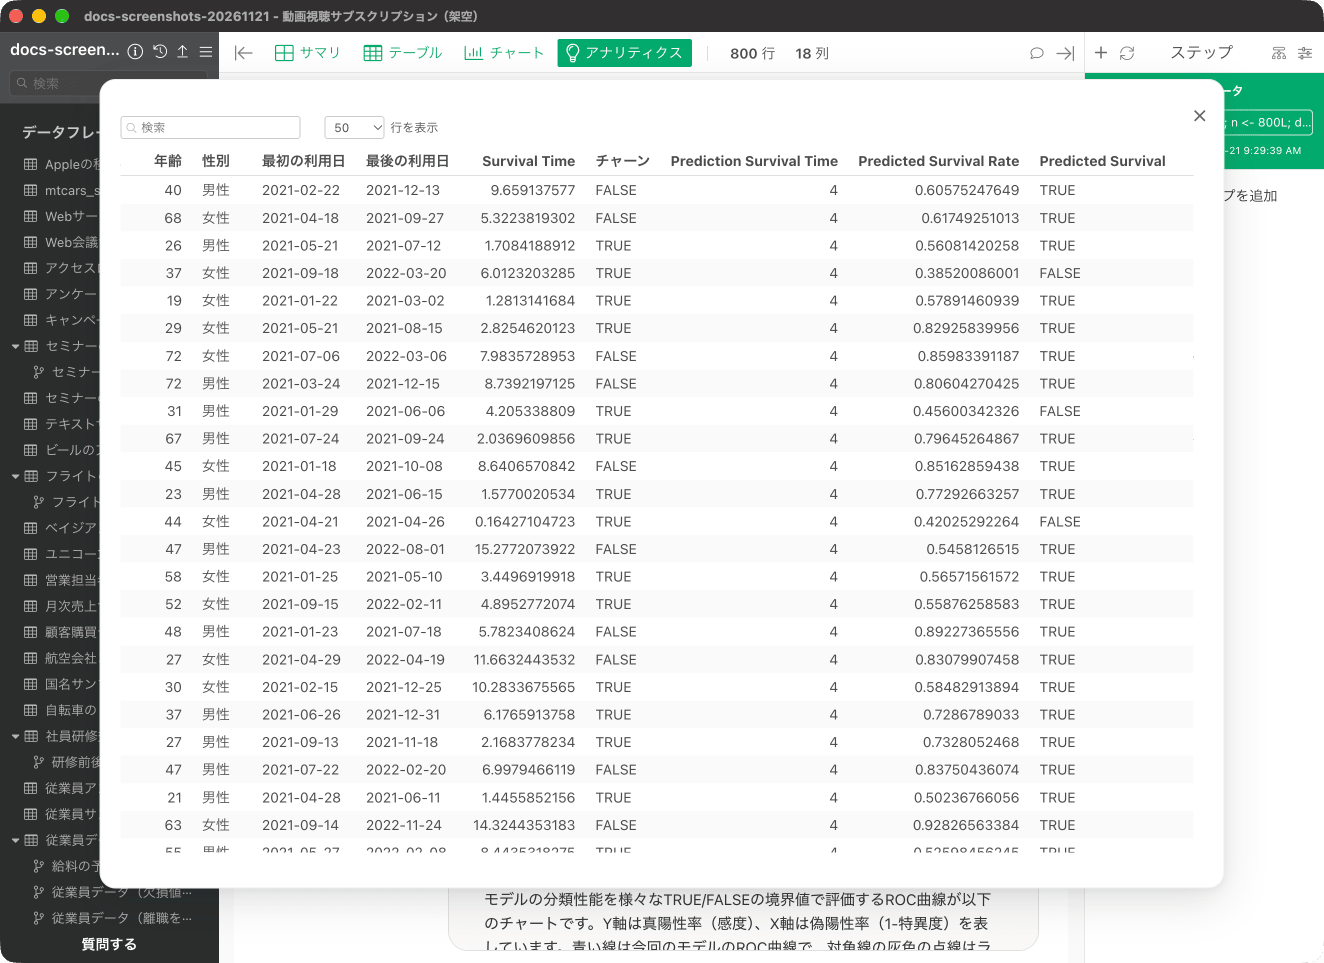
「トレーニングデータに対する予測」の「予測結果」を開くと、モデルに使用したデータと予測値がテーブルで表示されます。 拡大すると、「Survival Time」は各観察対象(顧客)の生存期間を表します。「チャーン」は実測の結果で、TRUEは観察期間中に解約したことを表します。 「Prediction Survival Time」は、どの時点での生存確率を予測しているかを表し、今回は4です。「Predicted Survival Rate」は、その期間における生存確率で、「Predicted Survival」は、「Predicted Survival Rate」にしきい値を適用した予測結果で、TRUEは指定した時点(今回は4か月)で生存していると予測したことを表します。たとえば生存確率が0.6058の顧客はTRUE、0.3852の顧客はFALSEでした。「チャーン」のTRUEは解約、「Predicted Survival」のTRUEは生存で、意味が逆になる点に注意してください。右には「Linear Predictor」「Std Error」「Residual」「Test Data」の列もあります。
コックス回帰に関するよくある質問

Q: 「説明変数の影響度」で表示されている実測値はどのように求められているのですか?

実測値はそれぞれの説明変数のデータタイプによって表示が異なります。 詳しくはこちらのノートをご覧ください。

Q: 「説明変数の影響度」で表示されている予測値はどのように求められているのですか?

予測値のチャートはPartial Dependence Plot(PDP)と呼ばれるもので、注目している変数の値を変化させたときに、予測結果がどう変わるかを可視化したチャートとなります。詳しくはこちらのノートをご覧ください。

Q: 予測に使用する生存期間はどのように変更できますか?

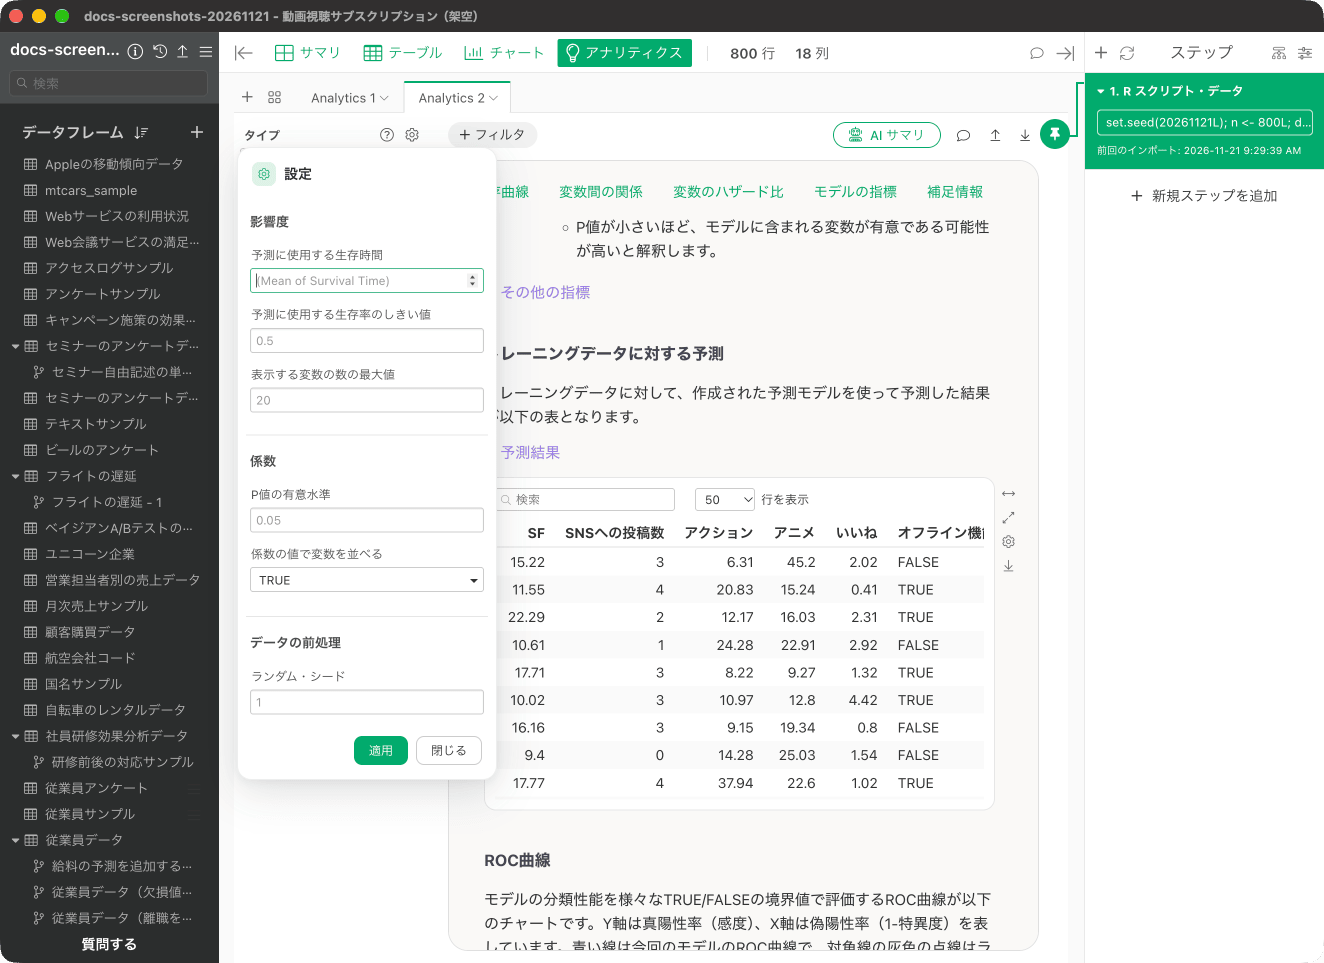
「予測に使用する生存時間」の初期値は「Mean of Survival Time」(生存期間の平均)ですが、「タイプ」の右にある歯車の設定の「影響度」にある「予測に使用する生存時間」から変更できます。
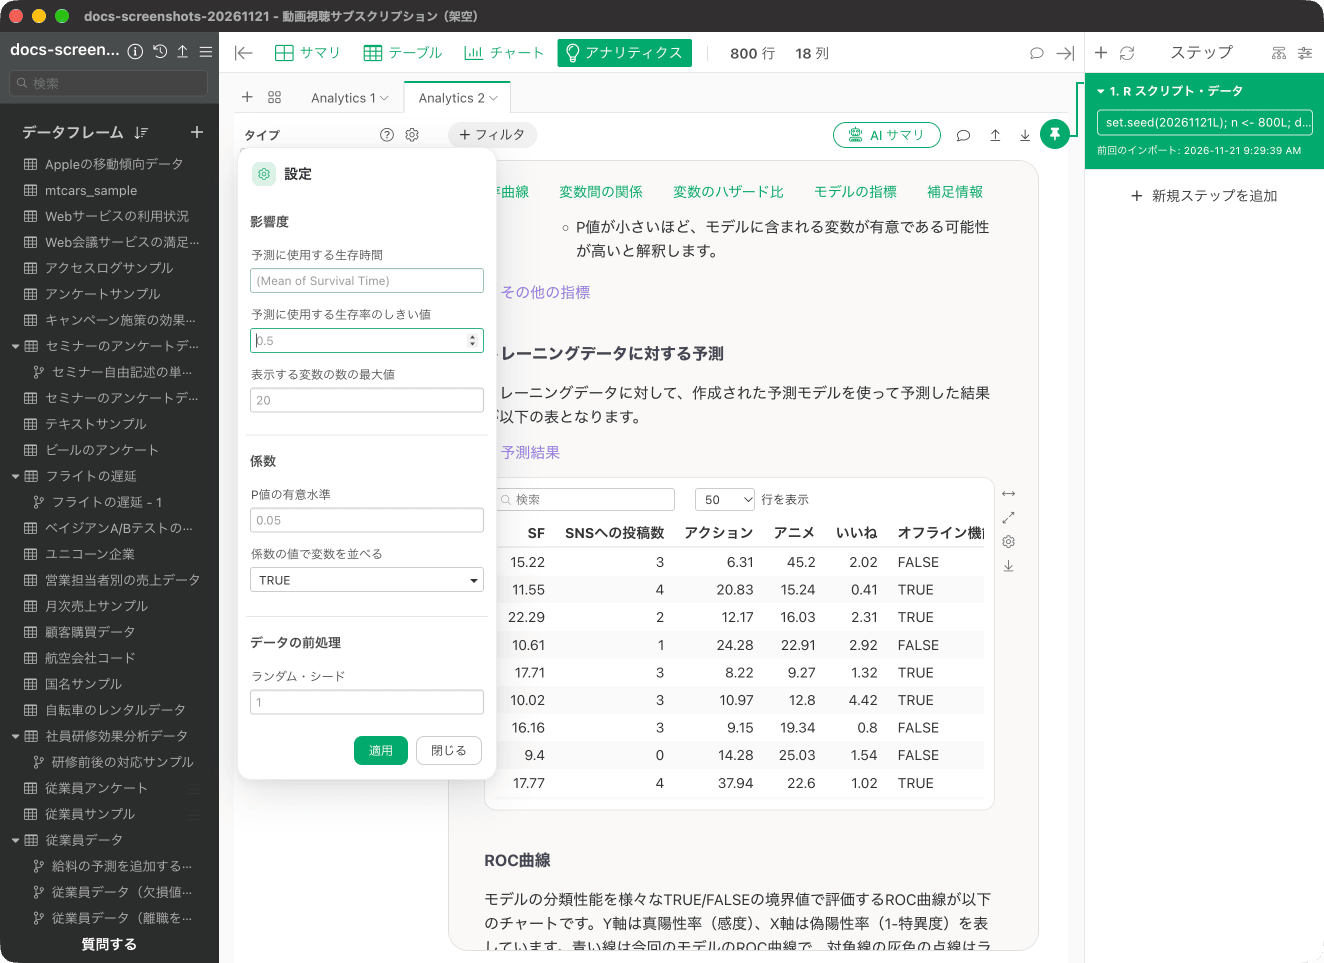
Q: 予測に使用する生存率のしきい値はどのように変更できますか?

設定の「影響度」にある「予測に使用する生存率のしきい値」から変更できます。しきい値の初期値は0.5です。設定には、このほか「係数」の「P値の有意水準」(0.05)と「係数の値で変数を並べる」(TRUE)があります。
Q: 時点AUCと一致係数はどちらを優先してみればいいでしょうか?

決まりのようなものはないのですが、予測において、何を重視したいかによってどの指標を重視するかを決めていただければよいかと思います。 例えば、一年後のように、特定の時点までにイベントが発生するのかどうかを予測することが重要であれば、1年後の「時点AUC」を見ていただくのがよいと思います。 どの時点ということに関係なく、イベントが発生しやすそうなほうから観察対象(例:顧客、従業員、など)にランク付けすることが重要なのであれば、「一致係数」をみていただくのがよいと思います。