- 二項分布:「はい / いいえ」「成功 / 失敗」といった2値の結果を扱います。
- ガンマ分布:0より大きい数値で、右に裾が長い分布のもの(金額など)を扱います。
- 逆ガウス分布:正の値で、右に裾が長い分布の数値(時間、距離、金額など)を扱います。
二項分布
一般化線形モデル(GLM)の二項分布は、「はい/いいえ」「成功/失敗」といった2値の結果を予測・分析する統計手法です。この手法は、ロジスティック回帰の発展形として位置づけられ、より柔軟で高度なモデリングを可能にします。例えば、「ある条件を満たすかどうか」「特定の事象が発生するかどうか」といった予測において、複数の要因の影響を詳細に分析できます。また、予測結果は0から1の間の確率として得られるため、結果の解釈が直感的で実務での活用がしやすい特徴があります。 この手法が特に注目される理由は、現実世界の複雑な関係性を表現できる点にあります。通常のロジスティック回帰では、説明変数と目的変数の間に単純な線形関係(多ければ多いほど良い、または少なければ少ないほど良い)を仮定します。しかし、実際のデータではより複雑な関係性が存在することがあります。例えば、「適度な量が最も効果的で、多すぎても少なすぎても効果が下がる」といった非線形な関係性や、「ある条件下では正の効果だが、別の条件下では負の効果になる」といった交互作用も、GLM - 二項分布では適切にモデル化できます。 このアプローチを使用することで、より正確な予測モデルの構築と、より深い洞察の獲得が可能になります。また、過学習(オーバーフィッティング)のリスクが比較的低く、データサイズが小さめでも安定した結果が得られやすいという特徴があります。さらに、モデルの結果は統計的な裏付けを持っているため、意思決定の根拠として説得力があります。各要因が結果に与える影響の大きさや方向性を具体的な数値として示すことができ、「なぜそのような結果になったのか」という因果関係の理解にも役立ちます。ロジスティック回帰と比較すると、よりきめ細かな分析が可能で、現実の複雑な事象をより適切にモデル化できる点が大きな利点となっています。どういった時に使えるのか
一般化線形モデル(二項分布)は、様々な分野で「Yes/No」の結果を予測・分析する際に活用できます。例えば、Eコマースでのキャンペーン効果を分析する場合、顧客の属性(セグメント、年齢層)、施策内容(タイプ、割引率)、コミュニケーション方法(メール、LINE、プッシュ通知)など、複数の要因が購買行動に与える影響を総合的に評価する必要があります。 また、金融分野では融資の返済遅延リスクの予測に活用され、取引履歴や収入といった基本情報に加え、過去の支払い行動パターンなど、複数の要因を組み合わせた分析が可能です。特に、収入と返済リスクの関係が単純な比例関係ではなく、一定の収入水準を超えると返済リスクが横ばいになるといった非線形な関係性も捉えることができます。 さらに工学分野では、機器の故障予測にも応用され、稼働時間や負荷状態、環境条件などから故障確率を予測します。例えば、温度と故障リスクの関係が、適温範囲では低く、高温や低温になるほど上昇するといったU字型の関係性もモデル化できます。 参考となるデータ例:- 顧客別の購入有無と属性データ
- 契約別の更新有無と取引データ
- 施策別の反応有無とメール配信情報データ
- 会員別の継続有無と行動データ
ユースケース
-
医療機関での使い方
- 疾病リスクの予測や早期発見のスクリーニングに使えます。
- 具体的には、患者の基本情報、生活習慣、検査値などから特定の疾病の発症確率を予測することで、リスク要因を特定できます。
- これにより、ハイリスク患者への予防的介入や検査優先度の決定に活用できます。
-
小売業での使い方
- 商品別のレコメンデーション効果予測に使えます。
- 具体的には、商品カテゴリ、価格帯、顧客の閲覧履歴などから、レコメンド商品への反応確率を予測することで、効果的な商品提案が可能になります。
- これにより、顧客別の最適な商品提案や、クロスセル施策の精度向上が実現できます。
-
品質管理担当者での使い方
- 検査工程の最適化に使えます。
- 具体的には、製品特性、製造条件、検査項目などから合格確率を予測することで、重点的に確認すべき項目を特定できます。
- これにより、効率的な検査計画の立案や品質改善施策の優先順位付けが可能になります。
-
リスク管理担当者での使い方
- 異常検知や事故予防に使えます。
- 具体的には、運転条件、環境要因、保守履歴などから故障や事故の発生確率を予測することで、リスク要因を事前に把握できます。
- これにより、予防保全の計画立案や安全対策の実施が可能になります。
Exploratoryで一般化線形モデル(二項分布)を実行する
使用するデータ
今回は「キャンペーン施策の効果測定データ」(1,000行・16列)を使用します。データはこちらからダウンロードが可能となっています。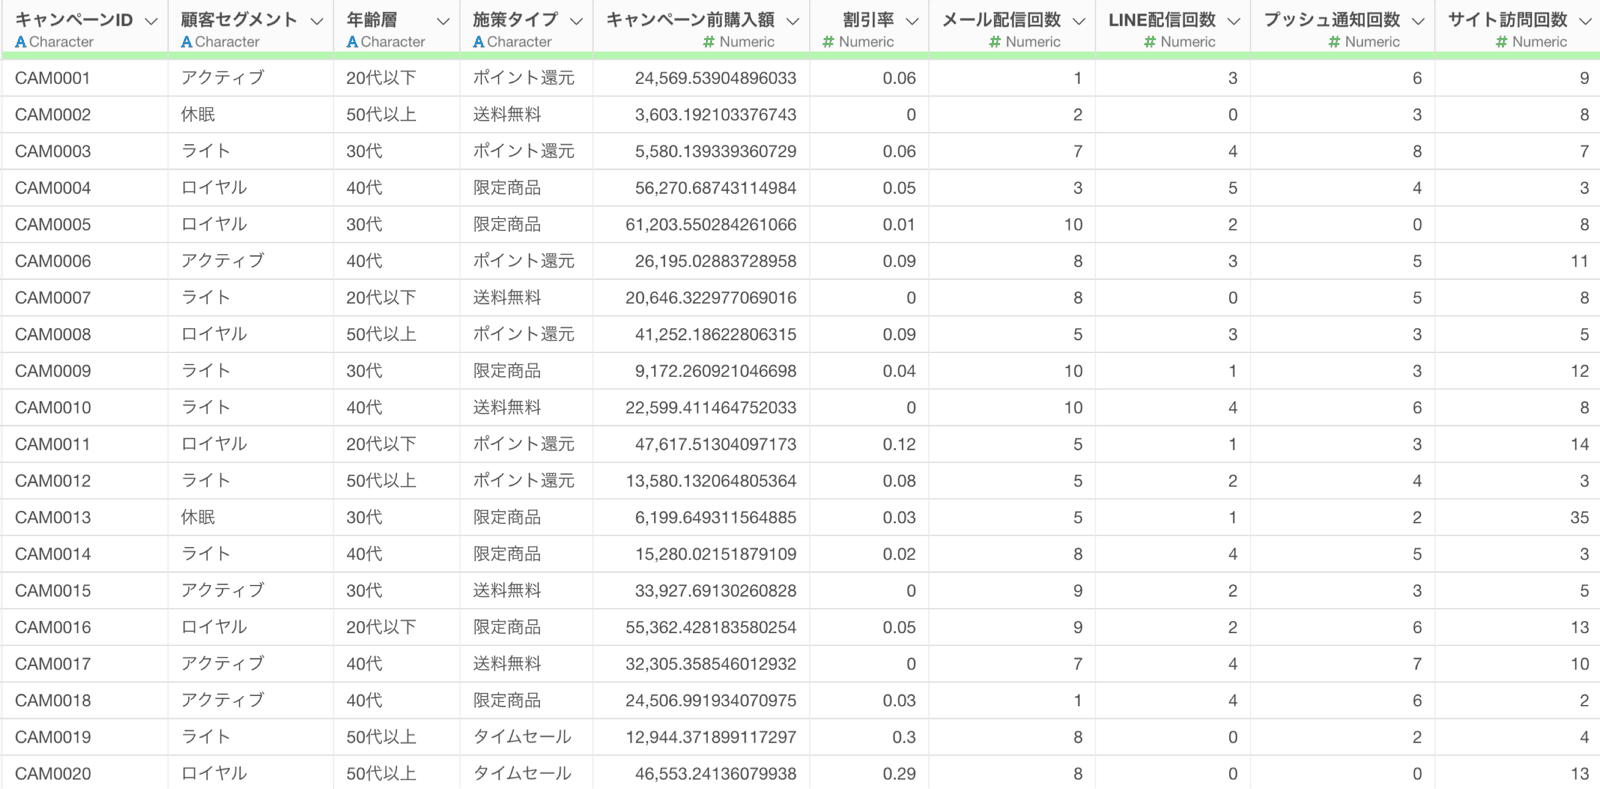
- 基本情報:キャンペーンID、顧客セグメント、年齢層
- 結果指標:キャンペーン反応(TRUE/FALSE)
- 施策情報:施策タイプ(ポイント還元、限定商品、送料無料、タイムセール)、割引率(%)
- コミュニケーション指標:メール配信回数、LINE配信回数、プッシュ通知回数
- 顧客行動指標:サイト訪問回数、メール開封率、LINE開封率、商品閲覧数、など。
- 目的変数(キャンペーン反応)は TRUE/FALSE の2値である必要があります
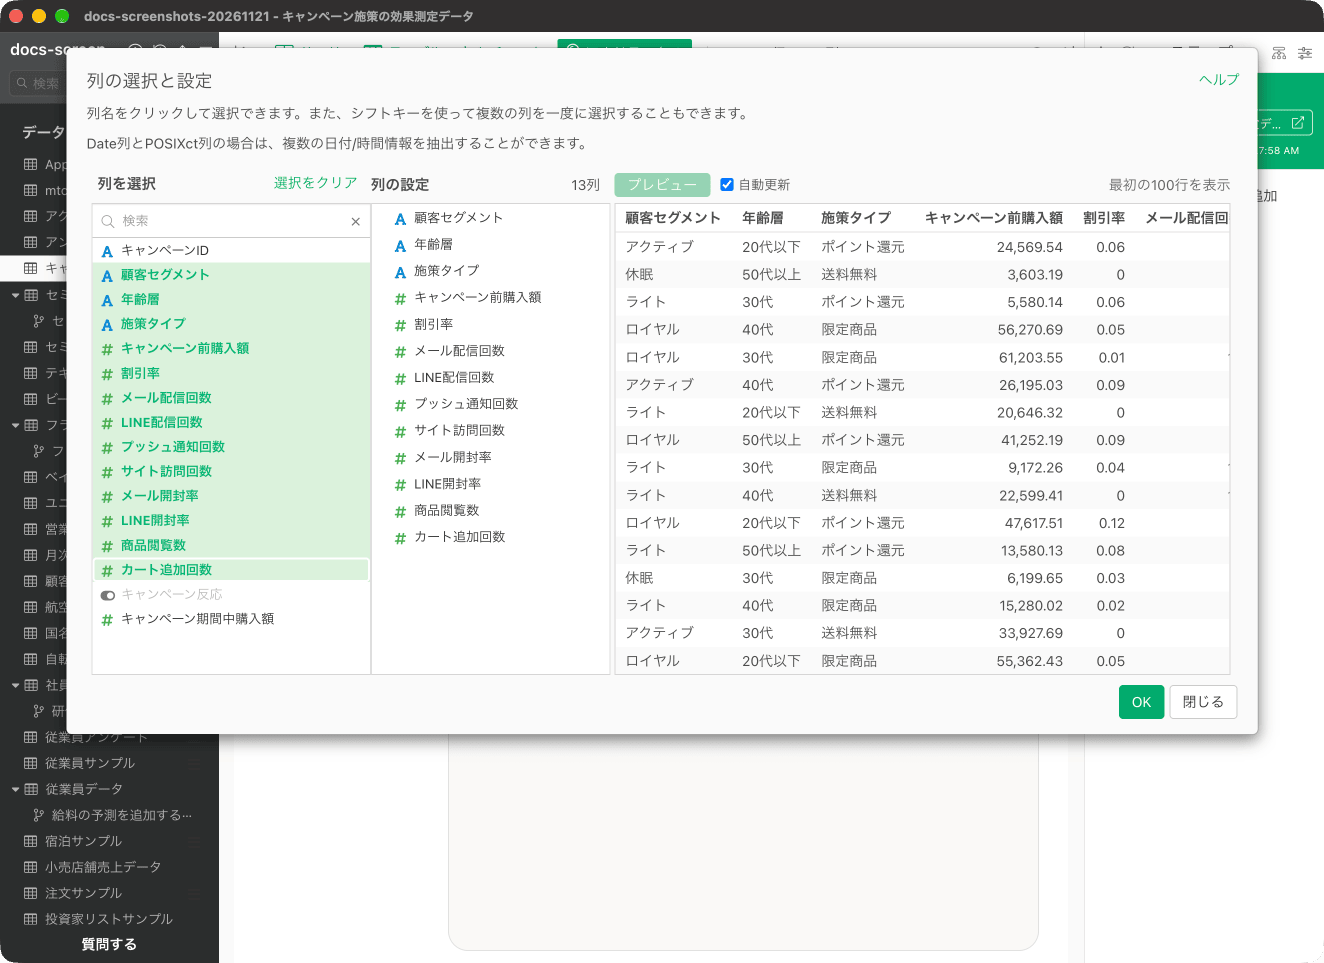
- 説明変数は数値型(配信回数、開封率など)やカテゴリ型(顧客セグメント、施策タイプなど)などの変数を使用します。
- キャンペーンIDのような識別子は分析から除外する必要があります。
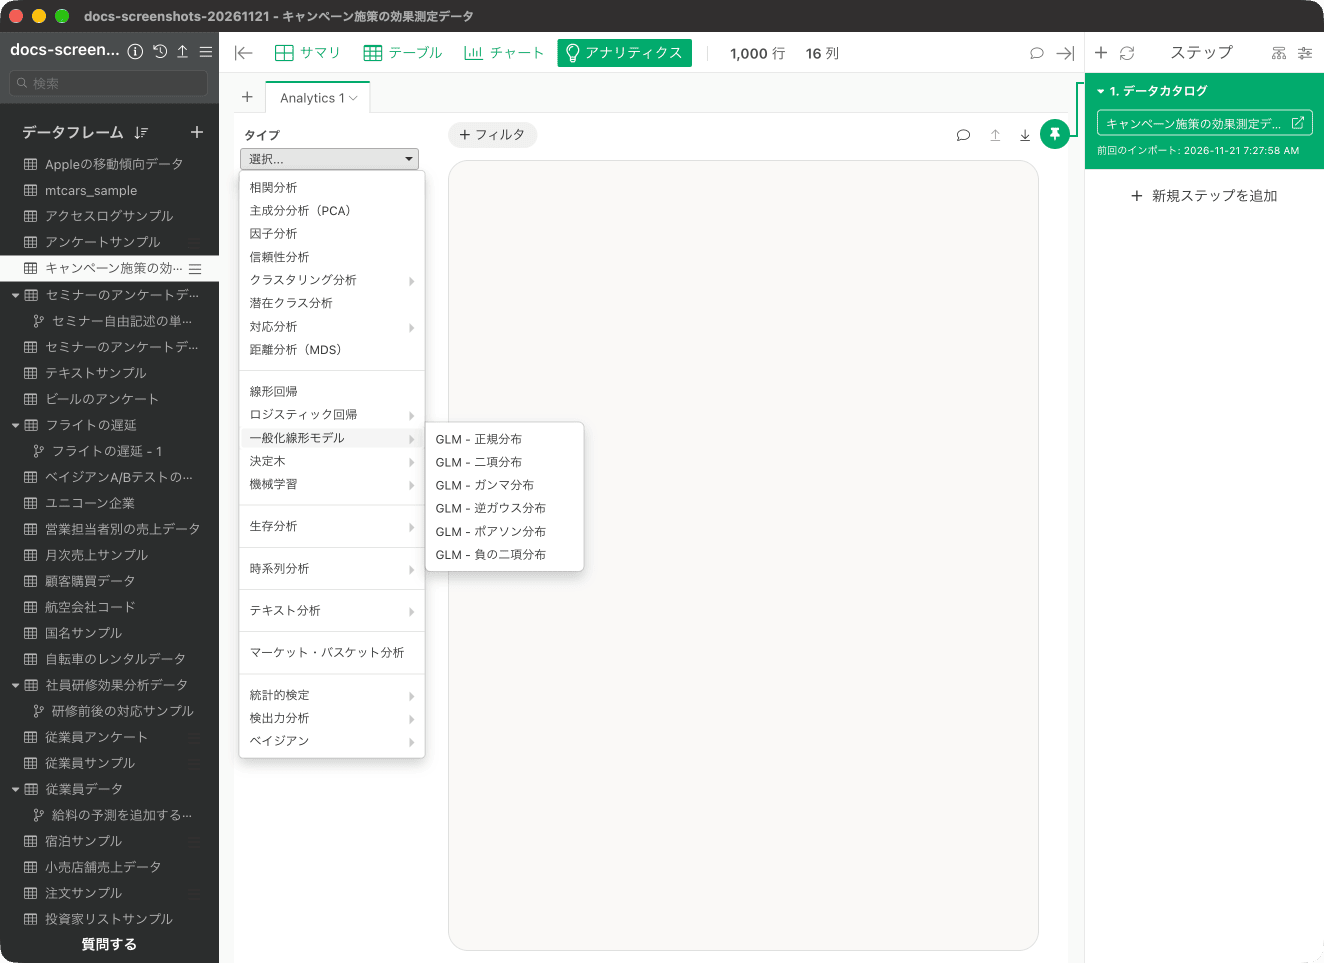
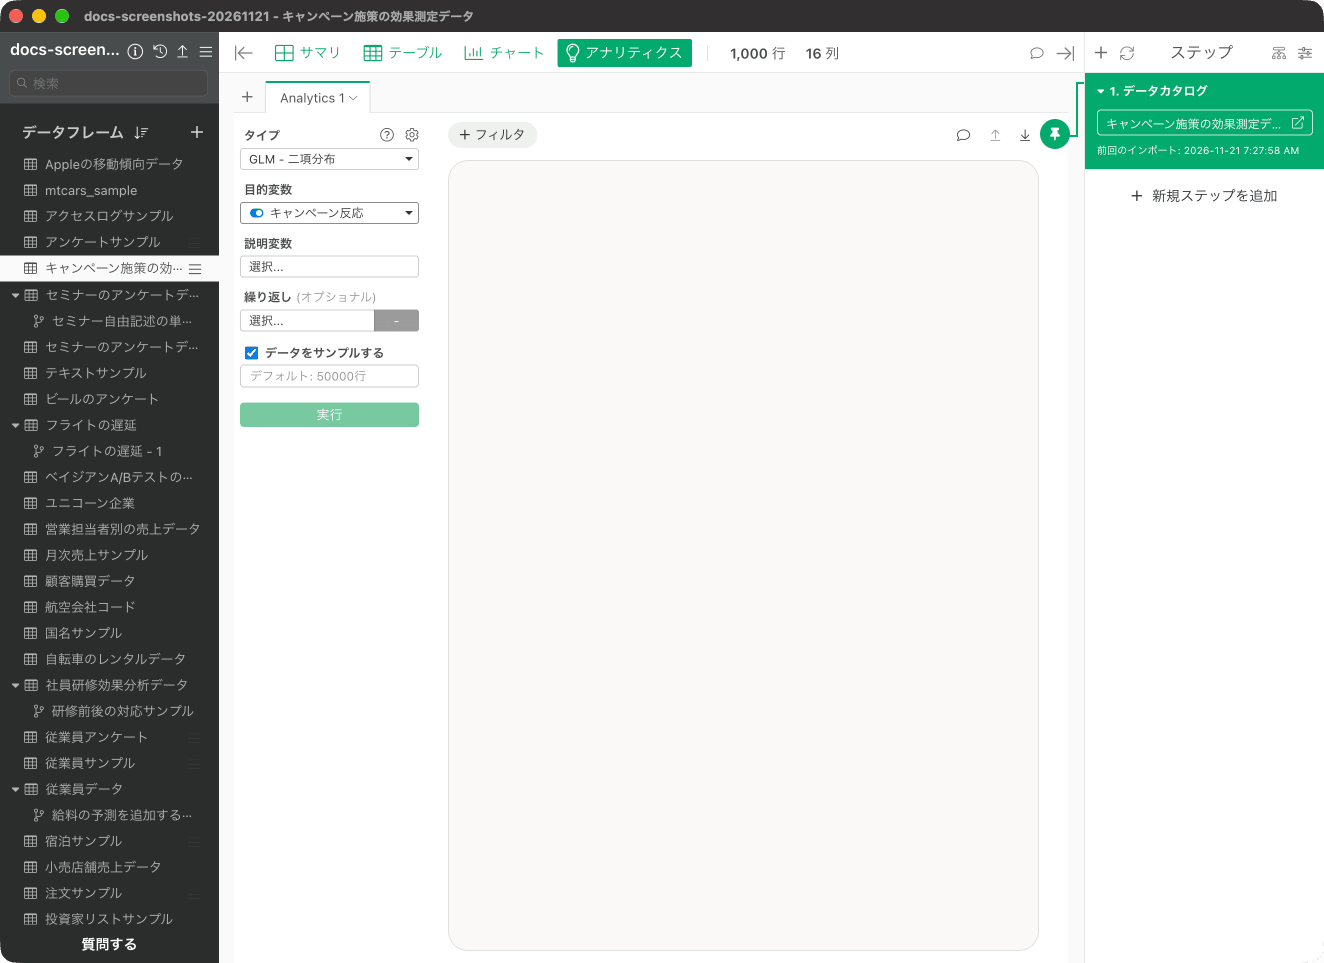
アナリティクスを作成する
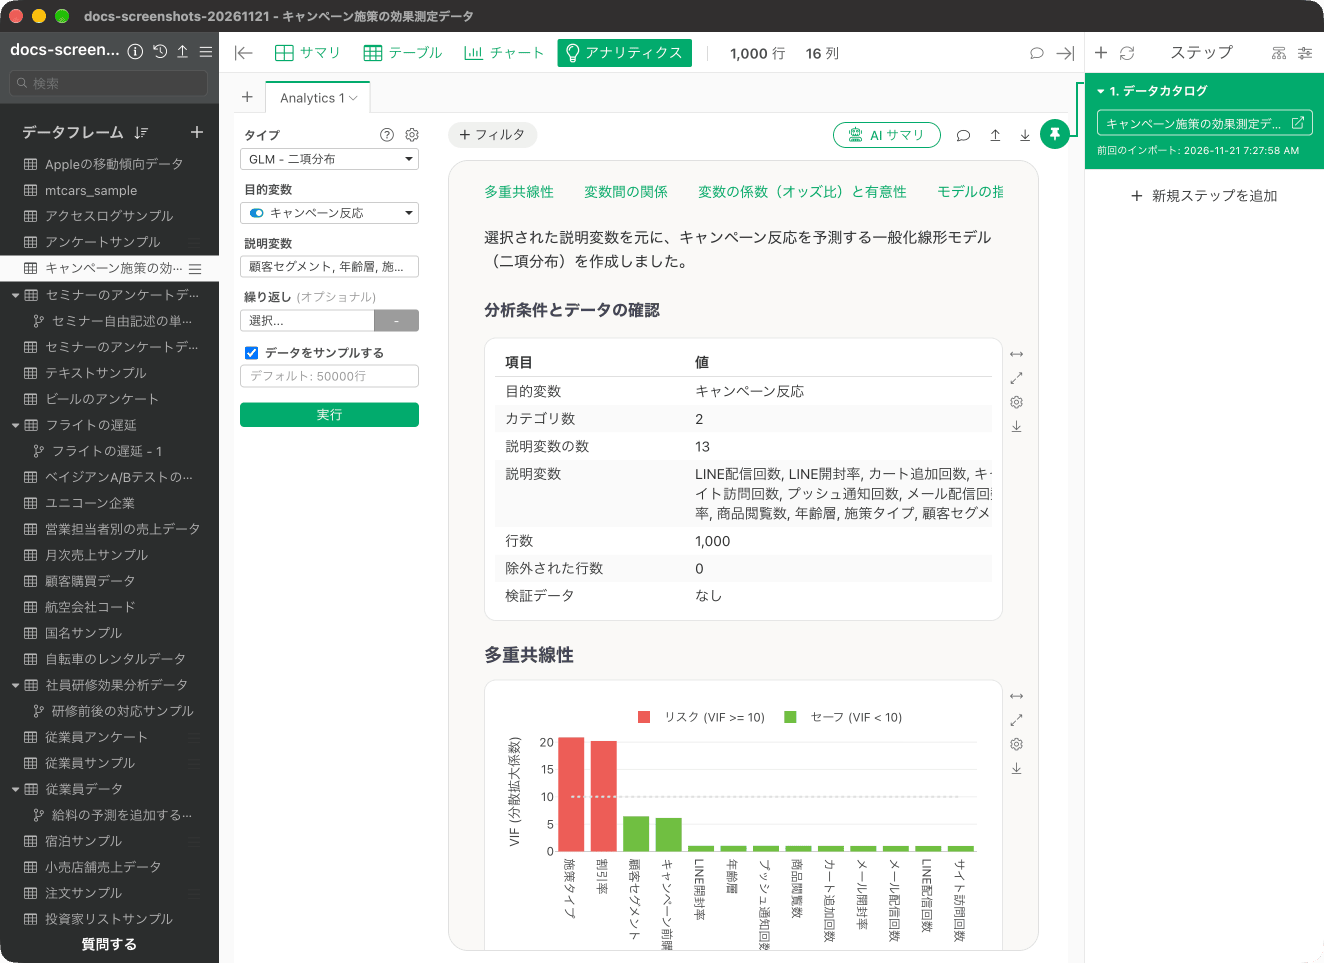
キャンペーン施策の効果測定データから「アナリティクス・ビュー」を開きます。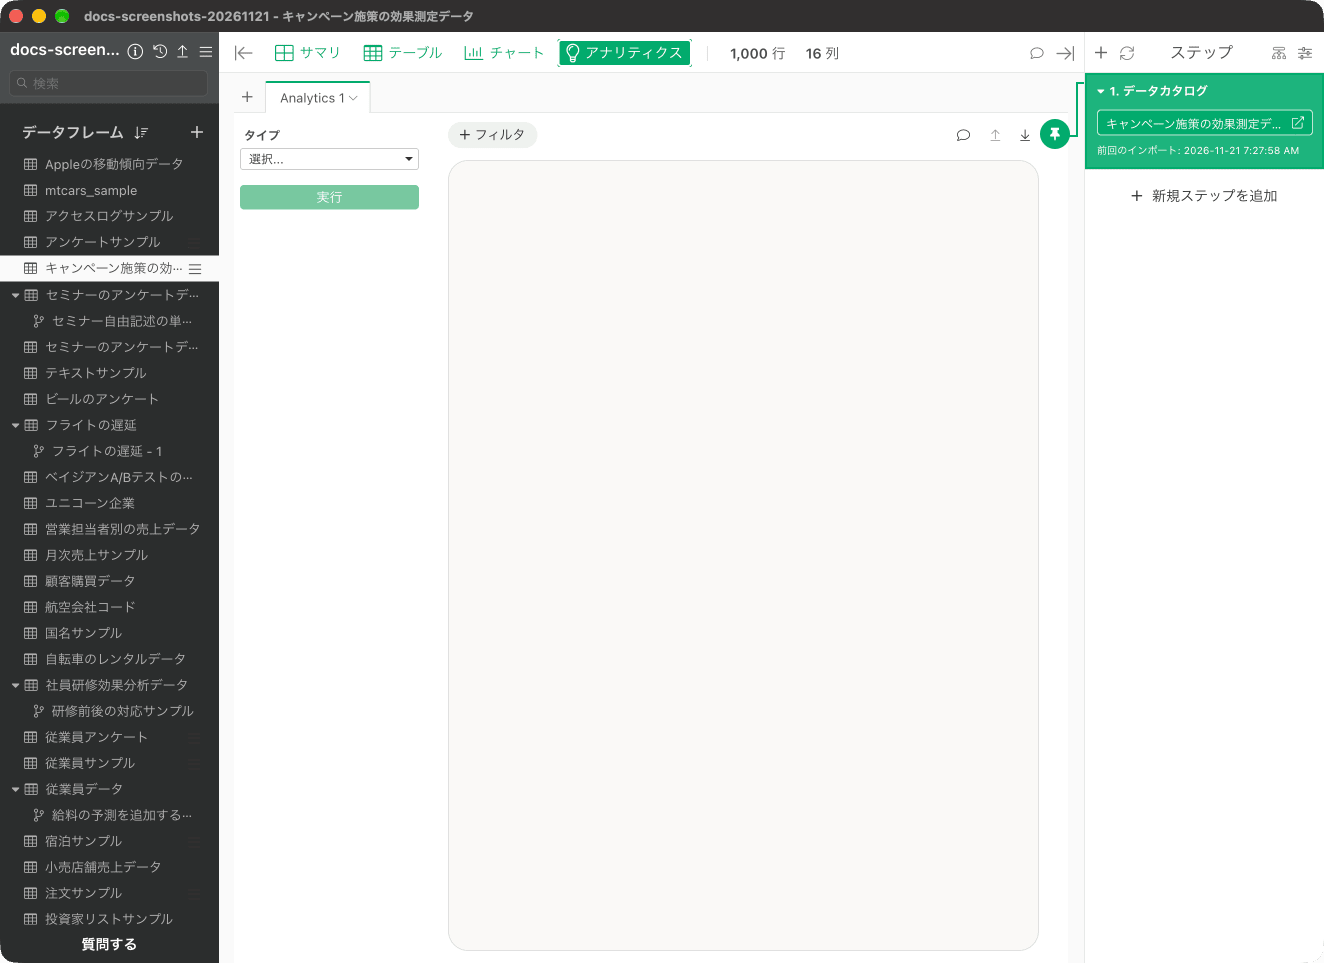
結果の解釈
一般化線形モデル(二項分布)では、キャンペーン施策の効果を多角的に分析するために、以下の節が用意されています。多重共線性
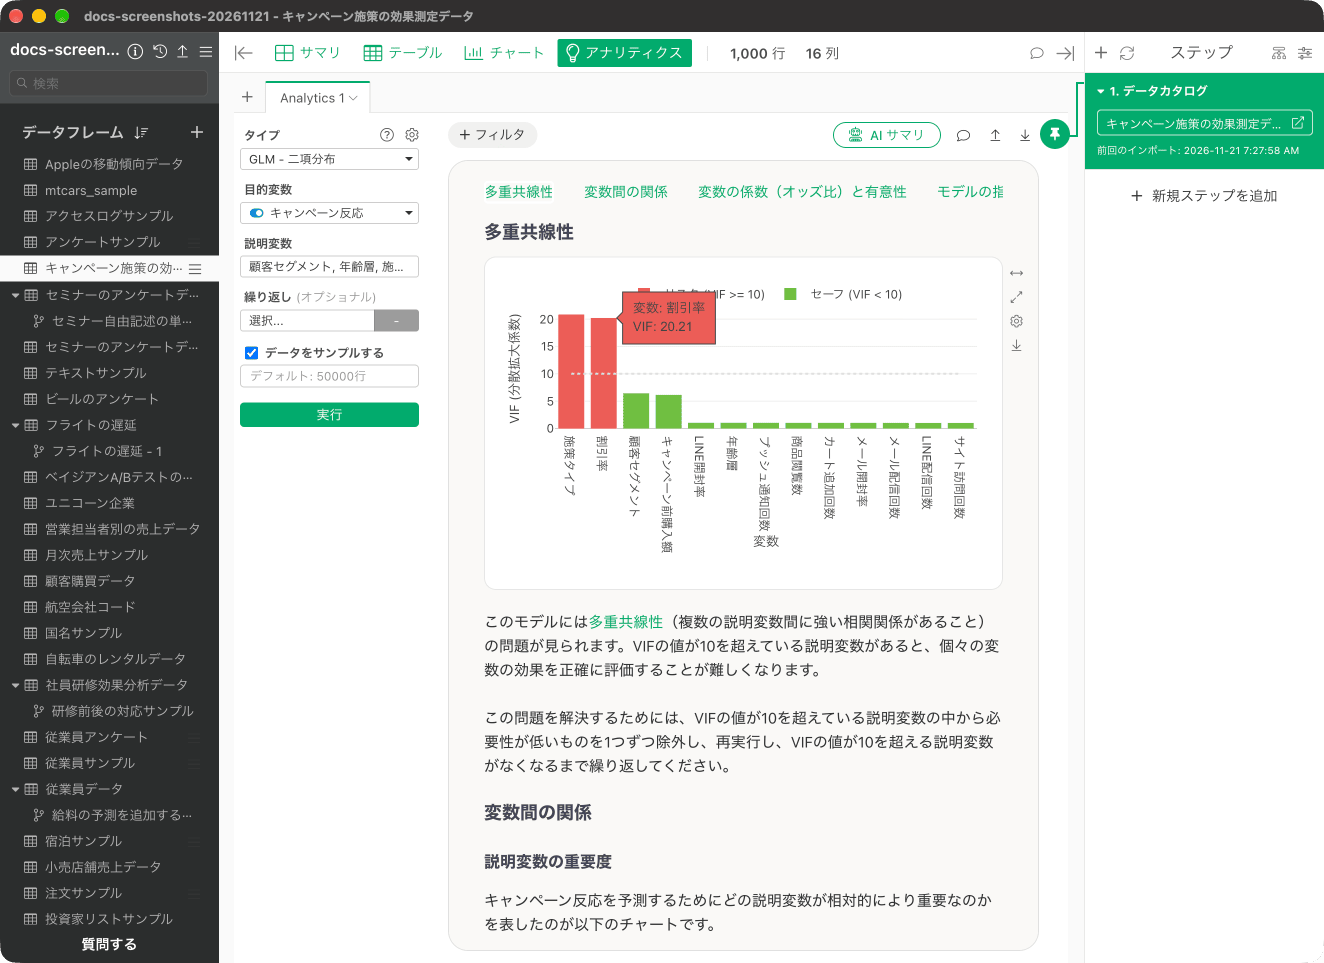
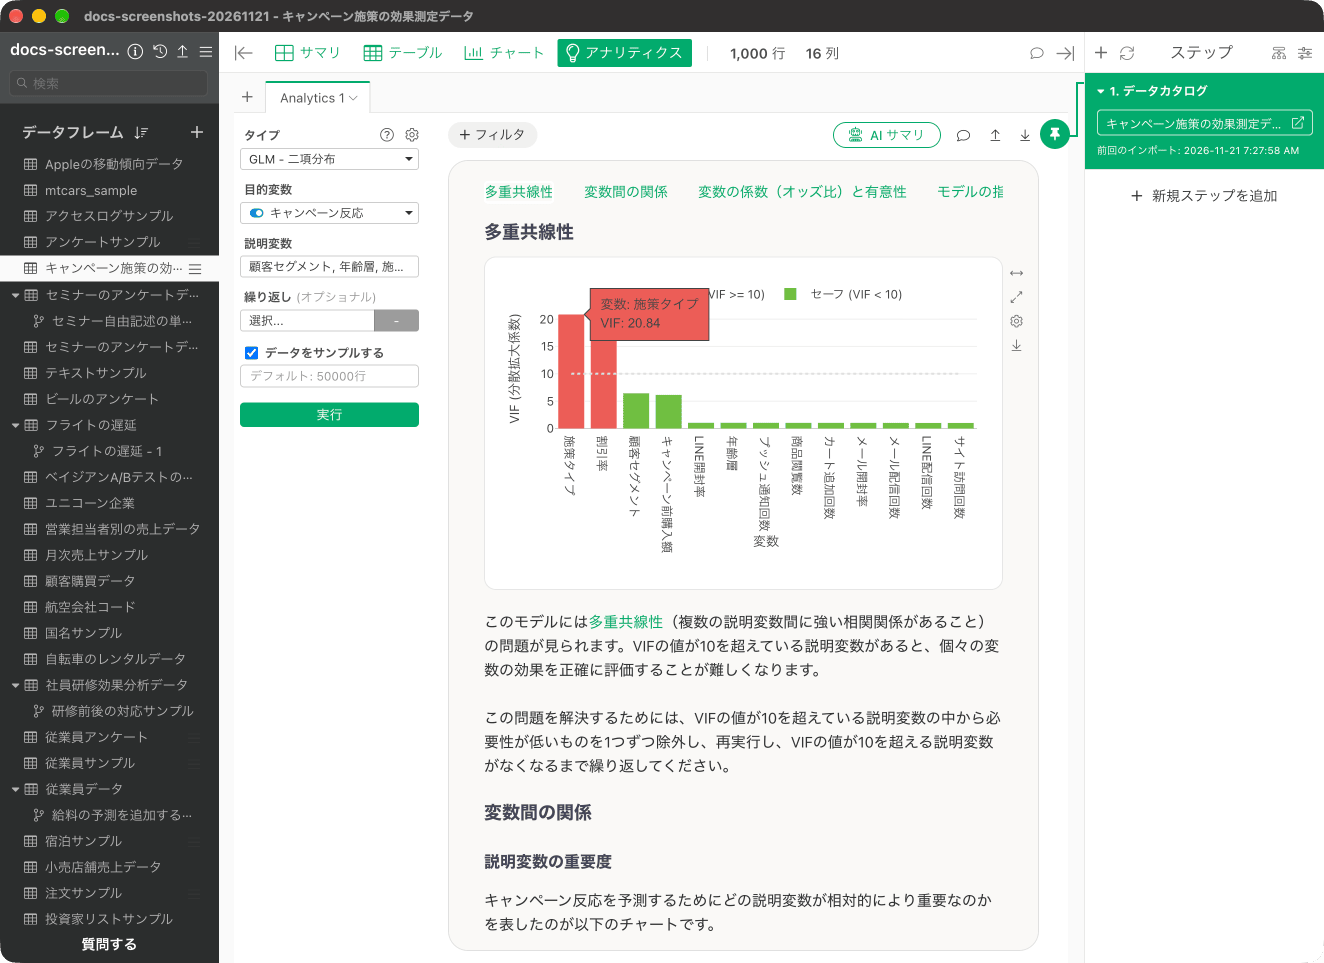
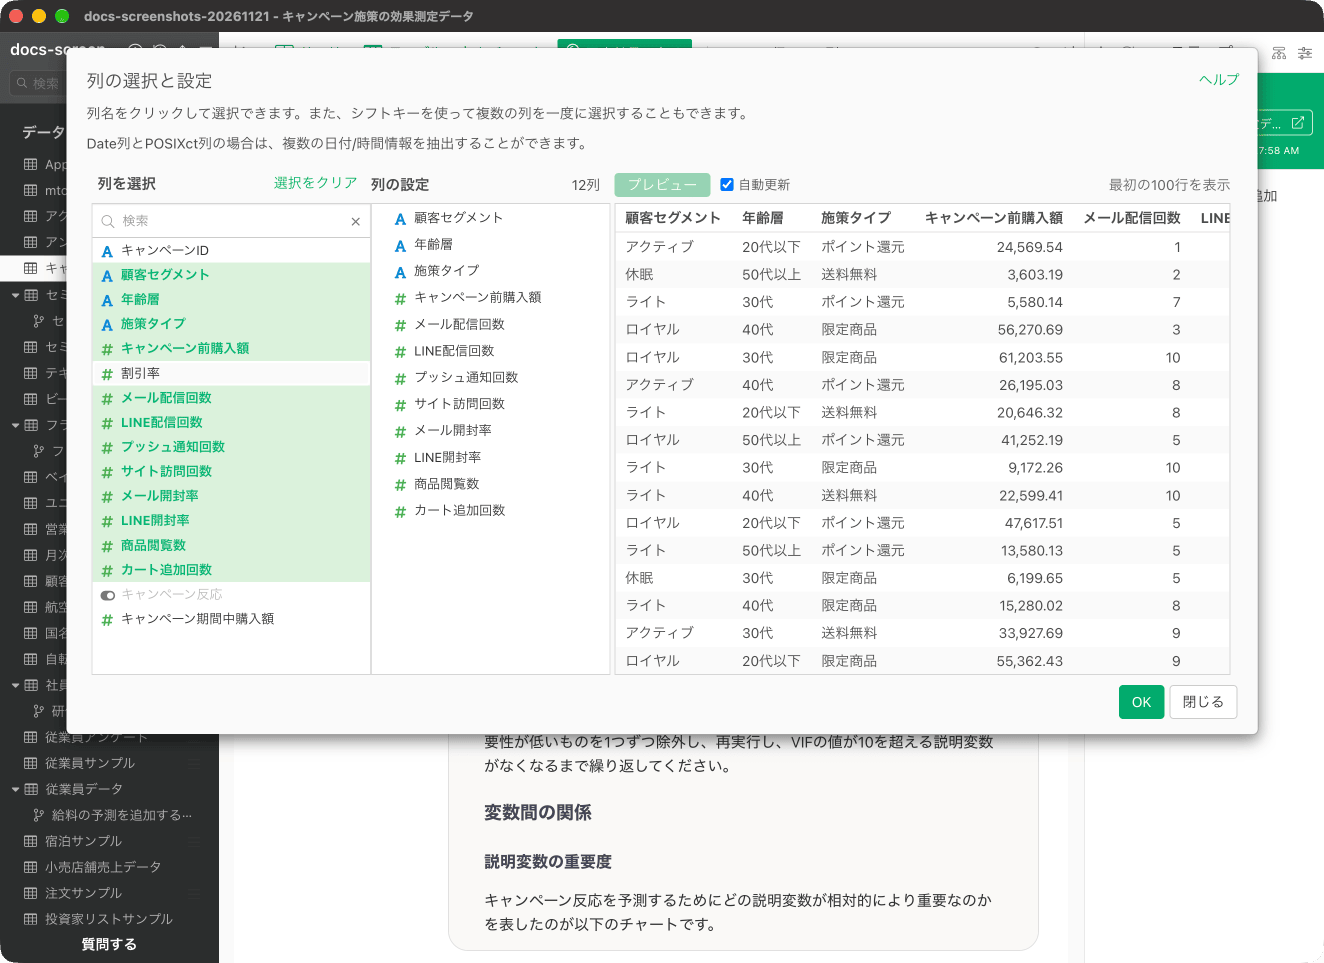
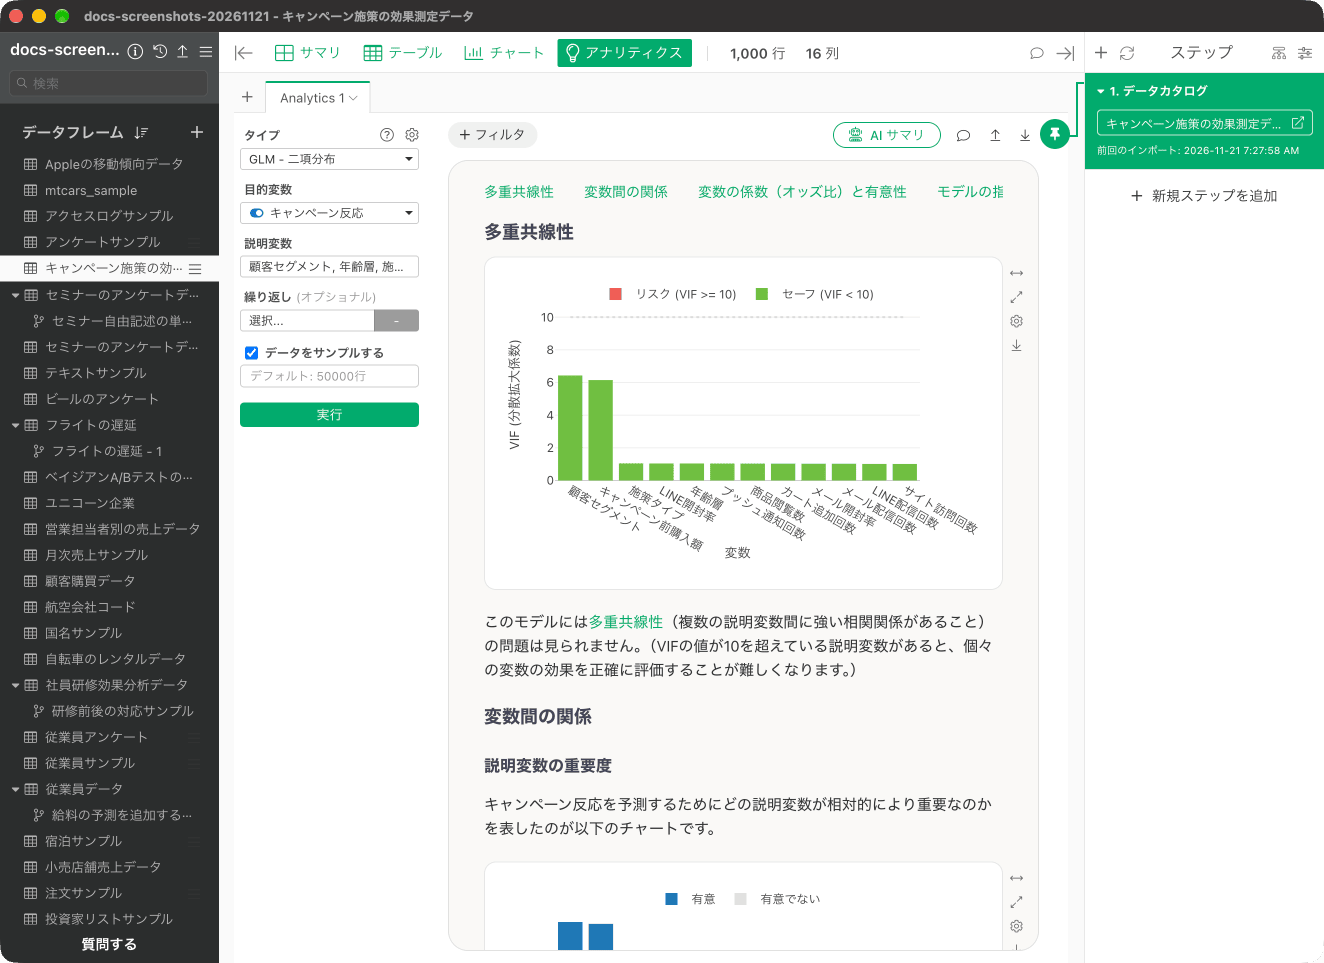
「多重共線性」の節では、説明変数間の相関が強すぎる(VIF 10以上)組み合わせがないかを確認できます。VIFが10以上の変数がある場合、説明変数間の相関が強く、傾きが不安定になる可能性があるため、変数の選択を見直す必要があります。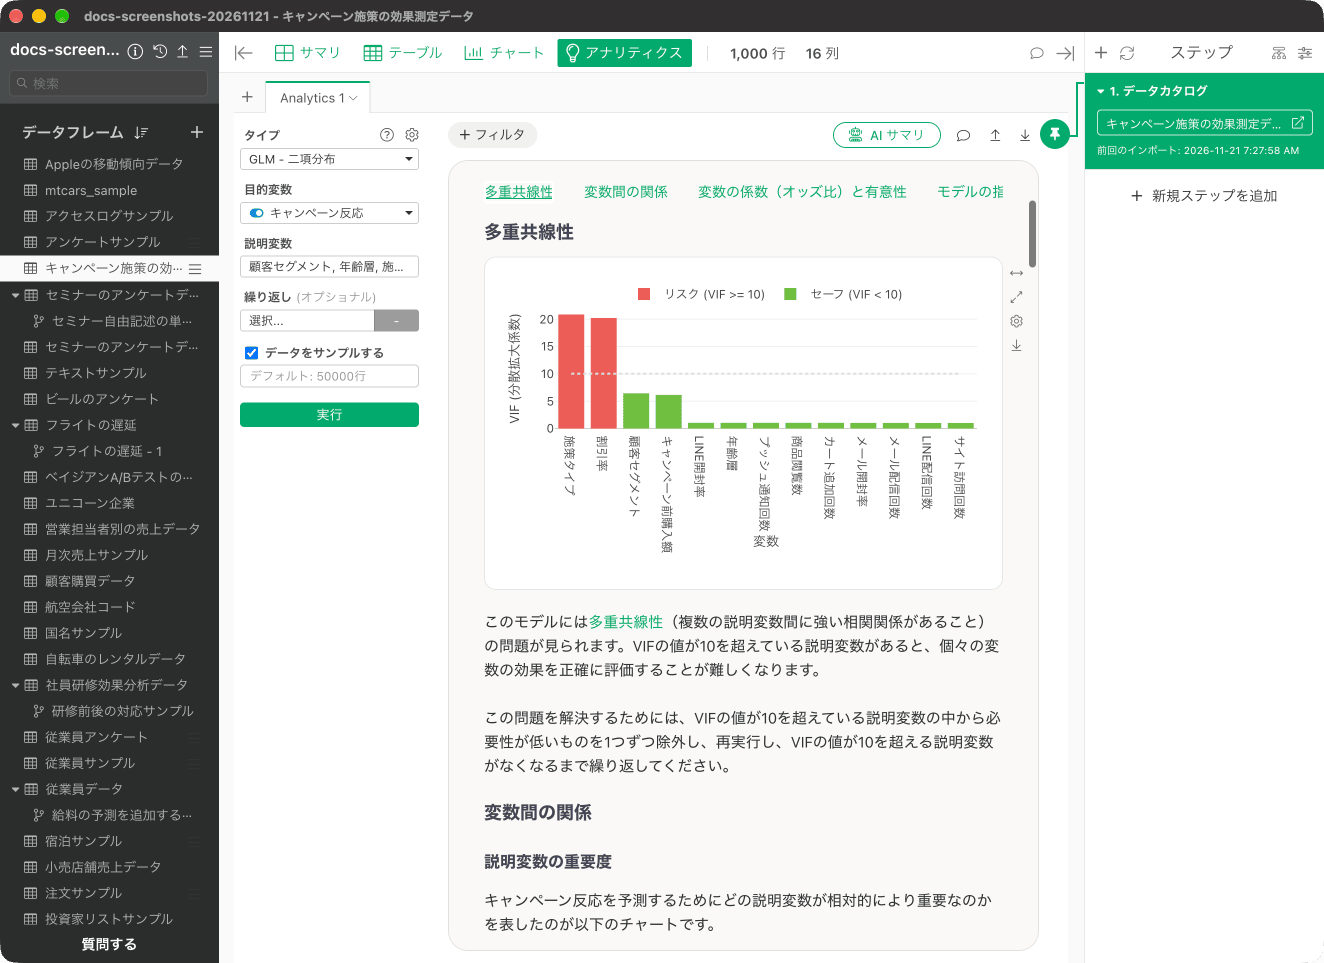
説明変数の重要度
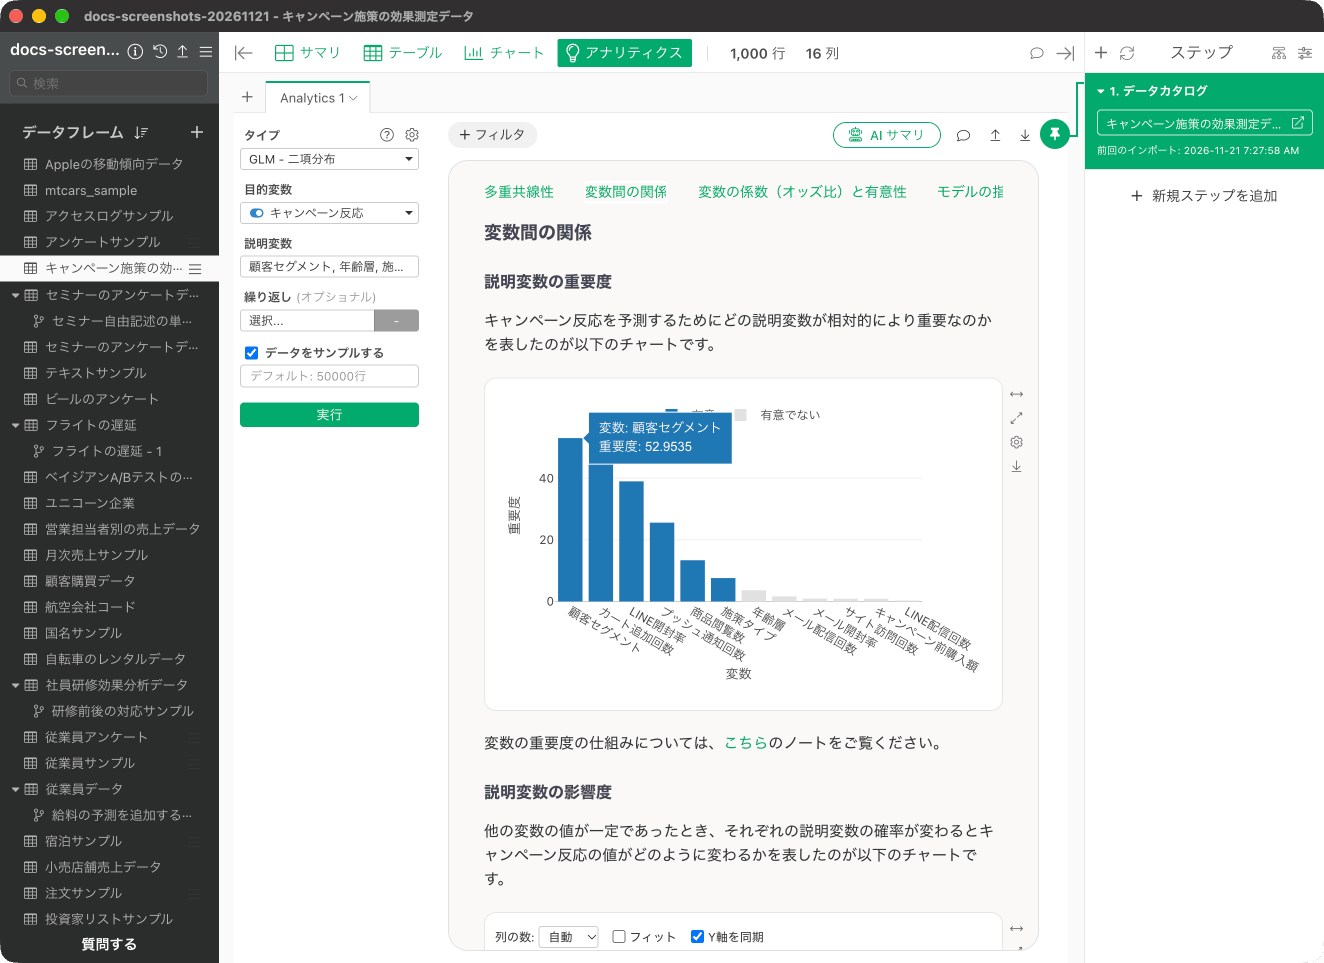
「変数間の関係」の節にある「説明変数の重要度」では、目的変数を予測する上でどの変数が重要なのかを確認できます。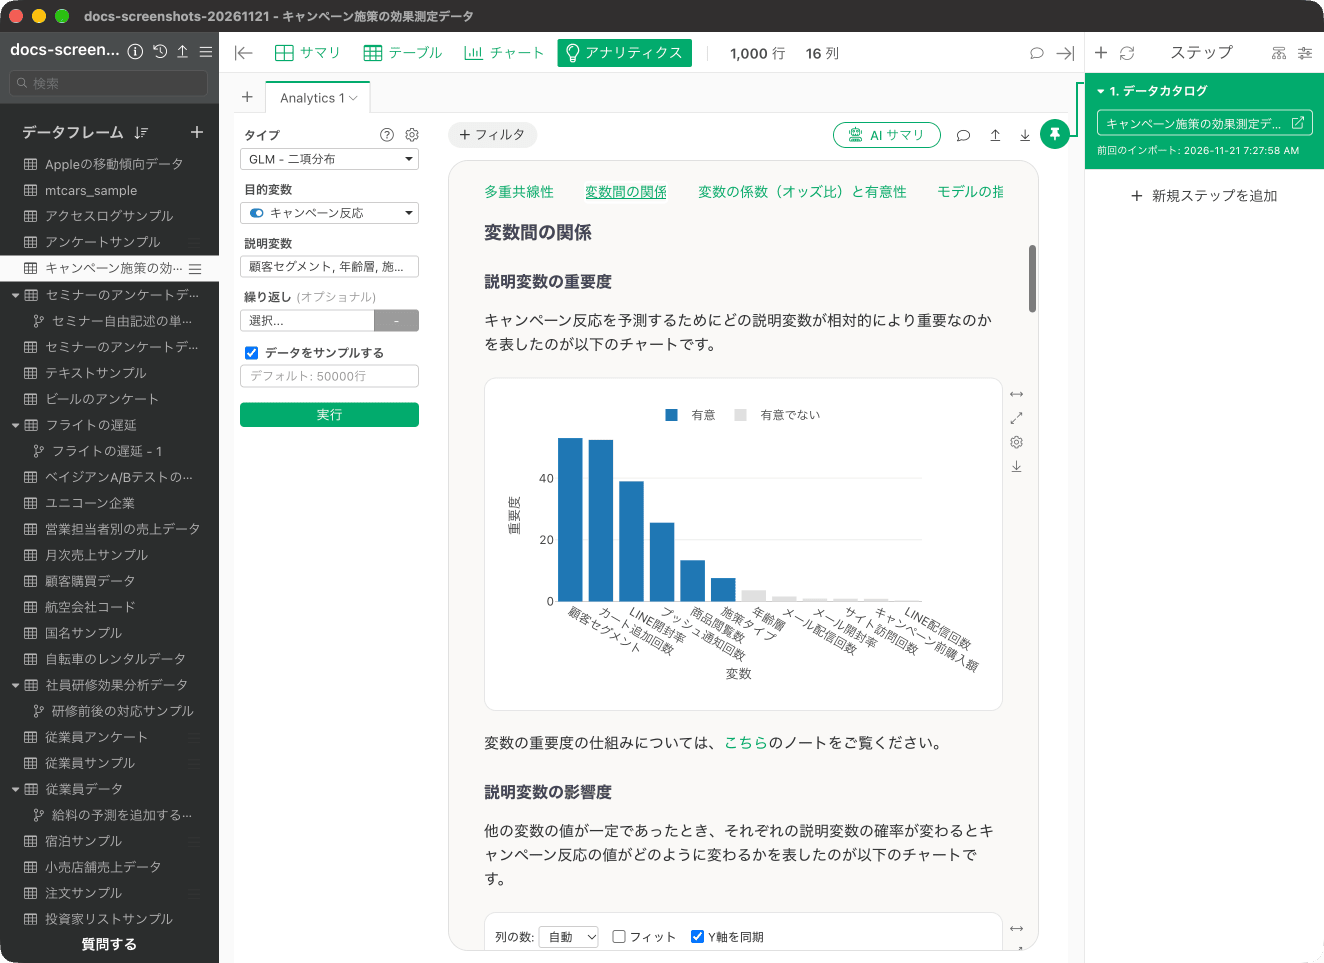
説明変数の影響度
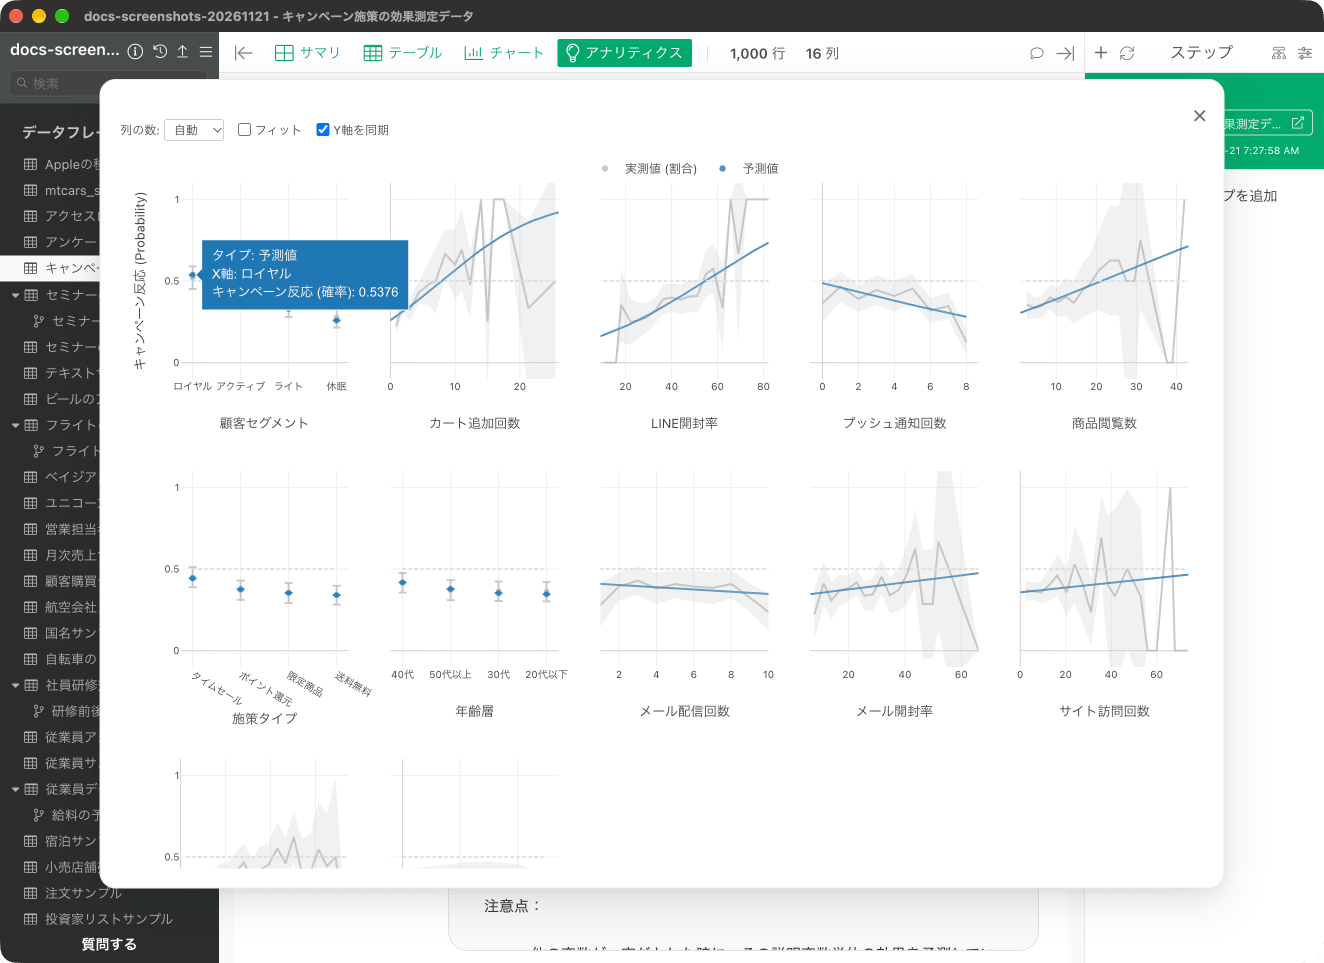
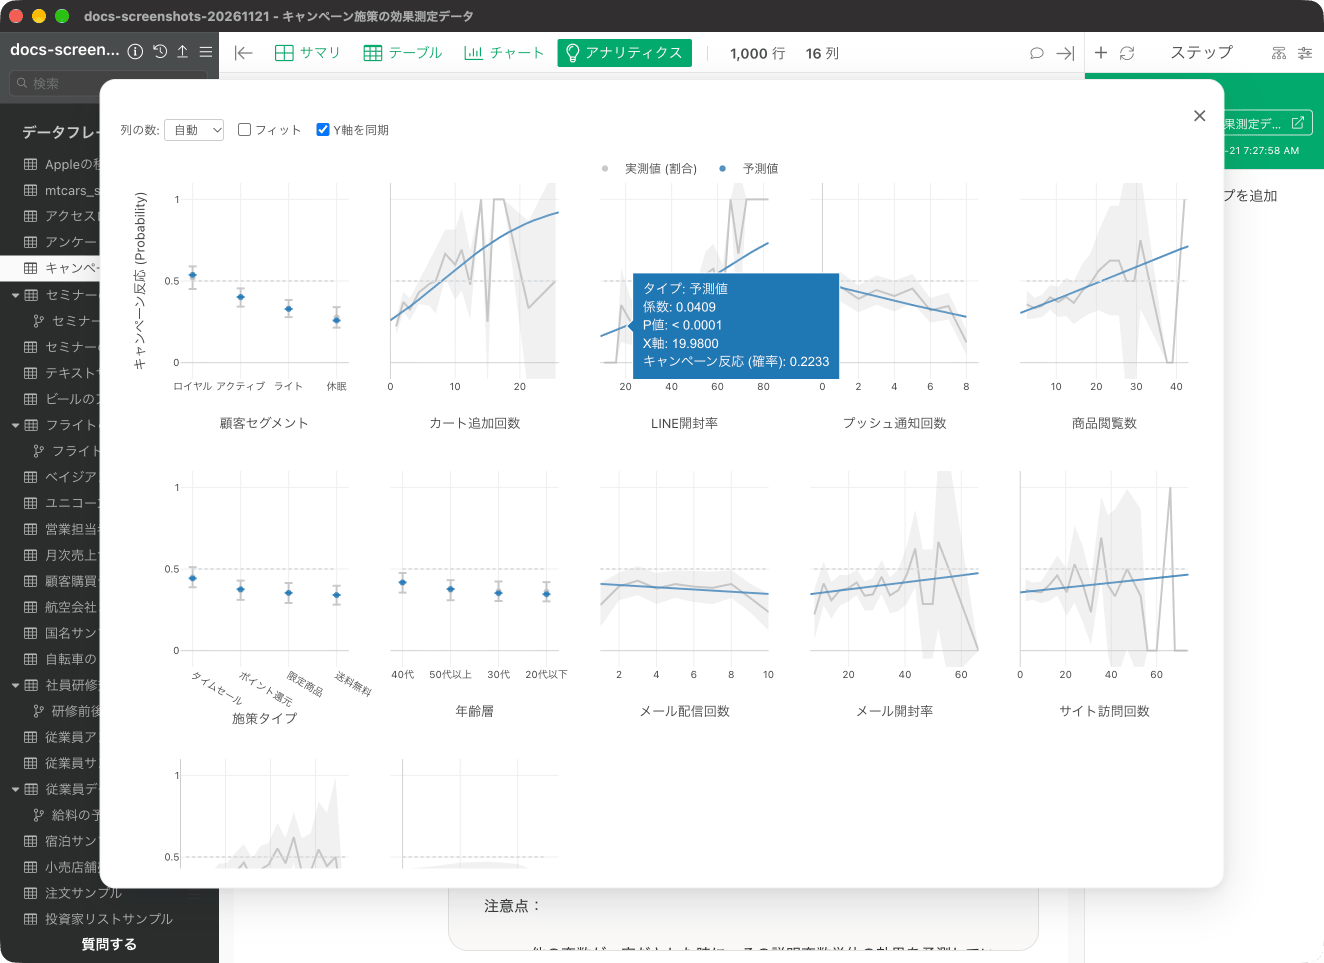
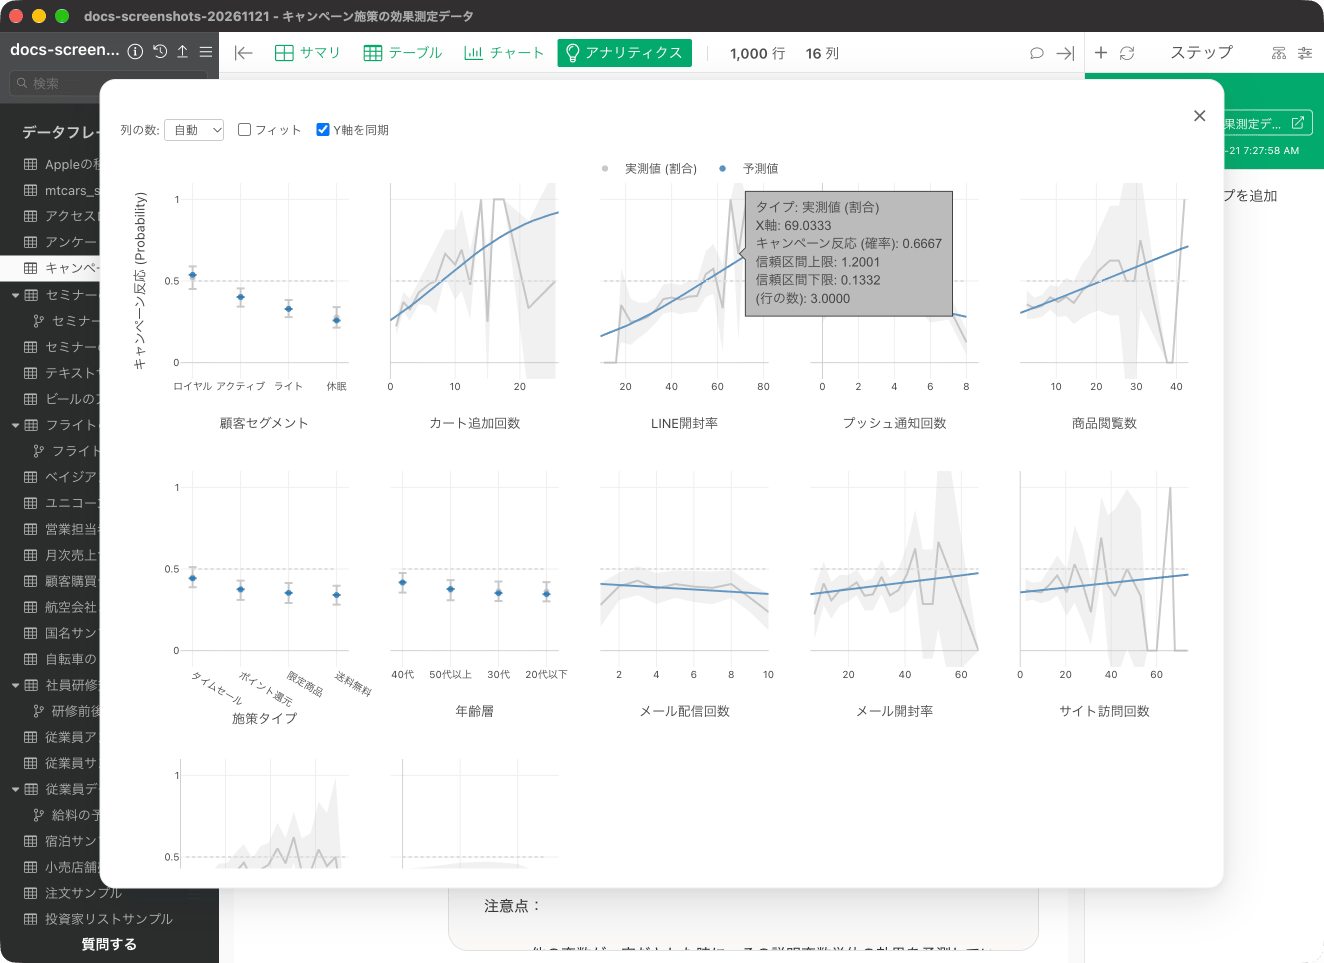
同じ「変数間の関係」の節にある「説明変数の影響度」では、各説明変数がキャンペーン反応の確率に与える影響の方向と強さを確認できます。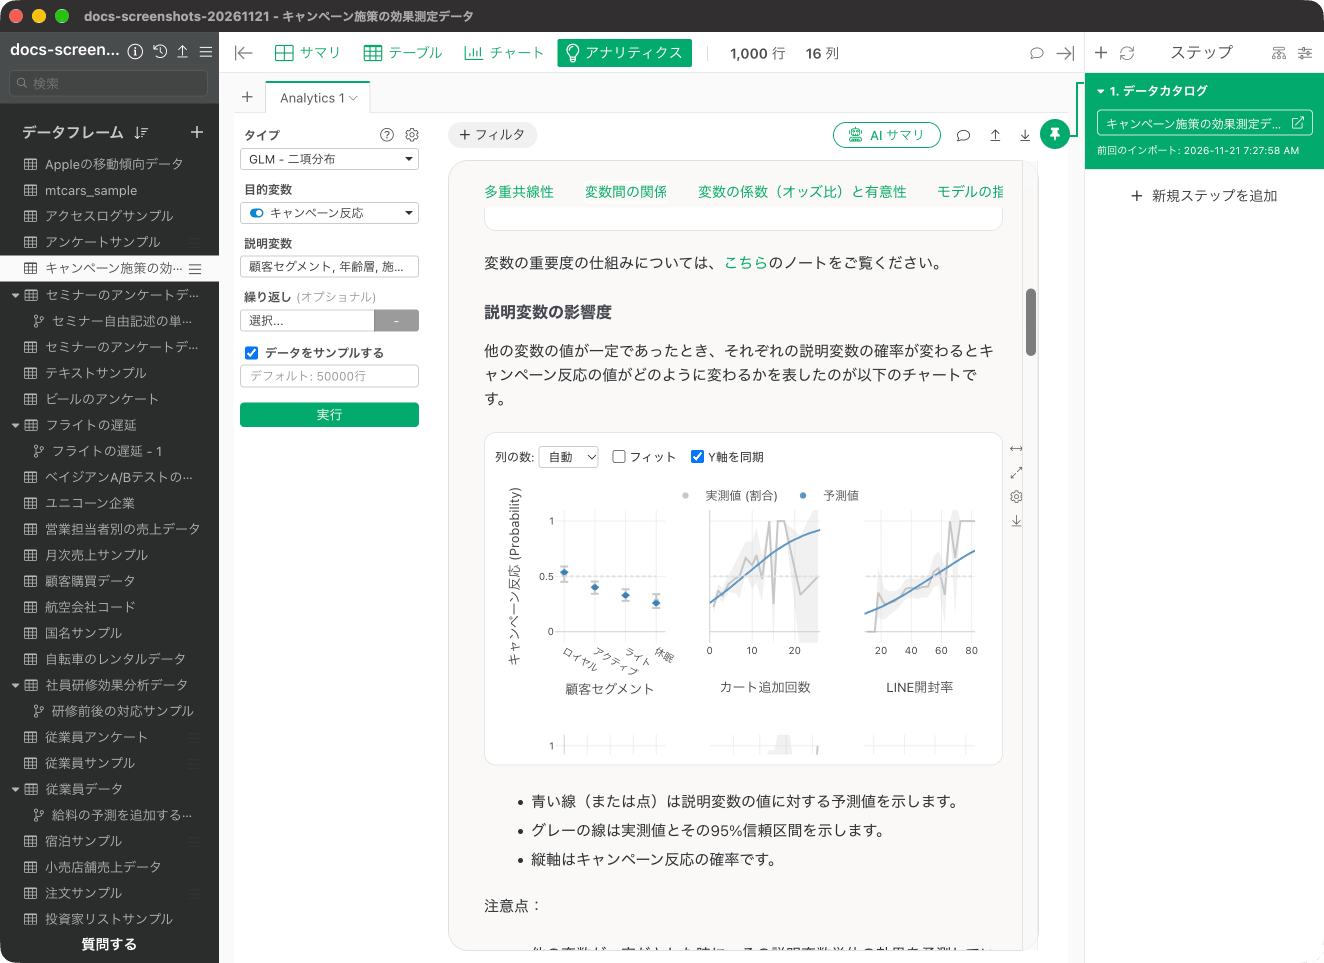
変数の係数と有意性
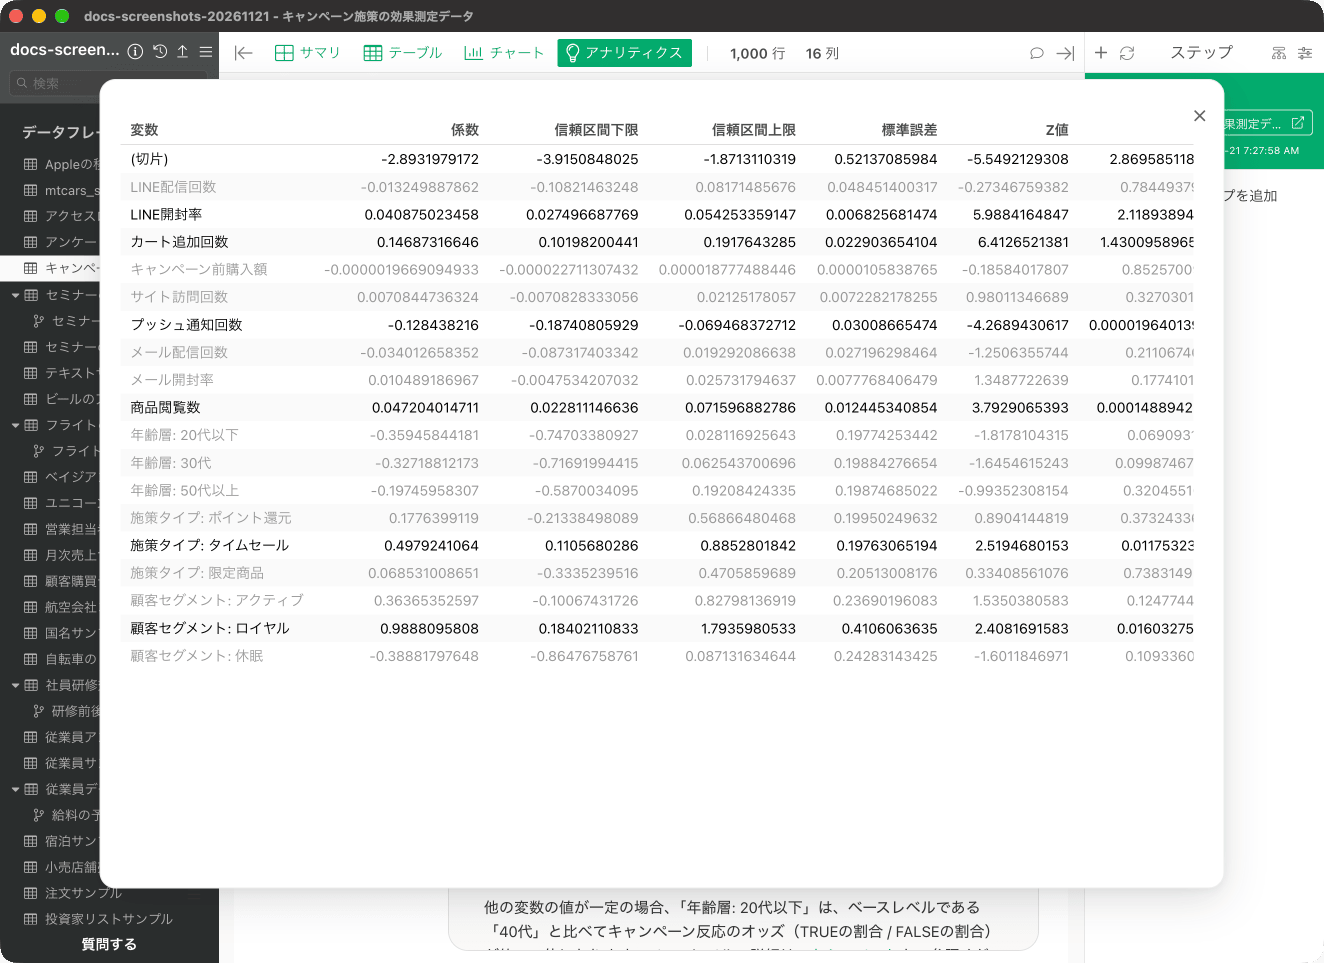
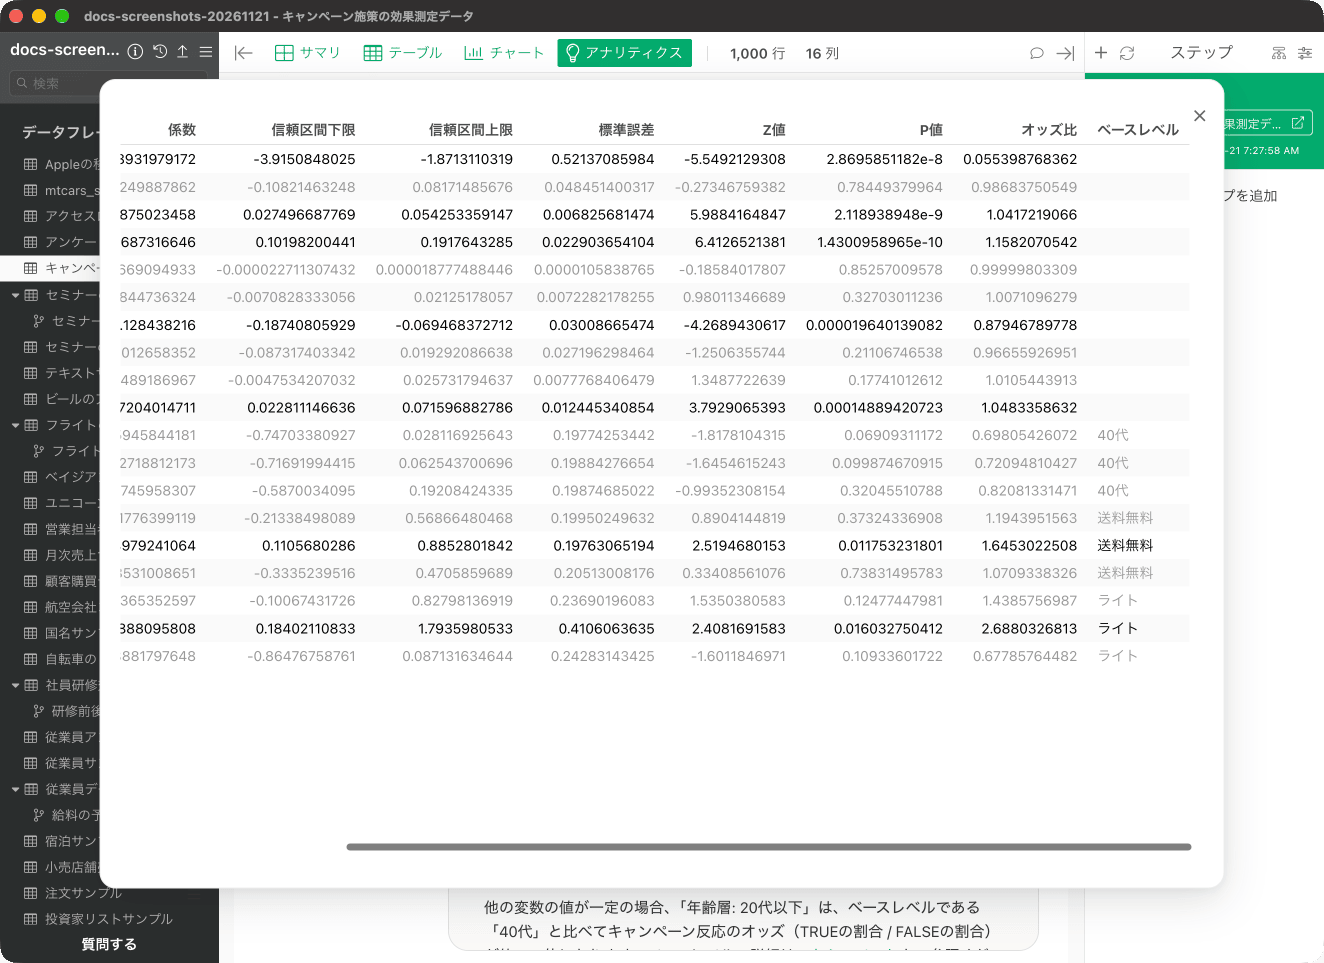
「変数の係数(オッズ比)と有意性」の節では、各説明変数の係数とその統計的有意性を確認できます。表を右へスクロールすると、「オッズ比」と「ベースレベル」の列が表示されます。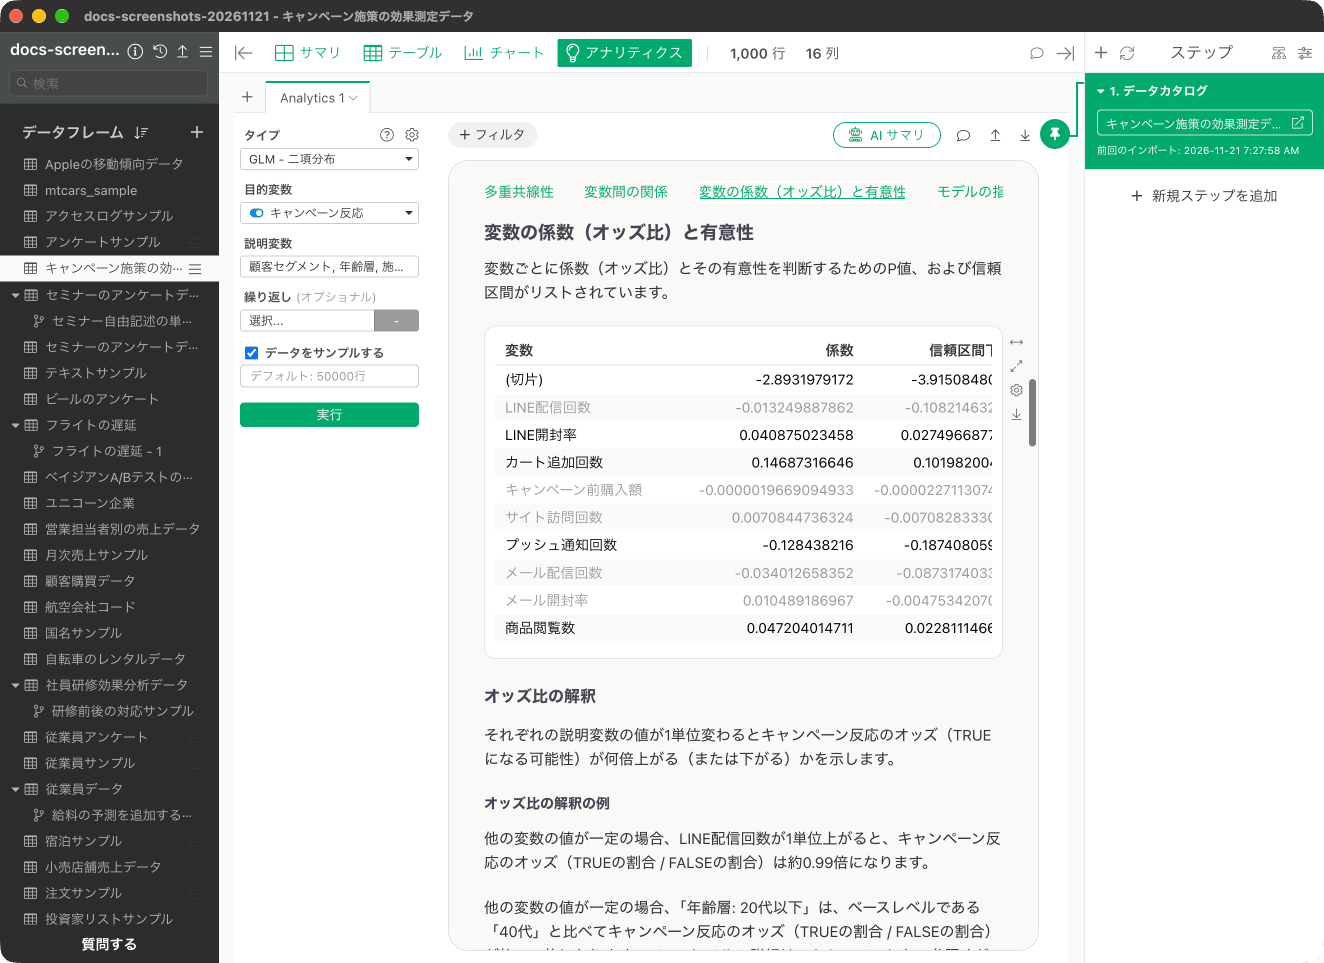
モデルの指標
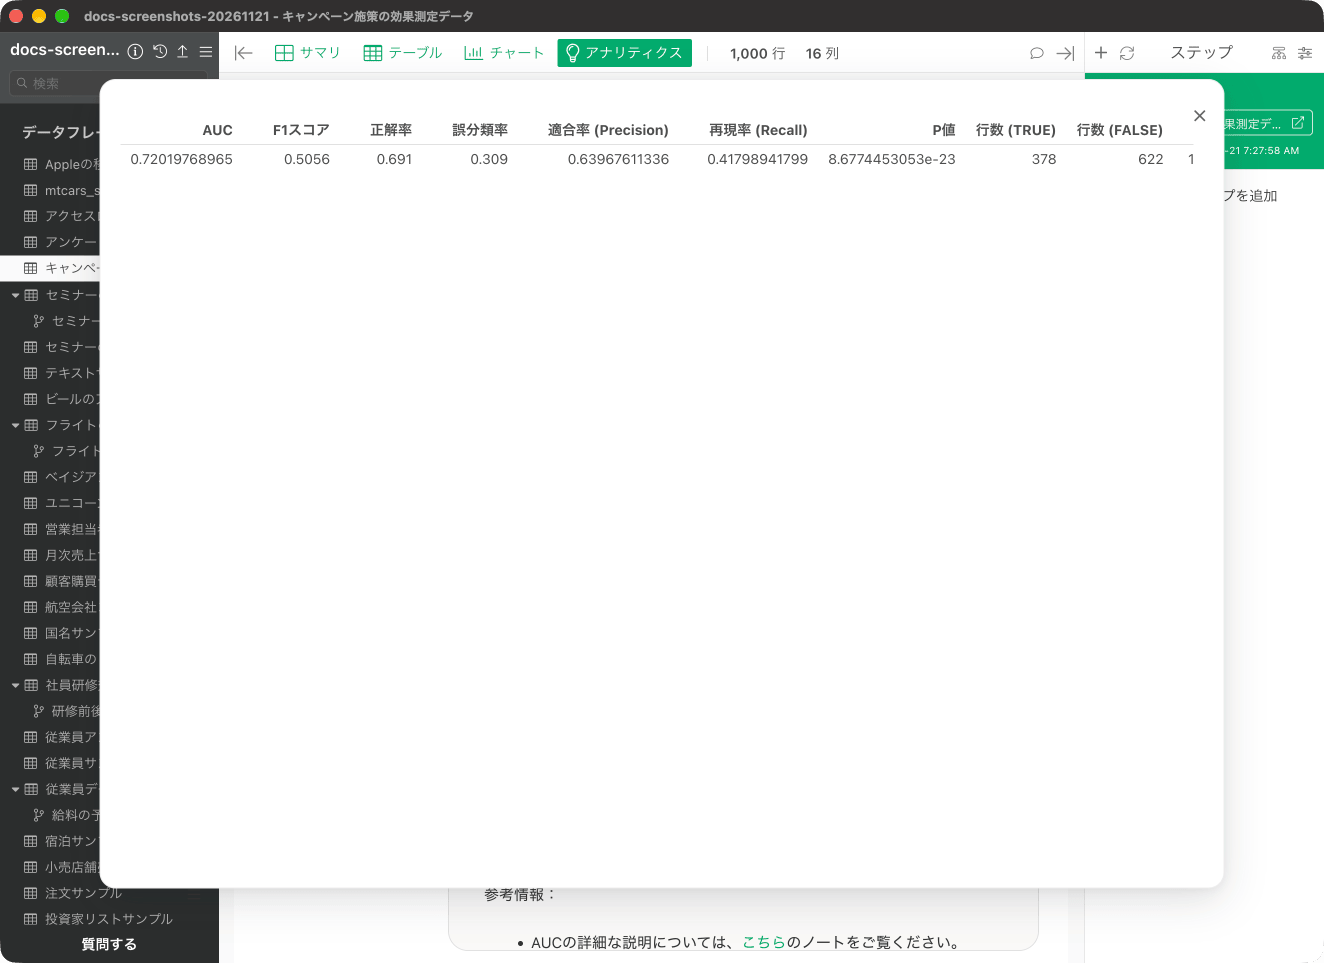
「モデルの指標」の節では、モデル全体の予測精度を確認できます。表には、AUC(0.7202)、F1スコア(0.5056)、正解率(0.691)、誤分類率(0.309)、適合率、再現率、P値、行数(TRUE と FALSE)が表示されます。「予測精度」の解説では、目的変数がロジカル型(TRUE/FALSE)の場合に予測精度を評価する指標としてAUCがよく使われると説明されています。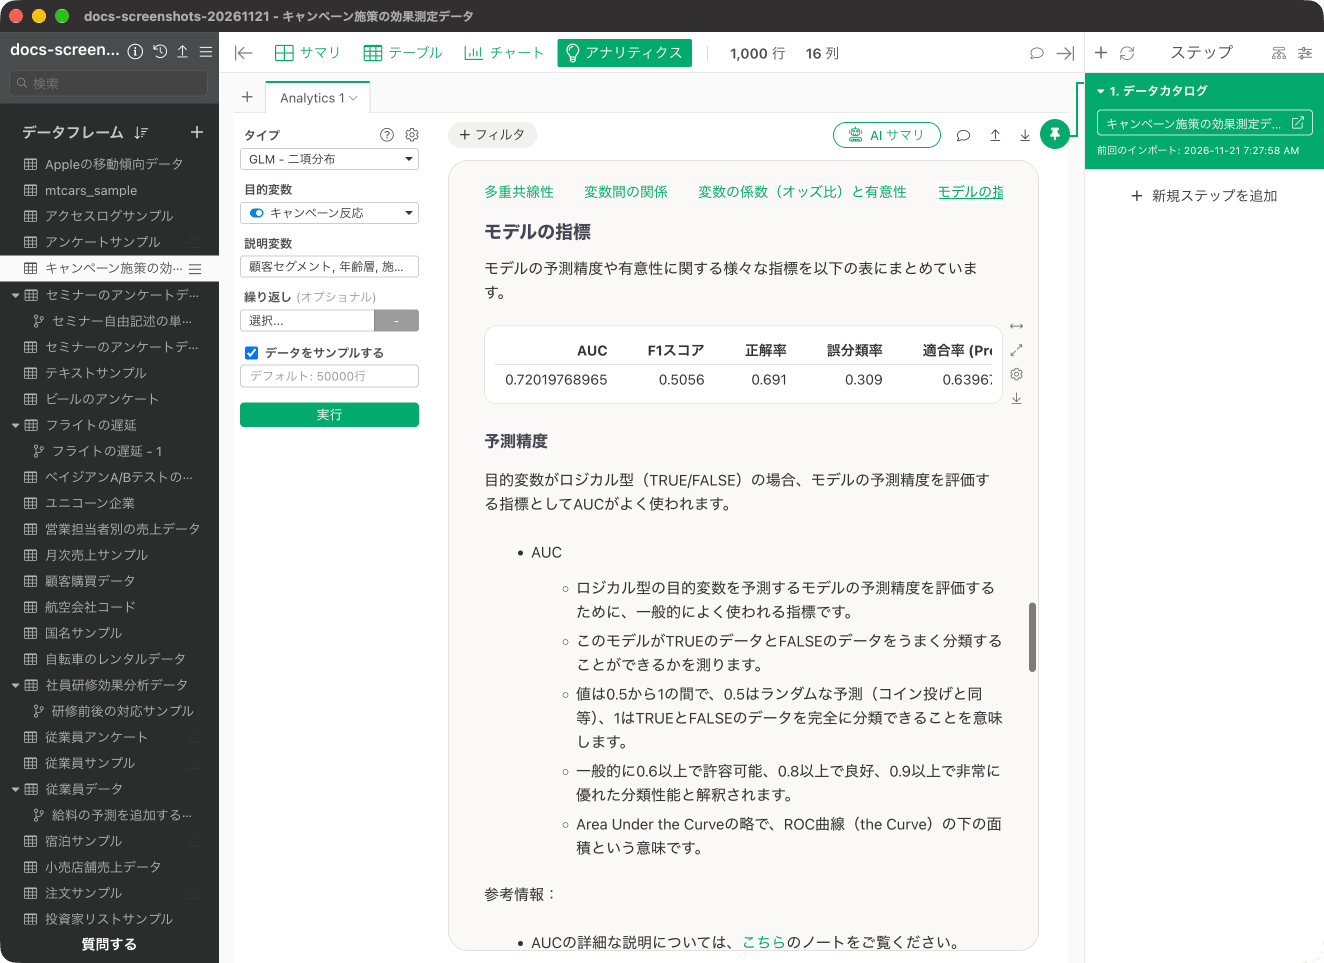
ガンマ分布
一般化線形モデル(GLM)のガンマ分布は、0より大きい数値データを分析する際に特に有用な統計モデルです。通常の線形回帰では適切に扱えない、値が0より大きく右に裾が長い分布を持つデータに対して効果的です。特に、保険金支払額、医療費、修理費用など、金額に関連するデータ分析でよく使用されます。 ガンマ分布GLMの特徴は、データの分散が平均の二乗に比例するという性質を持っていることです。これは、多くの金銭的なデータでみられる特徴と一致しています。例えば、保険金支払いデータでは、平均支払額が大きくなるほど、支払額のばらつきも大きくなる傾向がありますが、このような現象をガンマ分布GLMは適切にモデル化できます。 さらに、ガンマ分布GLMは、説明変数が目的変数に対して乗法的な効果を持つことを仮定しています。これは、例えば年齢が1歳増えることで支払額が一定の割合で増加するといった、実務でよく観察される関係性を自然にモデル化できることを意味します。また、対数リンク関数を使用することで、予測値が常に正の値となることが保証され、金額データの分析に適しています。どういった時に使えるのか
ガンマ分布GLMは、特に金額や時間など、0より大きい値を取り、平均が大きくなるほどばらつきも大きくなるような現象を分析する際に適しています。例えば、保険業界での保険金支払額の予測では、事故の重大性や契約者の属性によって支払額が変動しますが、その変動は平均支払額が大きいほど大きくなる傾向があります。また、医療分野での入院期間の分析では、疾患の重症度や患者の年齢によって入院期間が変動し、平均期間が長くなるほどばらつきも大きくなる傾向があります。 このモデルは、説明変数が目的変数に対して掛け算的な効果を持つ場合に特に有効です。たとえば、自動車保険の修理費用分析では、車両の年式が1年古くなることで修理費用が一定の割合で増加するような関係性を適切にモデル化できます。また、製造業での製品不良率分析において、製造時間と不良率の関係性を分析する際にも、時間の経過とともに不良率が一定の割合で変化するような現象をモデル化できます。 以下のようなデータ例で特に有効です:- 保険金支払データ(契約者属性、保険種類、事故状況と支払額の関係)
- 医療費データ(患者属性、疾患、治療内容と医療費の関係)
- 修理費用データ(製品年齢、故障内容、部品コストと修理費用の関係)
- 販売時間データ(商品特性、販売チャネル、季節性と販売所要時間の関係)
ユースケース
-
保険業界での使い方
- 保険金支払部門では、新規契約の査定や保険料設定の際に使えます。
- 具体的には、契約者の年齢、既往歴、生活習慣などの要因が支払額にどの程度影響を与えるかを分析する際にガンマ分布GLMを使うことで、各要因の影響度を正確に把握できるようになります。
- これにより、リスク要因に応じた適切な保険料設定や、支払リスクの高い契約の早期発見といった施策を実施できます。
-
医療業界での使い方
- 病院の経営企画部門では、診療科別の医療費予測に使えます。
- 具体的には、患者の年齢、疾患の種類、治療方法などが医療費にどのように影響するかを分析する際にガンマ分布GLMを使うことで、医療費の変動要因を特定できるようになります。
- これにより、診療科別の予算配分の最適化や、高額医療費が発生しやすい患者群の特定といった施策を実施できます。
-
データアナリストでの使い方
- ビジネスコンサルティングの場面で、クライアントの費用分析に使えます。
- 具体的には、プロジェクトの規模、期間、投入リソースなどがコストにどのように影響するかを分析する際にガンマ分布GLMを使うことで、コスト変動の要因を特定できるようになります。
- これにより、プロジェクトの予算策定や、コスト削減施策の提案といった具体的なアクションにつなげることができます。
-
品質管理エンジニアでの使い方
- 製造業の品質管理部門で、製品の不良率分析に使えます。
- 具体的には、製造条件、材料特性、環境要因などが不良率にどのように影響するかを分析する際にガンマ分布GLMを使うことで、不良発生のメカニズムを理解できるようになります。
- これにより、製造条件の最適化や、重点的な品質管理ポイントの特定といった施策を実施できます。
Exploratoryで一般化線形モデル(GLM - ガンマ分布)を実行する
使用するデータ
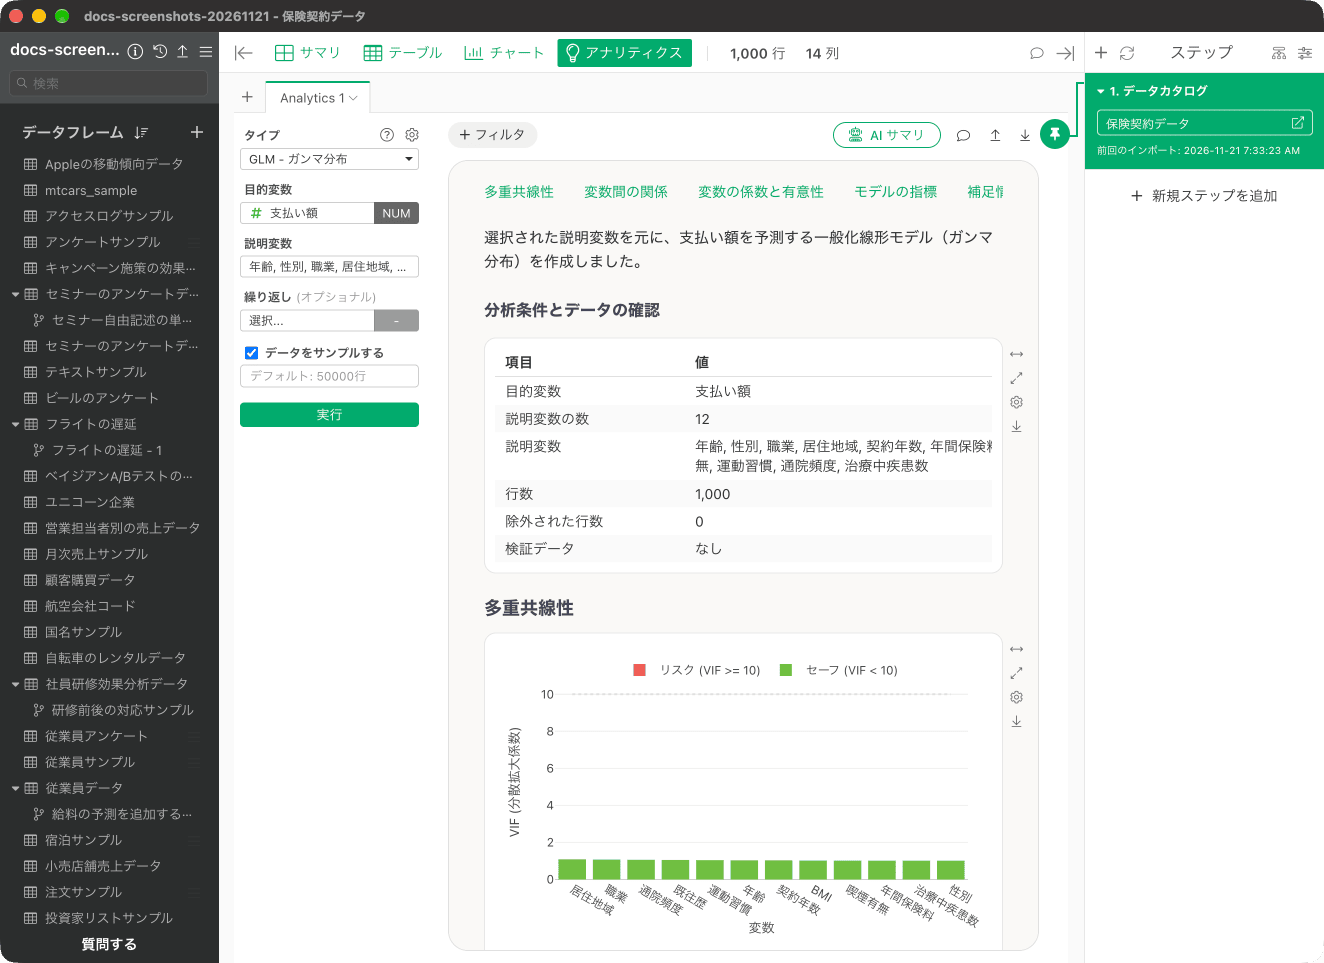
今回は「保険契約データ」を使用します。データはこちらからダウンロードが可能となっています。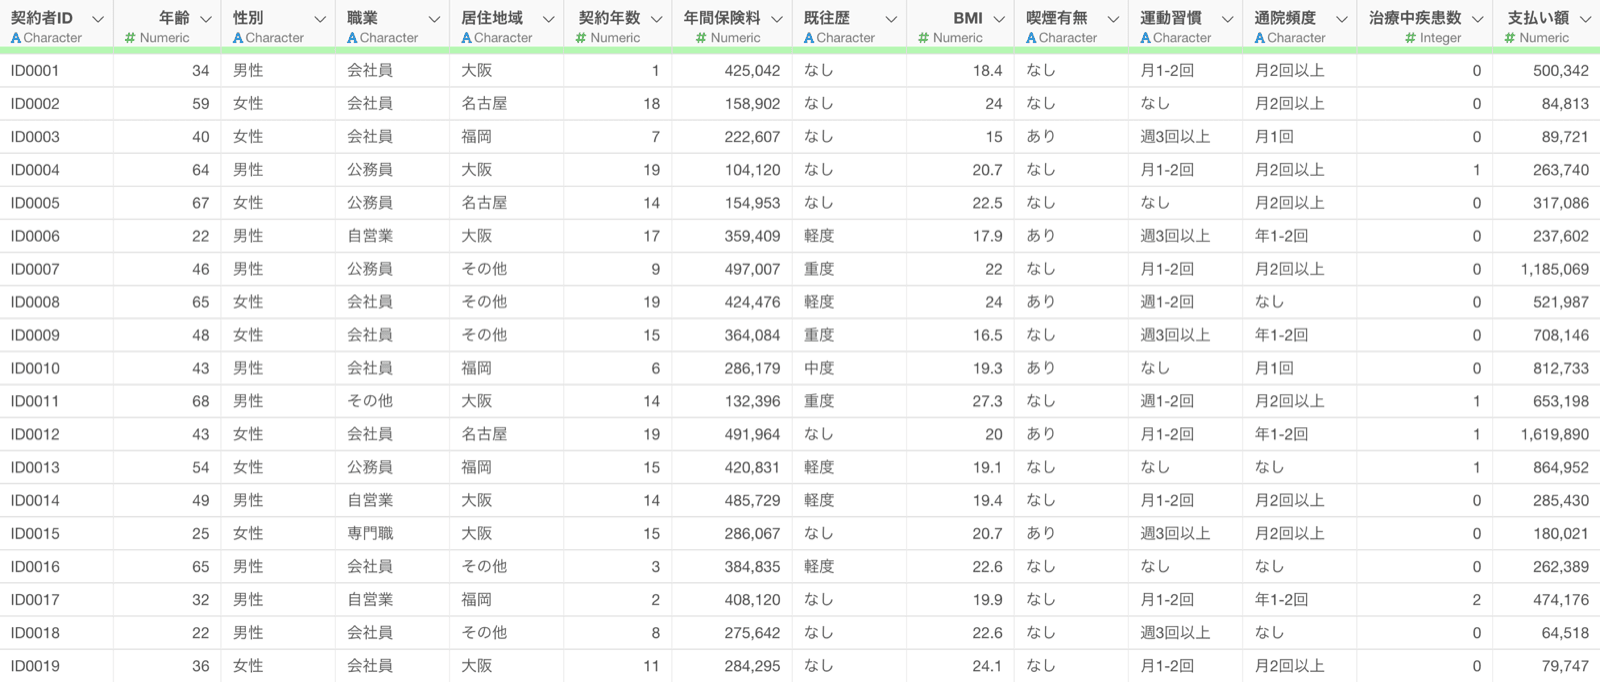
- 目的変数は0より大きい連続値であること
- 目的変数の分散が平均の二乗に比例する傾向があること
- 説明変数は数値型(例:年齢、契約年数)やカテゴリ型(例: 性別、運動習慣)などの変数を使用します。
アナリティクスを作成する
保険契約データ(1,000行・14列)から「アナリティクス・ビュー」を開きます。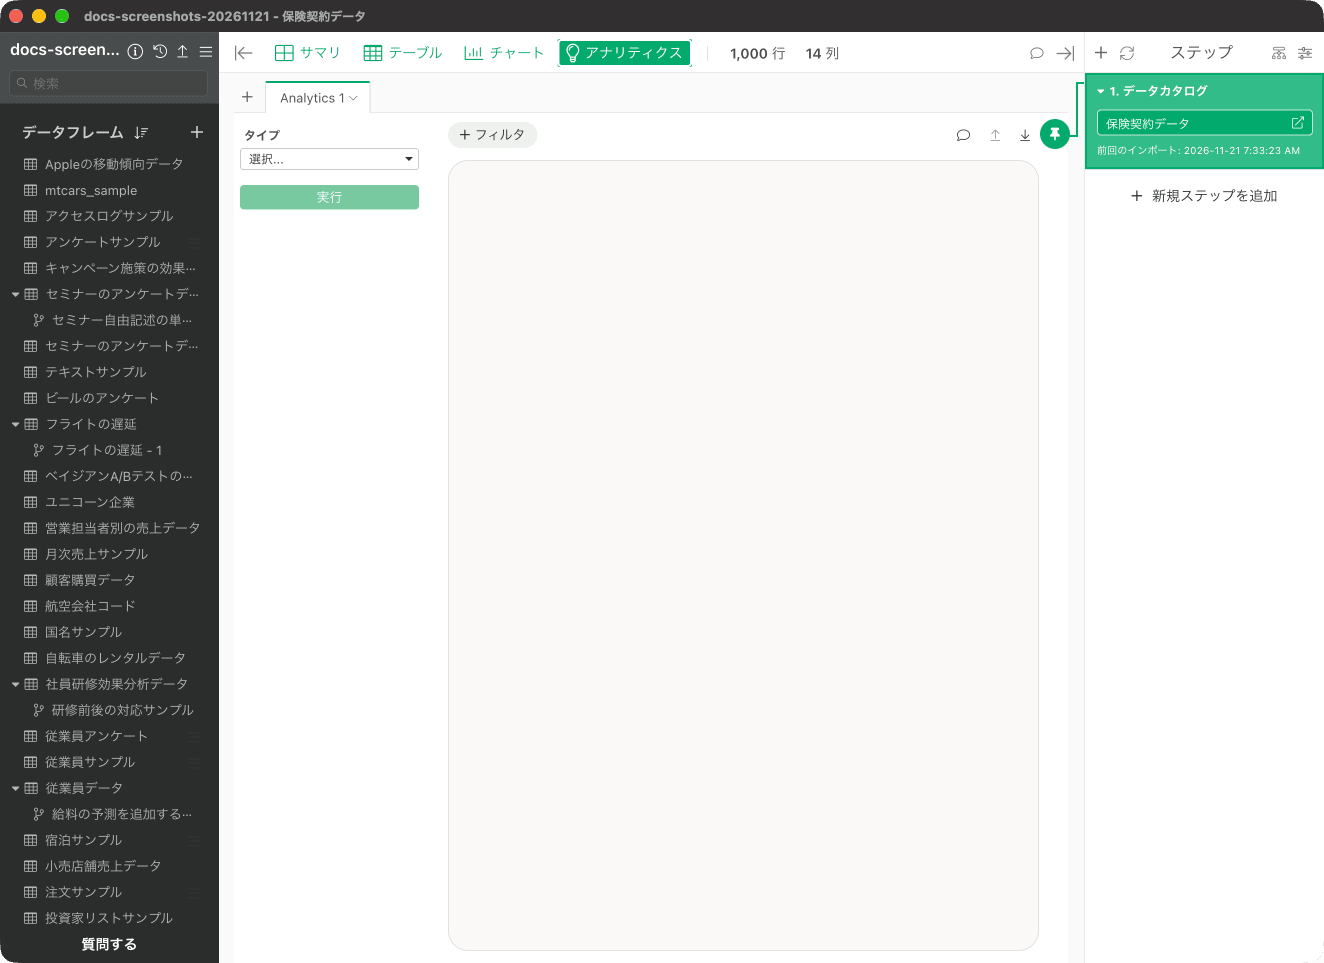
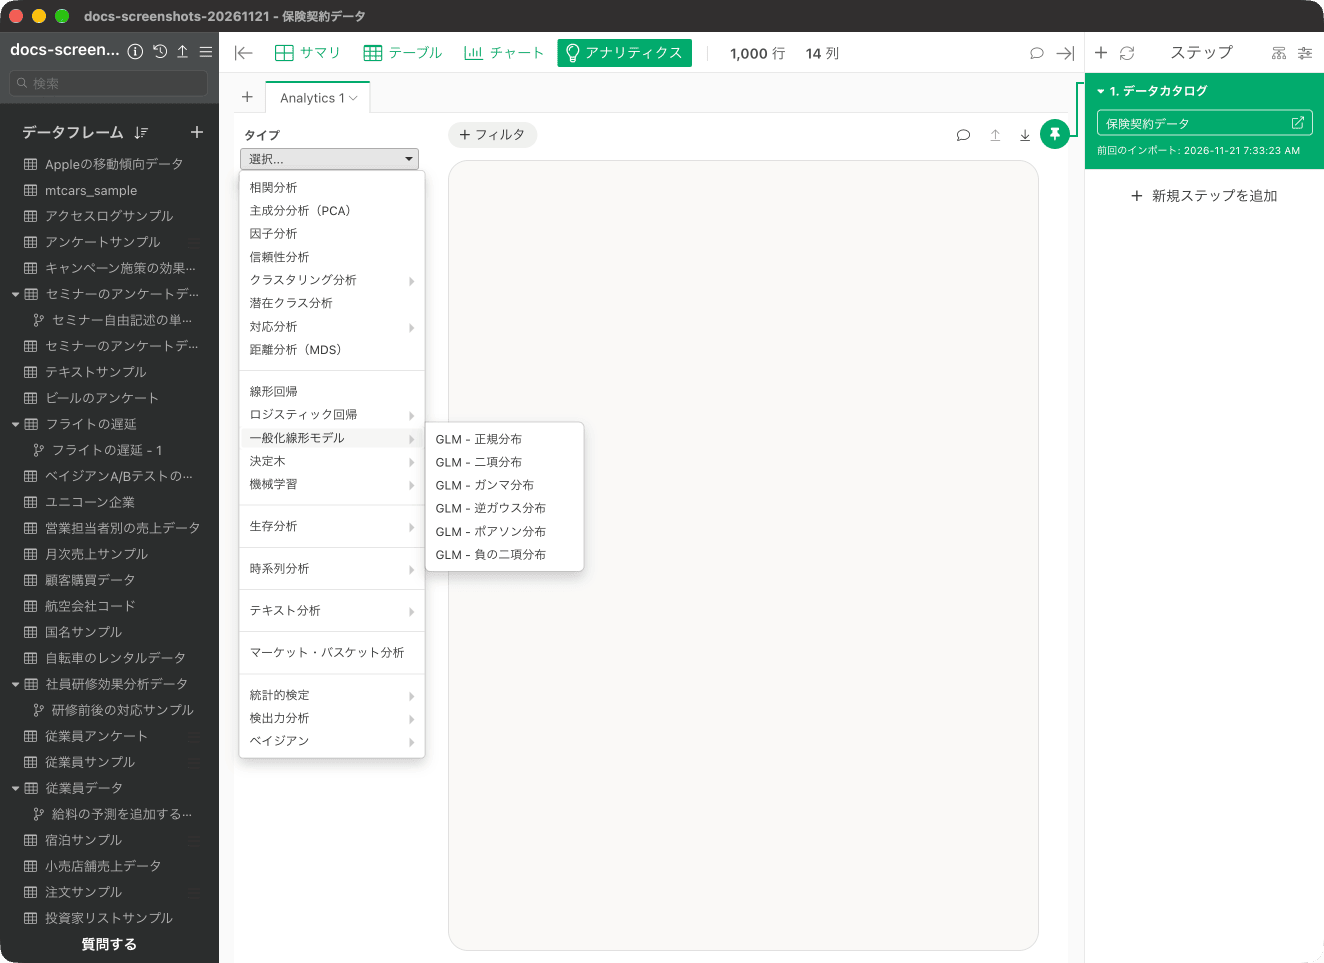
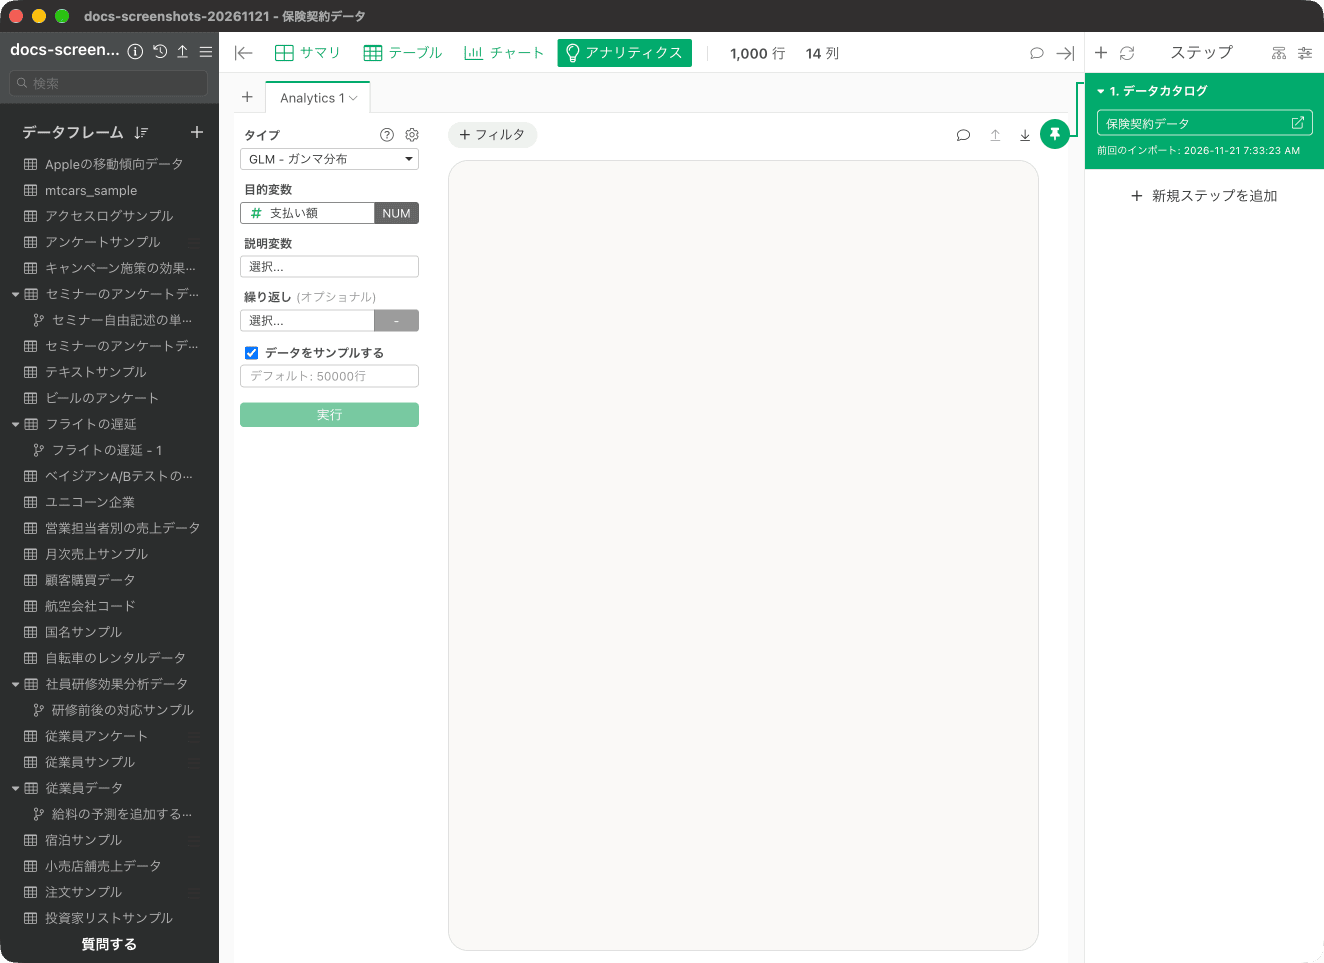
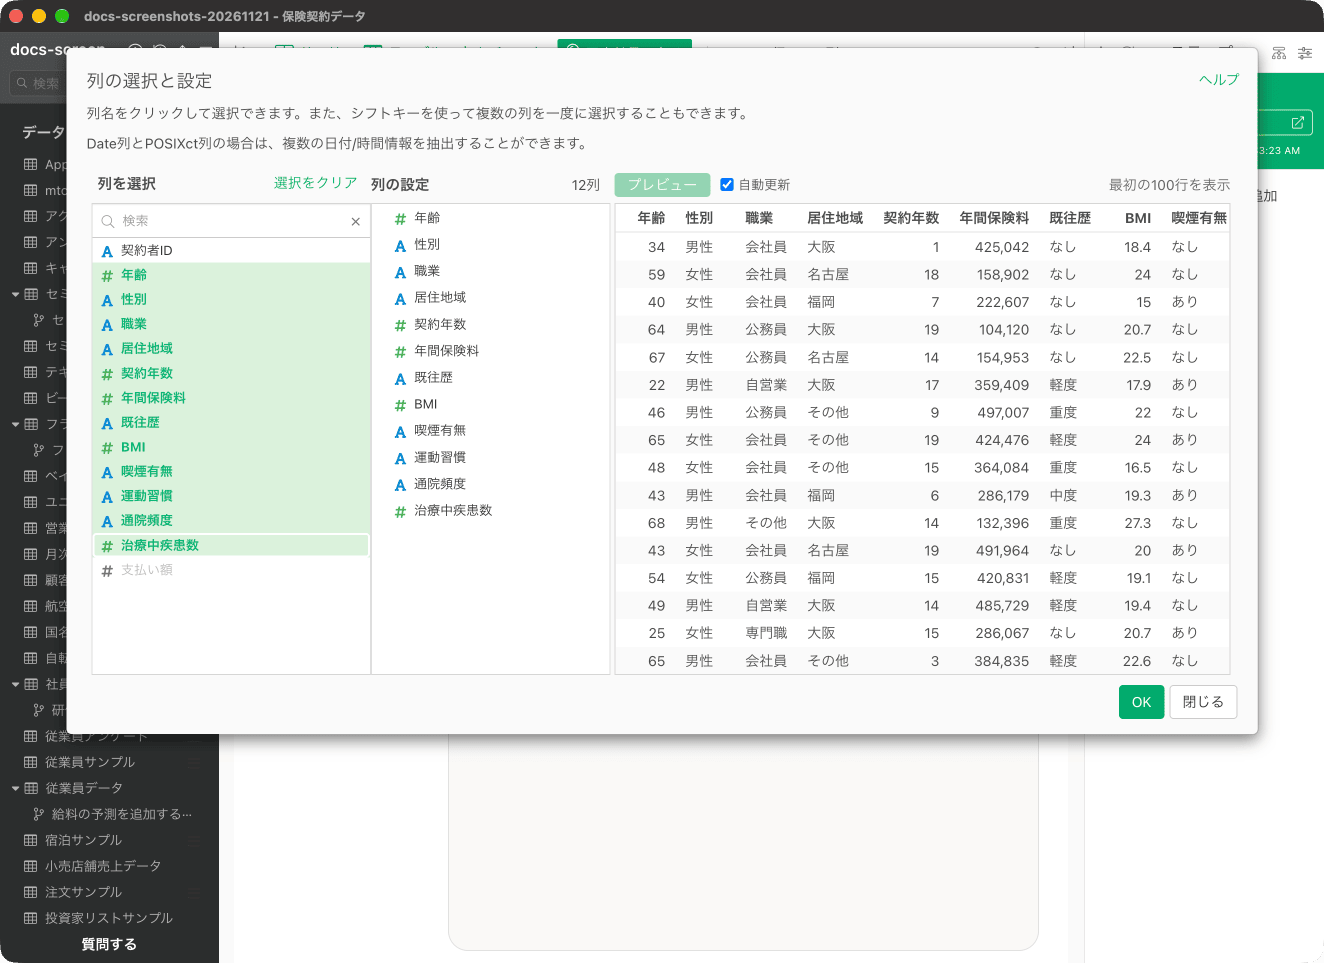
結果の解釈
一般化線形モデル(GLM - ガンマ分布)では、保険金支払額に影響を与える要因を解釈するために、以下の節が用意されています。多重共線性
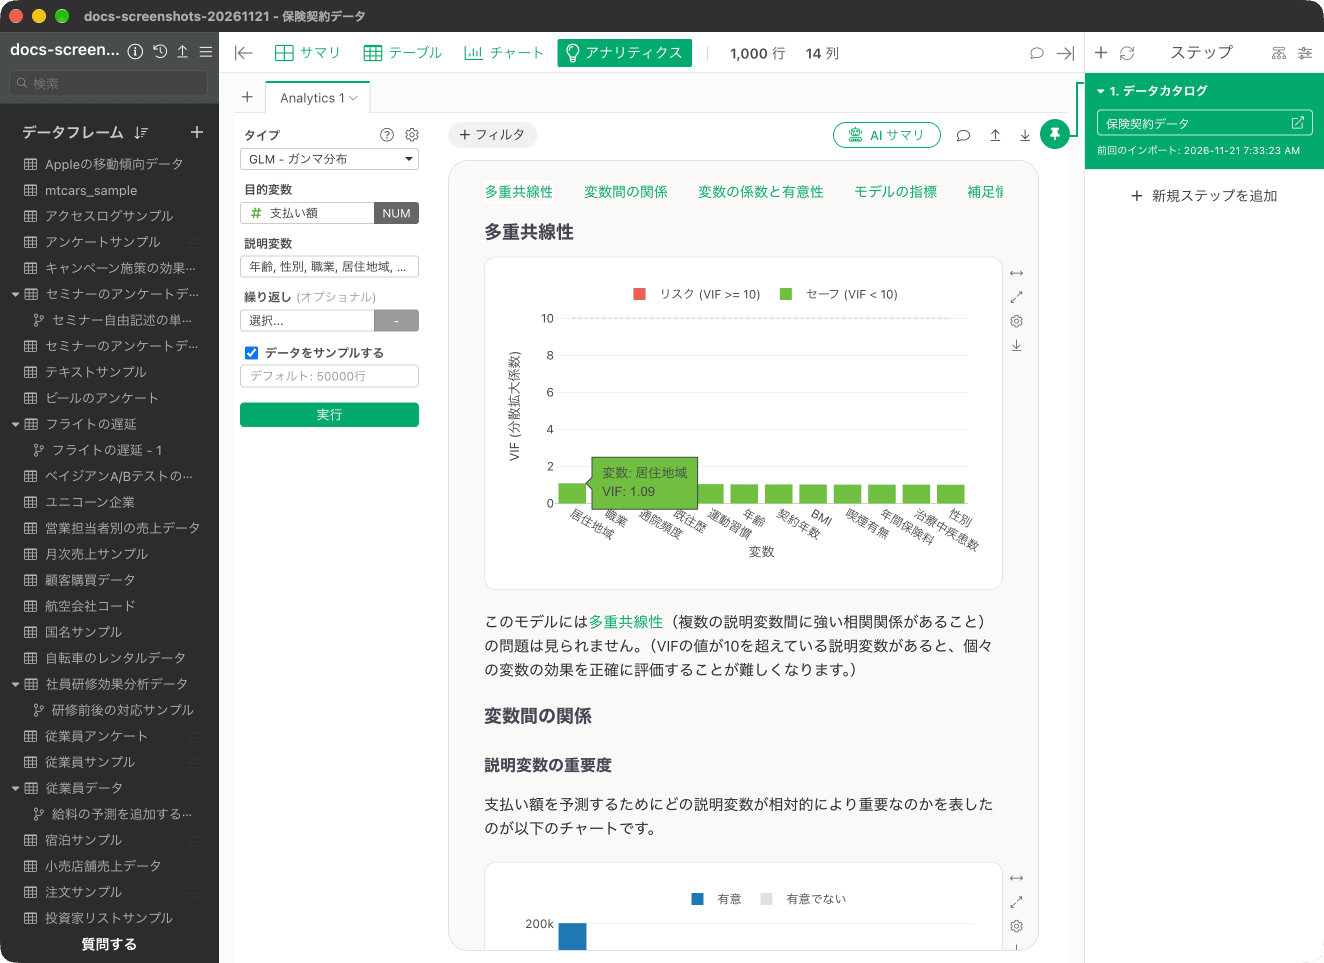
「多重共線性」の節では、説明変数間の相関が強すぎる(VIF 10以上)組み合わせがないかを確認できます。VIFが10以上の変数がある場合、説明変数間の相関が強く、傾きが不安定になる可能性があるため、変数の選択を見直す必要があります。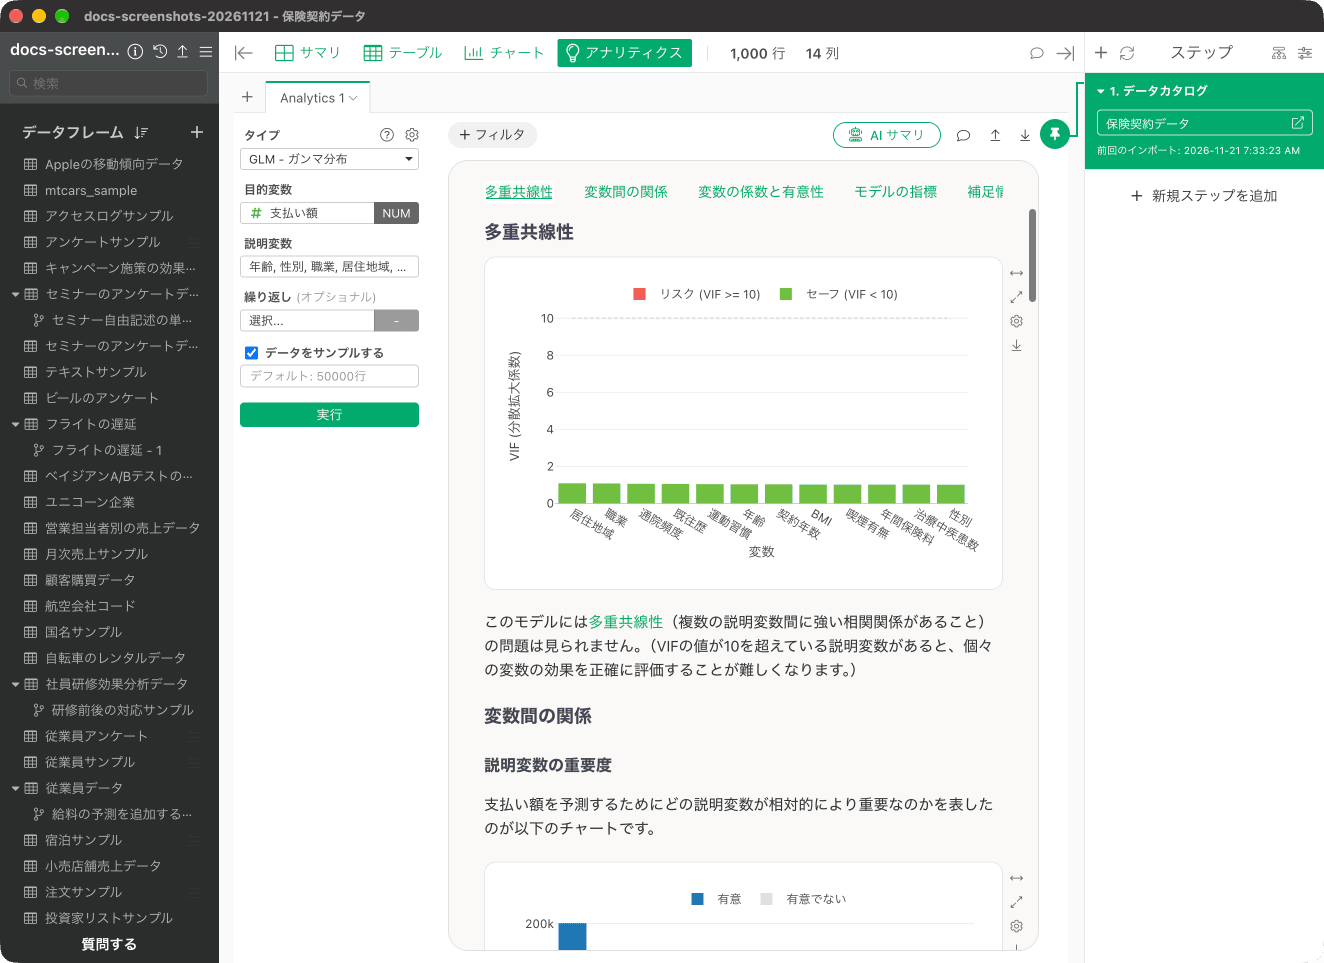
説明変数の重要度
「変数間の関係」の節にある「説明変数の重要度」では、目的変数を予測する上でどの変数が重要なのかを確認できます。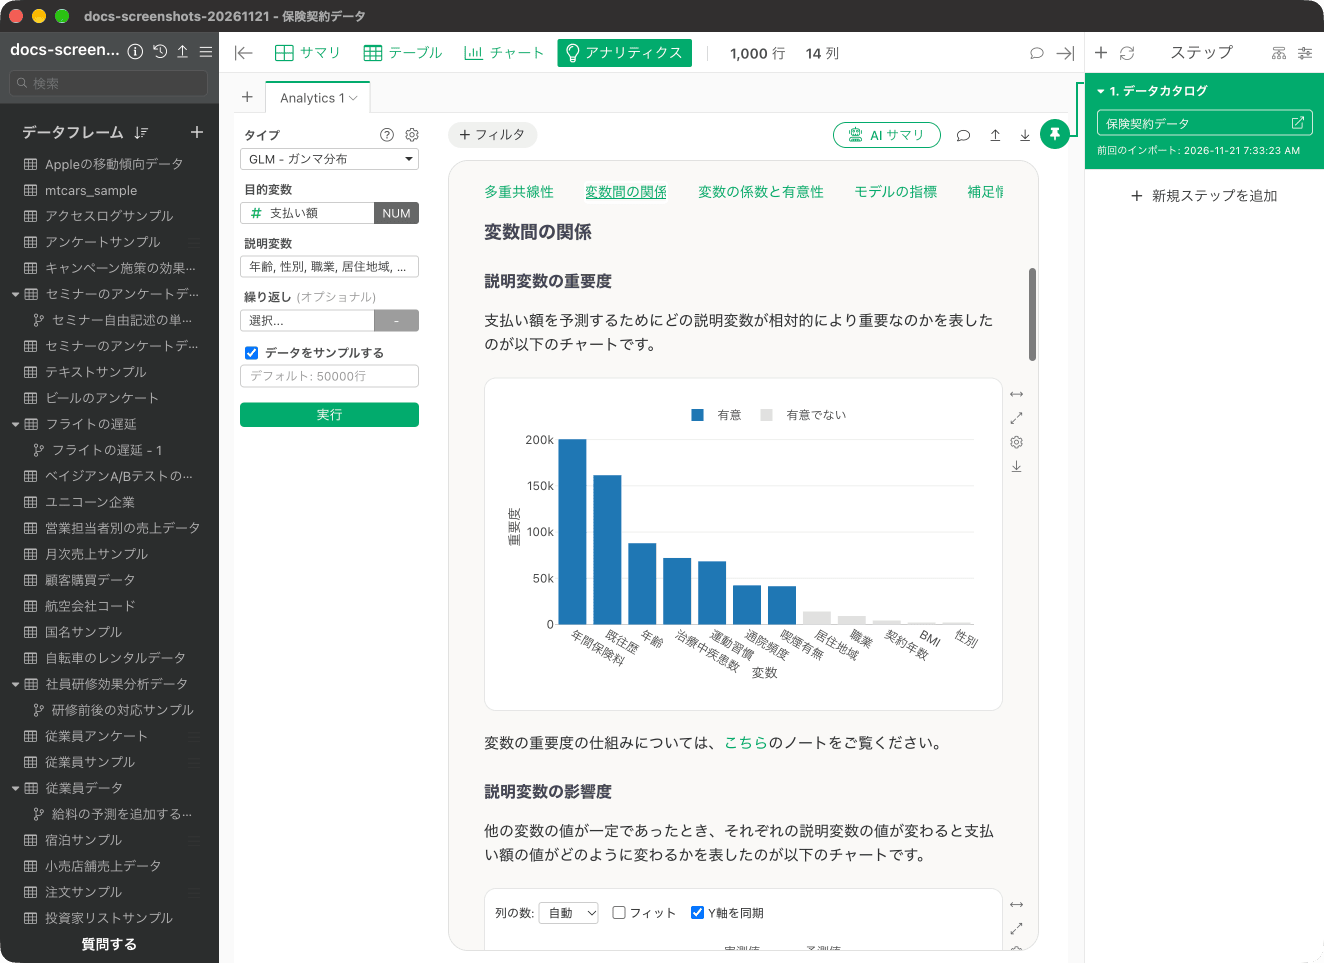
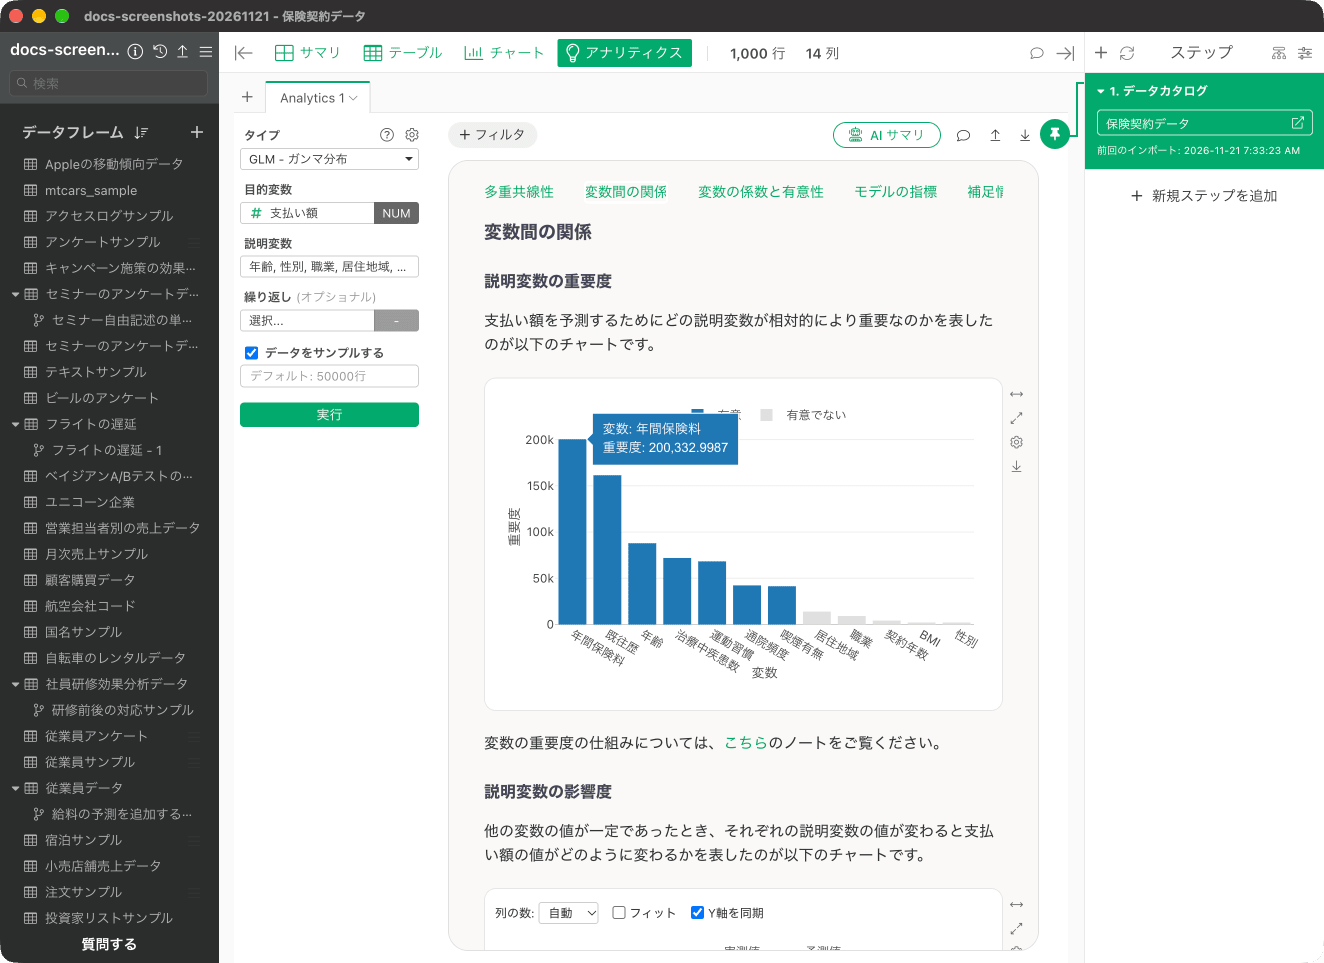
説明変数の影響度
「変数間の関係」の節にある「説明変数の影響度」では、各説明変数が支払額に与える影響の方向と強さを確認できます。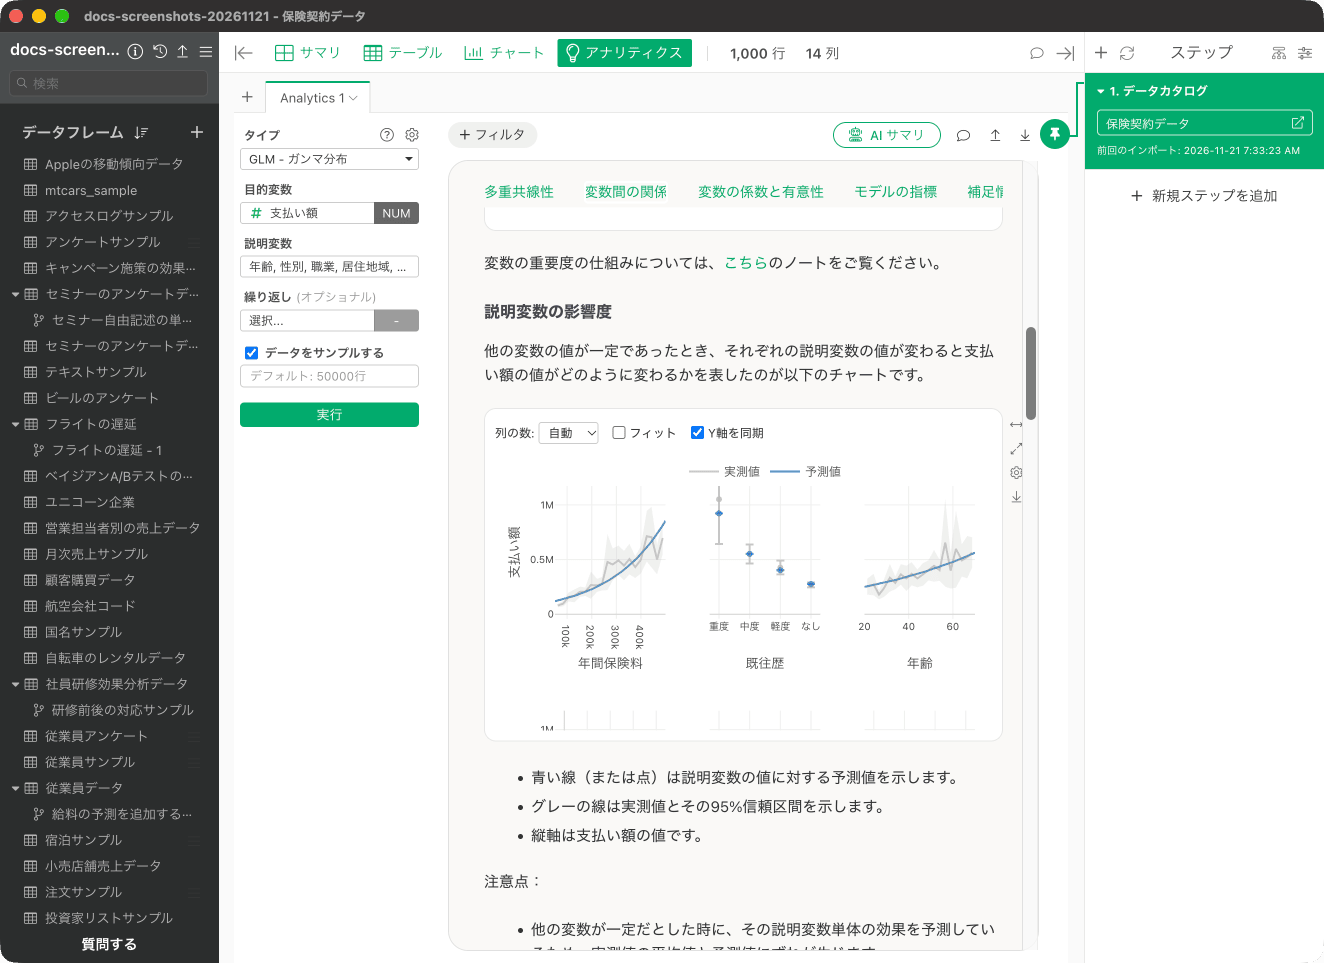
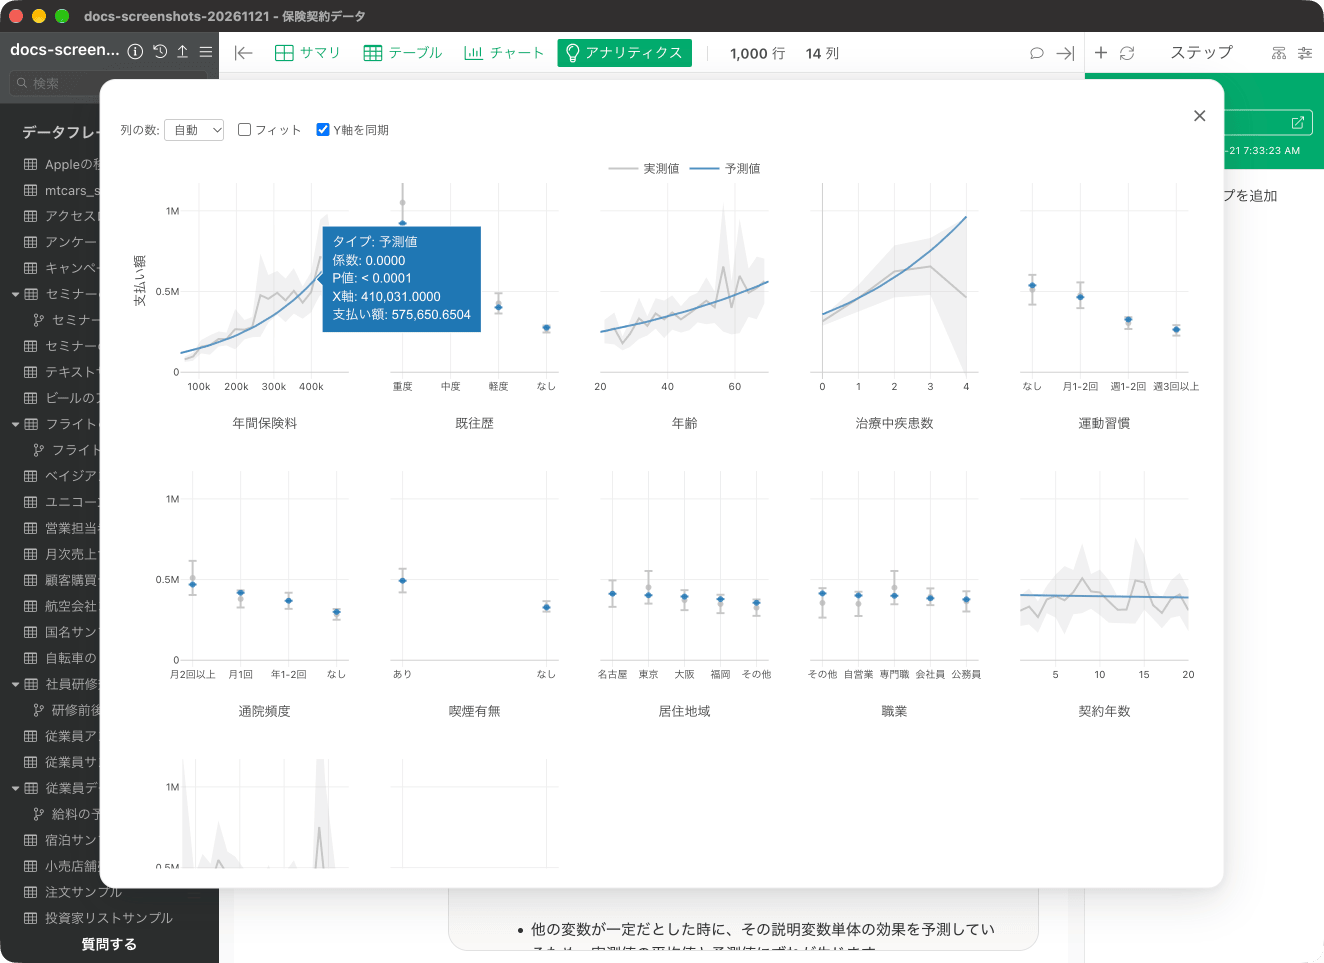
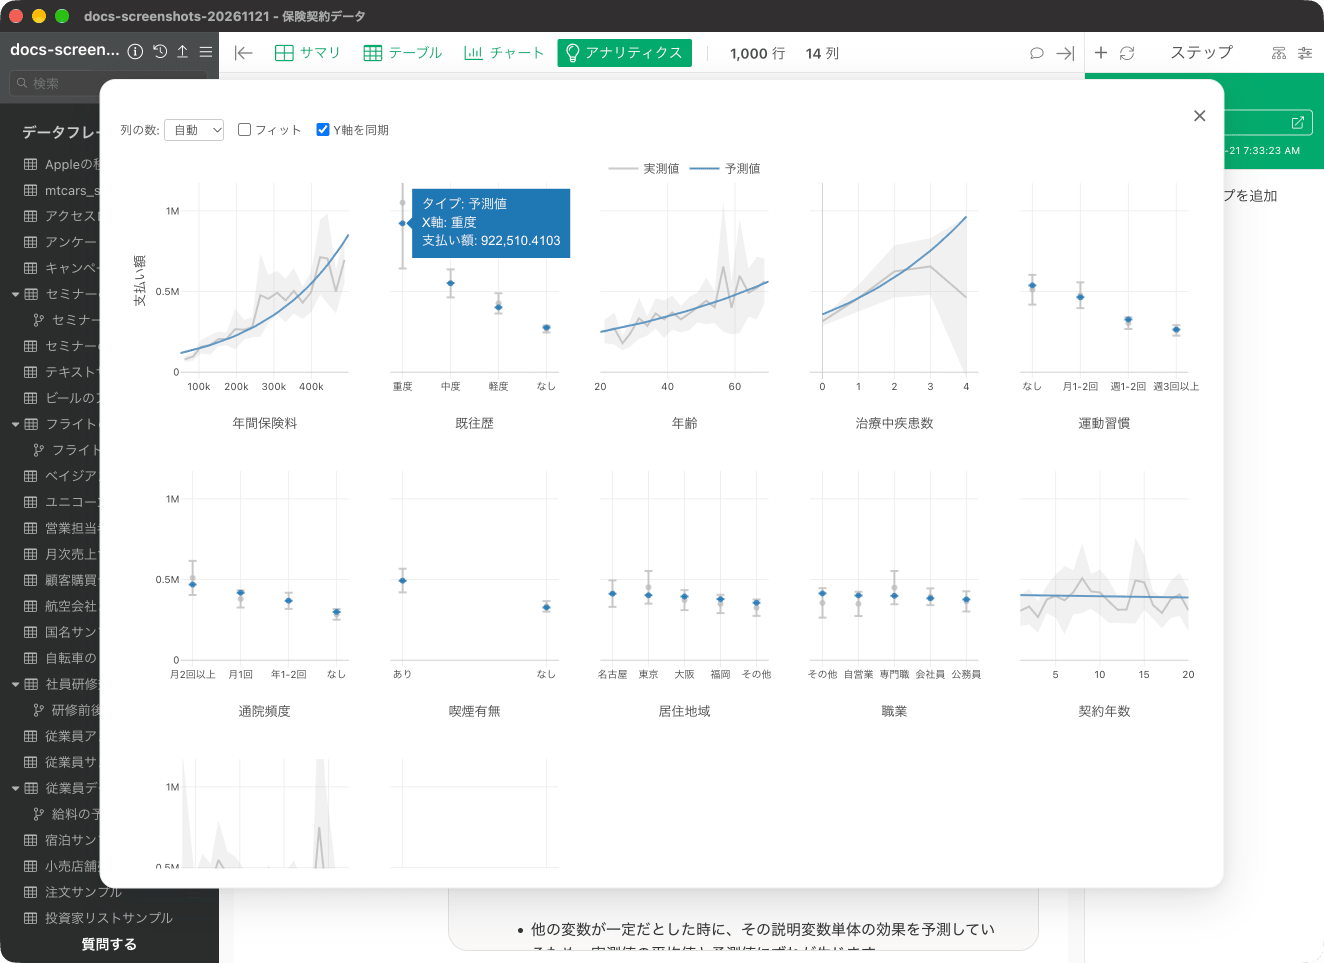
変数の係数と有意性
「変数の係数と有意性」の節では、各説明変数の係数とその統計的有意性を確認できます。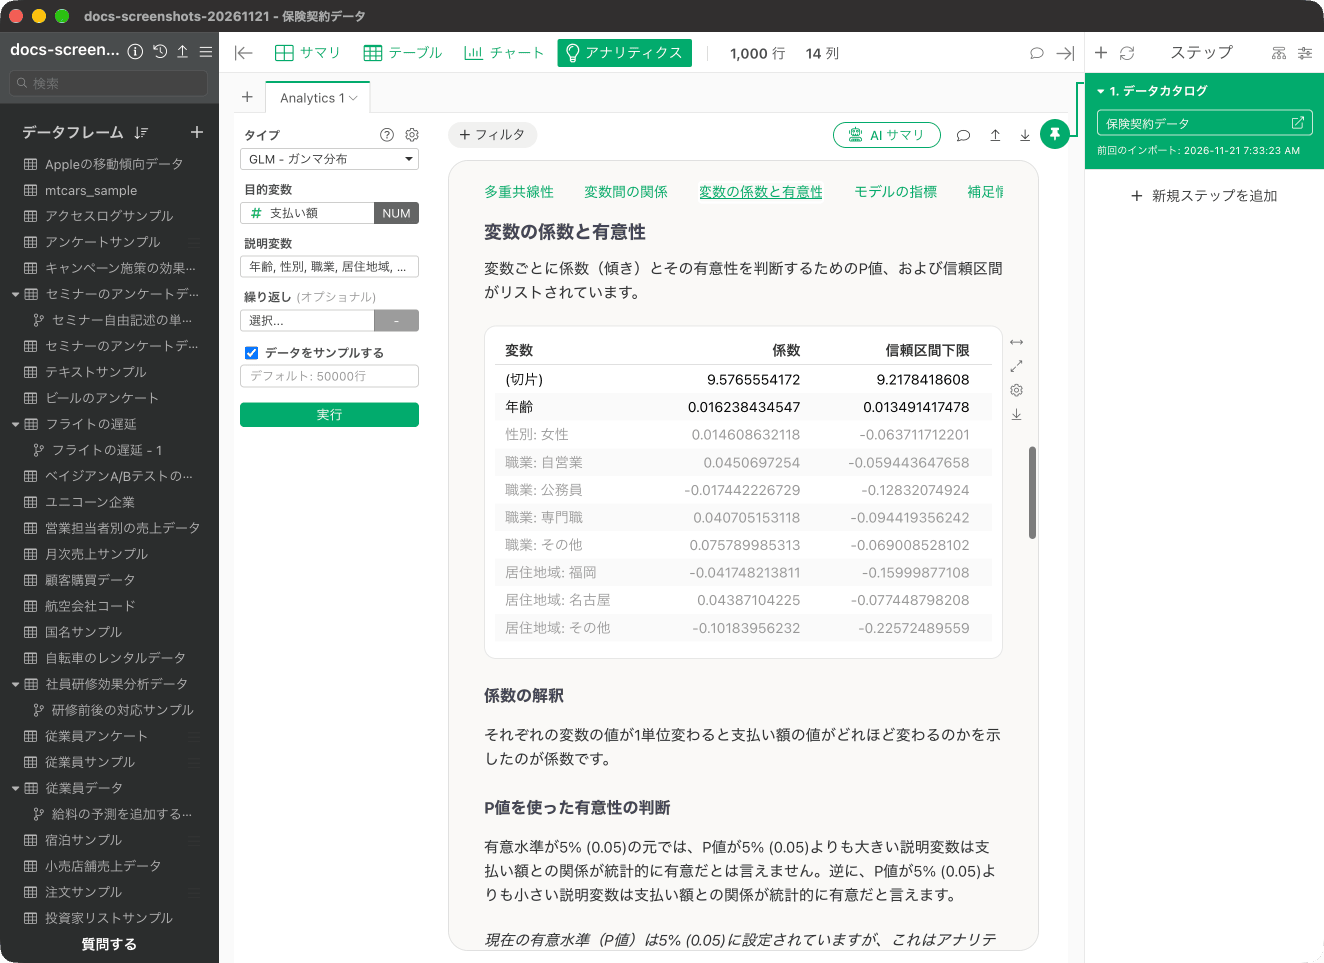
- 係数の指数を取る: exp(0.016238) = 1.016
- この値から1を引く: 1.016 - 1 = 0.016
- パーセンテージに変換: 0.016 × 100 = 1.6%
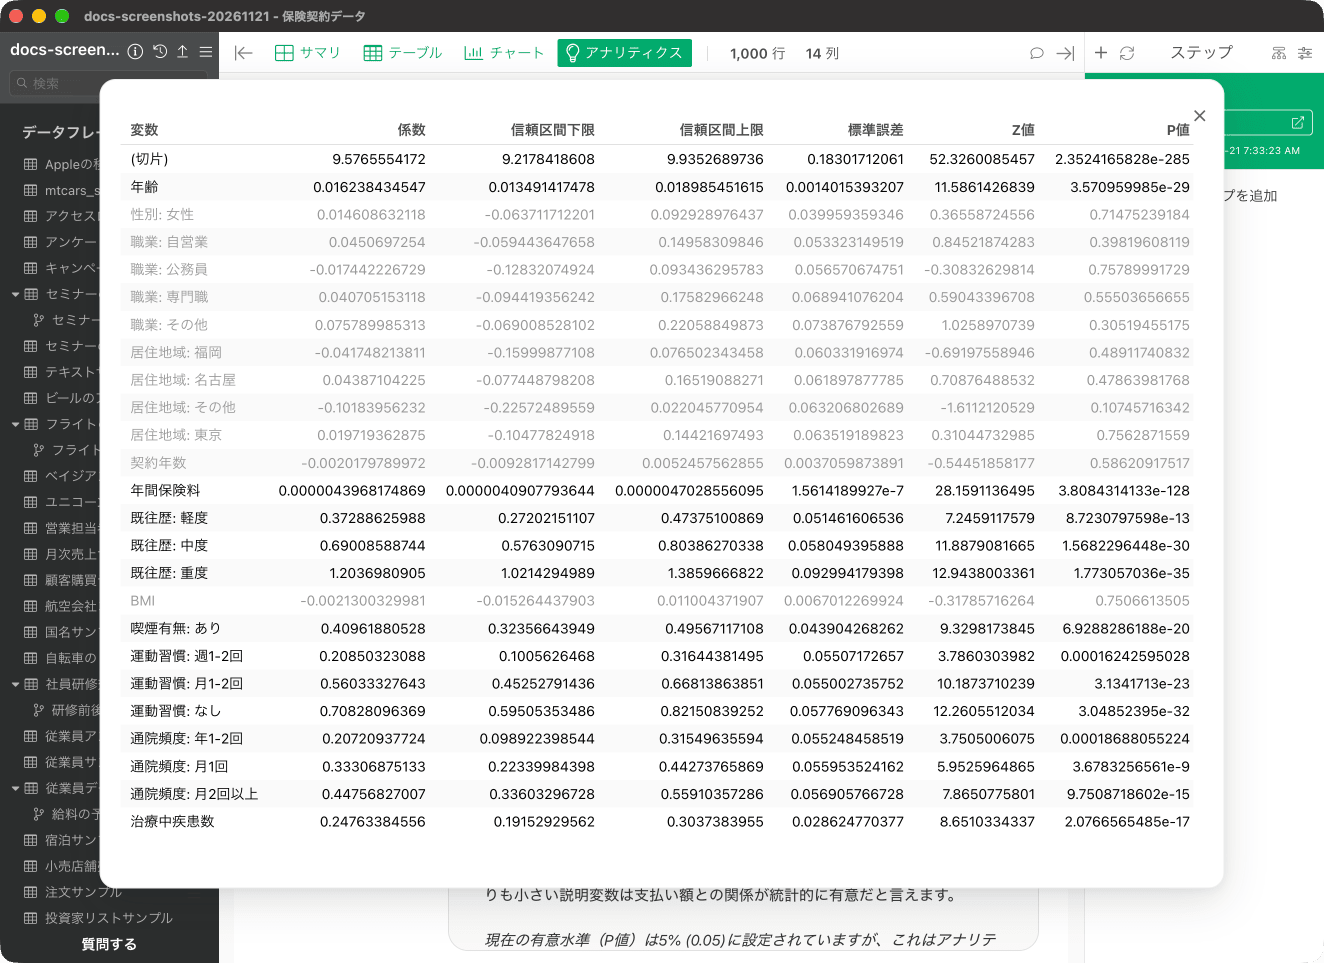
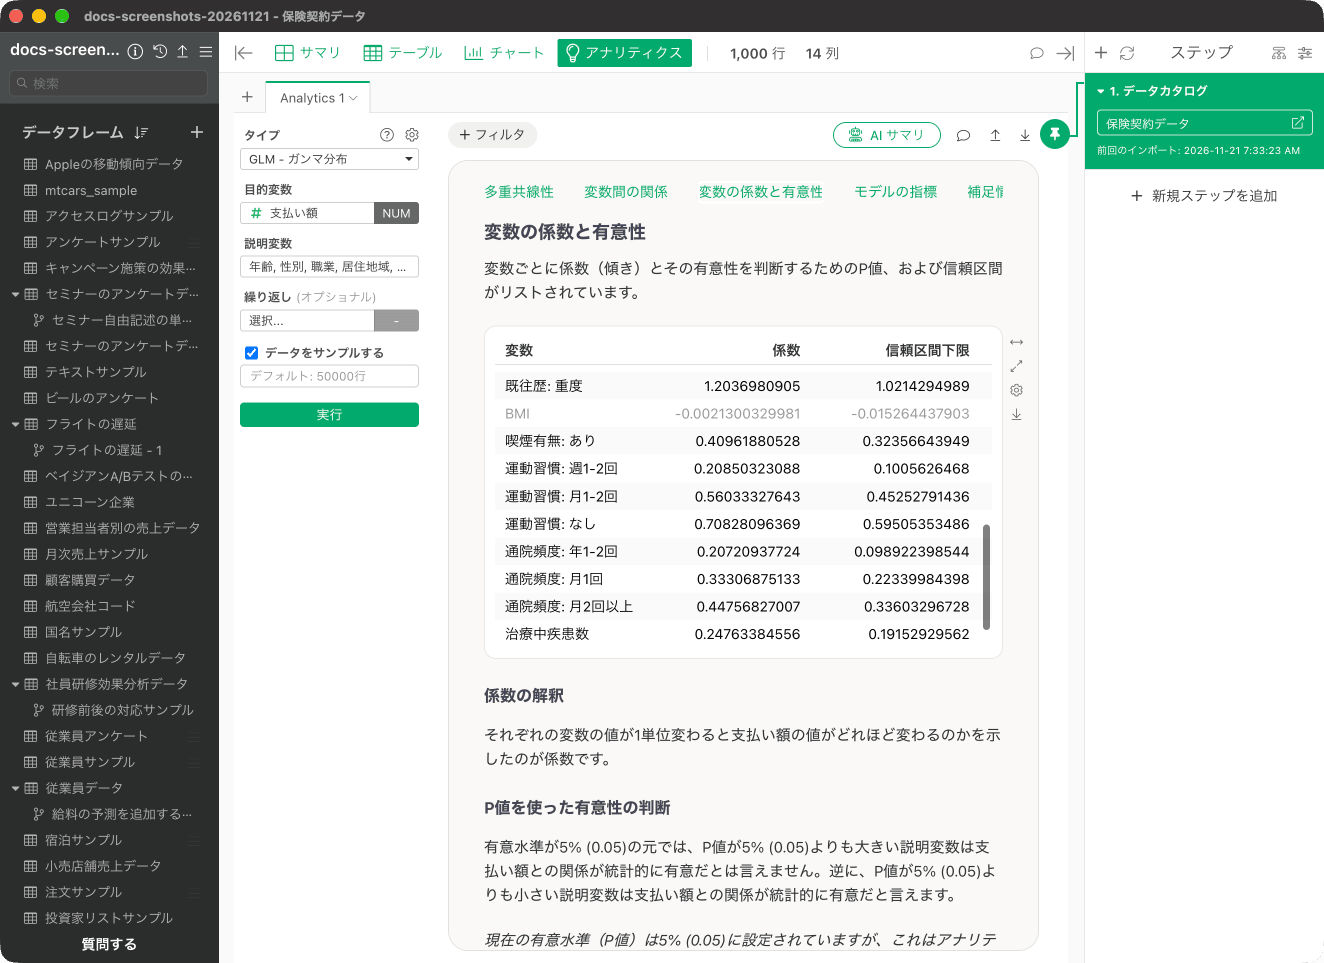
- 係数の指数を取る: exp(1.2037) = 3.33
- この値から1を引く: 3.33 - 1 = 2.33
- パーセンテージに変換: 2.33 × 100 = 233%
モデルの指標
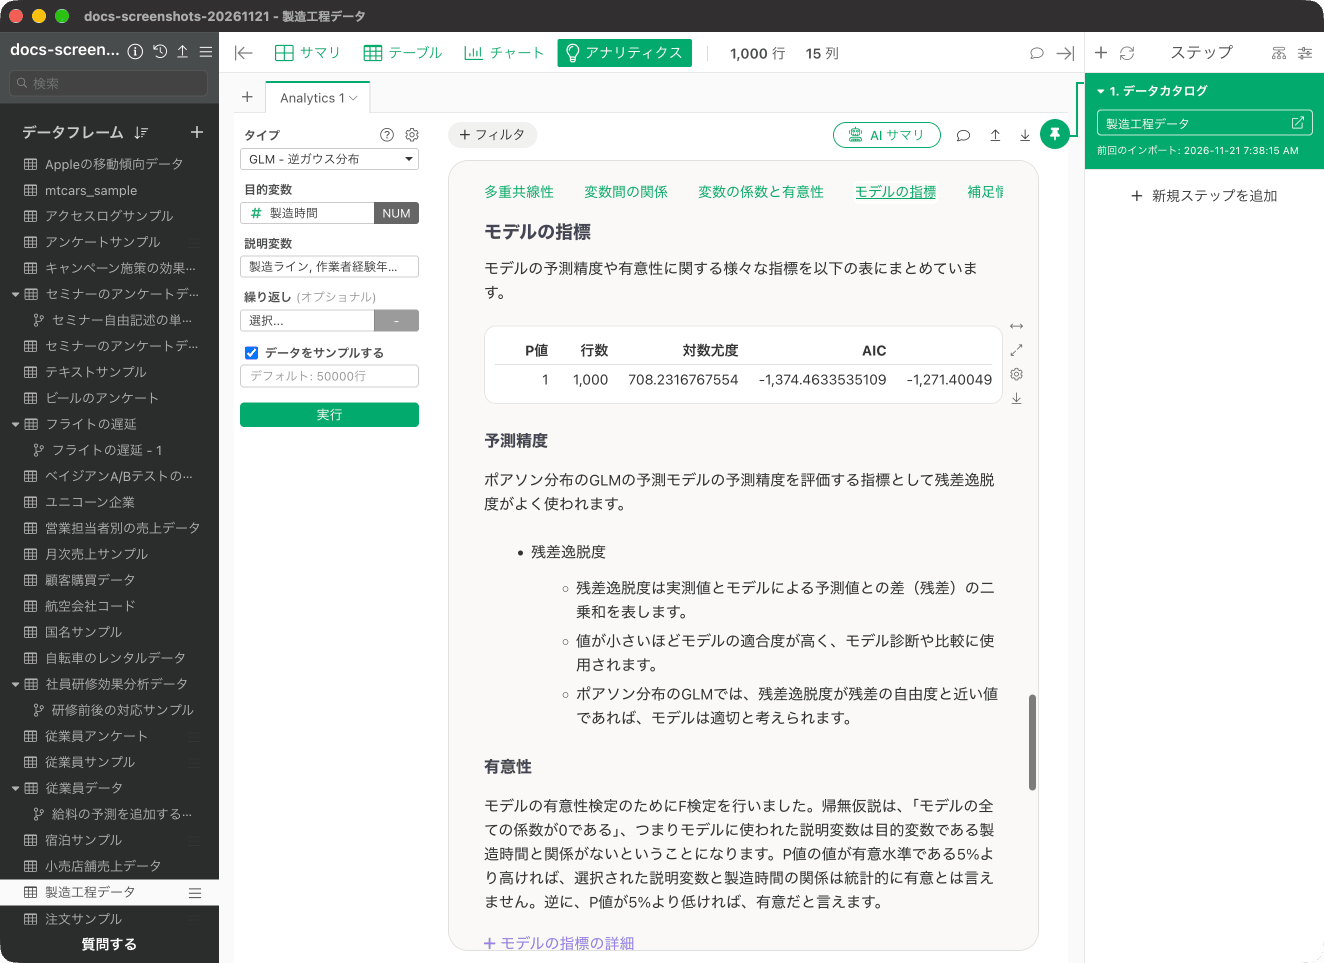
「モデルの指標」の節では、モデルの予測精度や有意性に関する指標が表にまとめられています。今回の例では、P値は 1.388e-125、行数は 1,000、対数尤度は -13,300.18、AIC は 26,652.36 です。この節には、有意性の確認(F検定)の説明もあります。 なお、この節の下にある予測精度の解説には、左のパネルで選んだ「GLM - ガンマ分布」ではなく「ポアソン分布のGLM」と表示されます。この表示は画面の選択とは異なります。数値は、分析結果の表(モデルの指標)を読んでください。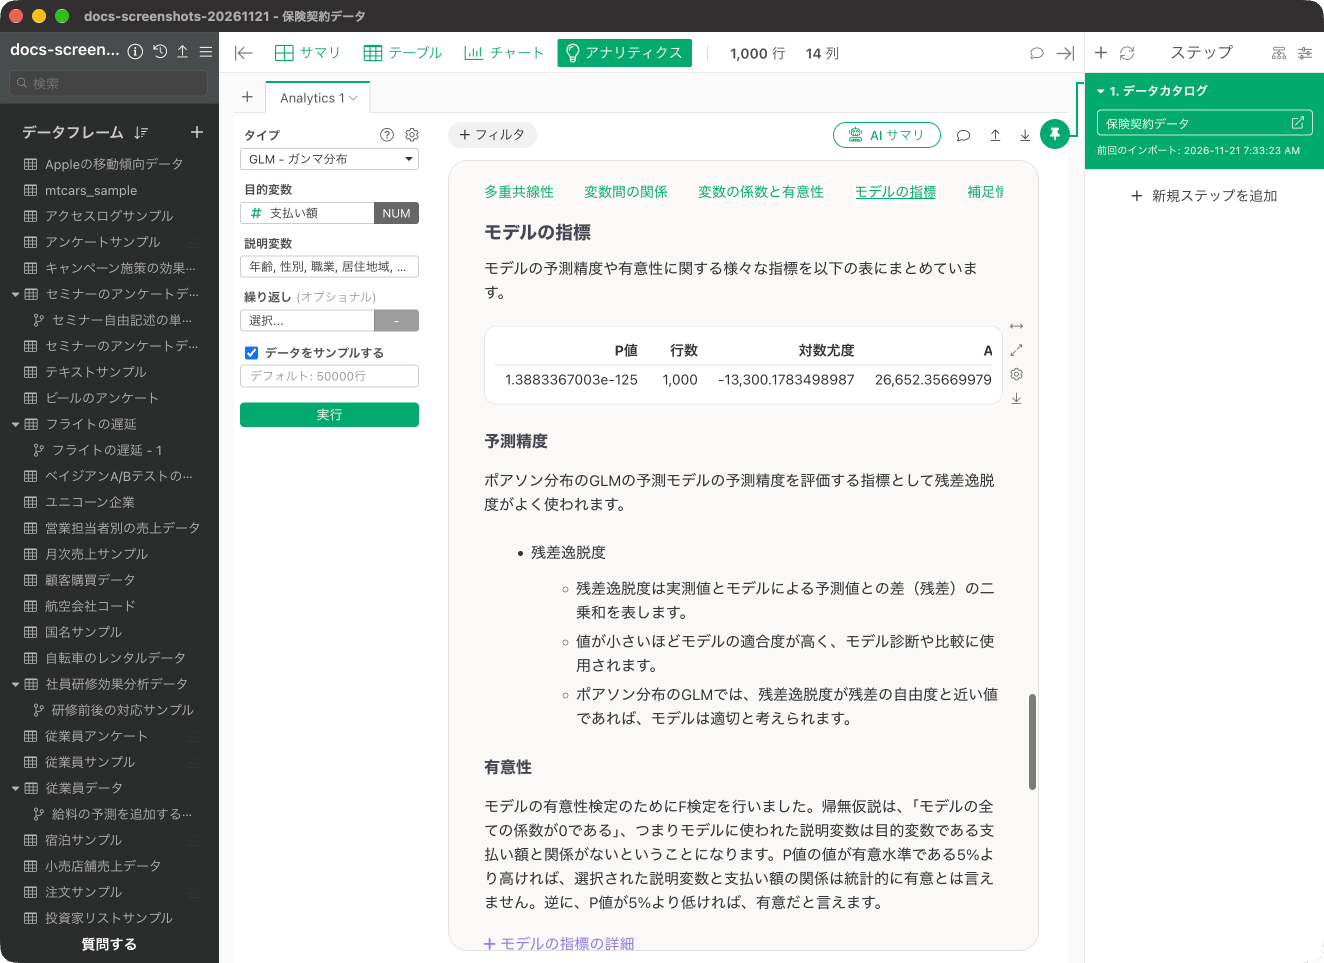
逆ガウス分布
一般化線形モデル(GLM)の逆ガウス分布は、正の値を持ち、右に裾が長い分布を示すデータの分析に特に適した手法です。特に、時間や距離、金額など、0より大きい値を取り、少数の大きな値が存在するような現象のモデリングに効果的です。通常の線形回帰モデルでは適切に扱えない非対称な分布を持つデータに対して、より精度の高い予測と解釈を可能にします。 この手法の特徴的な点は、データの分散が平均の3乗に比例するという性質を持つことです。これは製造プロセスの所要時間、機器の故障までの時間など、値が大きくなるほどばらつきも大きくなる傾向がある現象をモデル化する際に特に有用です。従来の正規分布を仮定した分析では、このような特性を持つデータの分析は困難でしたが、逆ガウス分布を用いることで、より現実に即した分析が可能になります。 逆ガウス分布の活用により、極端な値の影響を適切に考慮しながら、変数間の関係性を正確にモデル化できます。例えば、製造プロセスにおける加工時間の予測や、保険金支払額の予測モデルの構築など、実務的な場面で広く活用されています。また、モデルの解釈が比較的容易であり、各要因が目的変数に与える影響を具体的に評価できることも、この手法の大きな利点となっています。どういった時に使えるのか
逆ガウス分布GLMは、正の値のみを取り、分布が右に裾を引く特徴を持つデータの分析に特に適しています。例えば、製造業での製品加工時間の分析では、標準的な処理時間から大きく外れる長時間の加工ケースが存在する場合があります。このような場合、通常の線形回帰では適切にモデル化できませんが、逆ガウス分布GLMを使用することで、より正確な予測と要因分析が可能になります。 また、保険業界での保険金支払額の分析においても、多くの請求が比較的小額である一方で、少数の高額請求が存在するケースがあります。このような非対称な分布を持つデータに対して、逆ガウス分布GLMは効果的な分析手法となります。さらに、機械の故障時間分析や、サービス業での顧客対応時間の分析など、時間に関連する変数で右に裾の長い分布を示すデータの分析にも適しています。 代表的なデータ例としては以下のようなものが挙げられます:- 製造工程における製品の加工時間データ(基本情報、作業条件、品質情報など)
- 保険金支払いに関するデータ(請求額、契約者属性、事故状況など)
- 機械設備の故障までの稼働時間データ(運転条件、メンテナンス履歴など)
- カスタマーサービスの対応時間データ(問い合わせ内容、顧客属性、対応履歴など)
ユースケース
-
製造業での使い方
- 製造業では、製品の加工時間の変動要因を分析する際に使えます。
- 具体的には、作業者の経験年数、機械の稼働時間、環境条件などが製造時間にどのように影響するかを分析する時に逆ガウス分布GLMを使うことで、各要因の影響度を正確に把握できるようになります。
- これにより、製造時間の短縮に向けた重点改善項目の特定や、新規製造ラインの設計時の参考指標として活用できます。
-
保険業での使い方
- 保険業では、保険金支払額の予測モデルの構築時に使えます。
- 具体的には、契約者の属性、事故の種類、過去の請求履歴などから支払額を予測する時に逆ガウス分布GLMを使うことで、高額請求のリスク要因を特定できるようになります。
- これにより、リスク評価の精度向上や、保険料率の適正化といった施策を実施する際の根拠として活用できます。
-
オペレーション管理者での使い方
- オペレーション管理者は、物流倉庫での商品ピッキング時間の分析時に使えます。
- 具体的には、商品のピッキングにかかる時間を目的変数として、商品の保管場所、注文数、作業者の経験、時間帯などの要因が与える影響を分析する際に逆ガウス分布GLMを使うことで、作業時間の変動要因を特定できるようになります。
- これにより、商品の最適な保管レイアウトの設計や、作業者の適切な配置、繁忙期の人員配置計画といった施策立案に活用できます。
-
品質管理担当者での使い方
- 品質管理担当者は、製品の検査時間や不具合発生までの時間分析に使えます。
- 具体的には、品質検査にかかる時間と各種条件の関係を分析する時に逆ガウス分布GLMを使うことで、検査時間の変動要因を特定できるようになります。
- これにより、検査工程の効率化や、品質管理プロセスの改善施策の立案に活用できます。
Exploratoryで一般化線形モデル - GLM - 逆ガウス分布を実行する
使用するデータ
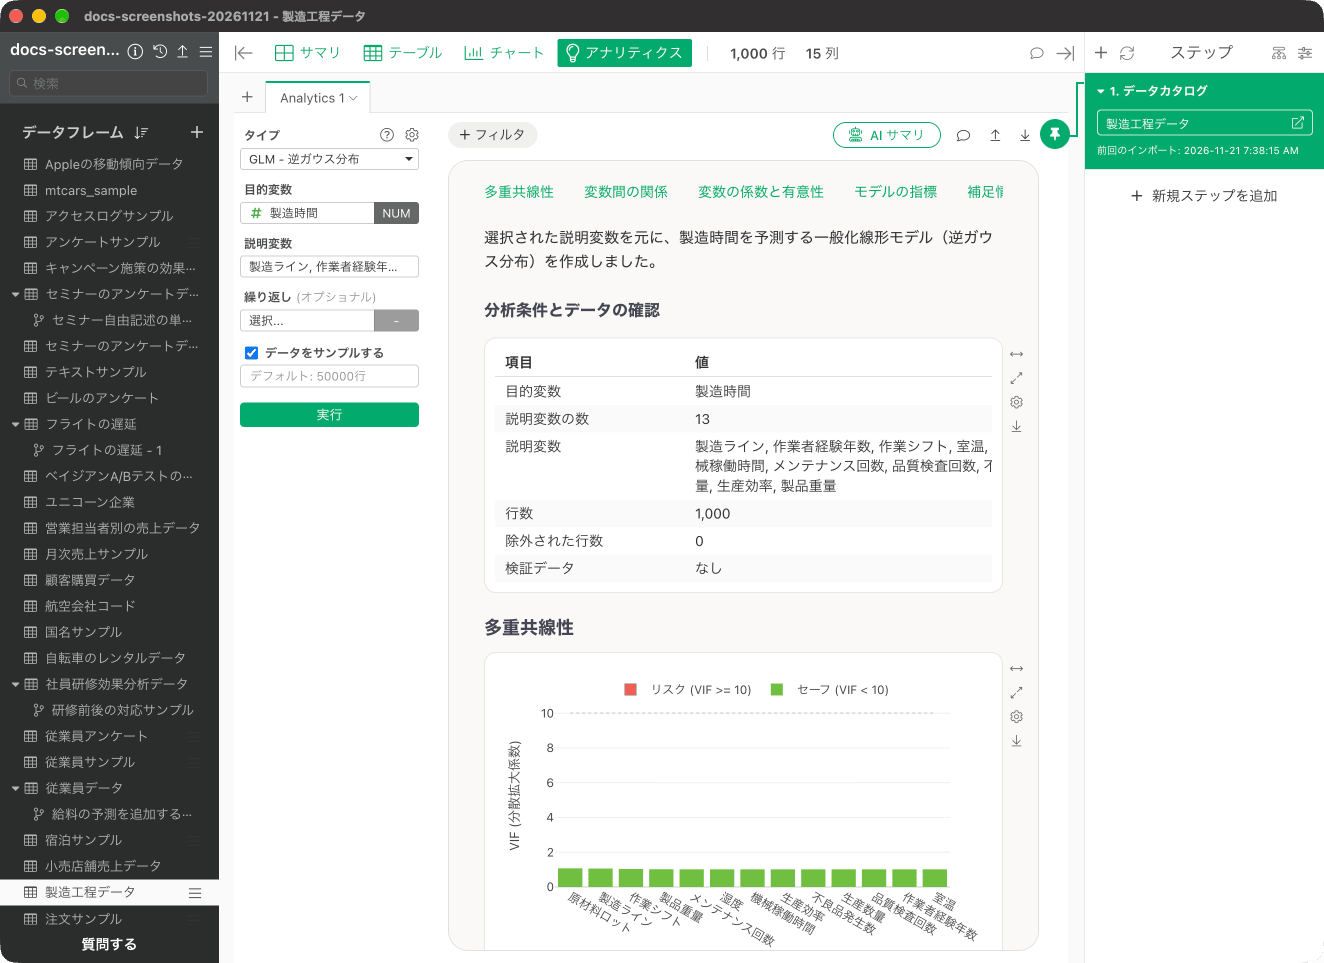
今回は「製造工程データ」(1,000行・15列)を使用します。データはこちらからダウンロードが可能となっています。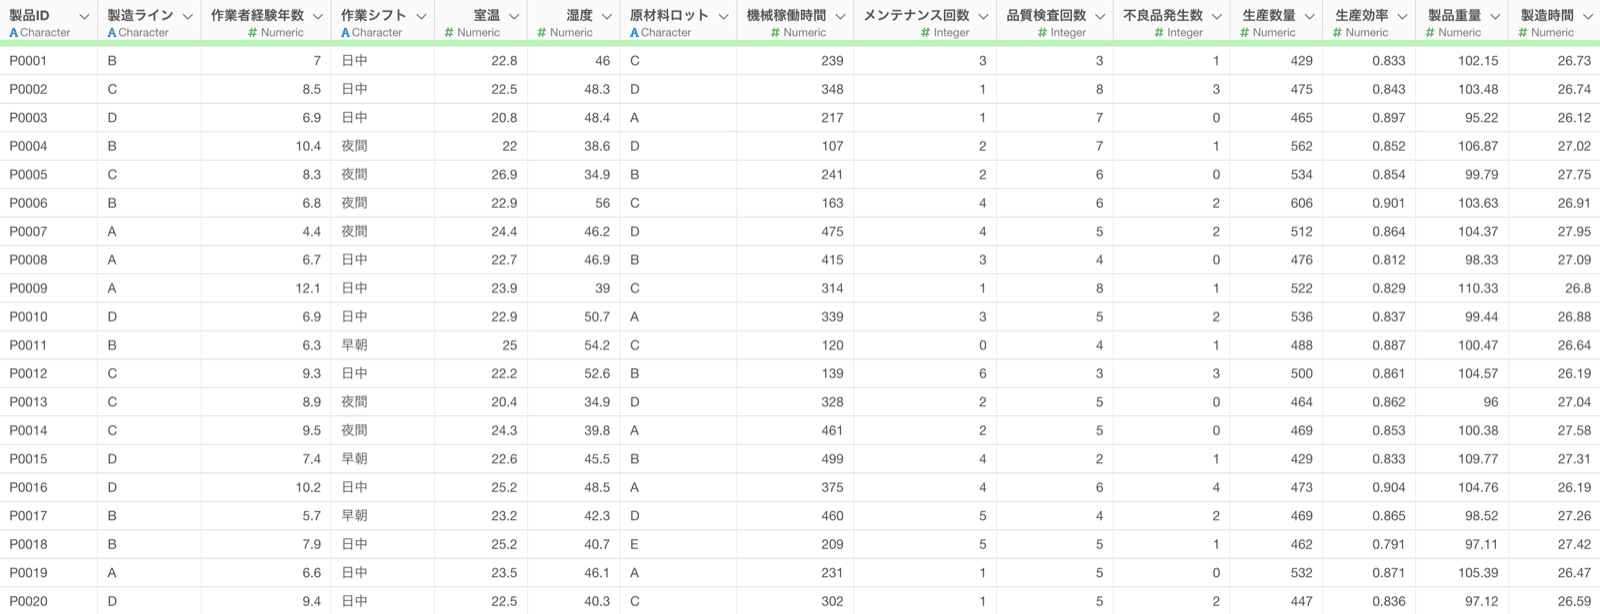
- 目的変数は正の連続値であること
- 目的変数の分布が右に裾が長い特徴を持つこと
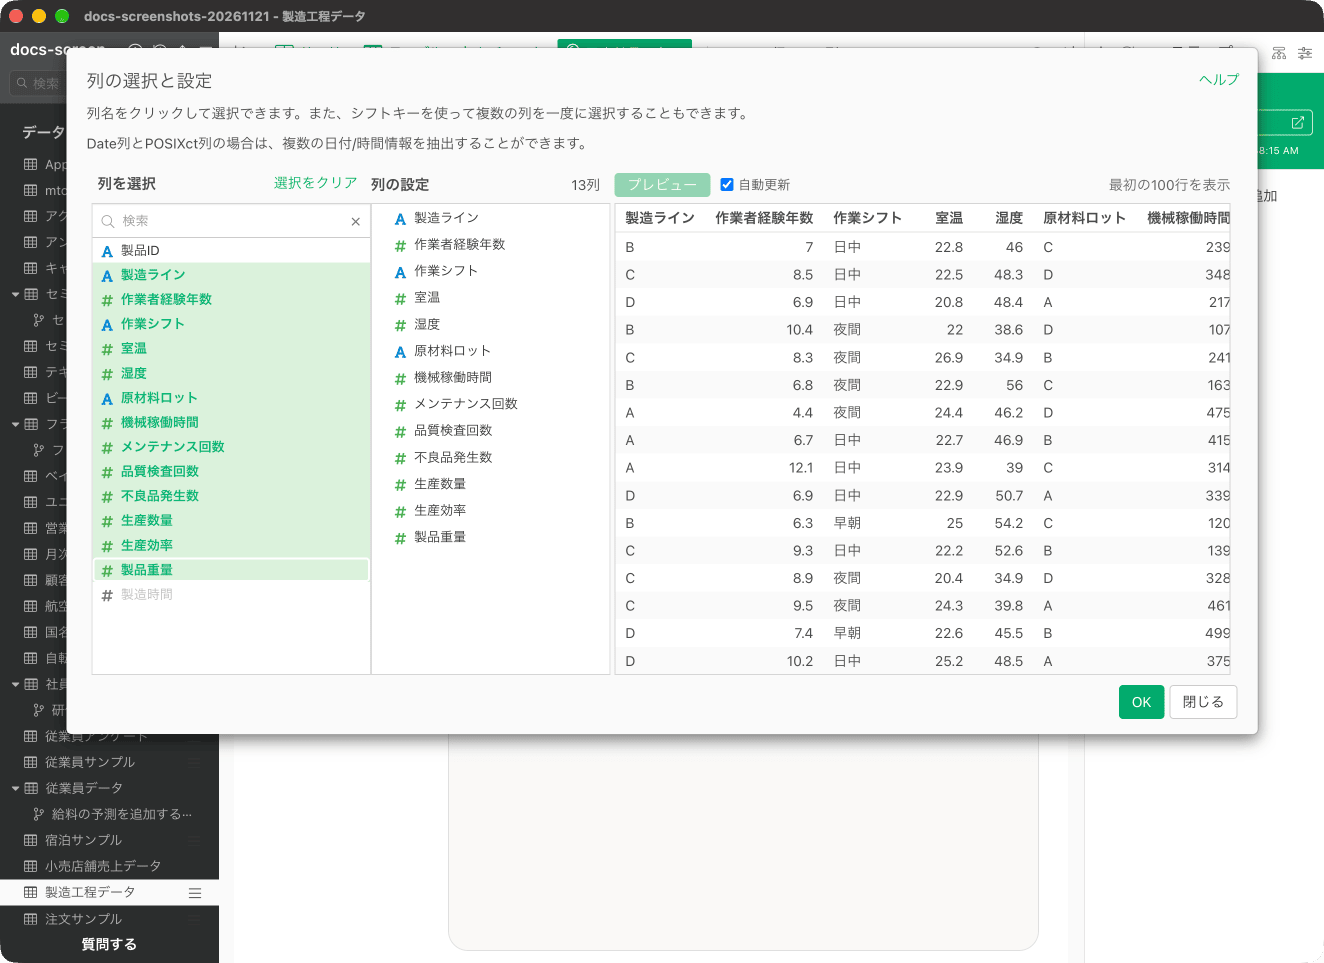
- 説明変数は数値型(例:経験年数、室温)やカテゴリ型(例: 作業シフト、製造ライン)などの変数を使用します
アナリティクスを作成する
製造工程データから「アナリティクス・ビュー」を開きます。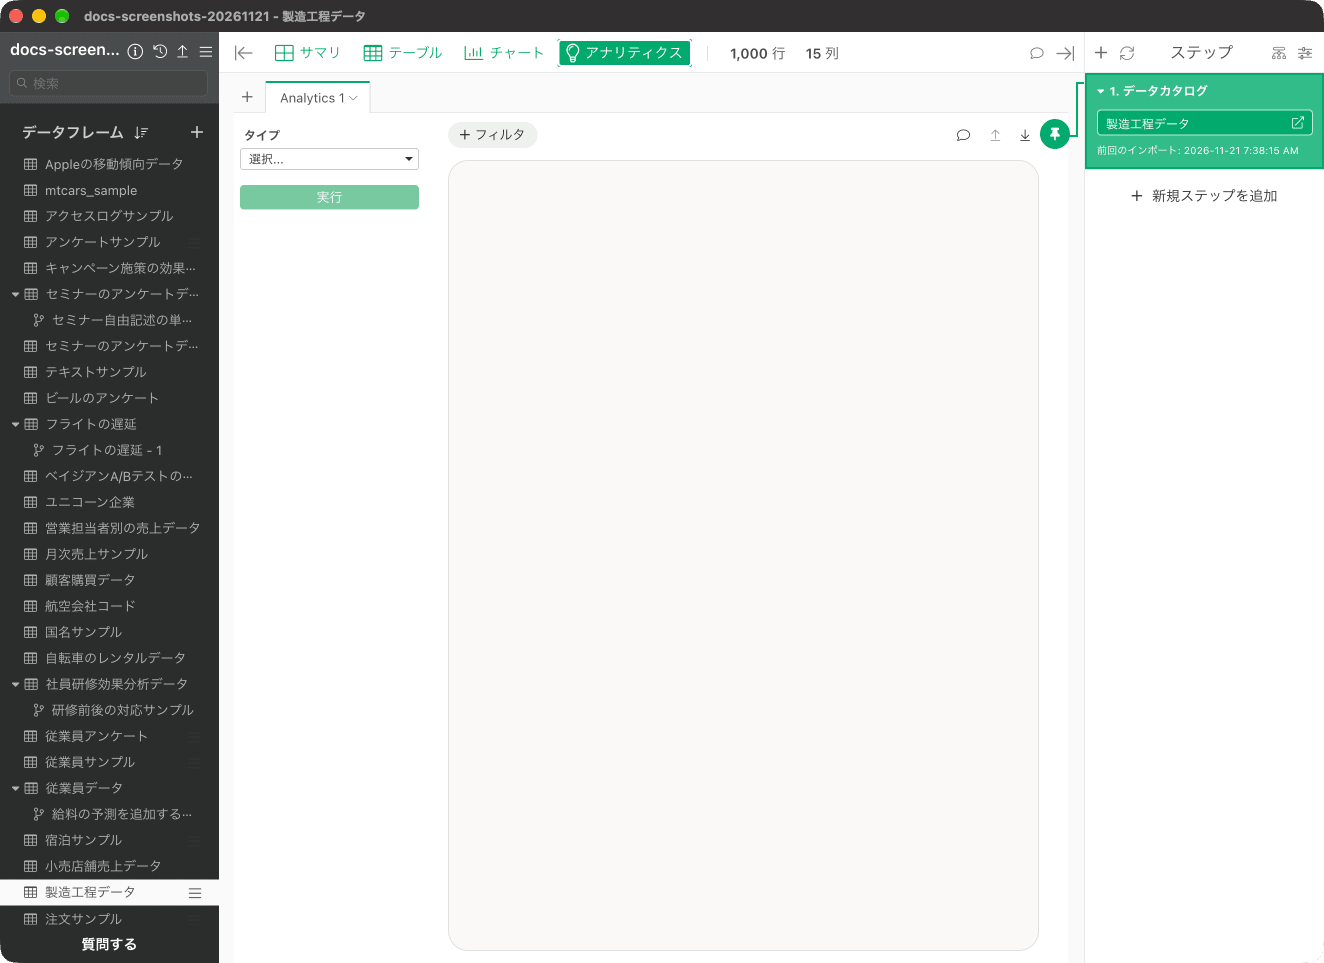
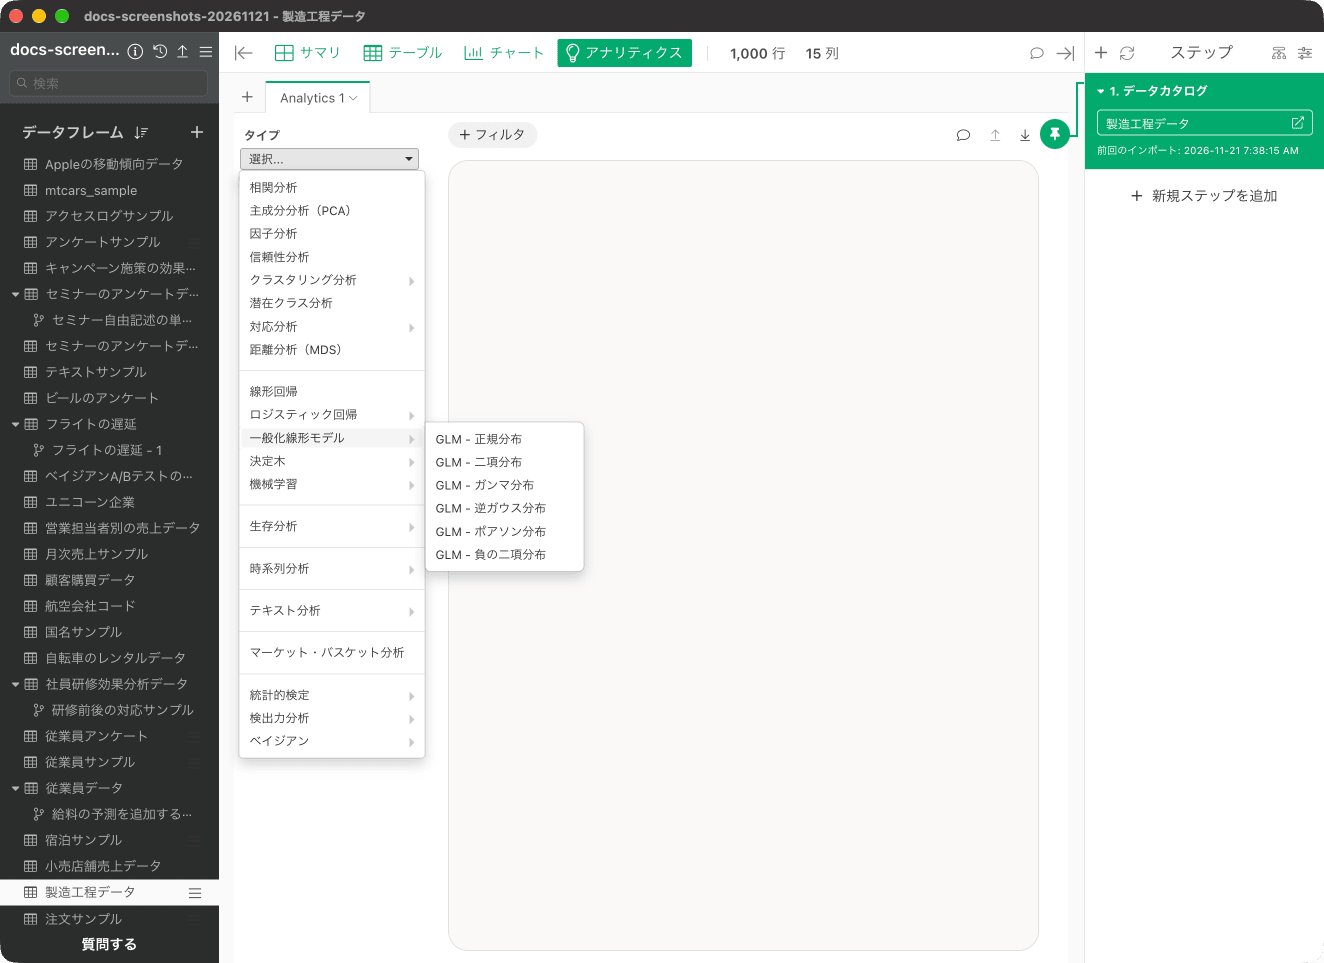
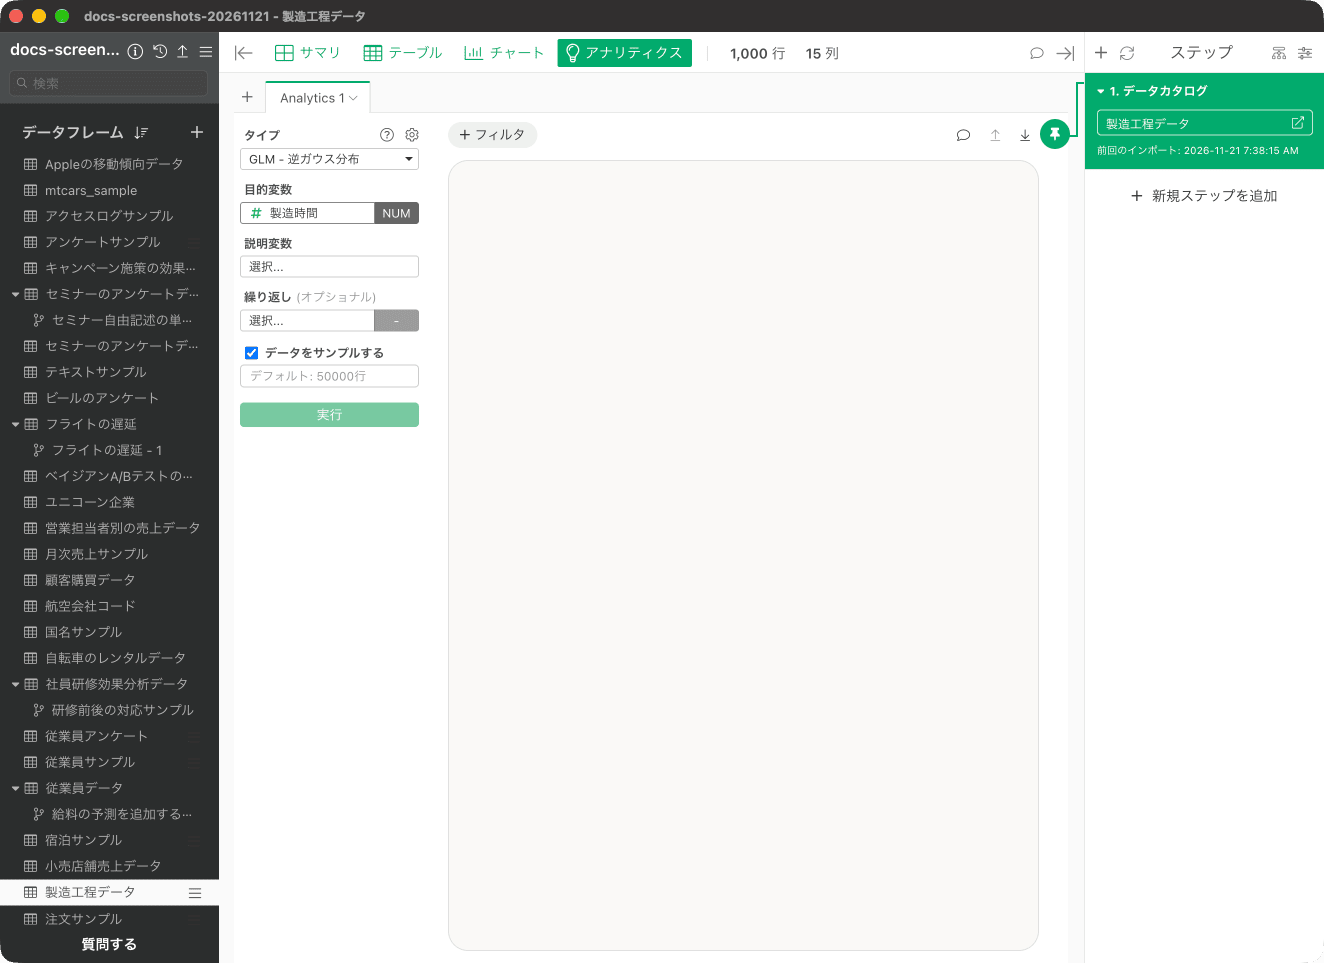
結果の解釈
一般化線形モデル - GLM - 逆ガウス分布では、製造時間に影響を与える要因を解析するために、以下の節が用意されています。多重共線性
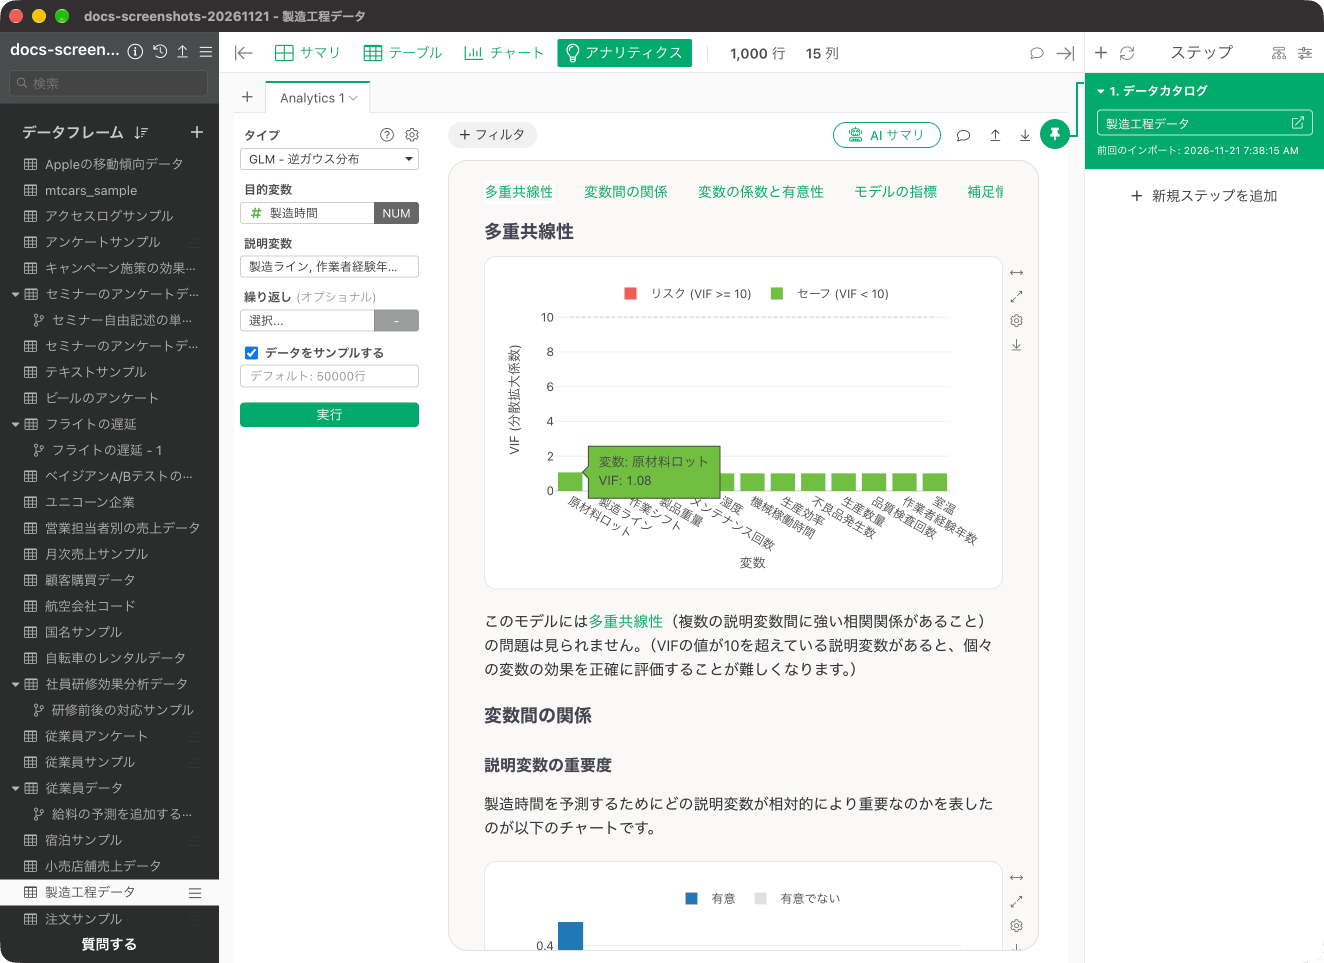
「多重共線性」の節では、説明変数間の相関が強すぎる(VIF 10以上)組み合わせがないかを確認できます。VIFが10以上の変数がある場合、説明変数間の相関が強く、傾きが不安定になる可能性があるため、変数の選択を見直す必要があります。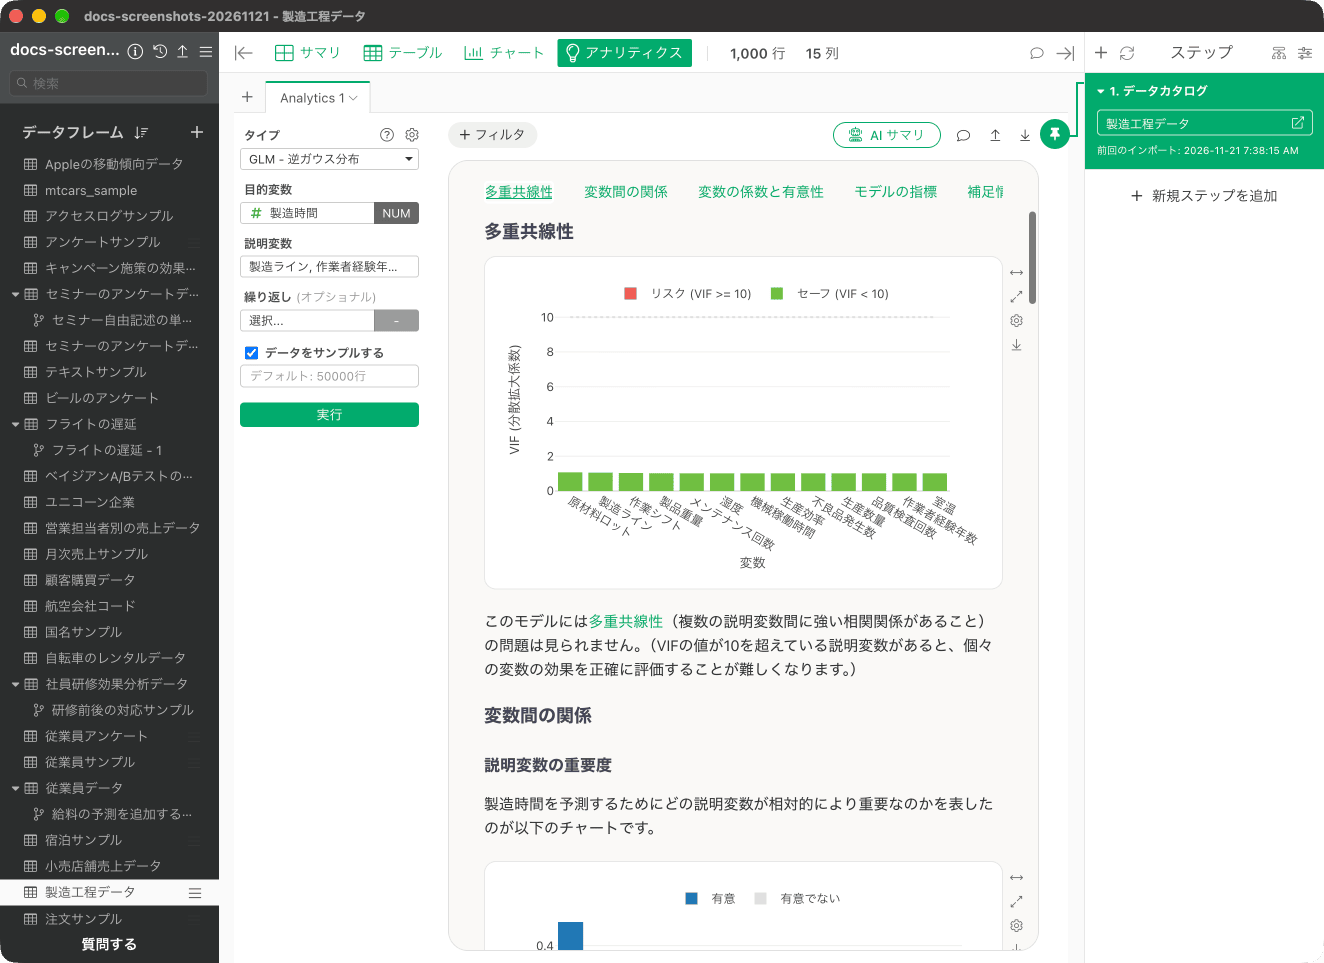
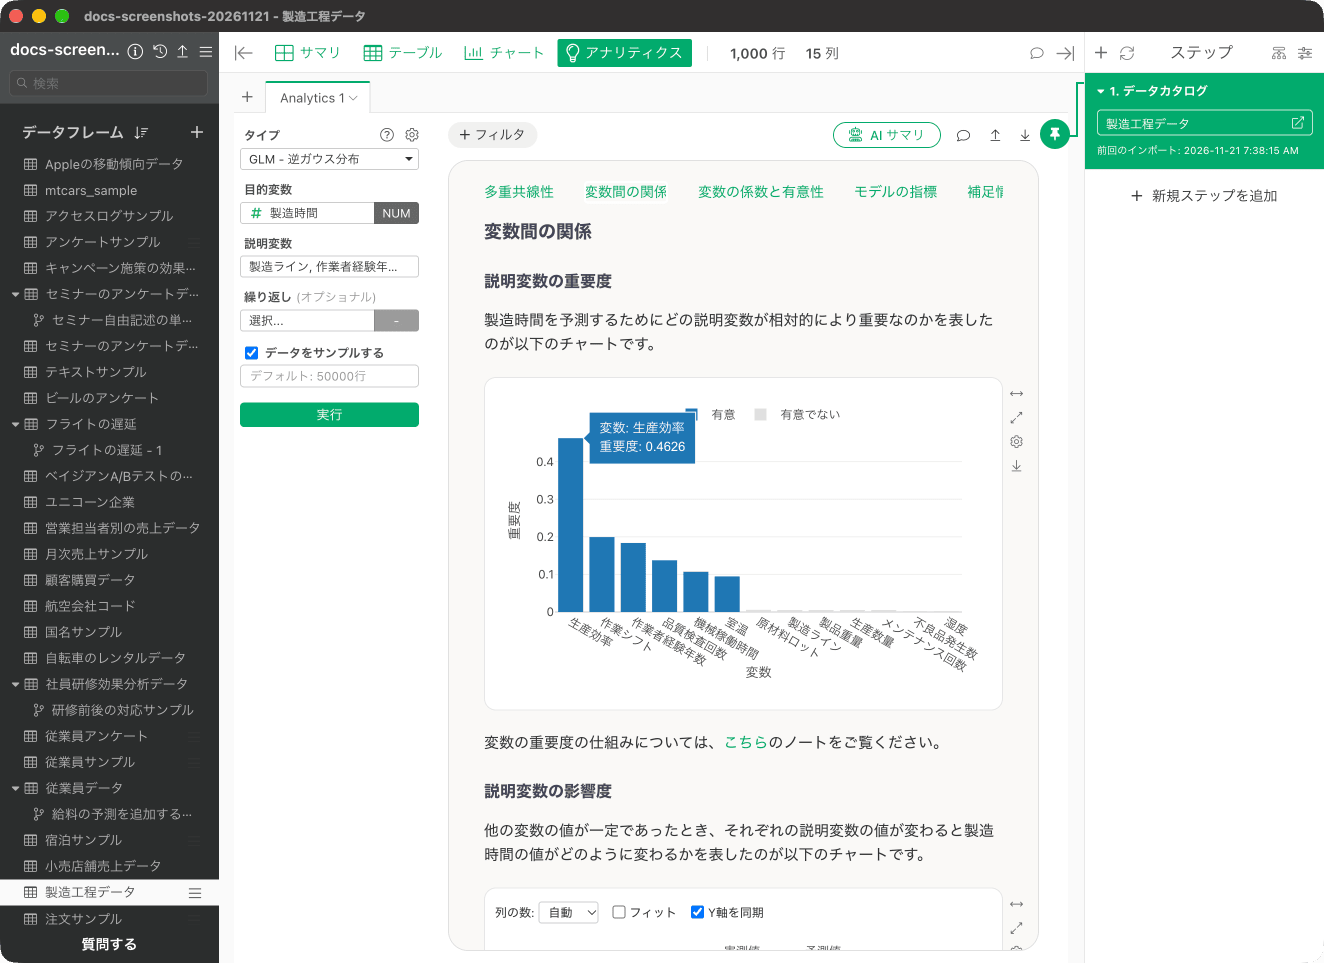
説明変数の重要度
「変数間の関係」の節にある「説明変数の重要度」では、目的変数を予測する上でどの変数が重要なのかを確認できます。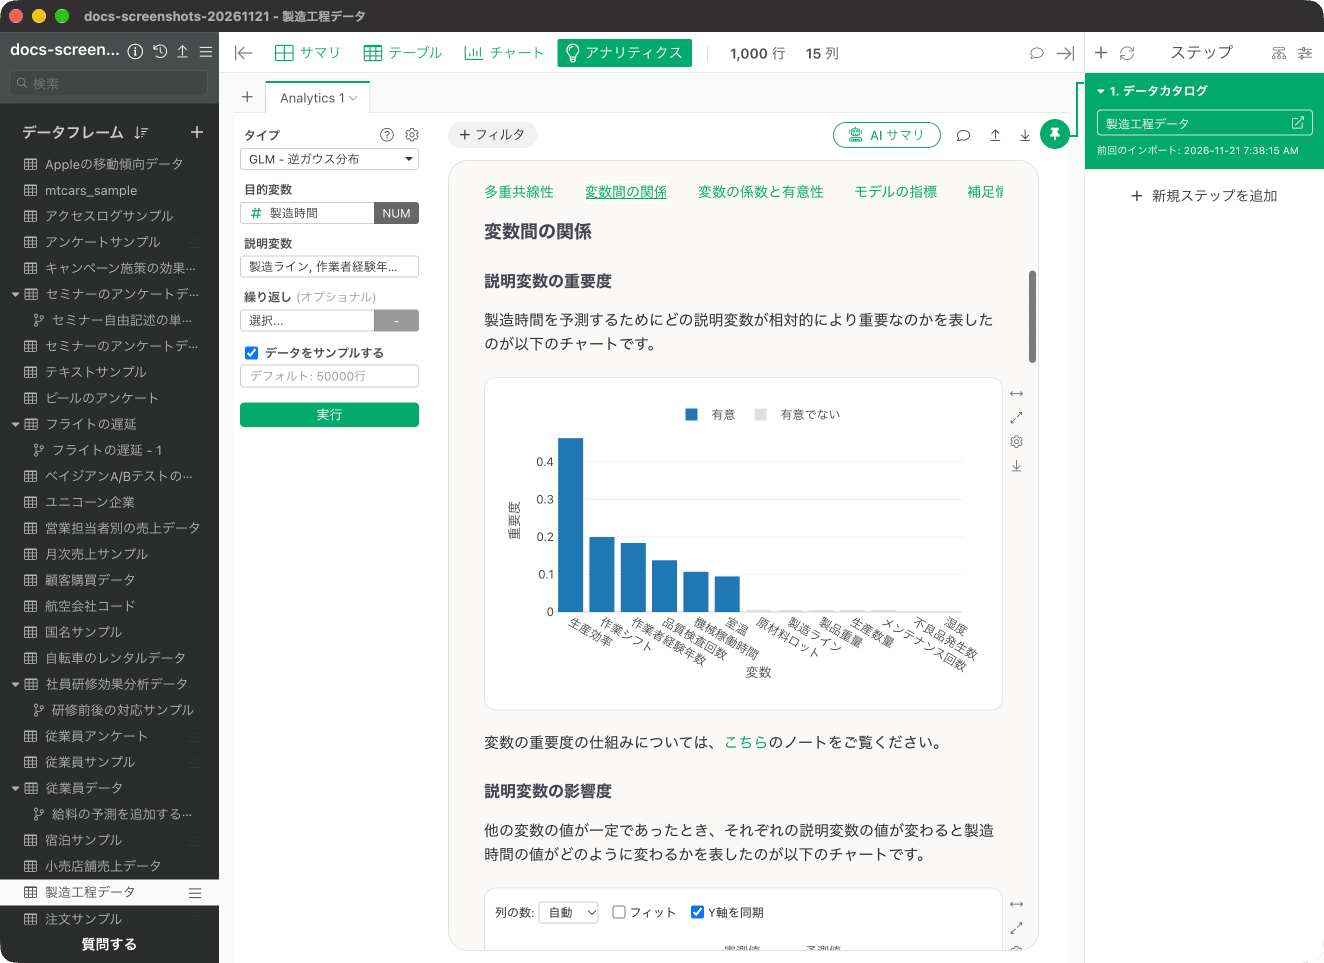
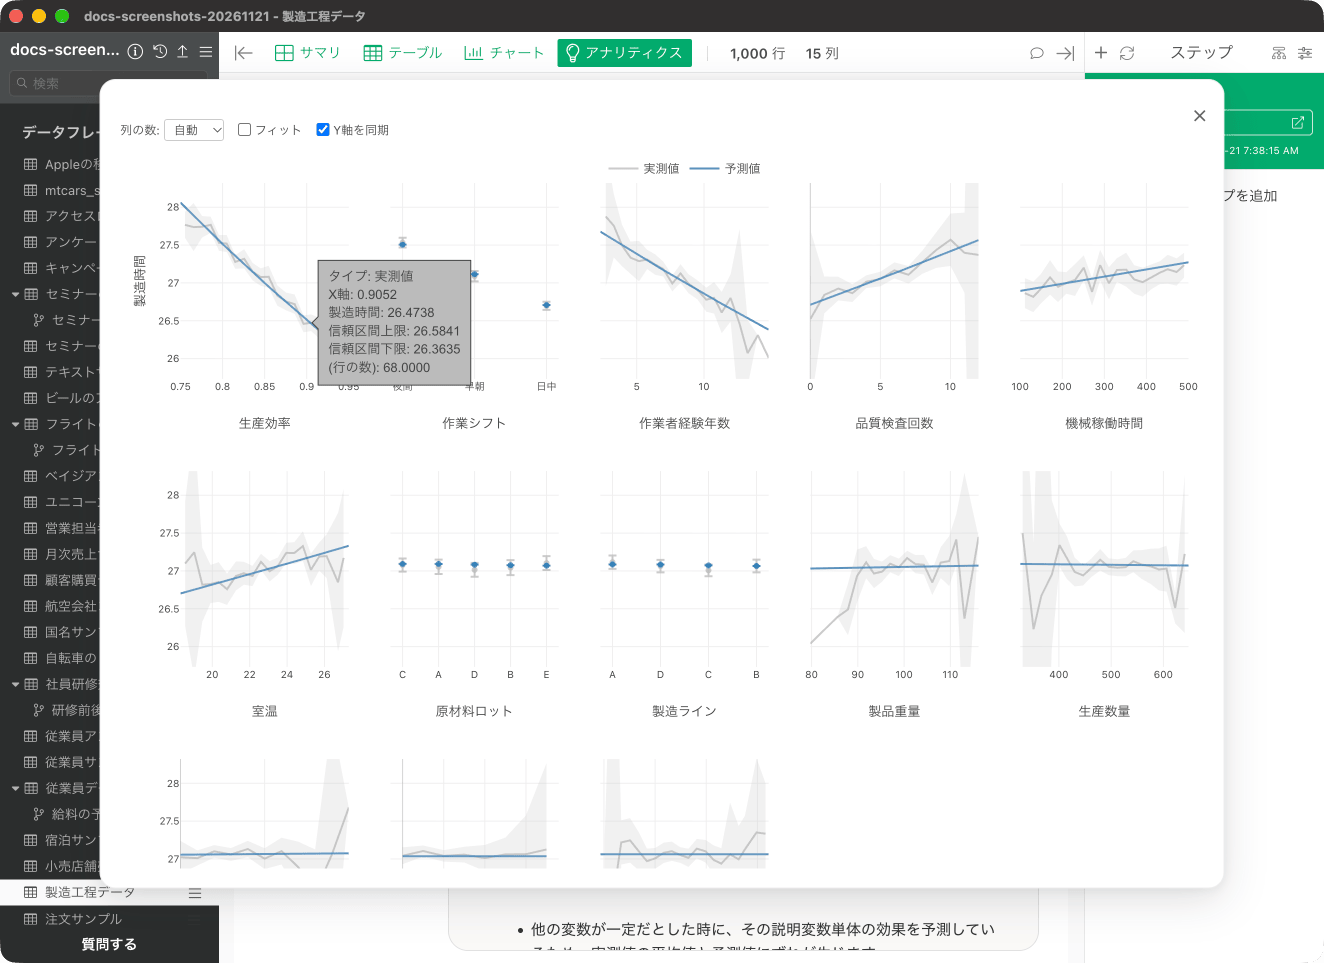
説明変数の影響度
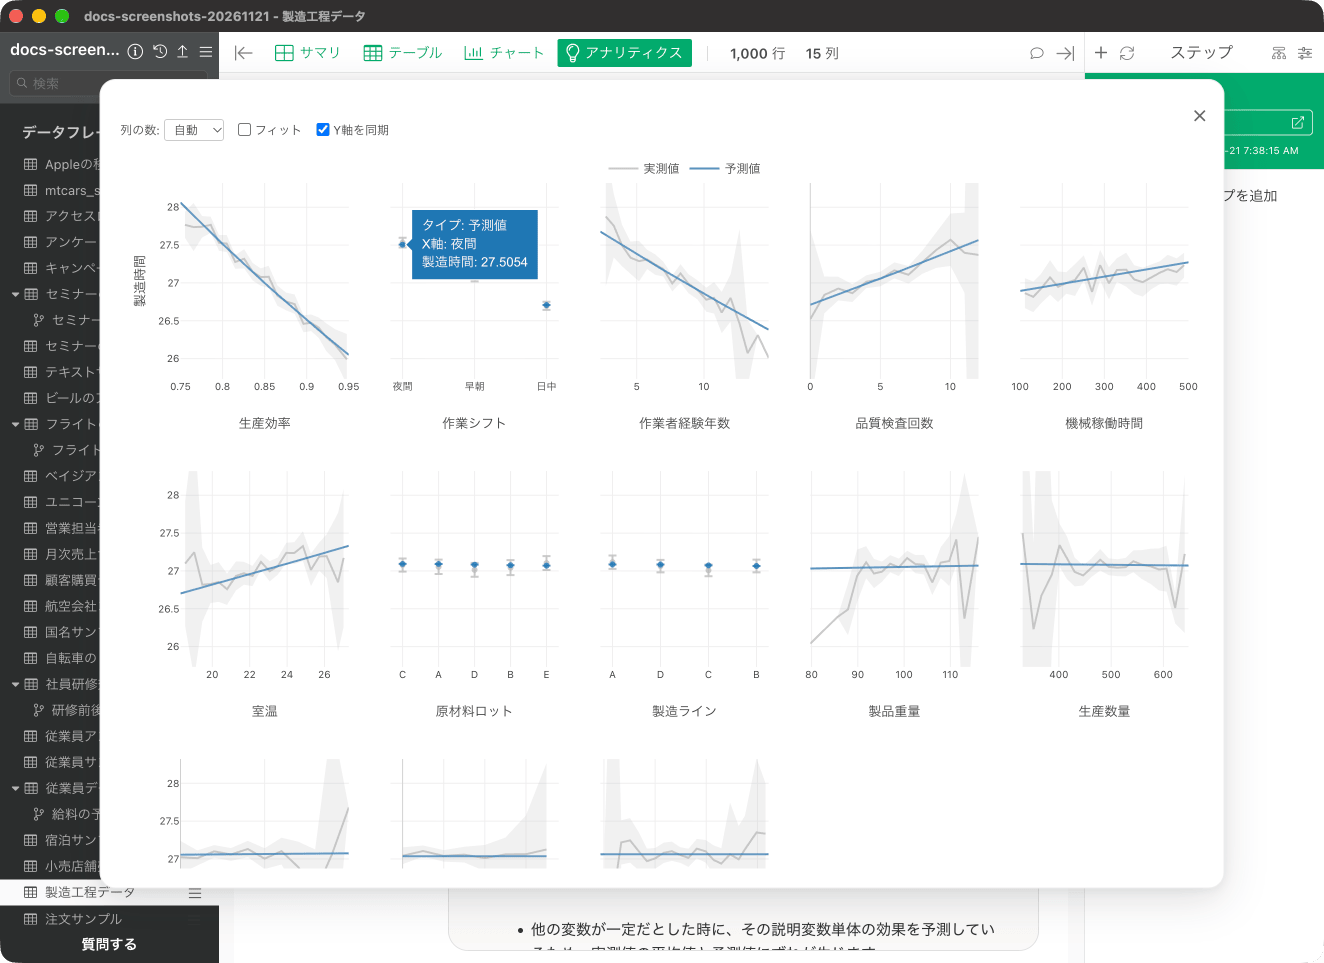
「変数間の関係」の節にある「説明変数の影響度」では、各説明変数が製造時間に与える影響の方向と強さを確認できます。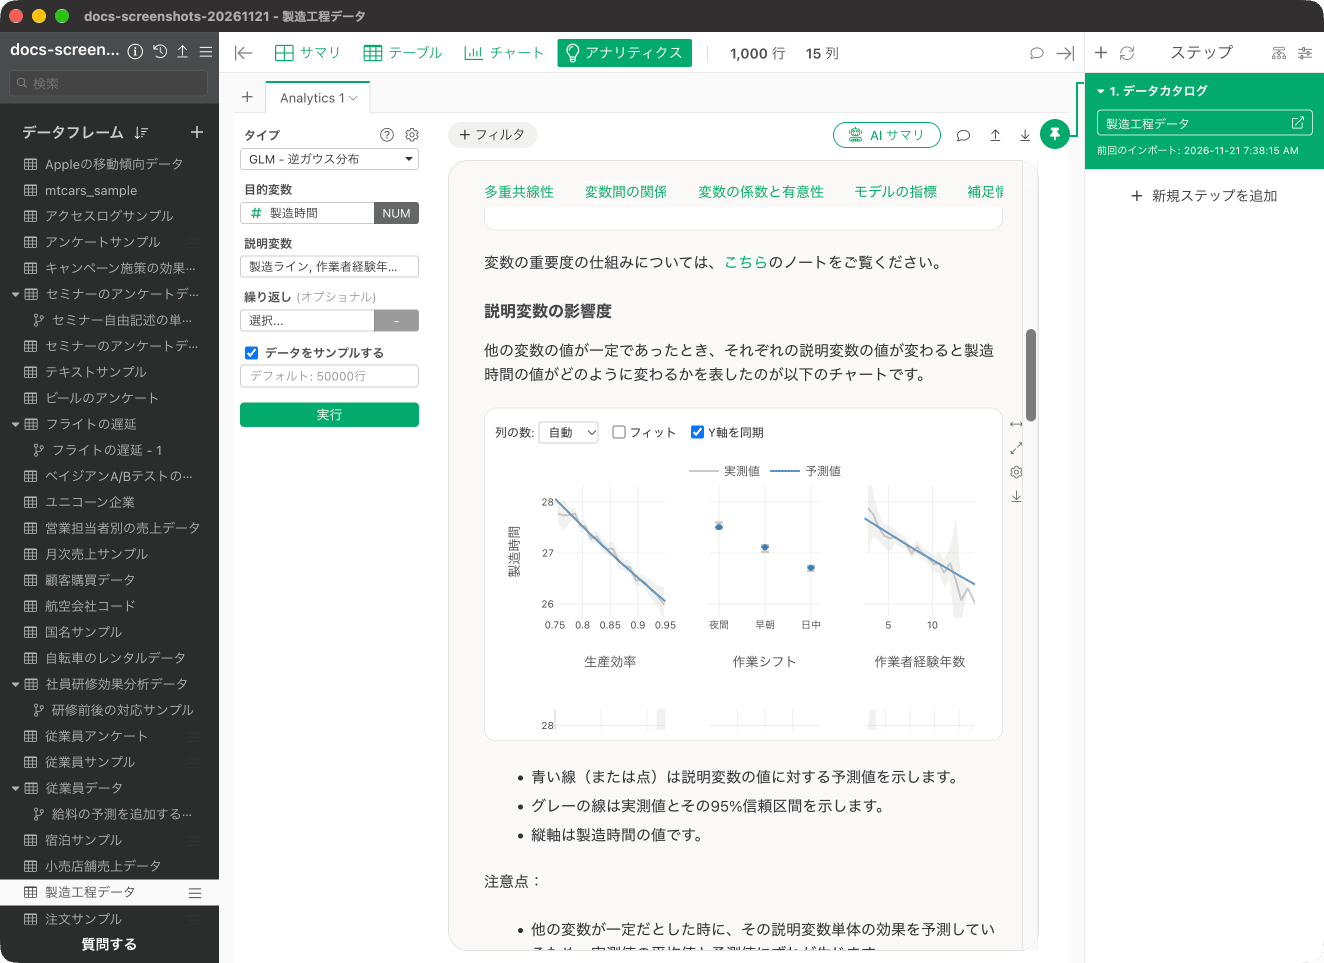
変数の係数と有意性
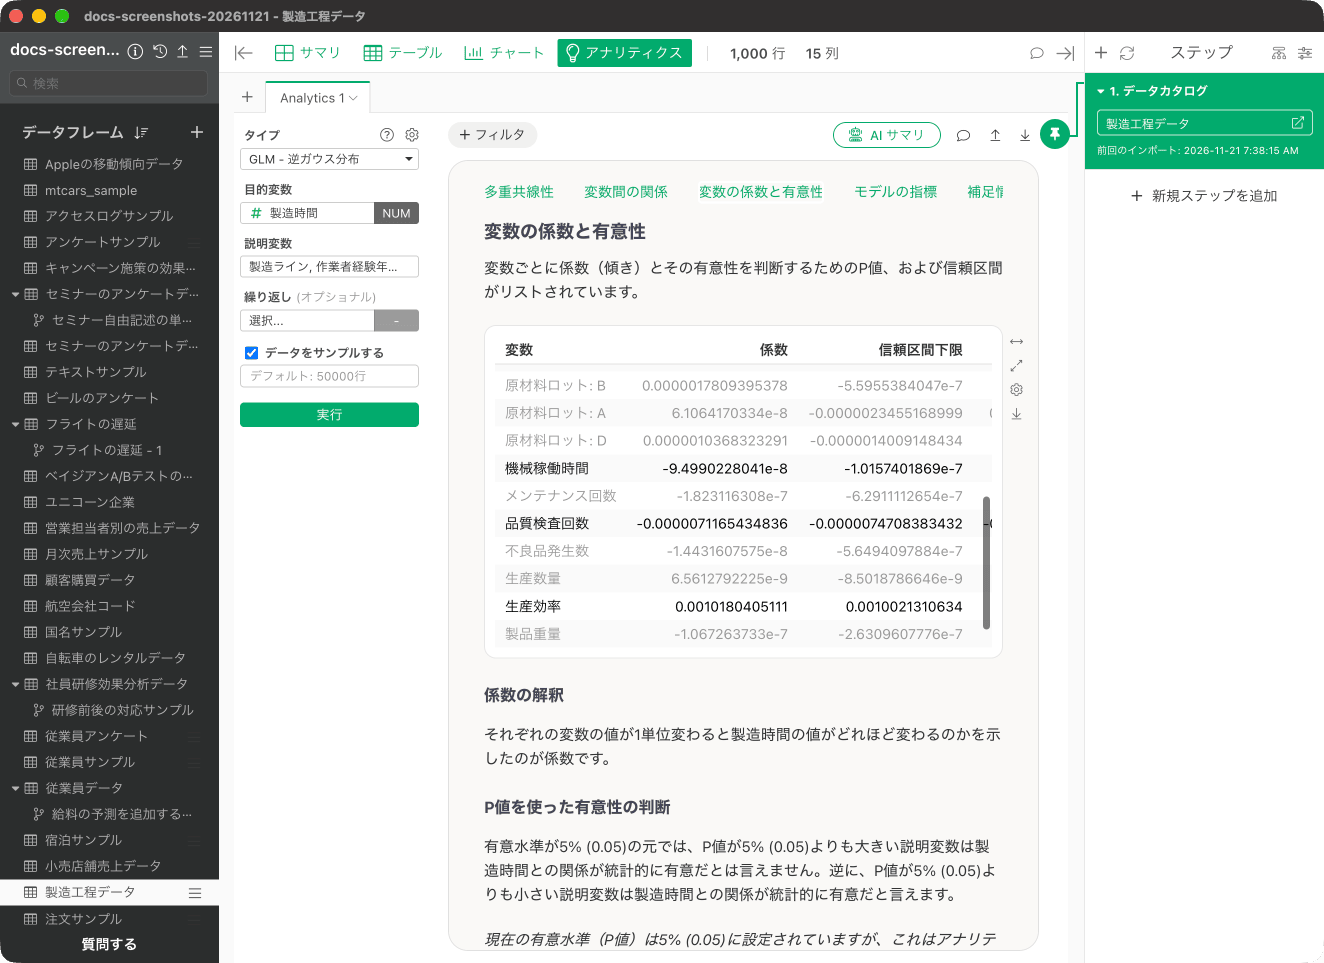
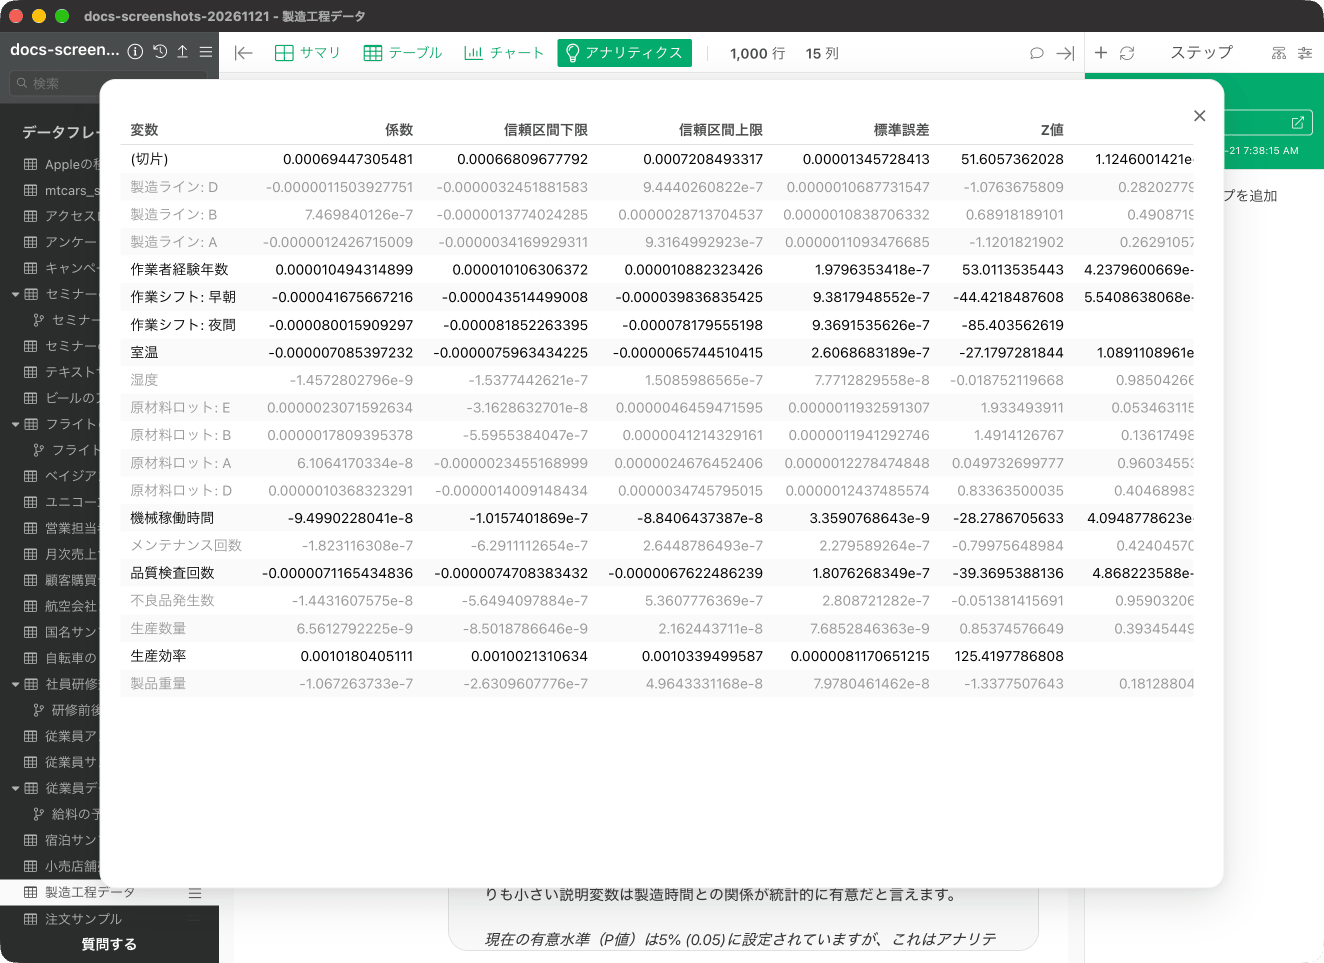
「変数の係数と有意性」の節では、各説明変数の係数とその統計的有意性を確認できます。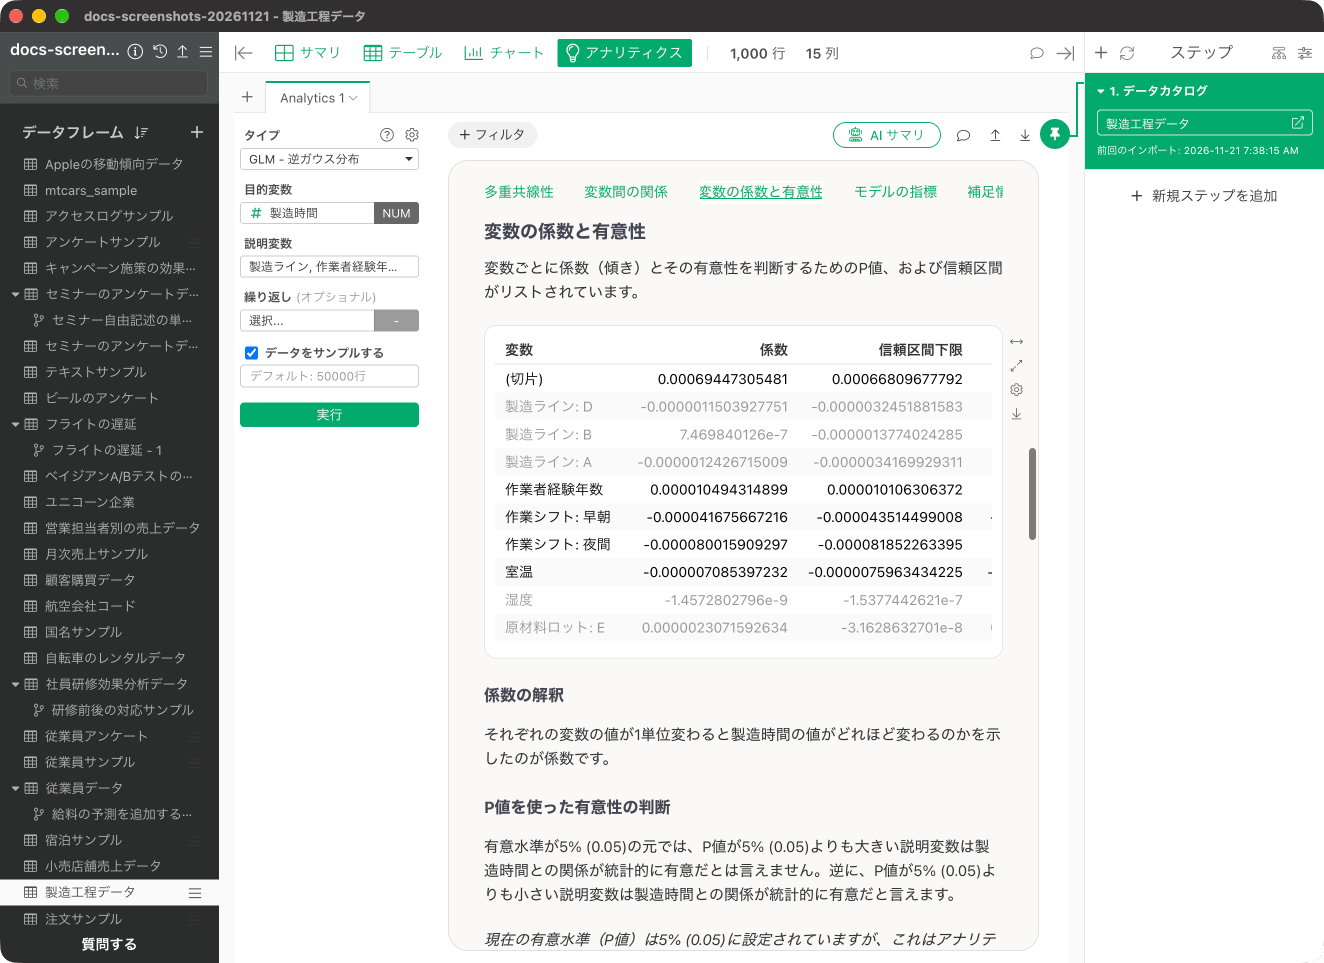
モデルの指標
「モデルの指標」の節では、モデルの予測精度や有意性に関する指標が表にまとめられています。今回の例では、P値は 1、行数は 1,000、対数尤度は 708.23、AIC は -1,374.46 です。 この節の下の予測精度の解説にも、左のパネルで選んだ「GLM - 逆ガウス分布」ではなく「ポアソン分布のGLM」と表示されます。表示は画面の選択とは異なりますので、数値は分析結果の表(モデルの指標)を読んでください。