何ができるか
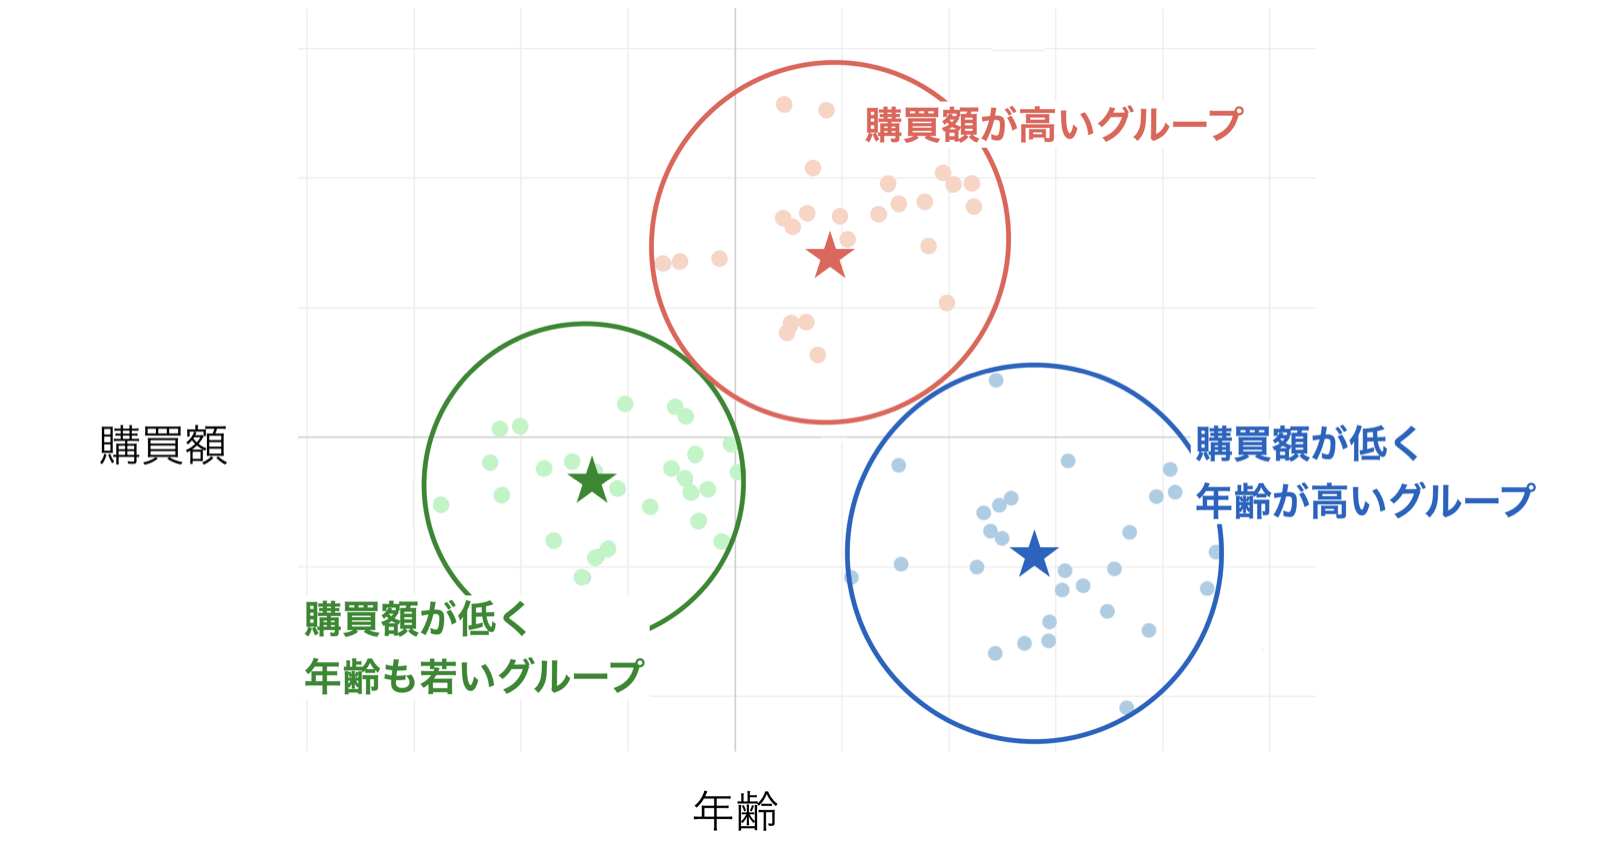
たとえば、顧客一人当たりの年齢と購買額の関係をプロットした散布図があったとします。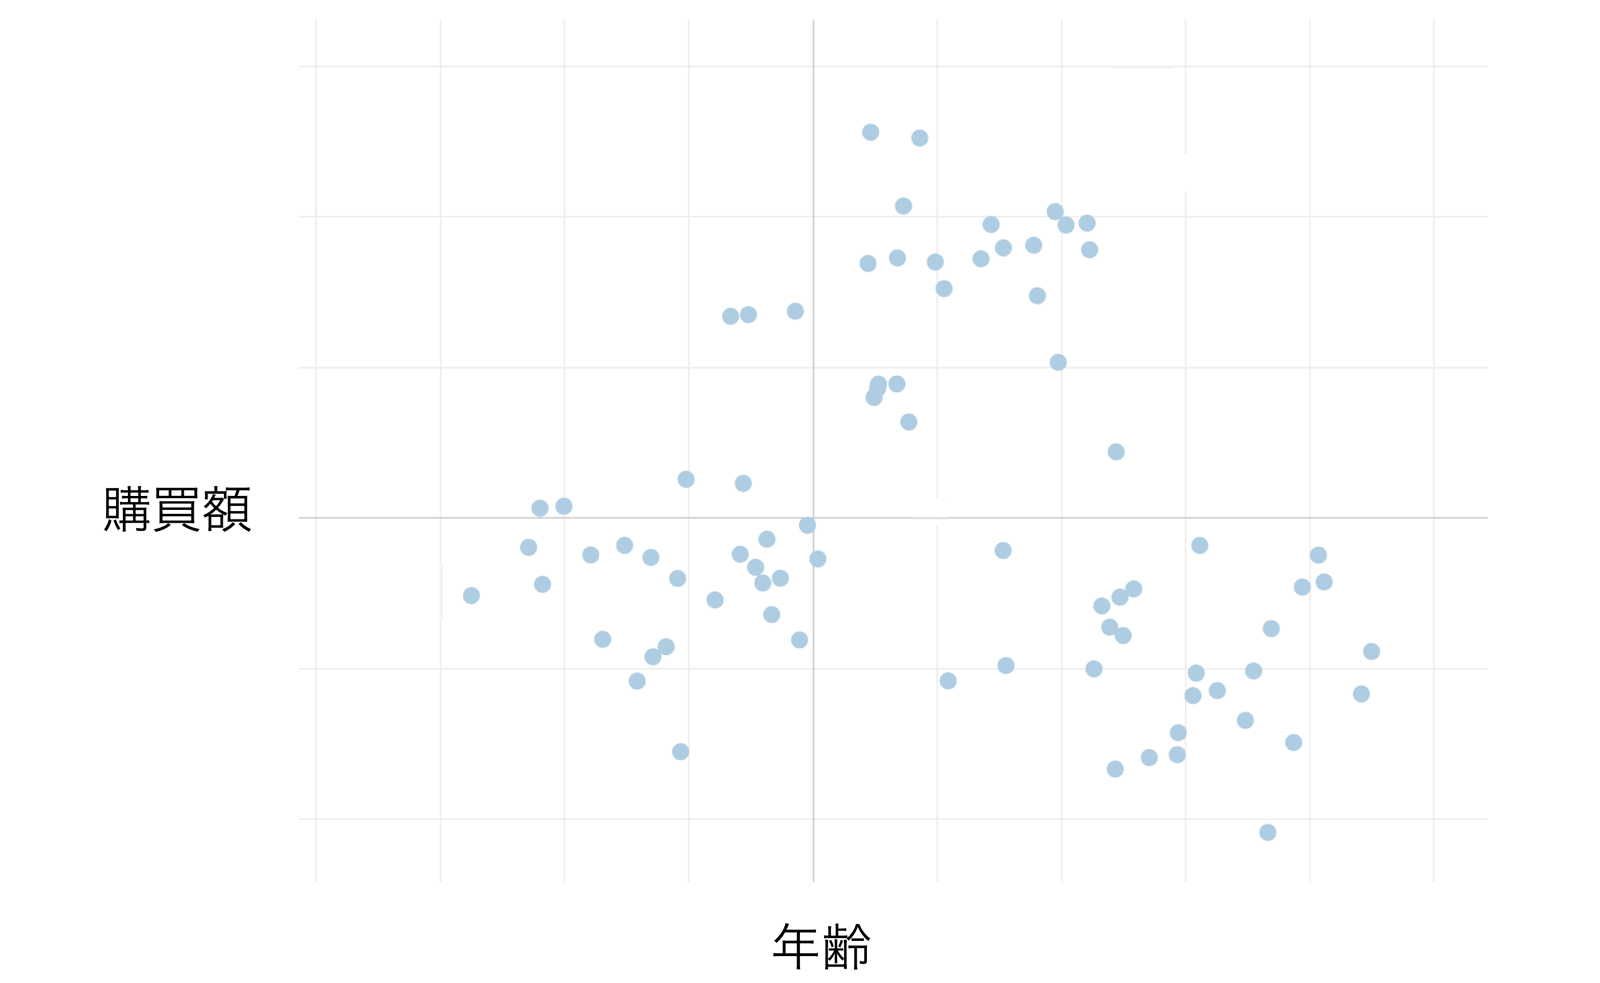
必要なデータの形式
K-Meansクラスタリングを実行する際には、1行が1観測対象となっているデータを使う必要があります。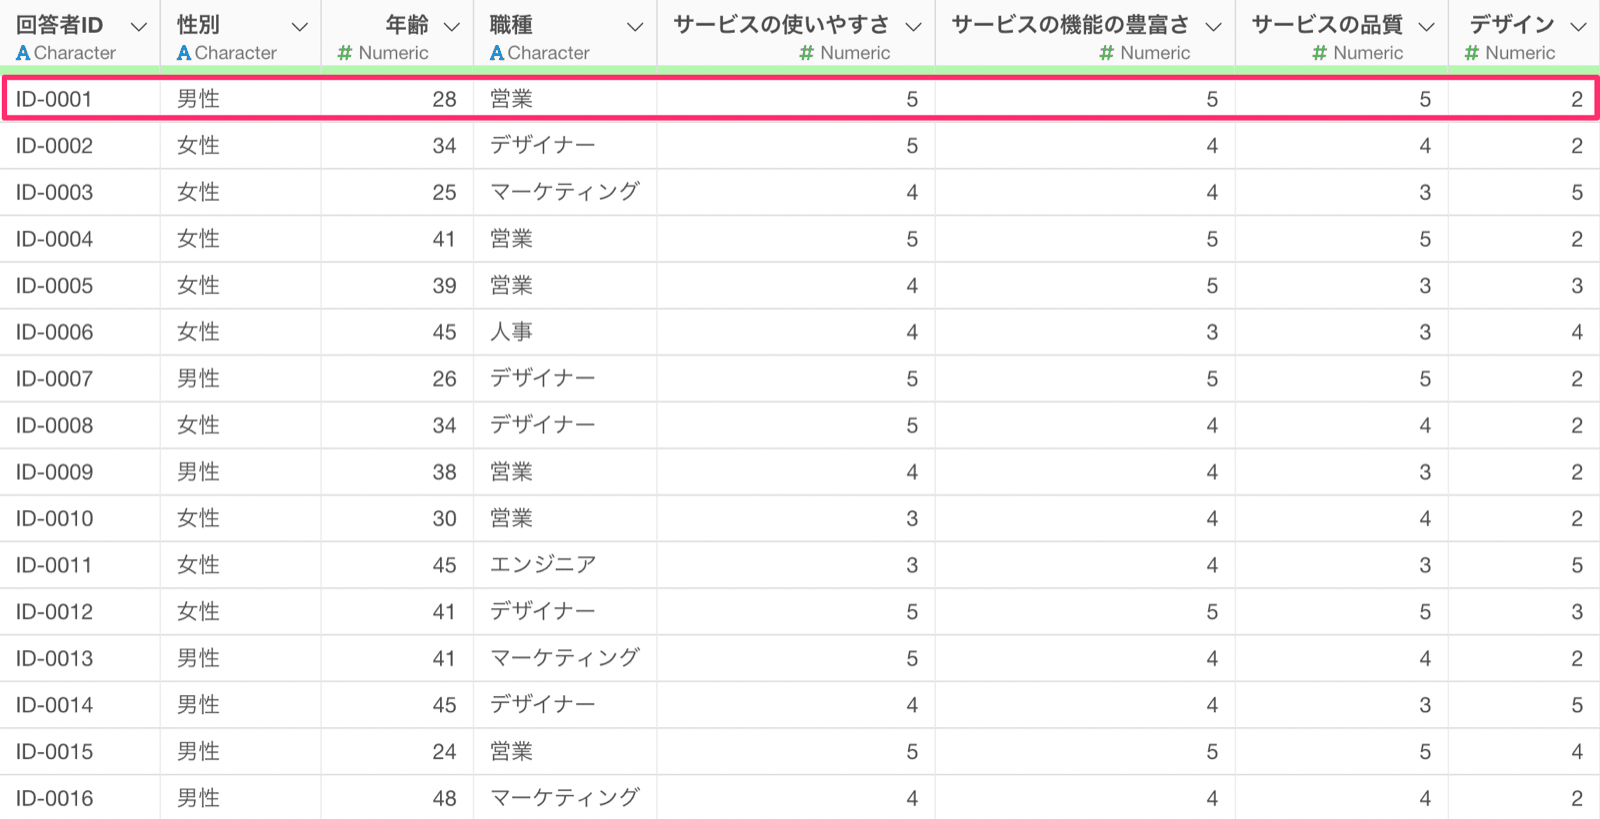
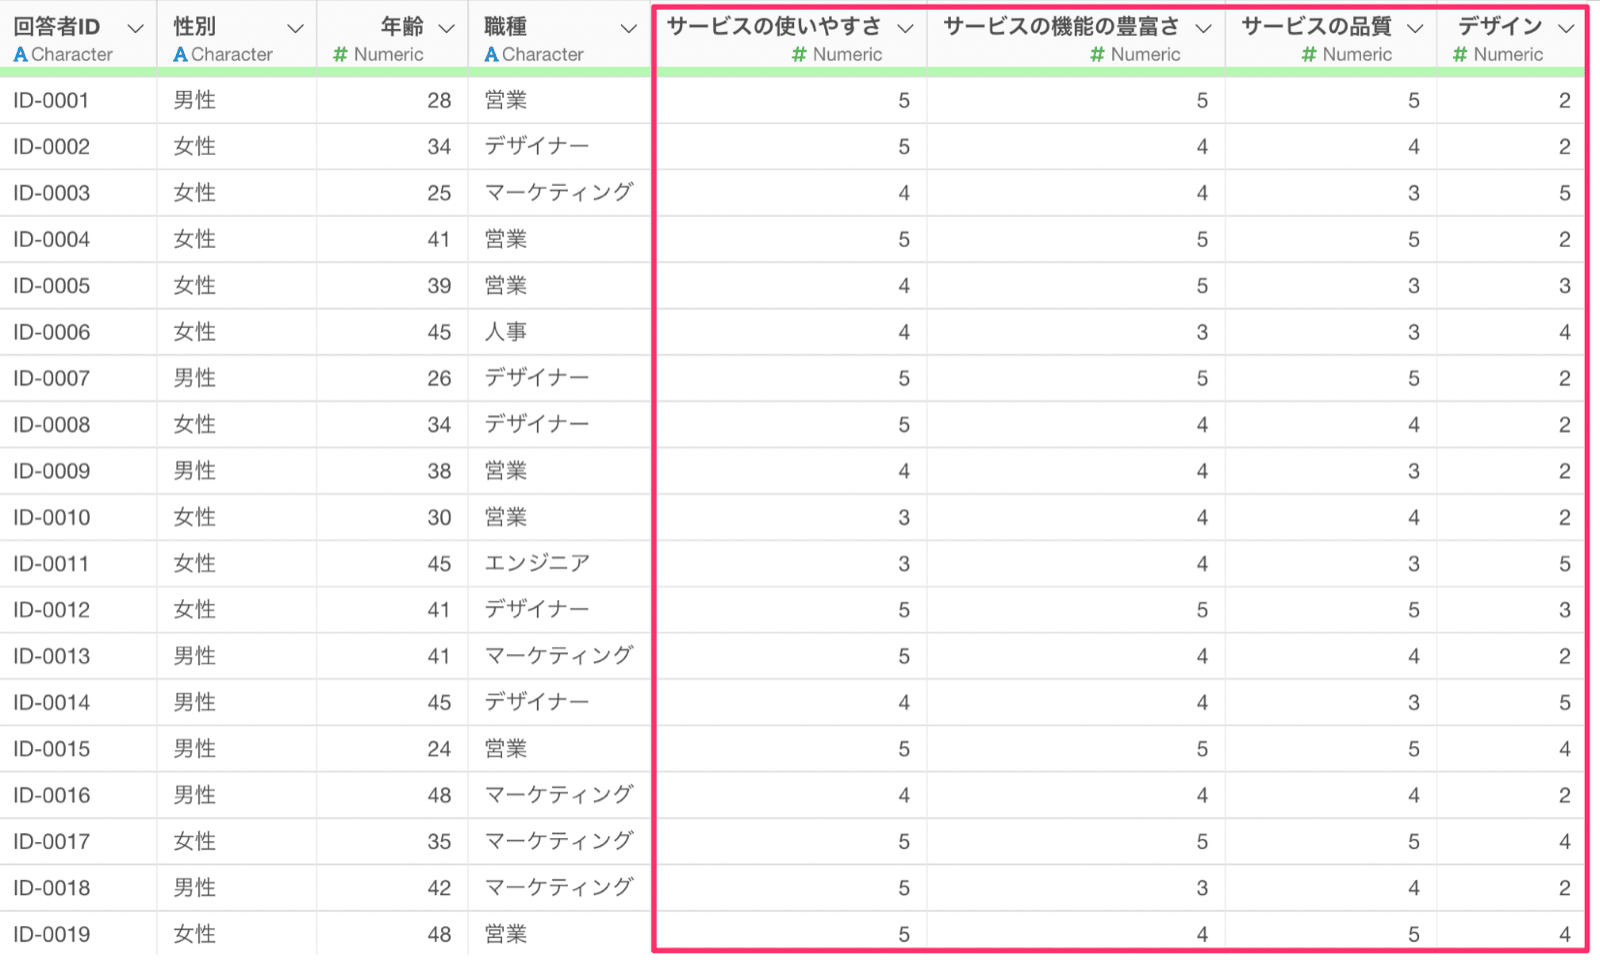
サンプルデータ
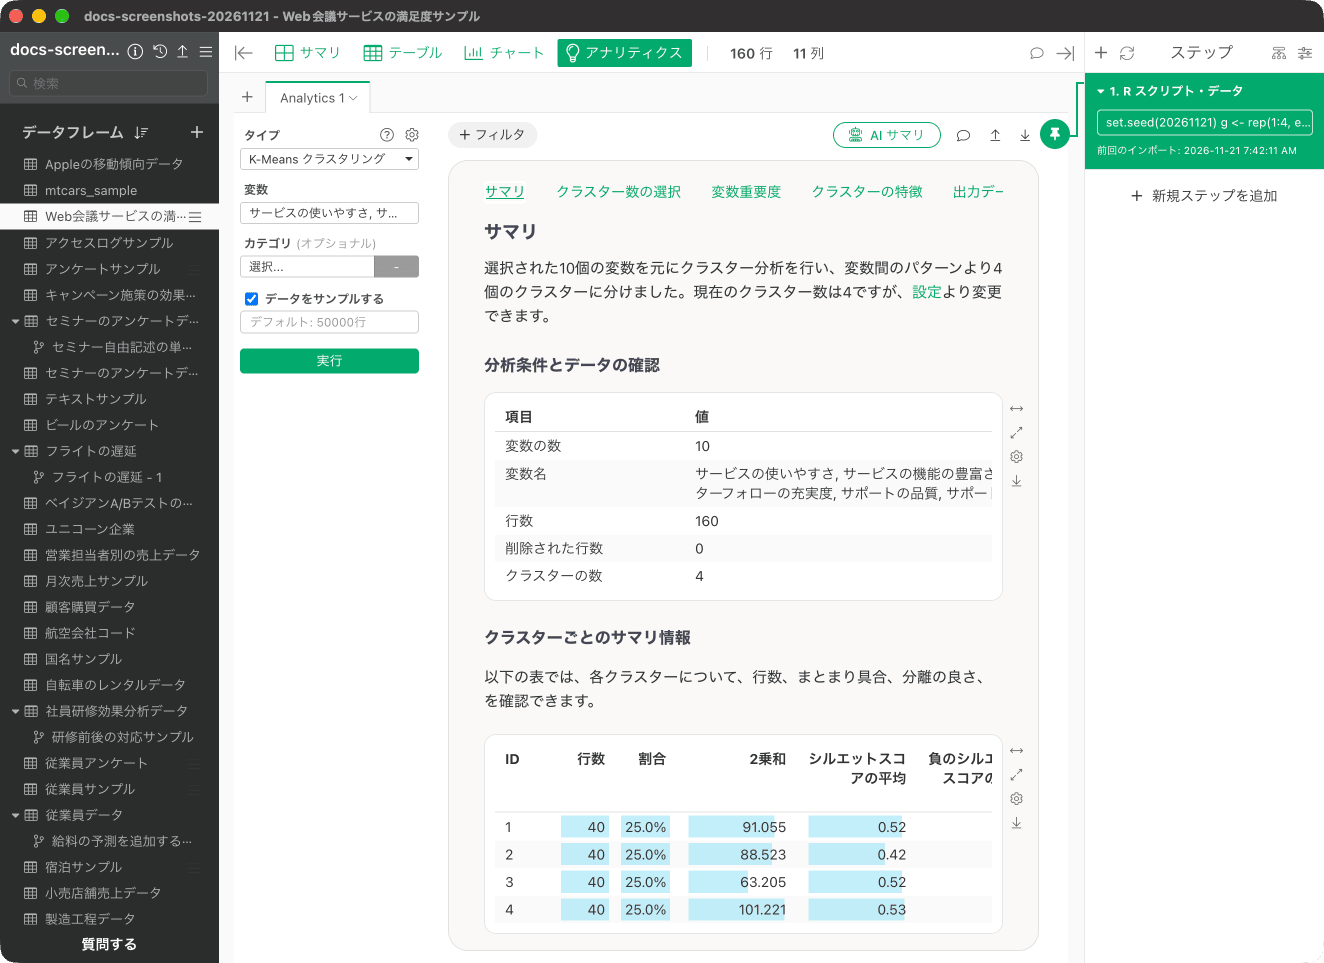
今回使用するのは、サンプルデータ「Web会議サービスの満足度サンプル」です。この例のデータは説明用に作った架空のものです。1行が1回答者を表し、160行・11列です。列には、サービスの使いやすさ、サービスの機能の豊富さ、サービスの品質、デザイン、導入の簡単さ、アフターフォローの充実度、サポートの品質、サポートの応対速度、ブランドのイメージ、価格の10項目の評価(1から5の数値)と、「NPSカテゴリ」(デトラクター・中立者・プロモーター)があります。K-Meansクラスタリングを実行する
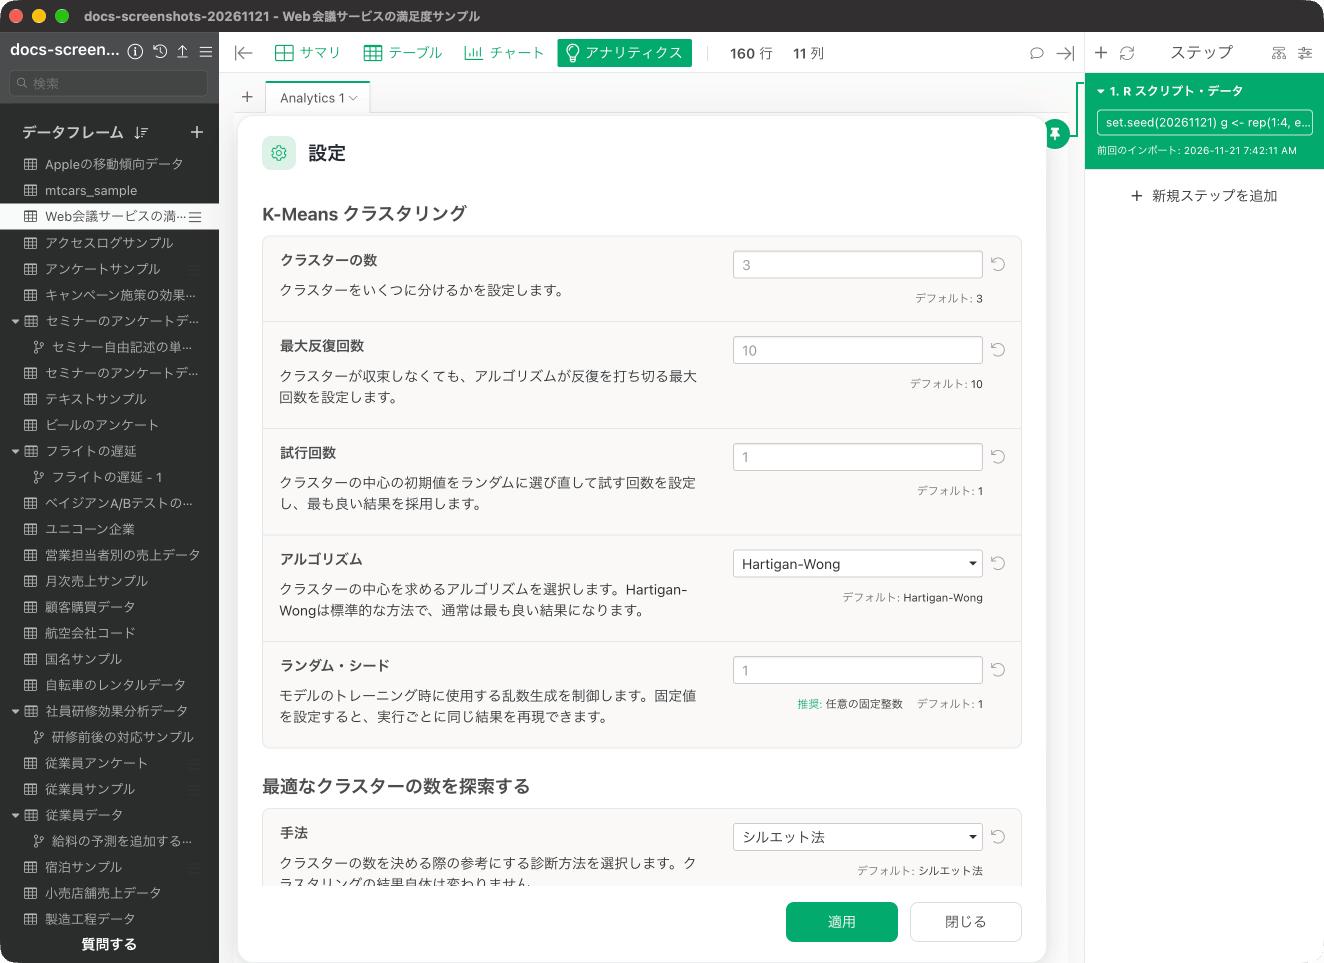
アナリティクスビューを開き、「タイプ」のメニューで「クラスタリング分析」にマウスを合わせ、「K-Means(数値)」を選択します。同じメニューには、K-Modes(カテゴリ)、K-Medoids(順序 / 数値)、階層クラスタリングもあります。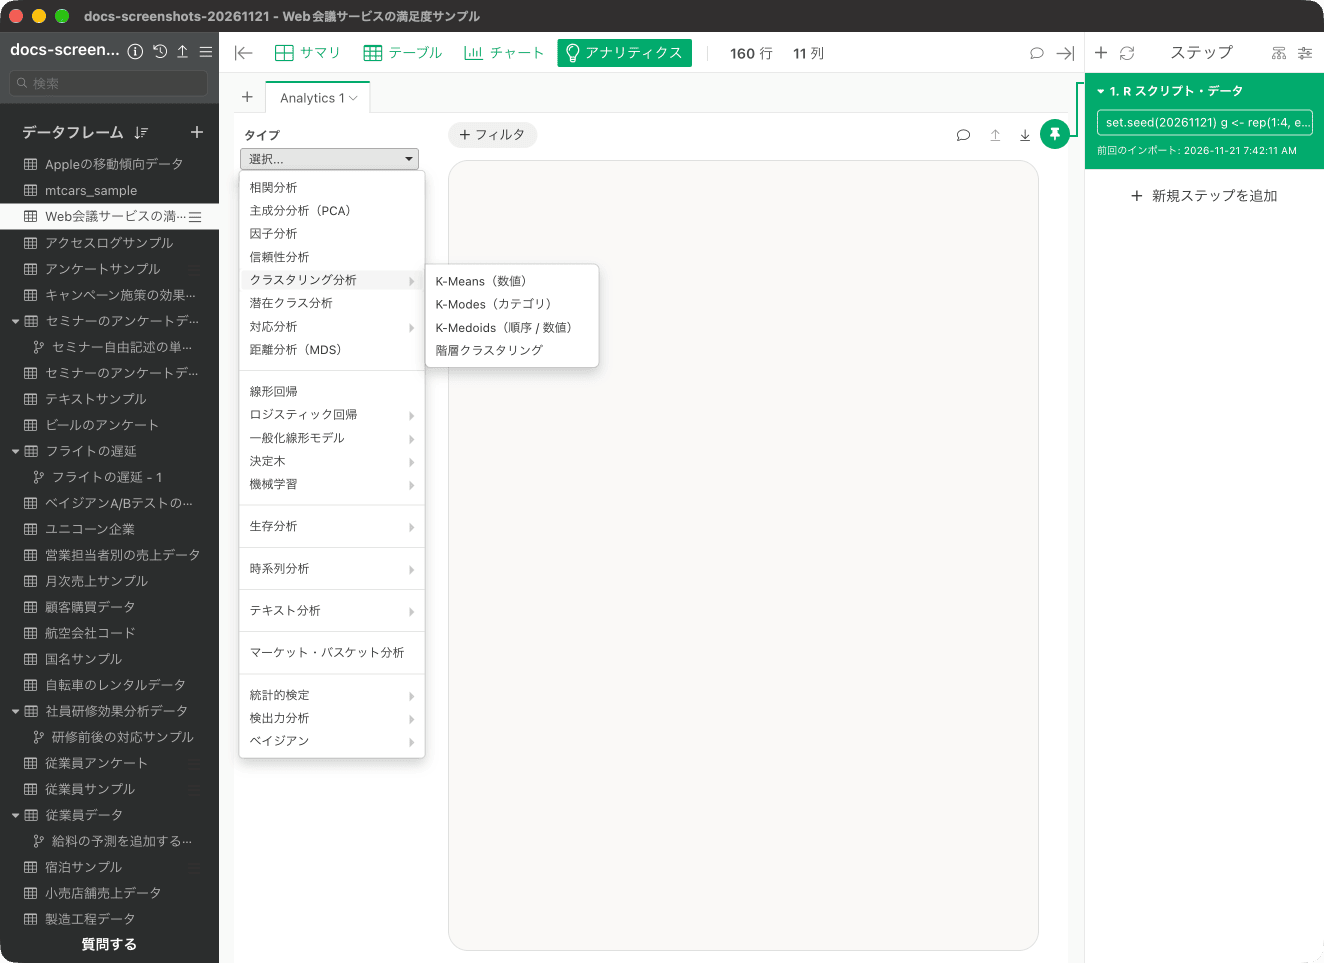
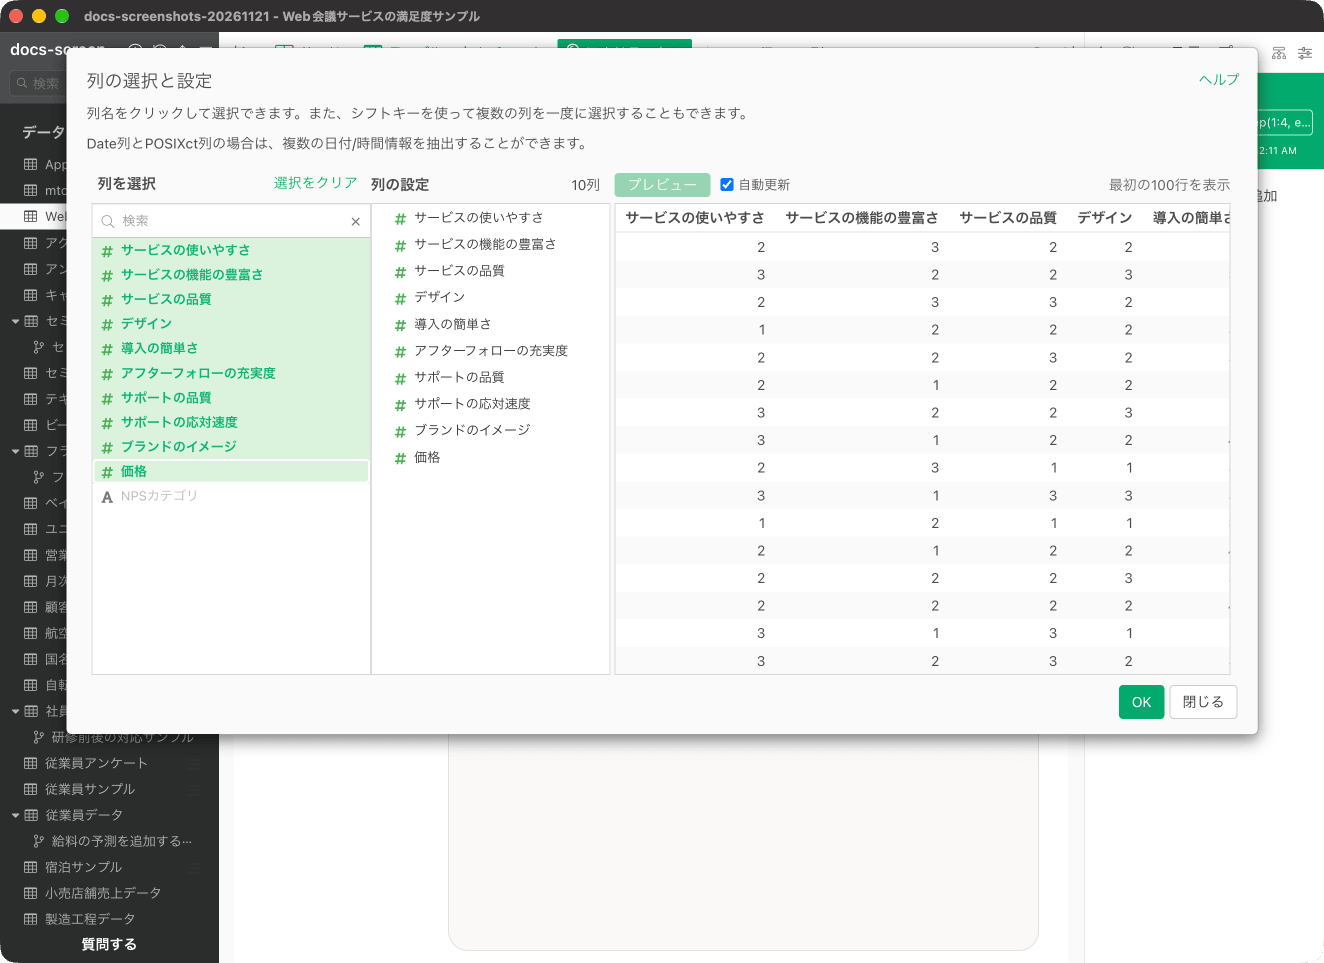
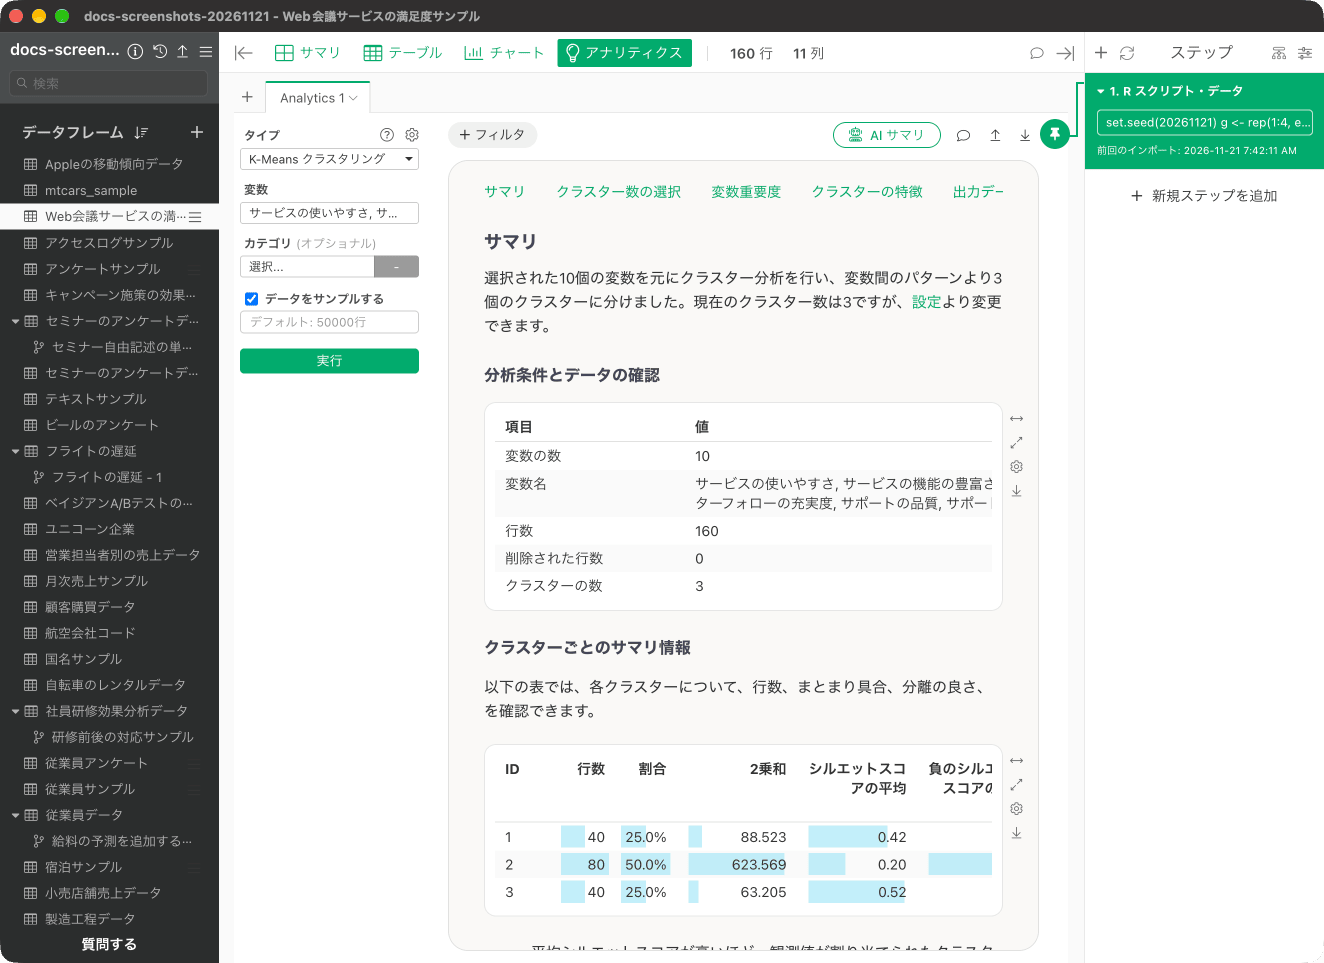
クラスターの数を変更する
クラスターの数は、歯車のアイコンから「設定」を開き、「K-Means クラスタリング」の「クラスターの数」で変更できます。デフォルトは3で、今回はクラスターの数を「4」、「試行回数」を「25」に変更して「適用」をクリックします。同じ画面には、最大反復回数(デフォルト10)、試行回数(デフォルト1)、アルゴリズム(デフォルトは Hartigan-Wong)、ランダム・シード(デフォルト1)、最適なクラスターの数を探索する手法(デフォルトはシルエット法)があります。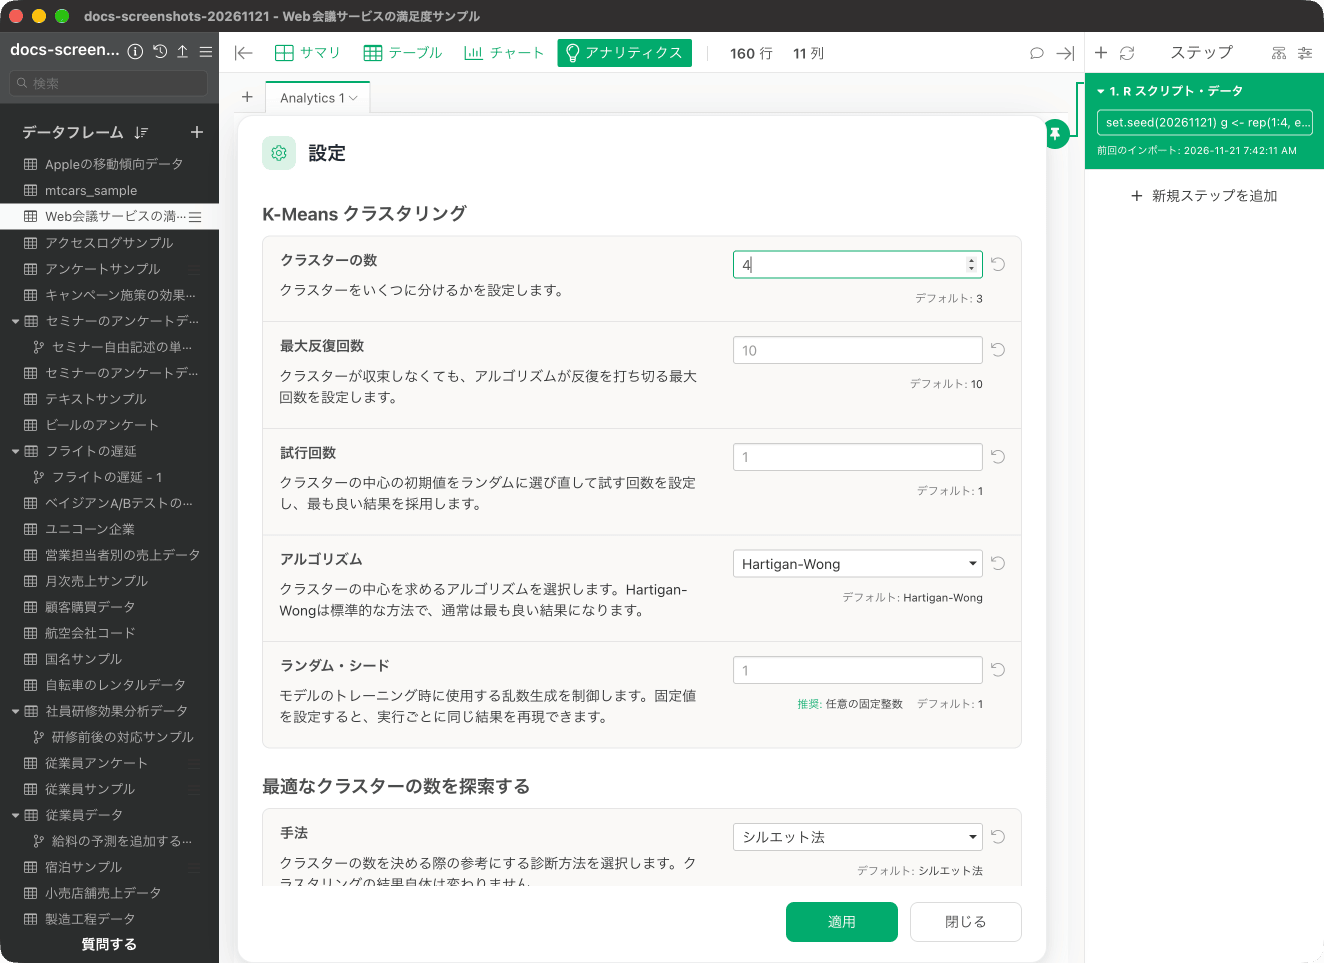
結果の解釈
変数の平均値(レーダー)
「クラスターの特徴」の節にある「変数の平均値」では、クラスター分析に使用した変数の平均値(標準化後)を、クラスターごとのレーダーチャートで確認できます。値は標準化されていて、0は全体の平均を表し、正の値は平均より高く、負の値は平均より低いことを示します。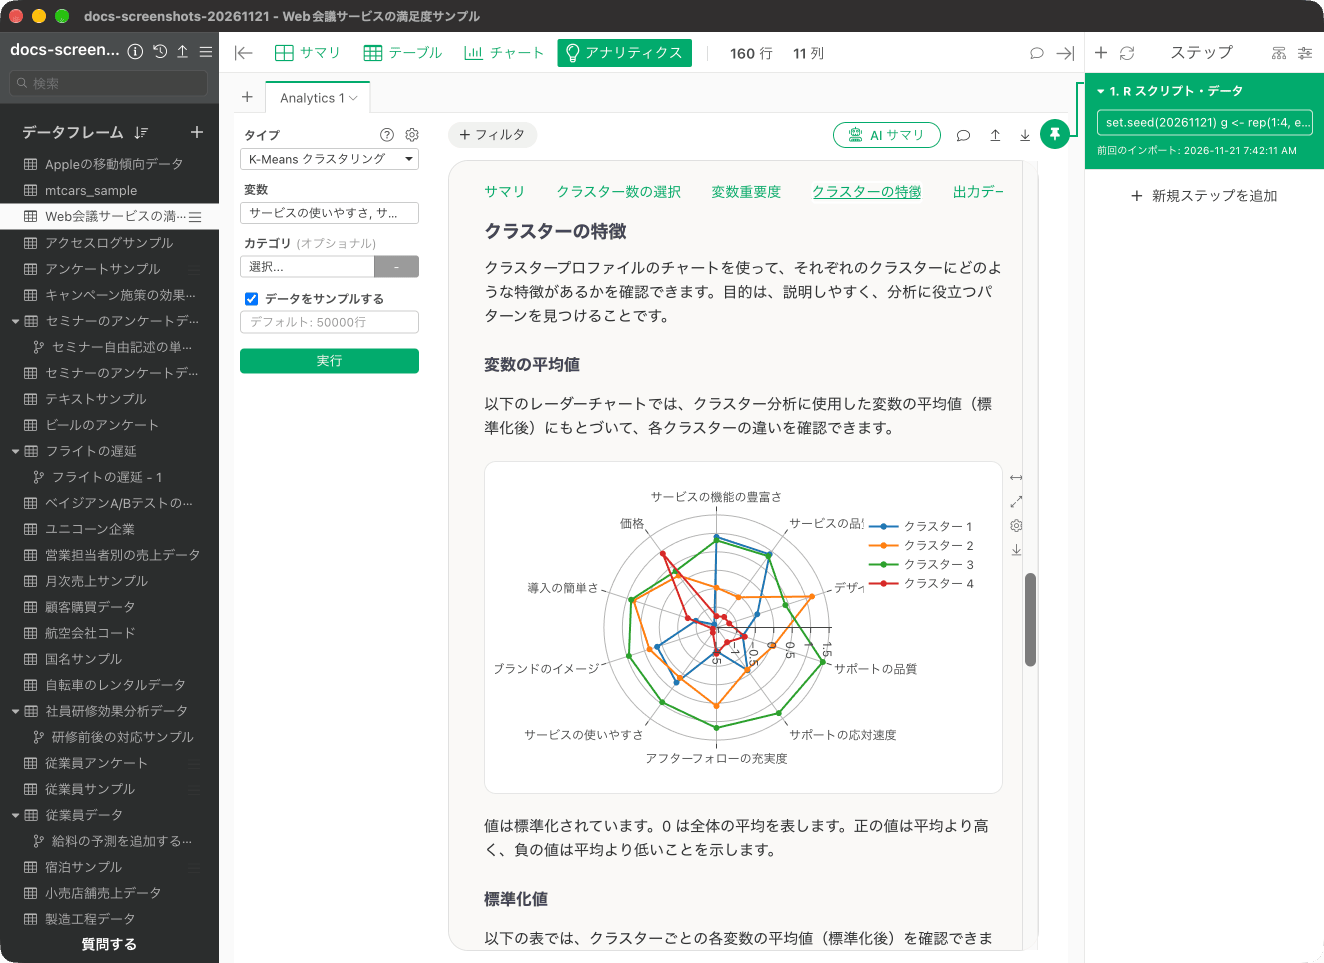
クラスターマップ(バイプロット)
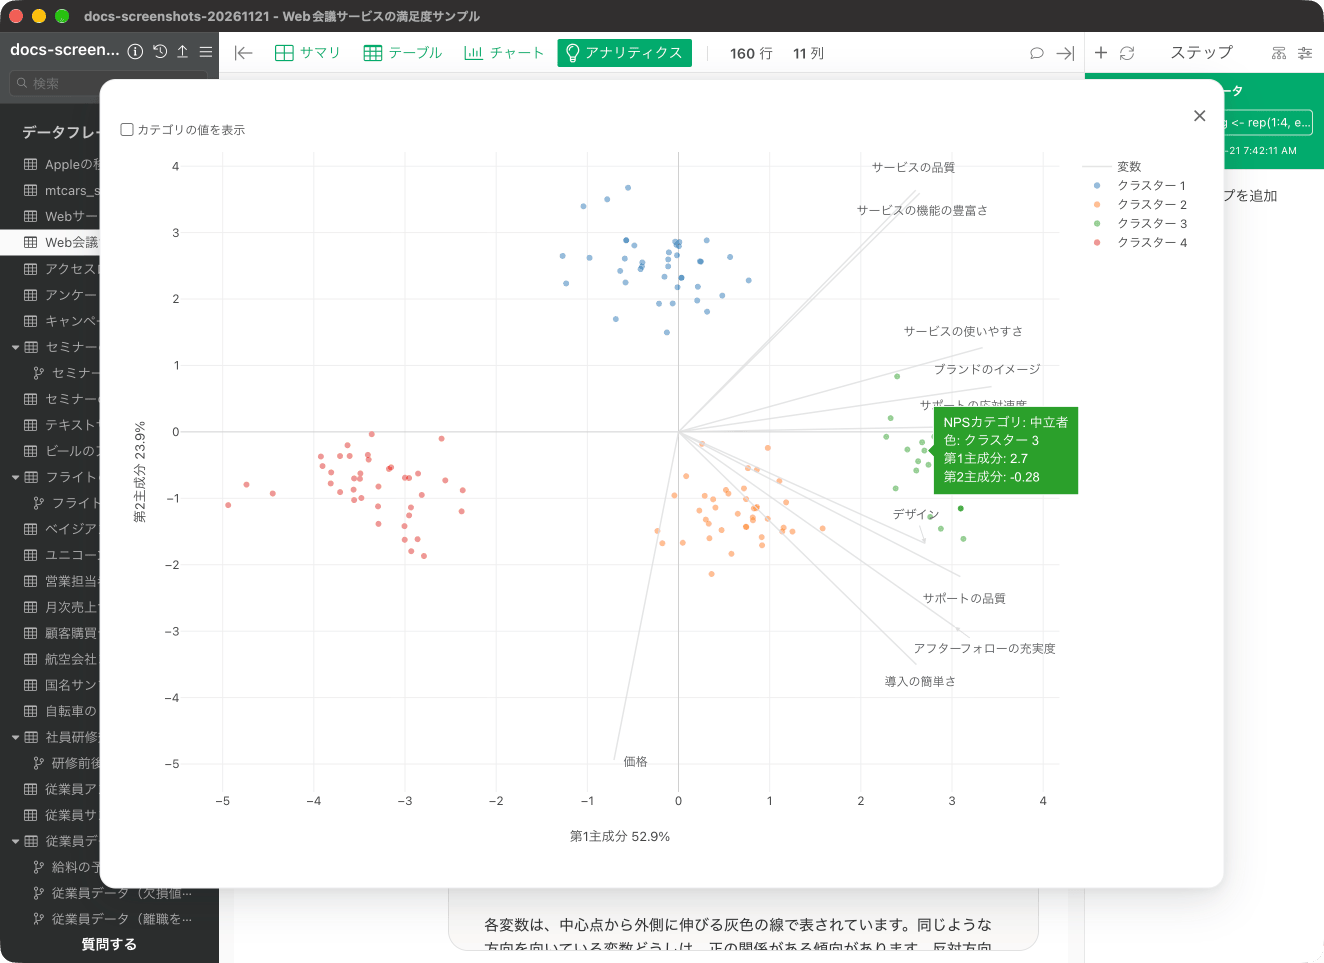
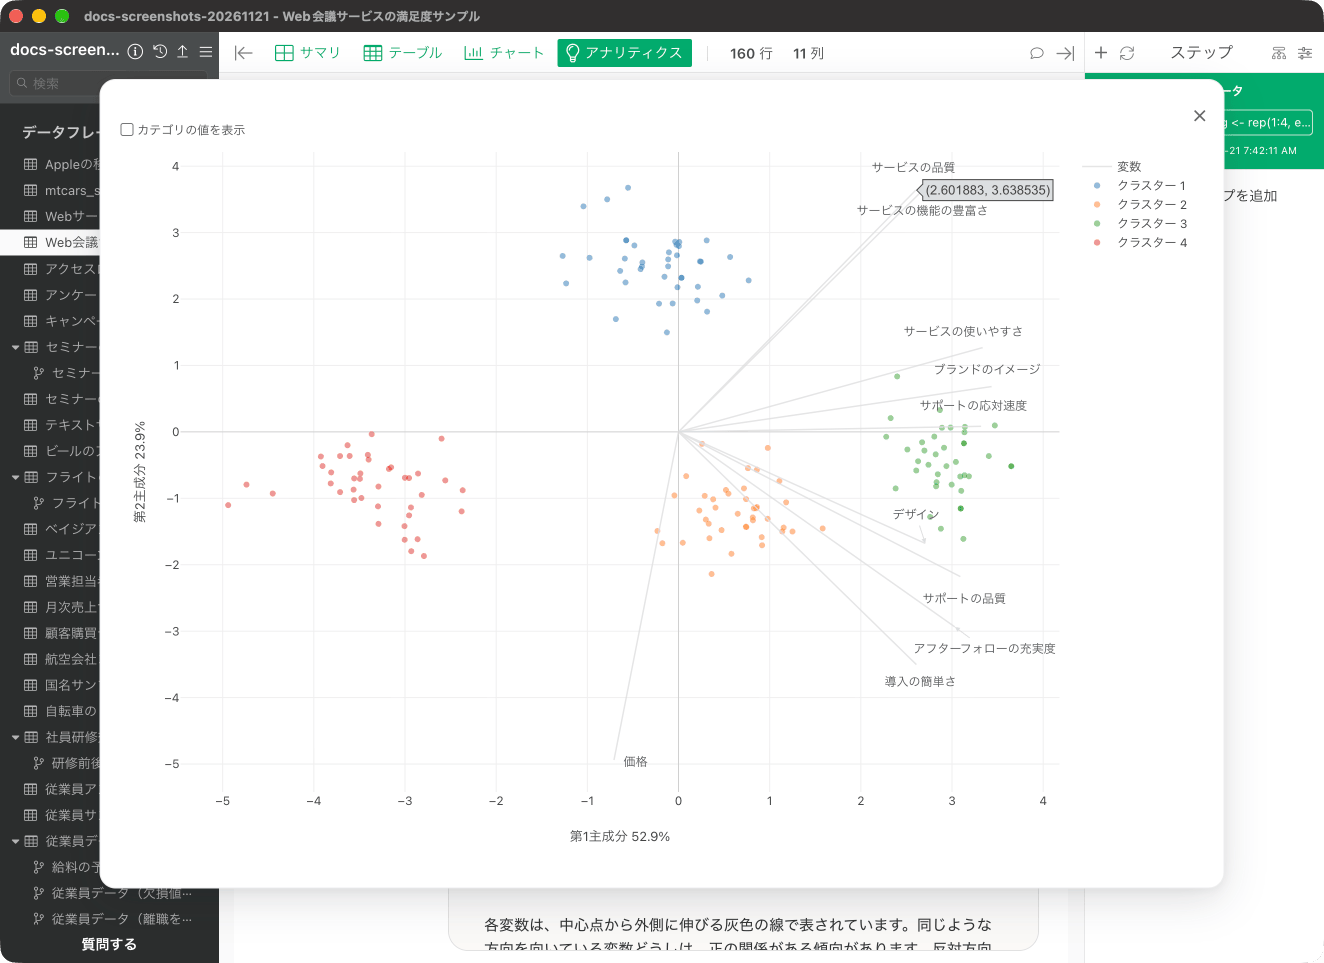
同じ「クラスターの特徴」の節にある「クラスターマップ」では、それぞれのクラスター(グループ)ごとにどういった特徴があるのかを散布図上で確認できます。クラスターは色分けされ、凡例に表示されます。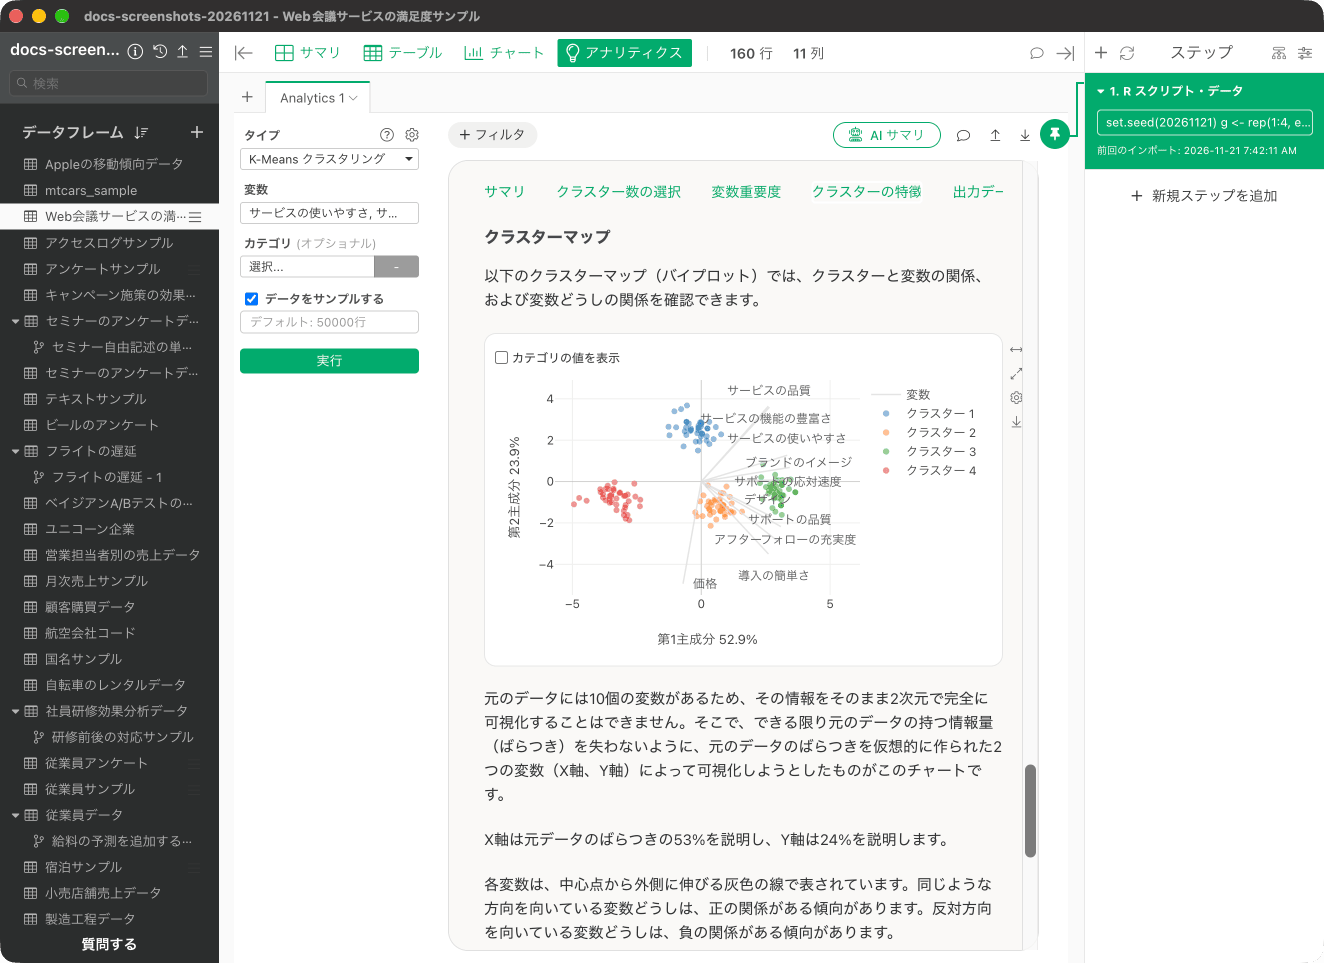
AI サマリを使って分析結果を要約
AI サマリの機能では、クラスタリング結果を自動的に要約してくれます。 使い方は驚くほど簡単で、K-Meansクラスタリングを実行した後に、上部の「AI サマリ」のボタンをクリックします。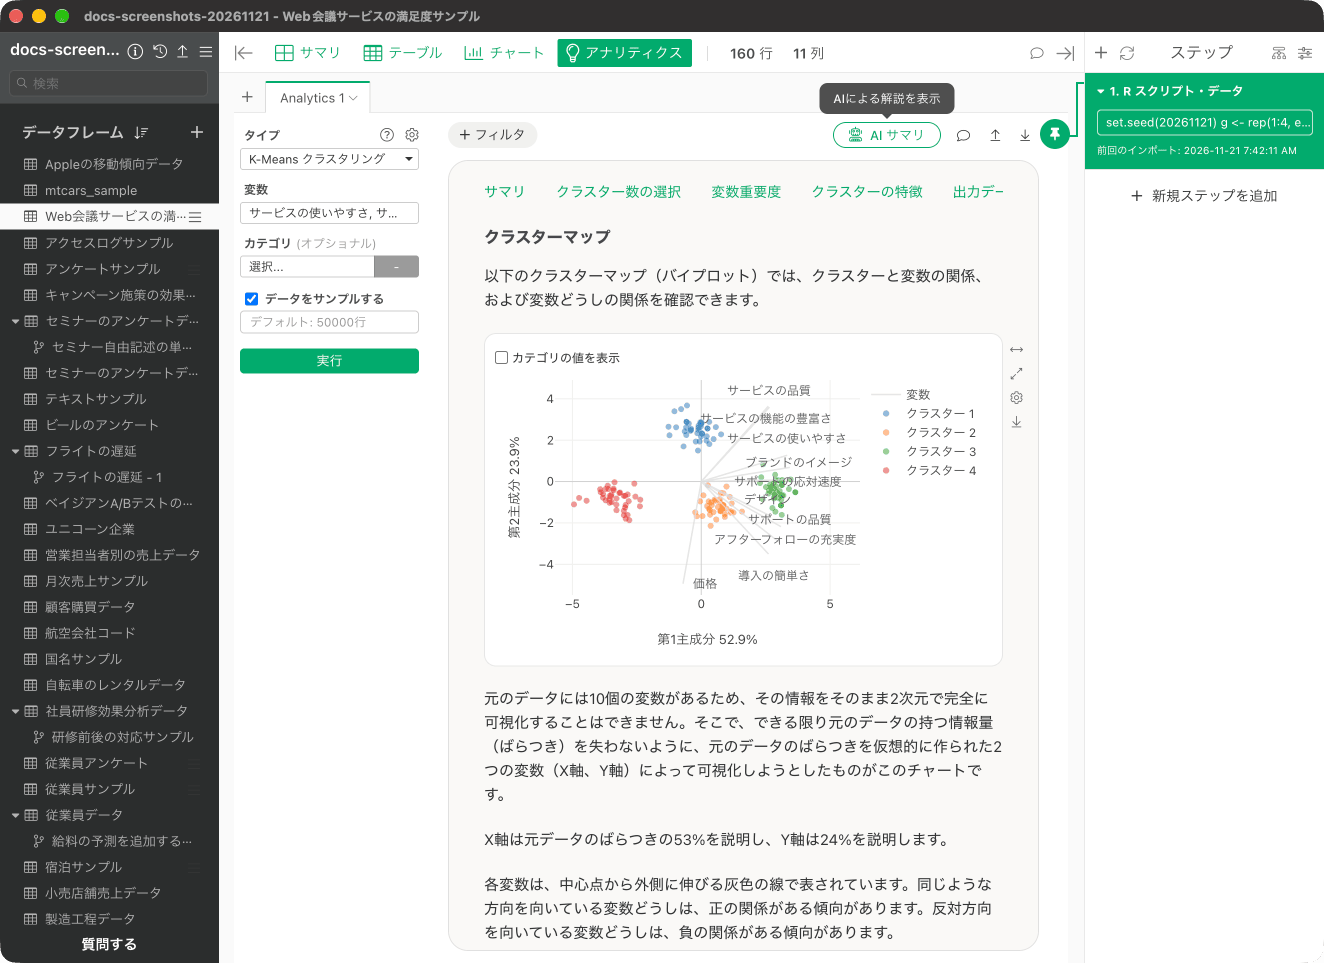
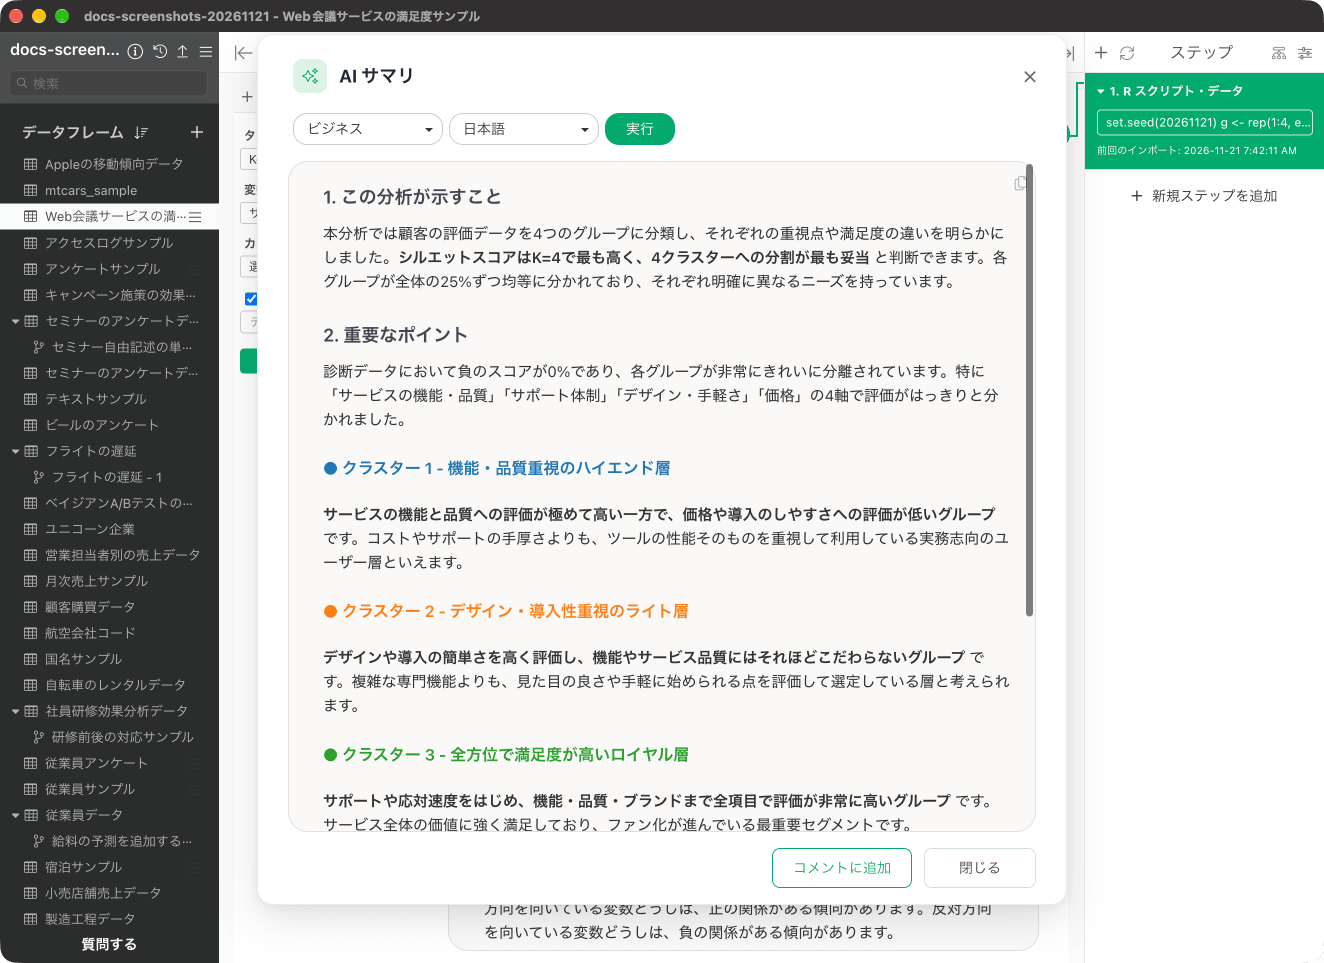
- クラスター1: 機能・品質重視のハイエンド層
- クラスター2: デザイン・導入性重視のライト層
- クラスター3: 全方位で満足度が高いロイヤル層
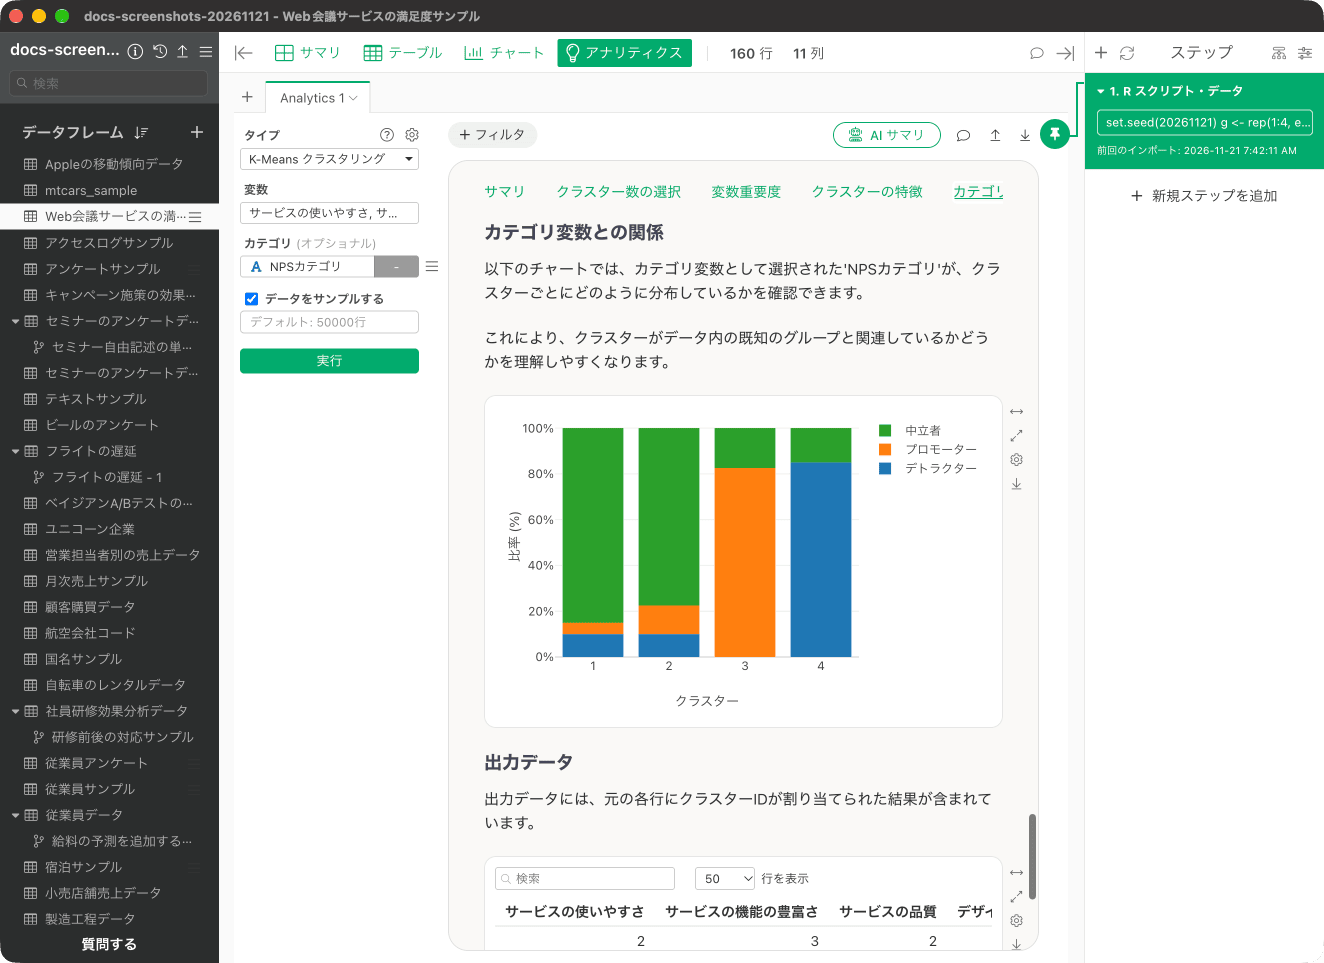
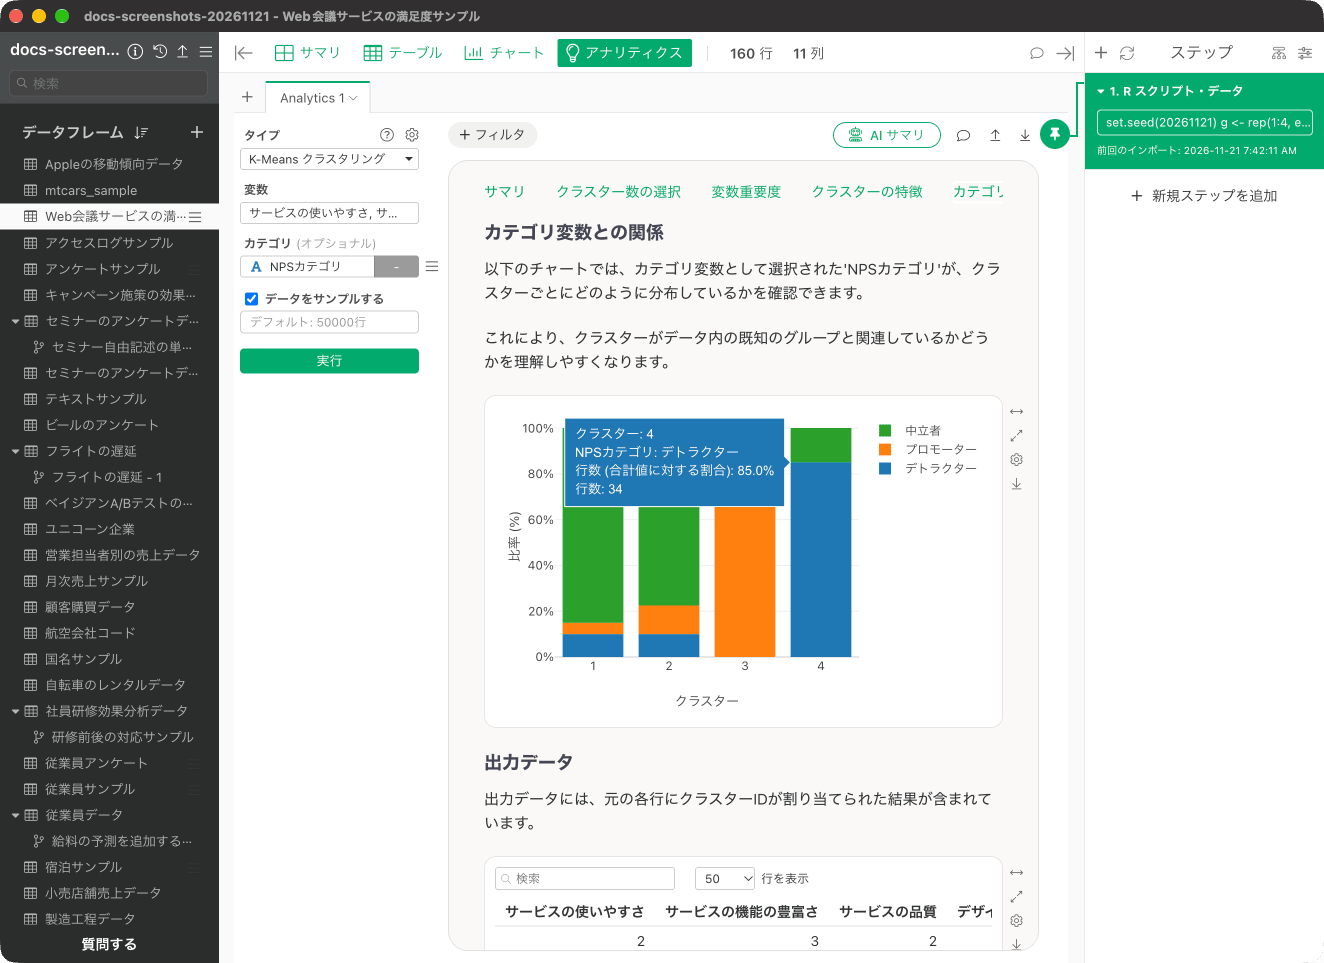
クラスターとカテゴリの関係性を見る
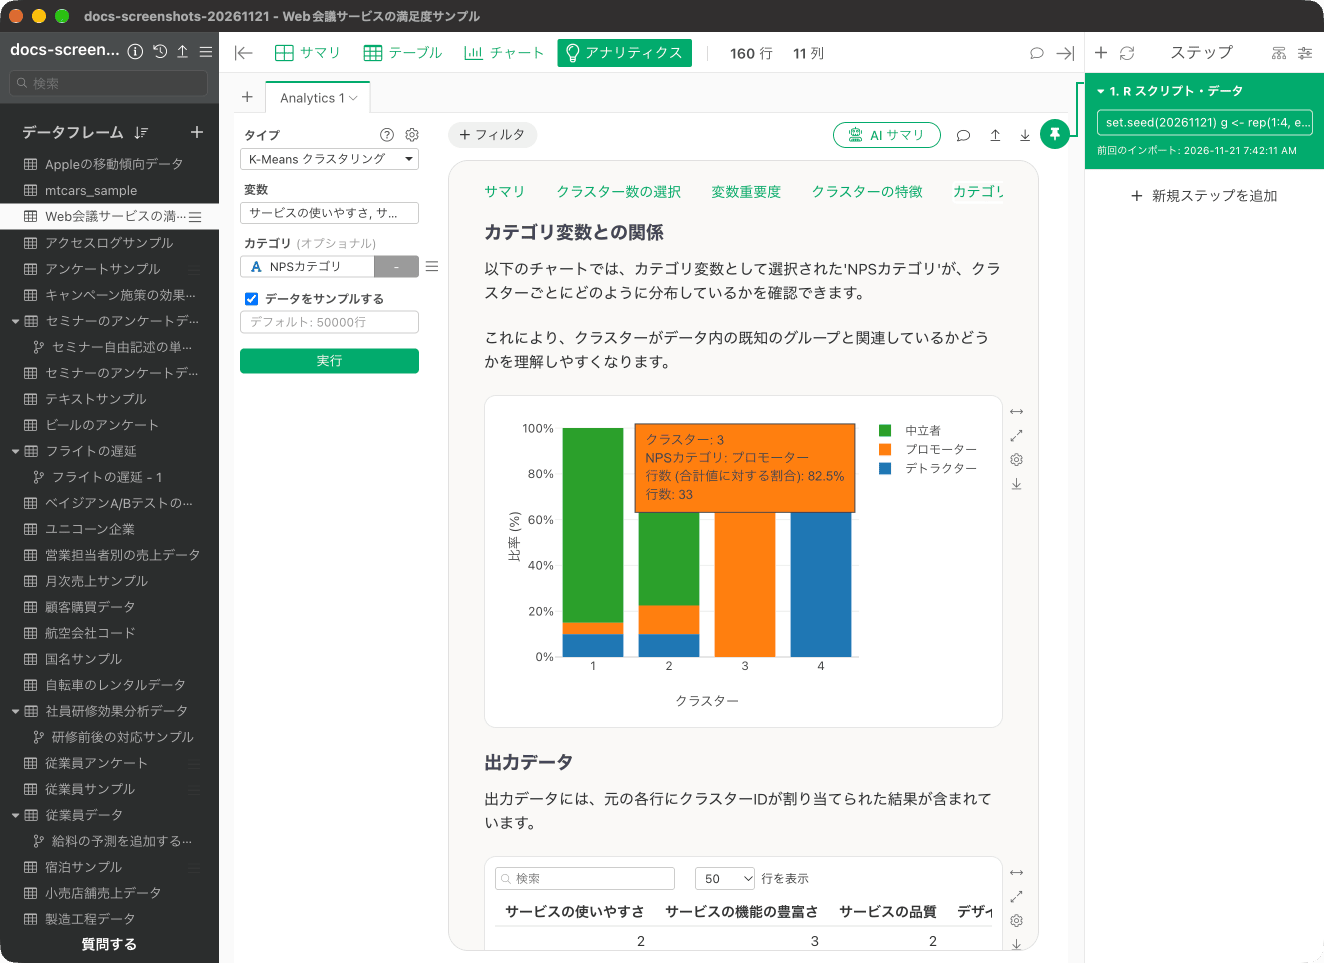
データの中に「NPSカテゴリ」の列があり、どのクラスターでプロモーター(推奨者)やデトラクター(非推奨者)が多いのかを知りたいとします。 K-Meansクラスタリングの「カテゴリ」に「NPSカテゴリ」の列を割り当てて実行します。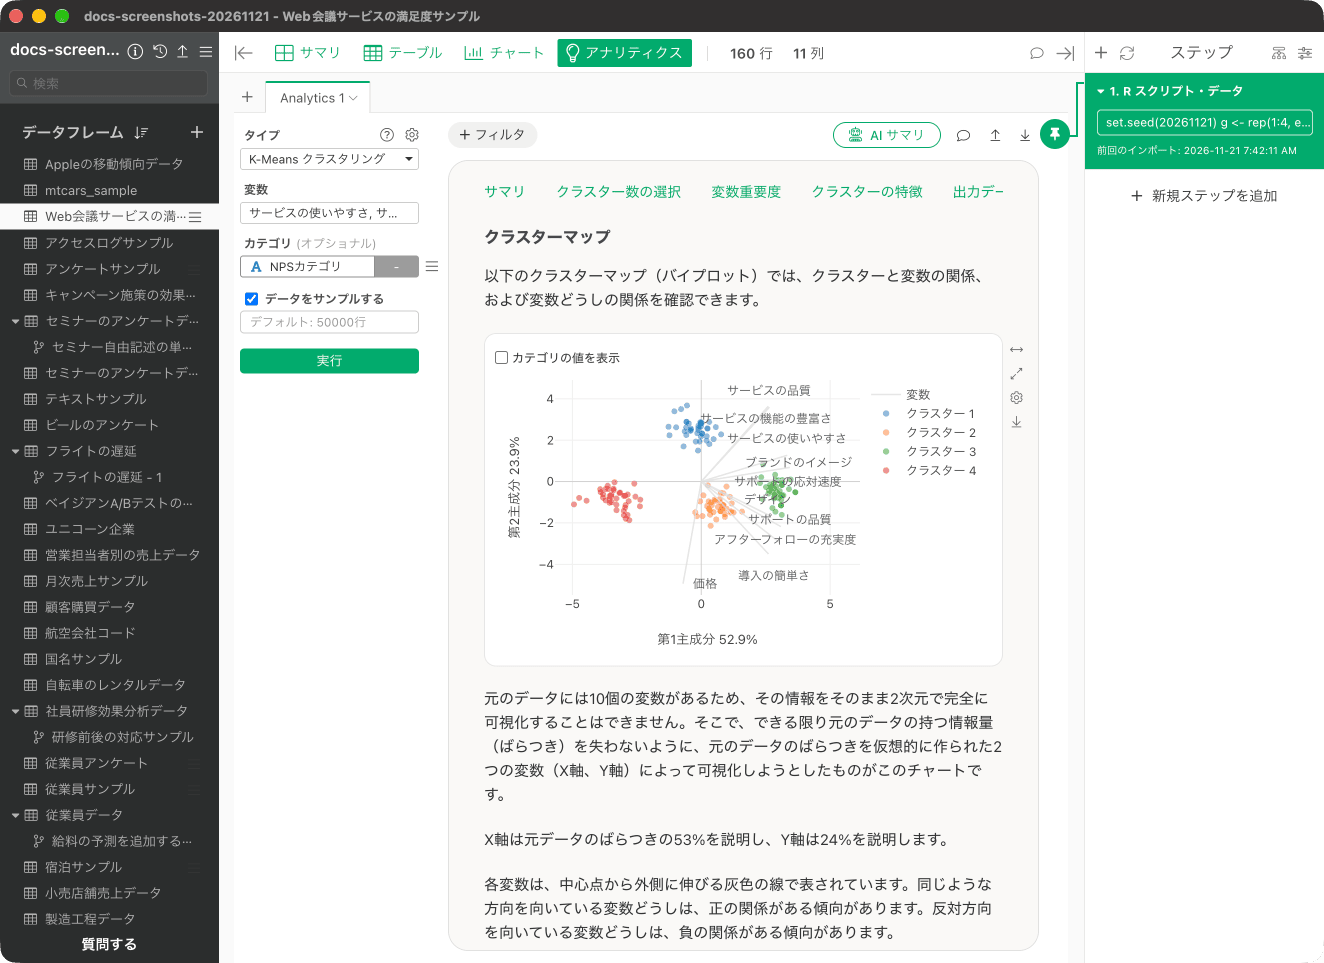
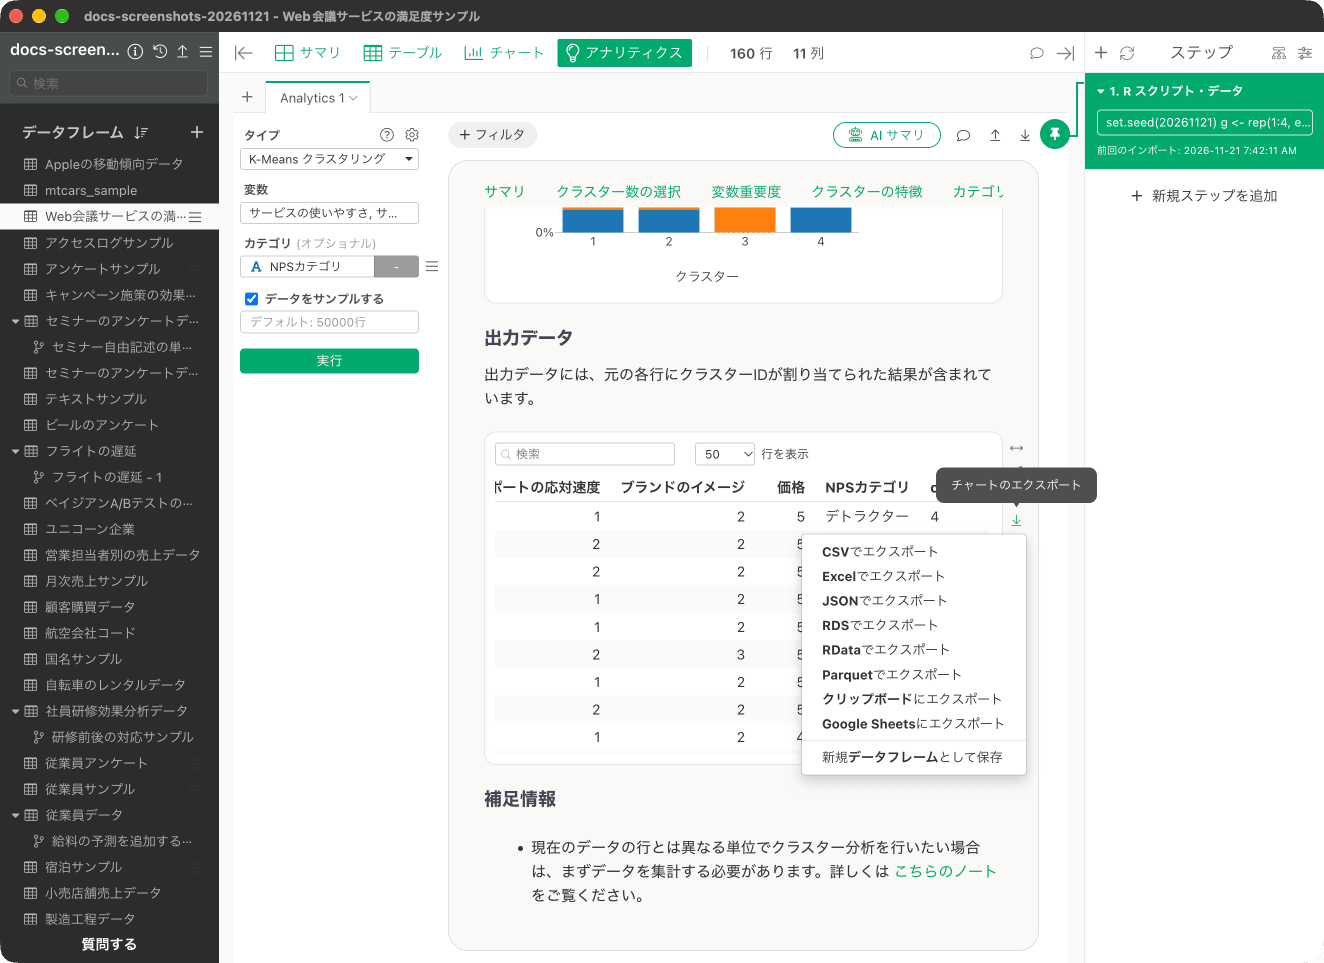
クラスタリングしたデータをエクスポートする
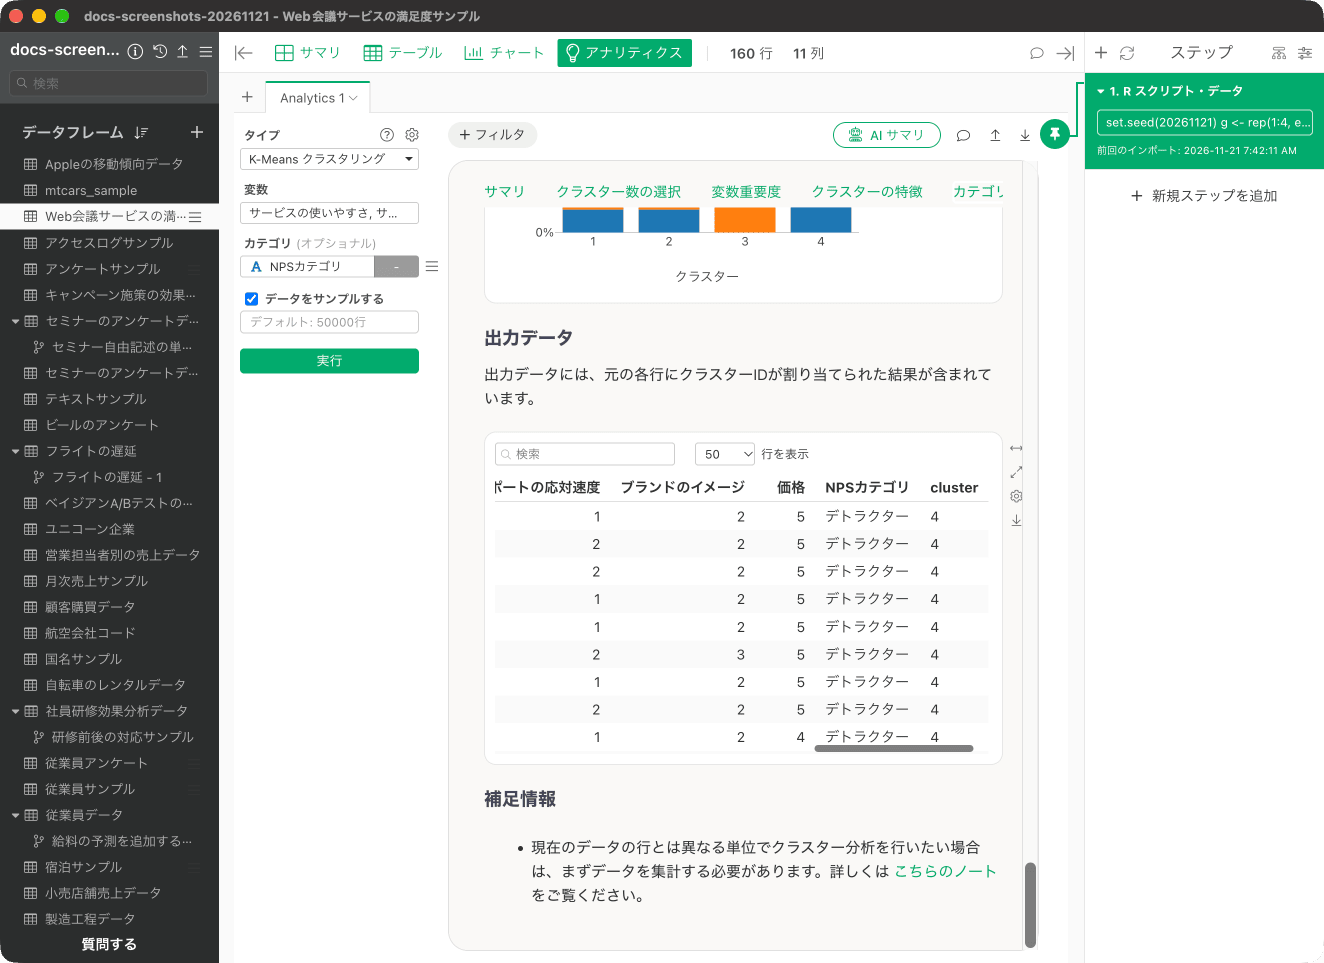
「出力データ」の節にあるテーブルでは、K-Meansクラスタリングに使用されているデータとクラスター番号(cluster 列)を確認できます。
K-Meansクラスタリングに関するよくある質問
Q: K-Meansクラスタリングを実行すると「クラスターの数は一意なデータの数より少なくする必要があります。」というエラーが表示される。
K-Meansクラスタリングを実行したときに、「クラスターの数は一意なデータの数より少なくする必要があります。クラスター数を減らすか、一意なデータの数を増やしてから再実行してください。」というエラーが表示され、K-Meansクラスタリングの結果が返らないことがあります。下の例は、160行のデータにクラスター数161を指定して実行したものです。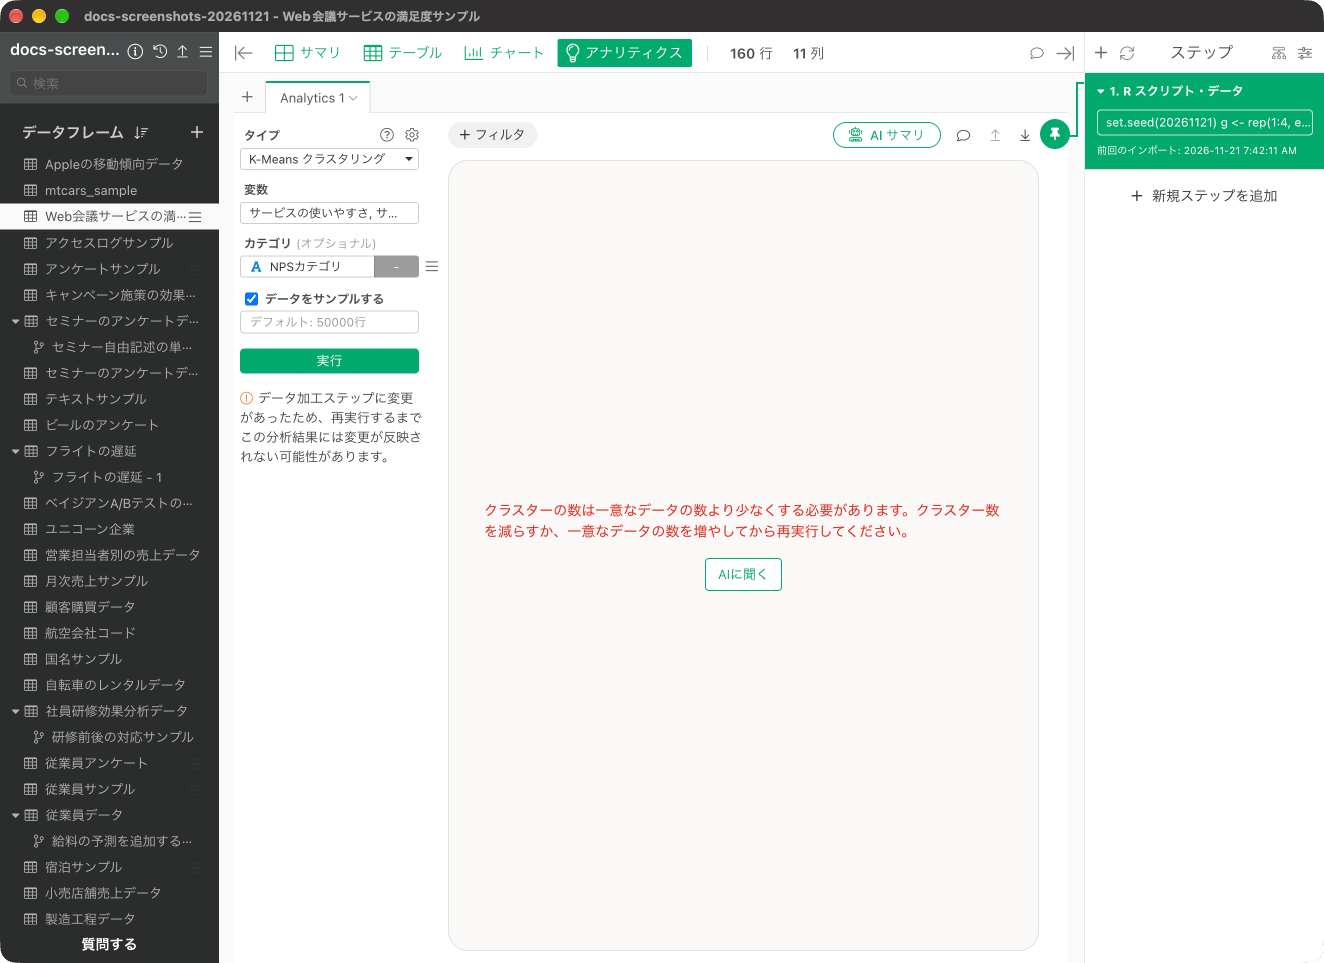
Q: K-Meansクラスタリングにおけるランダム・シードとはどのような設定ですか?
K-Meansクラスタリングは、クラスタリングを始めるときに、ランダムにクスラターの中心を決めるところから処理を始め、観察対象をクラスターに分けていきます。 ランダム・シードはそのときの初期中心の位置を決めるための「番号」のようなものです。「設定」の「K-Means クラスタリング」にあり、デフォルトは1です。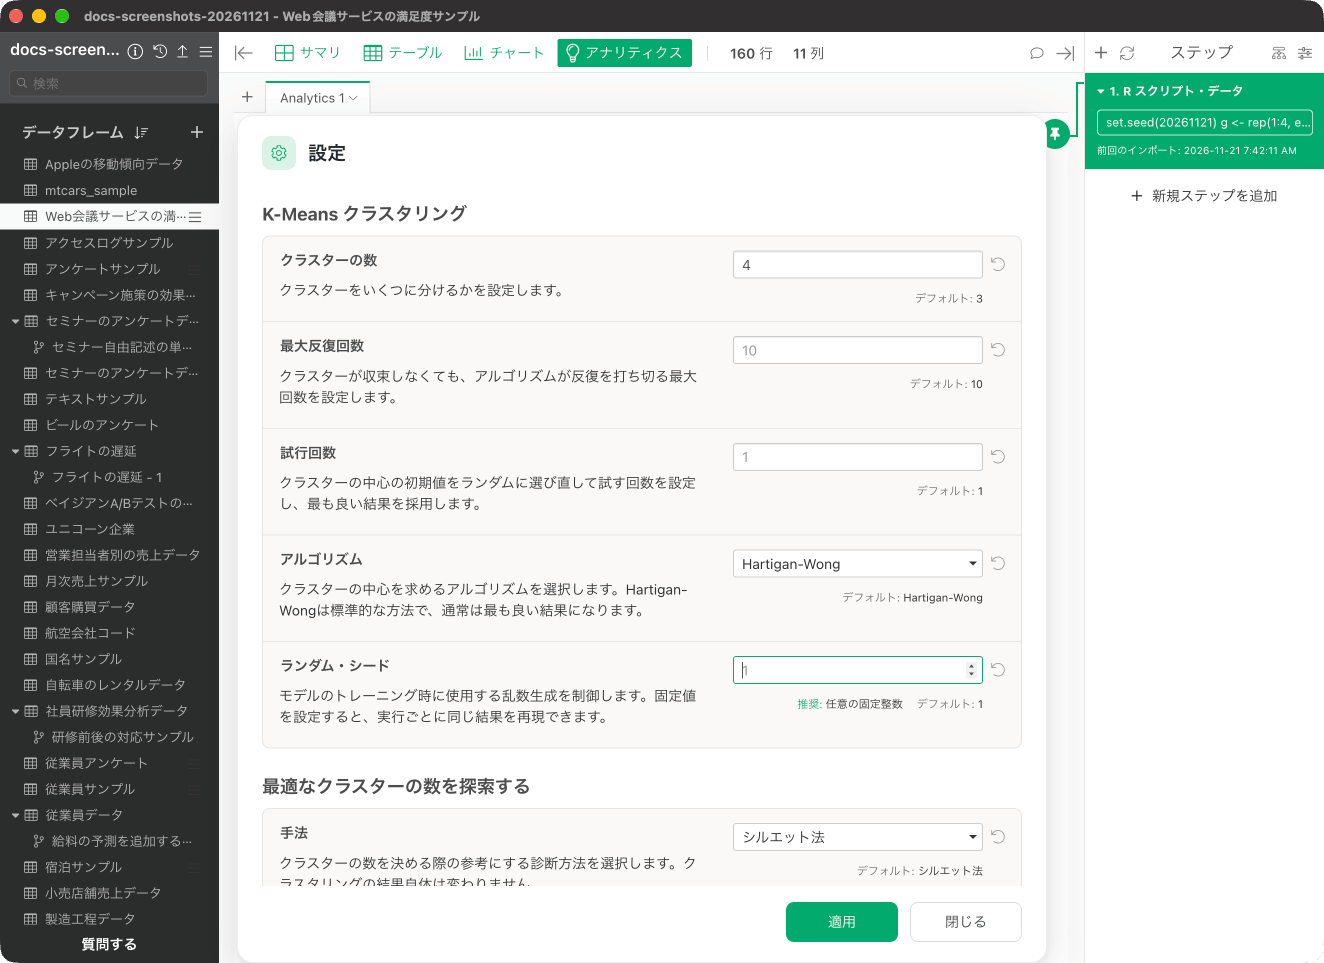
Q: K-Meansクラスタリングを実行した際、データの並び順によって結果にばらつきが生じます。結果のばらつきを減らすために、できることはありますか?
K-Meansクラスタリングは、クラスタリングを始めるときに、ランダムにクスラターの中心を決めるところから処理を始め、観察対象をクラスターに分けていきます。 そのため、データの並び順が変わることで、最初に設定されるランダムな中心が変わってしまい、得られる結果が変わることは想定されることになります。 一方でデータの並び順による結果のばらつきを減らすためには、「試行回数」や「最大反復回数」、特に「試行回数」を増やすことが有効です。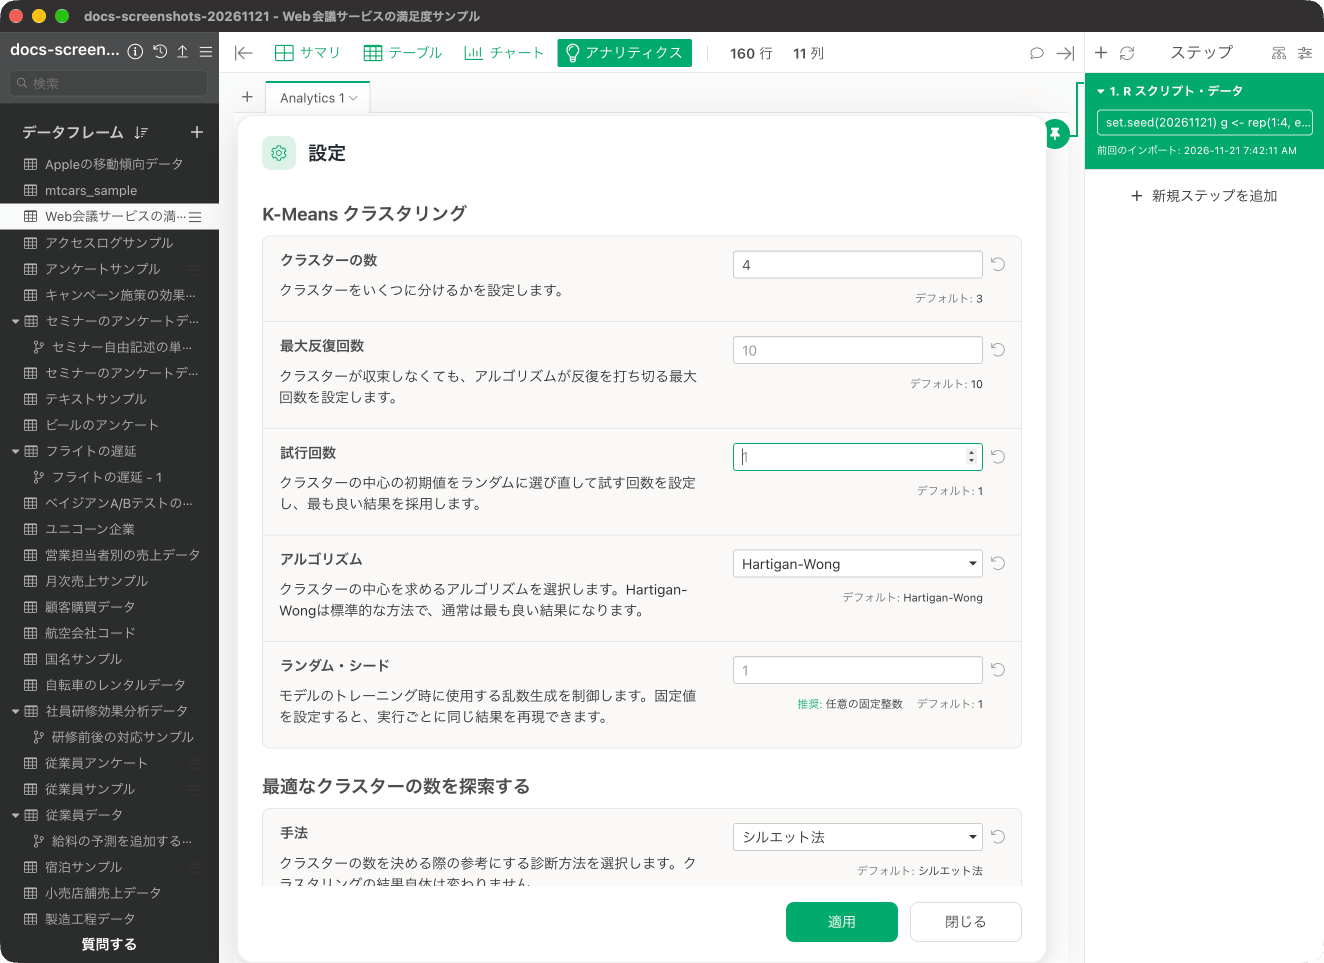
Q: 「サマリ」に表示されるクラスター内平方和とはなんでしょうか?
クラスター内平方和は各クラスターの中心地からのそれぞれのデータのずれの合計だと捉えていただければと思います。この値が小さければ小さいほどずれが少なくなり、K-Meansではこのクラスター内平方和を少なくするために、クラスターの中心となる点をずらしていくという手法となっています。「サマリ」の節の「クラスターごとのサマリ情報」にある「2乗和」の列が、この値にあたります。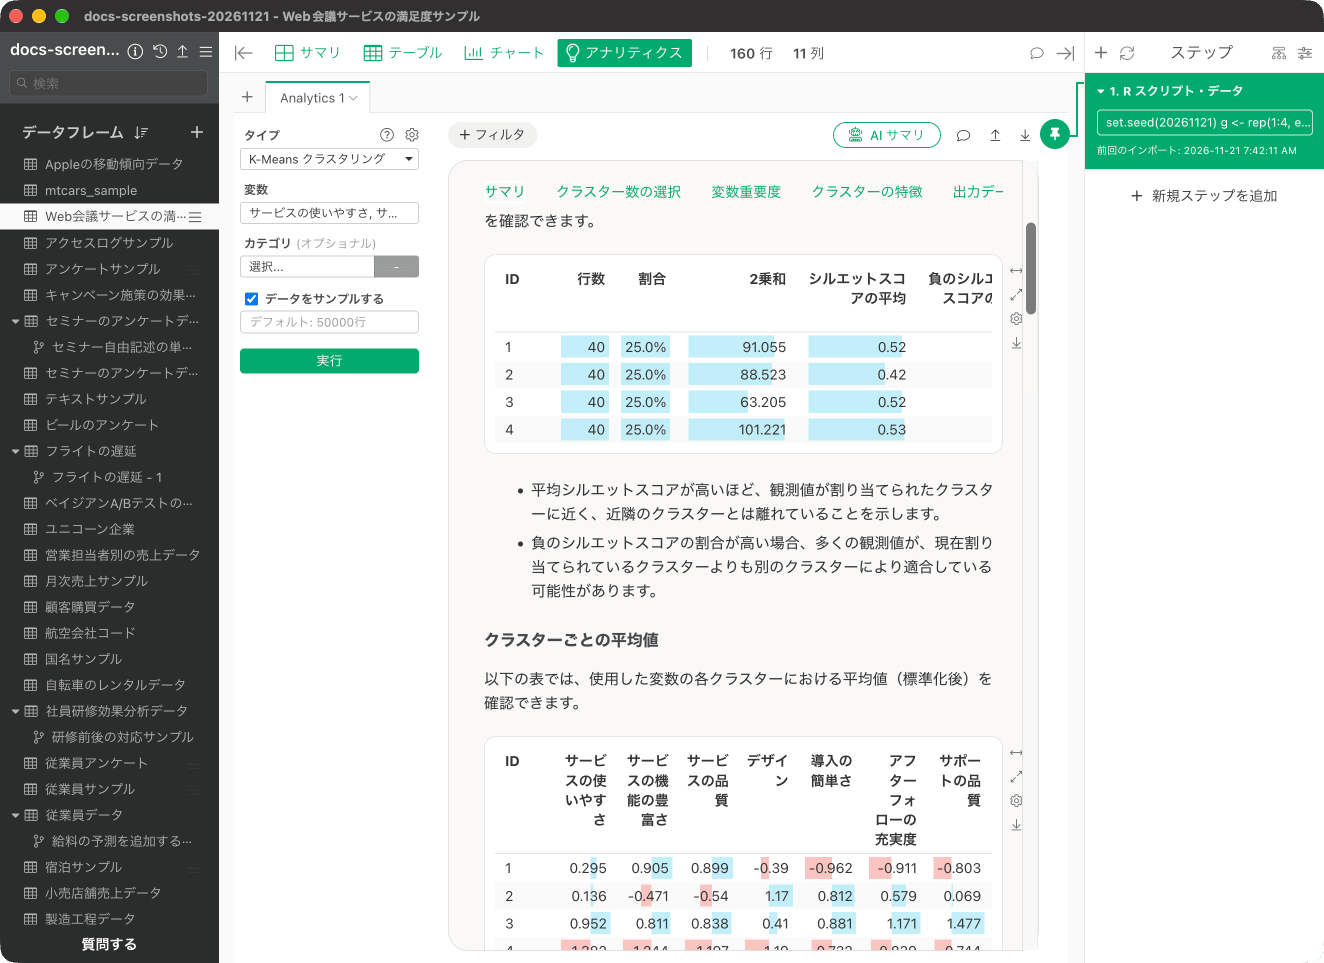
Q: クラスター間平方和とはなんでしょうか?
クラスター間平方和はクラスターの中心が、全データの中心からどれだけ離れているかを示す指標となり、各クラスターがどれだけ綺麗に分かれているかを測る相対的な指標となり、Between-Cluster Sum of Squares(BCSS)と呼ばれることがある指標です。Q: 設定メニューに表示される「反復回数」や「試行回数」は何を表していますか?
K-Means クラスタリングでは最初にランダムにクラスターの中心点の位置を決め、観察対象をクラスターに分けることになります。 Exploratoryではシードがセットされているため、同じマシンで実行している限りは結果が変わることはありませんが、最初に決められたクラスターの中心点が変わることによって結果が変わってしまうことがあります。 そこで試行回数ではK-Meansクラスタリングがグループ分けをする処理を試行する回数、言い換えれば、クラスターの中心点の位置を決め、観察対象をクラスターに分ける処理を繰り返す回数を決められるようになっています。 なお、反復回数は1回の試行の中で、クラスターに分けるための処理の実行回数を表しています。Q: 設定メニューに表示される「反復回数」や「試行回数」を減らすことでどのような効果を期待できますか?
一般的に試行回数や反復回数を増やすことで、ランダム性を減らすことができ、安定した結果が得られる可能性が高まることになります。 一方で試行回数や反復回数には答えがあるわけではないため、得られた結果(例: それぞれの設定を変更しても結果があまり変わらない)をもとに最適なな設定を判断していくことになります。Q: クラスターマップに表示されている第1主成分、第2主成分は何を表しているのでしょうか?
クラスターマップ(バイプロット)では次元削減のアルゴリズムである主成分分析(PCA)というものを使っており、複数の変数を2つの次元で表した時にどれだけの情報量(ばらつき)を表現できているかが第1主成分と第2主成分からわかります。 例えば、下記は10列使用してK-meansクラスタリングを実行したものとなりますが、第1主成分で52.9%、第2主成分で23.9%と2つ合わせて全ての変数のばらつきの76.8% を表現できていると捉えることができます。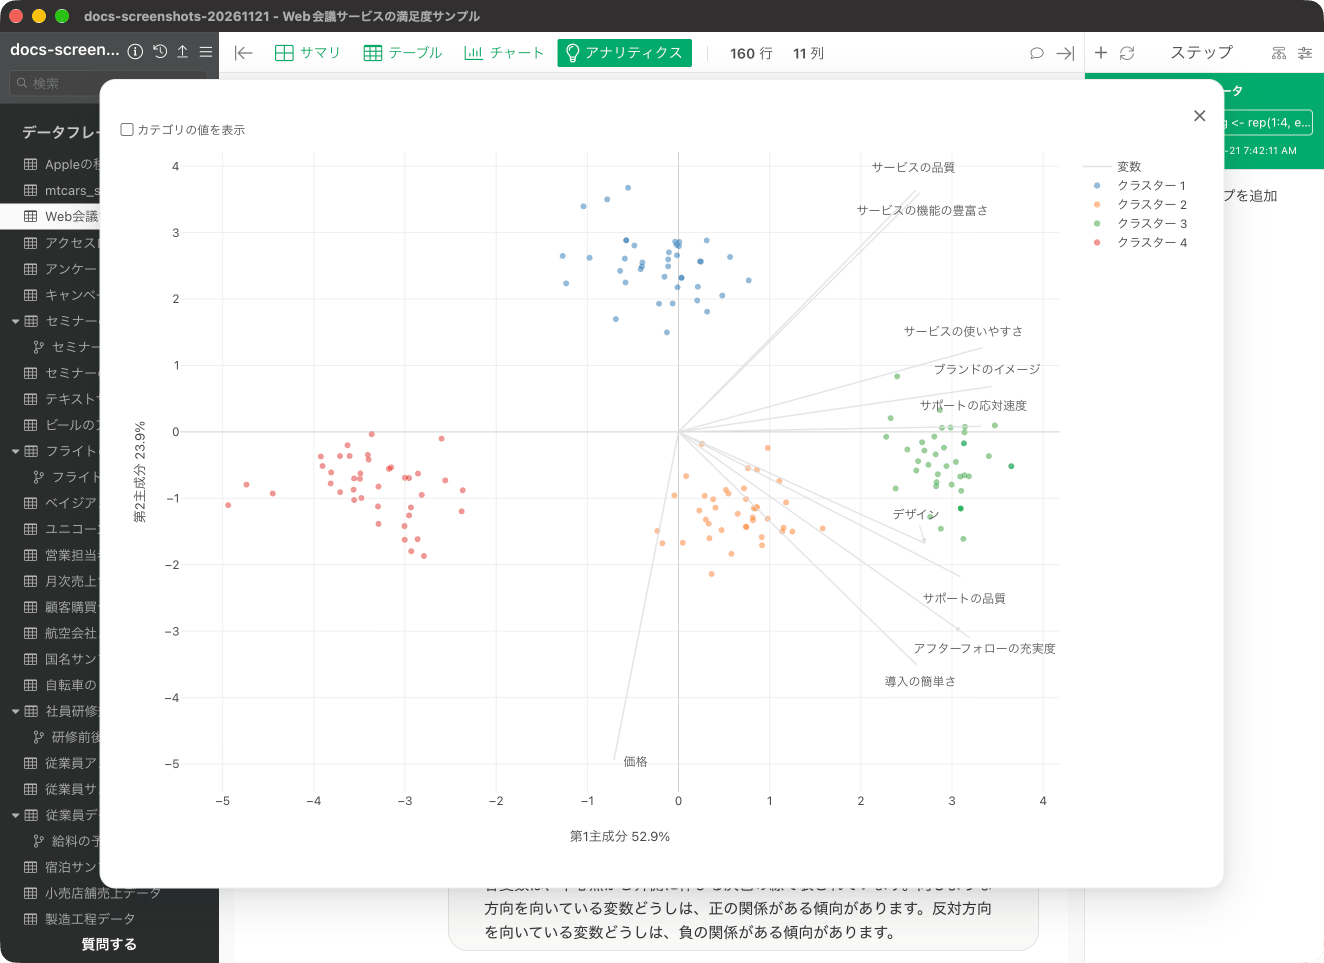
Q: クラスターマップに表示される変数の軸線はどのように決まっていますか?
前述の「クラスターマップに表示されている第1主成分、第2主成分は何を表しているのでしょうか?」と関連していますが、それぞれの変数の軸線は、主成分分析で求めた、その変数と第1主成分・第2主成分との関係をもとに位置が決まっています。 下の画像は、レポートの「クラスターマップ」とその説明文です。画面には、元のデータにあるばらつきのうち、第1主成分が53%、第2主成分が24%を説明すると表示されています。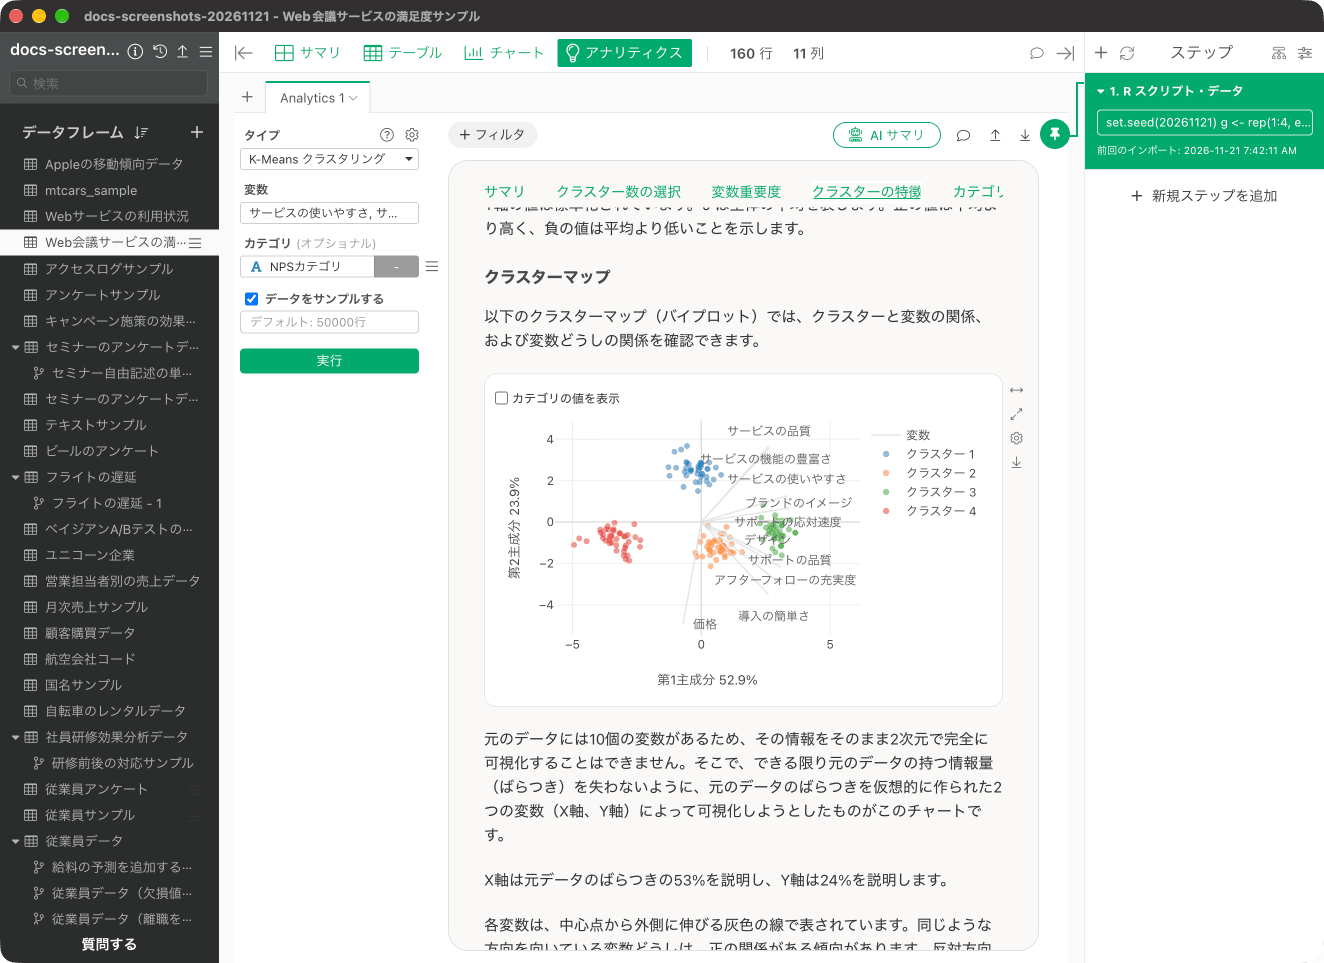
Q: クラスターマップのデータをエクスポートしたときの、それぞれのデータは何を表すのでしょうか?
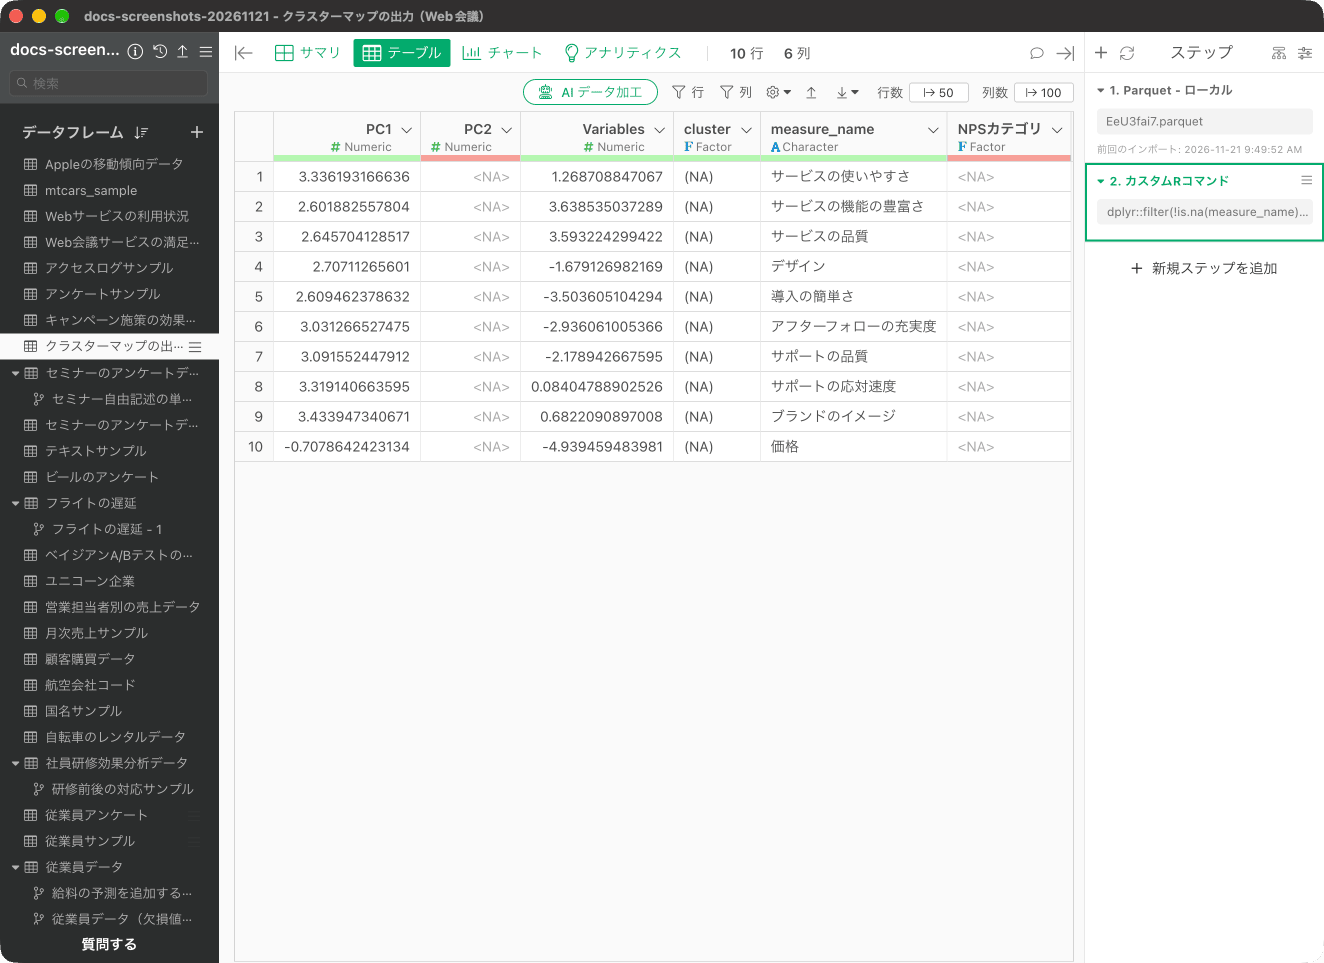
「チャートのエクスポート」から「新規データフレームとして保存」でクラスターマップのデータを保存すると、次のような180行・6列のテーブルになります。回答160行に、軸線の起点・終点にあたる20行が加わっています。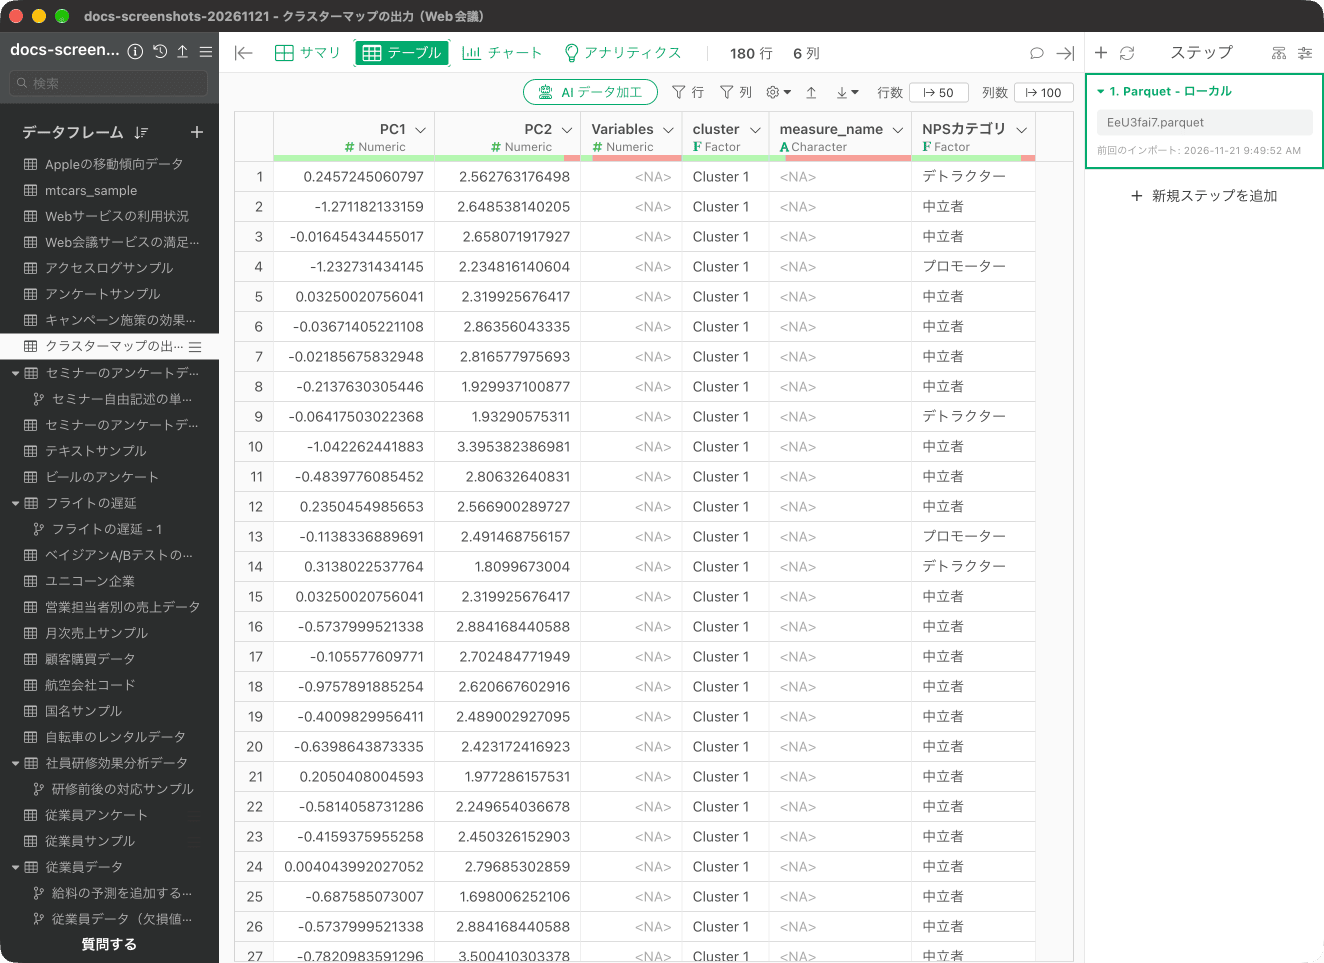
dplyr::filter(!is.na(measure_name), PC1 != 0 | Variables != 0) のステップで、軸線の終点にあたる10行だけを表示したものです。