何ができるか
ロジスティック回帰を使うと、次の質問に答えられます。- このデータ(説明変数)を使うことで、目的変数(例:コンバージョン)のTRUE/FALSEをどれだけうまく分けられているか。
- どの変数が目的変数を予測するうえで重要か。
- 変数の値が変わると、目的変数の値はどのように変わるか。
- その説明変数は、目的変数の変化を説明するうえで有意と言えるか。
- 他の変数が一定のとき、変数の値が1上がると、目的変数の値はどれだけ上がる(または下がる)か。
必要なデータ
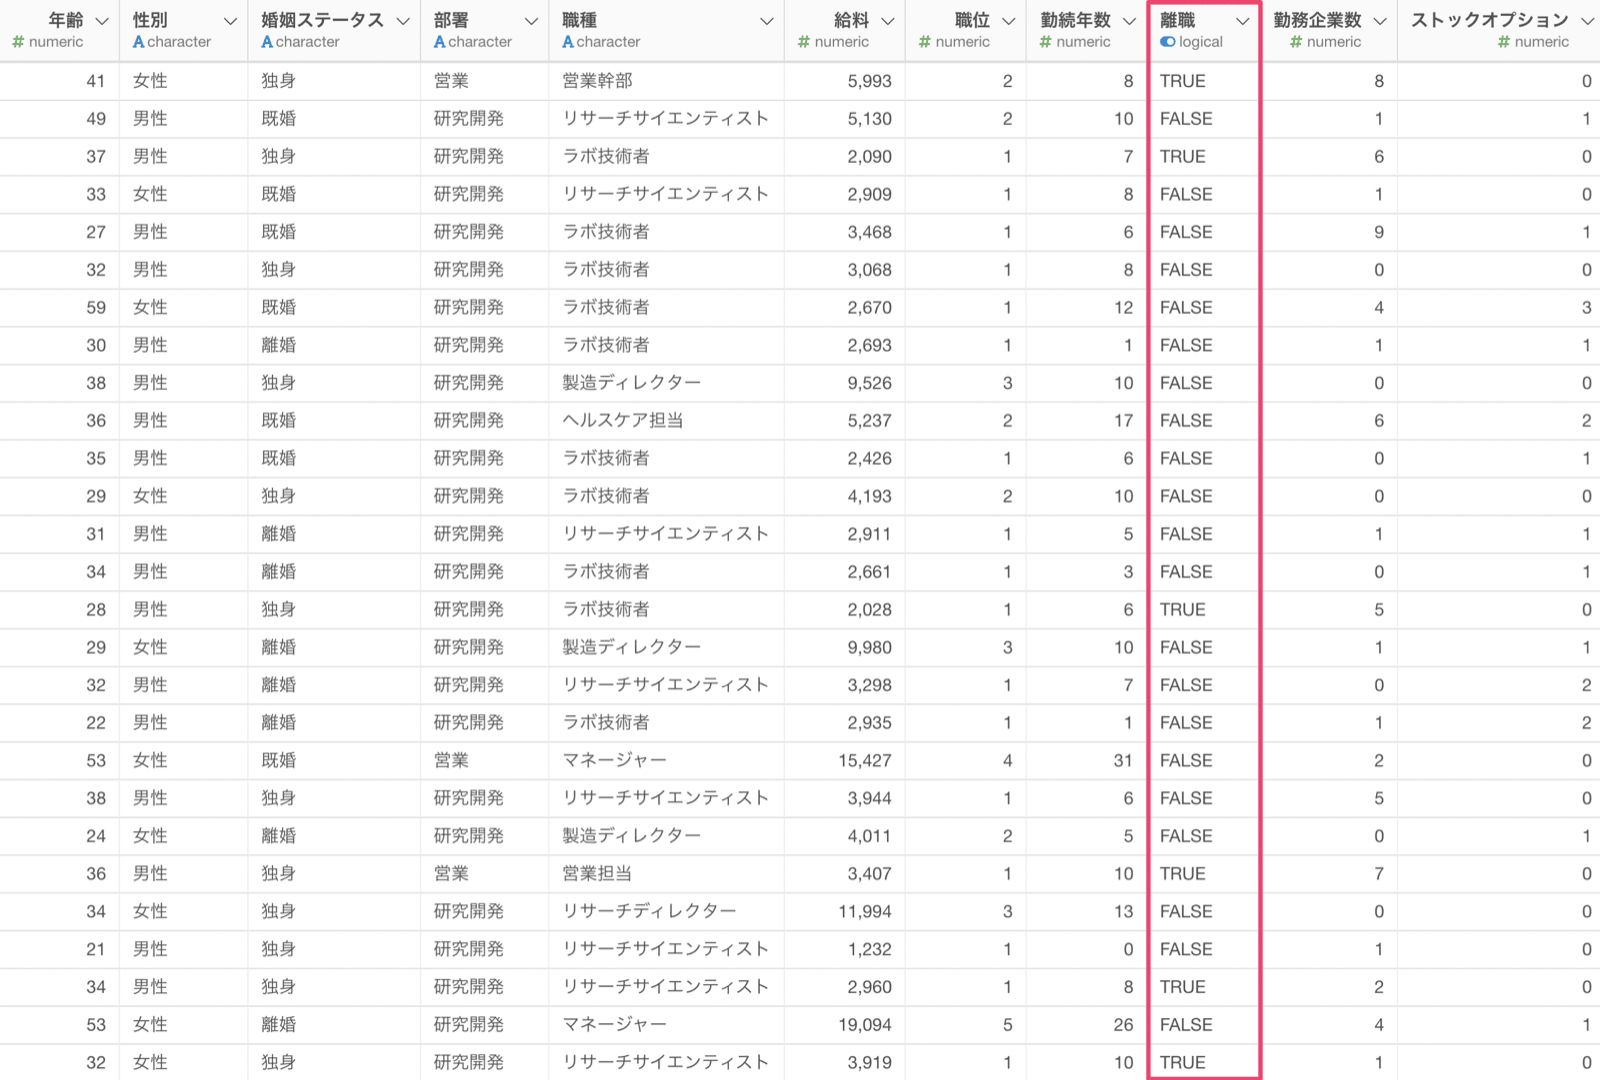
ロジスティック回帰を作成するためには、1行が1観察対象(例:1行が1従業員)となっているデータが必要です。 また、目的変数として使用できるデータタイプはTRUE/FALSEの二値をとる「ロジカル型」の列で、説明変数におけるデータタイプには特に縛りはありません。しかし、ロジスティック回帰などの統計系のモデル作成時には、説明変数どうしの相関があまりにも強い時に発生する「多重共線性」などの問題を考慮する必要があります。 もし、目的変数にしたい列のデータタイプがロジカル型になっていない場合、こちらのノートを参考にロジカル型に変更してからロジスティック回帰のモデルを作成ください。サンプルデータ
今回はサンプルデータとして、従業員データを使用していきます。 このデータは1行が1従業員のデータで、列には年齢や職種、離職など従業員の属性を表す列があります。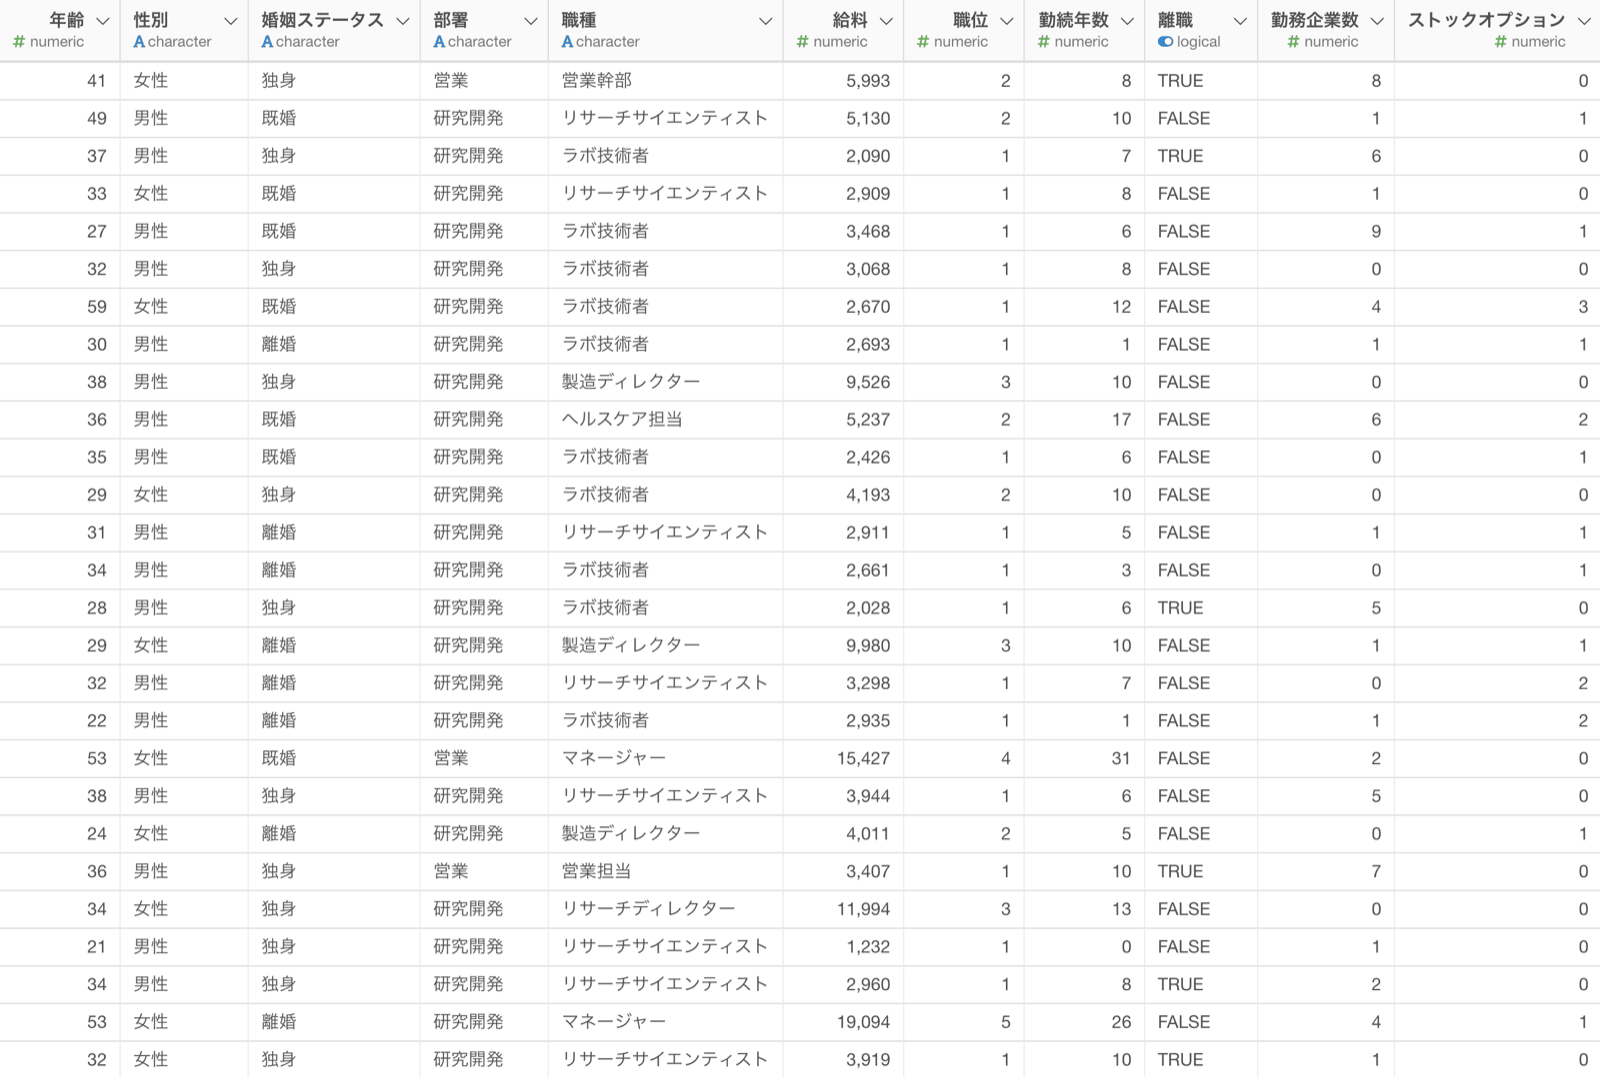
ロジスティック回帰のモデルを作成する
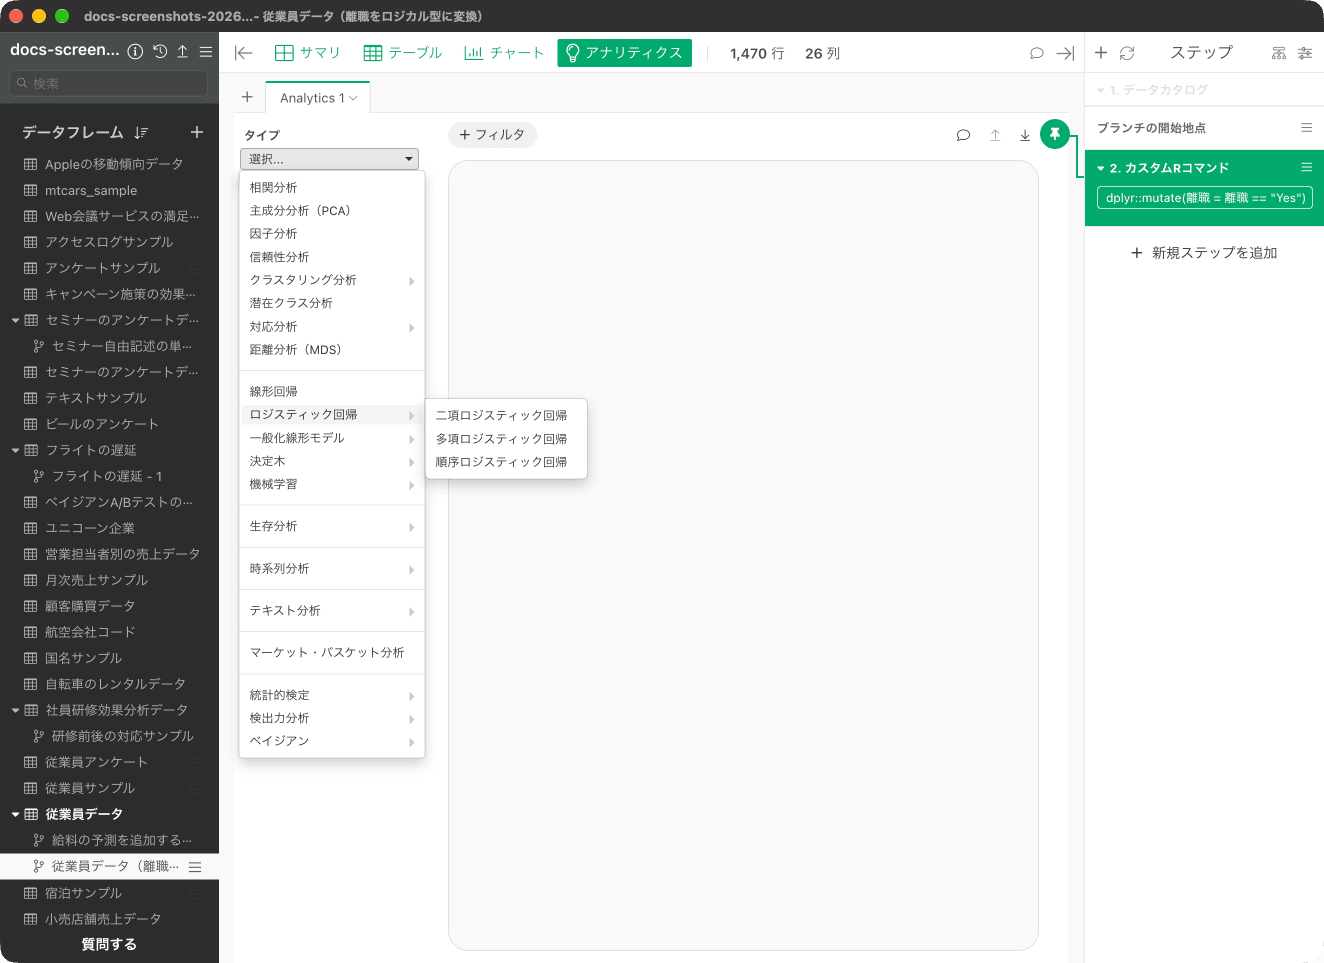
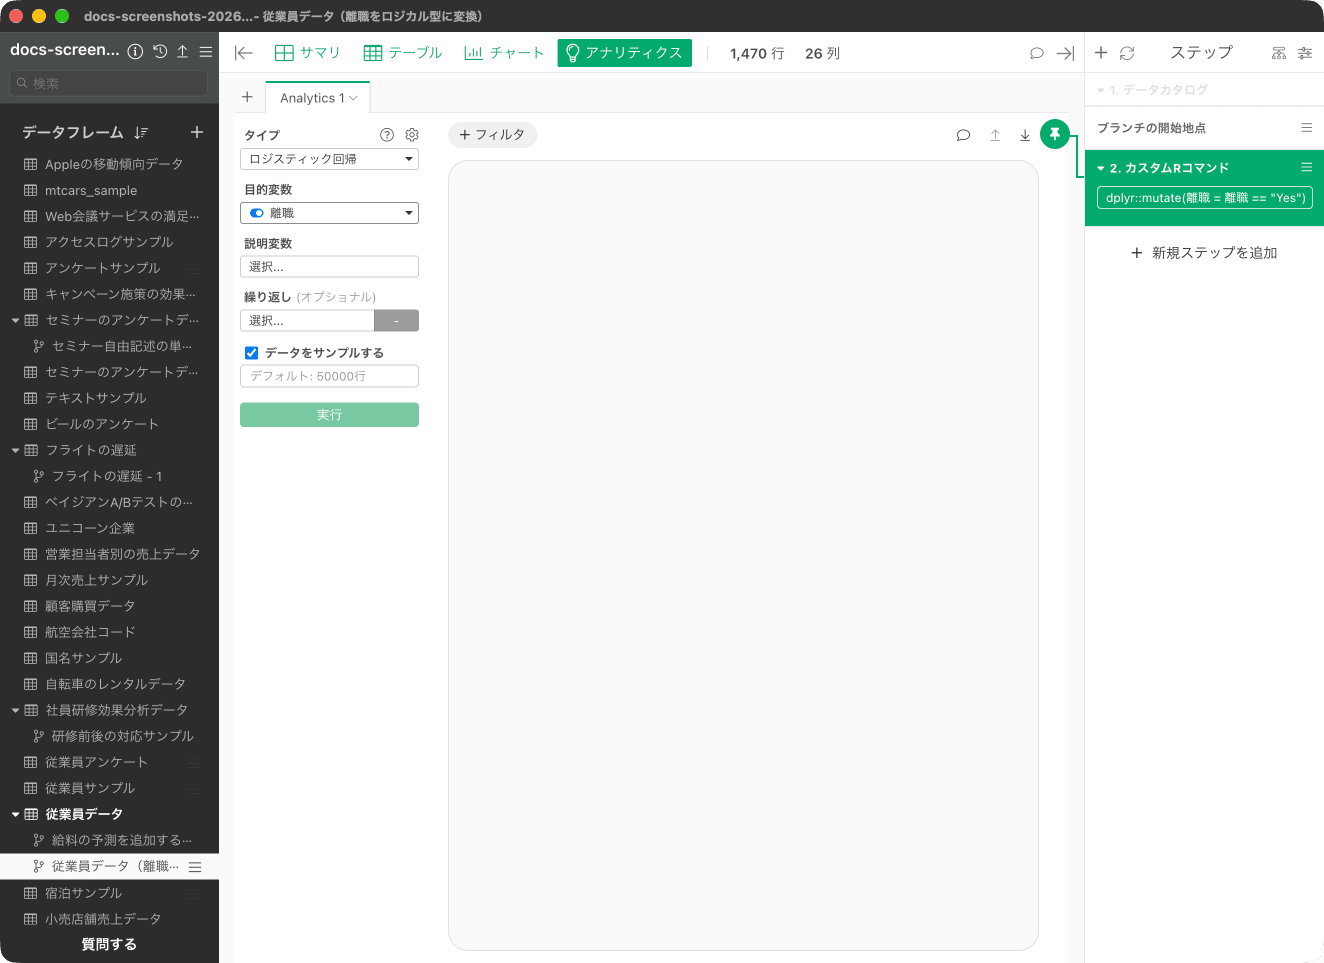
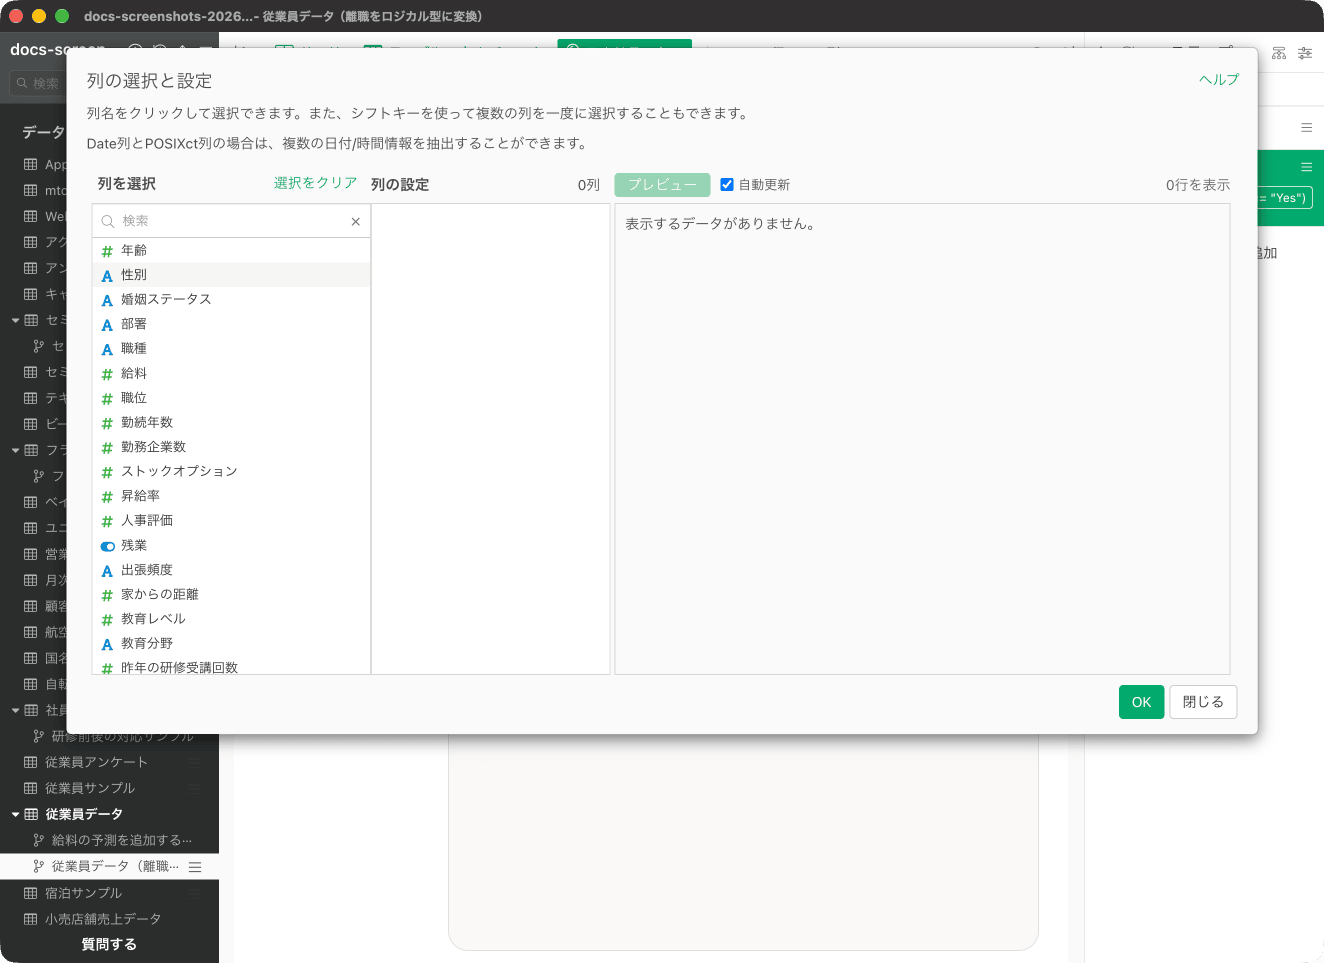
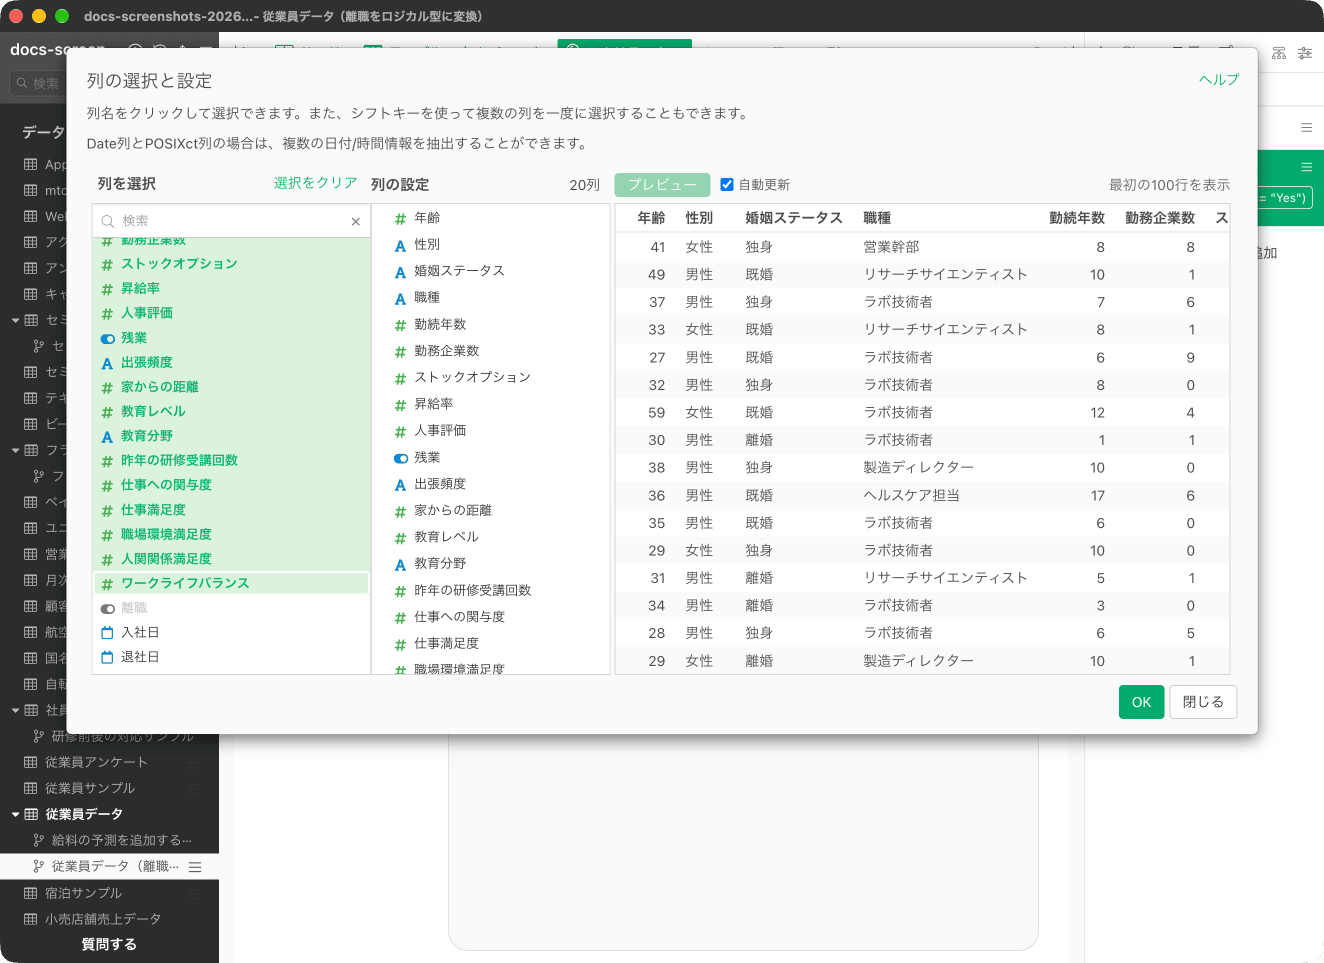
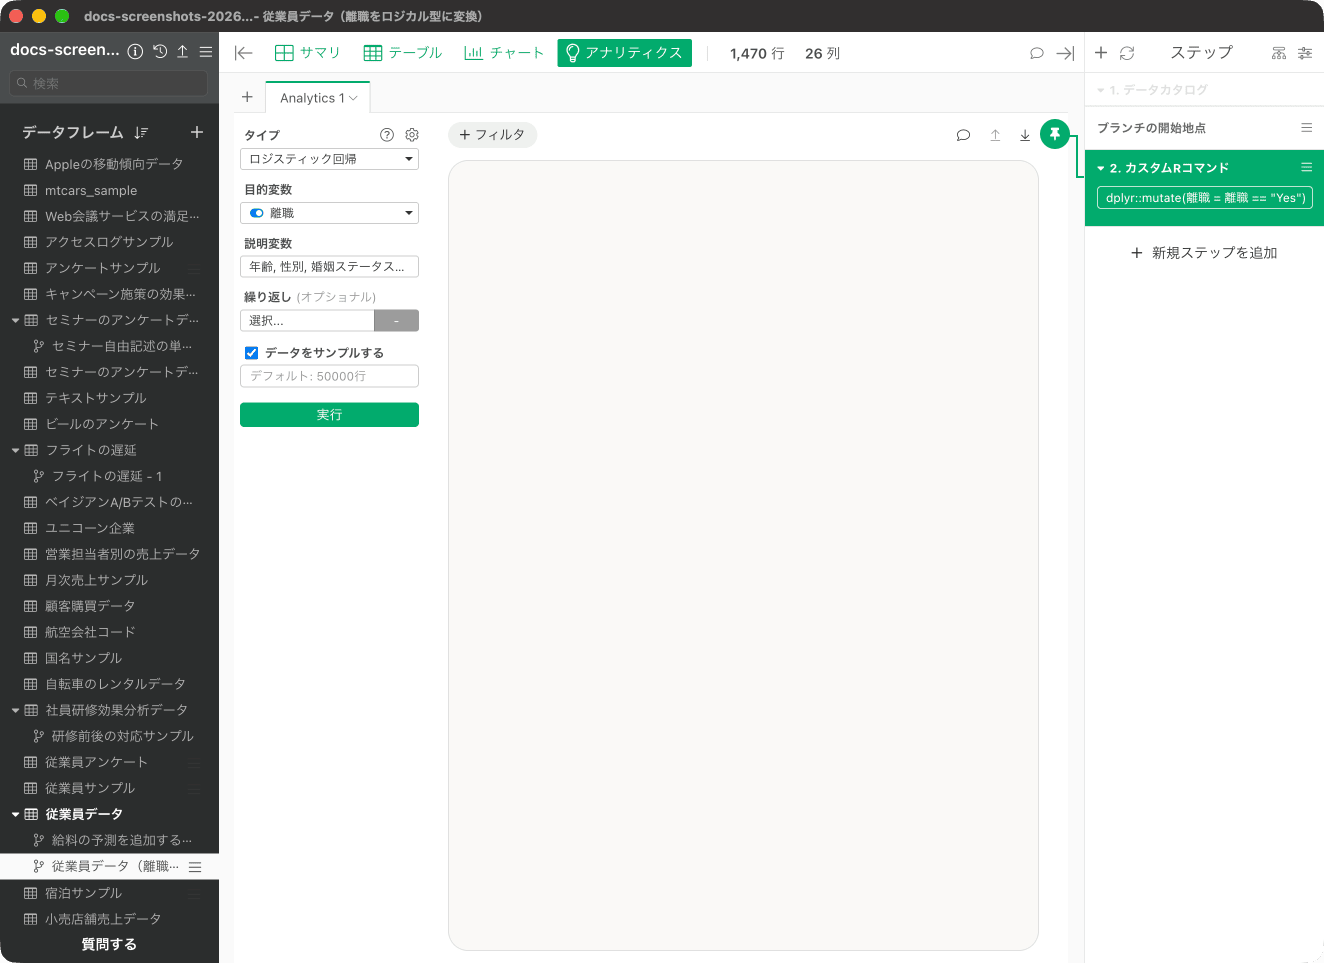
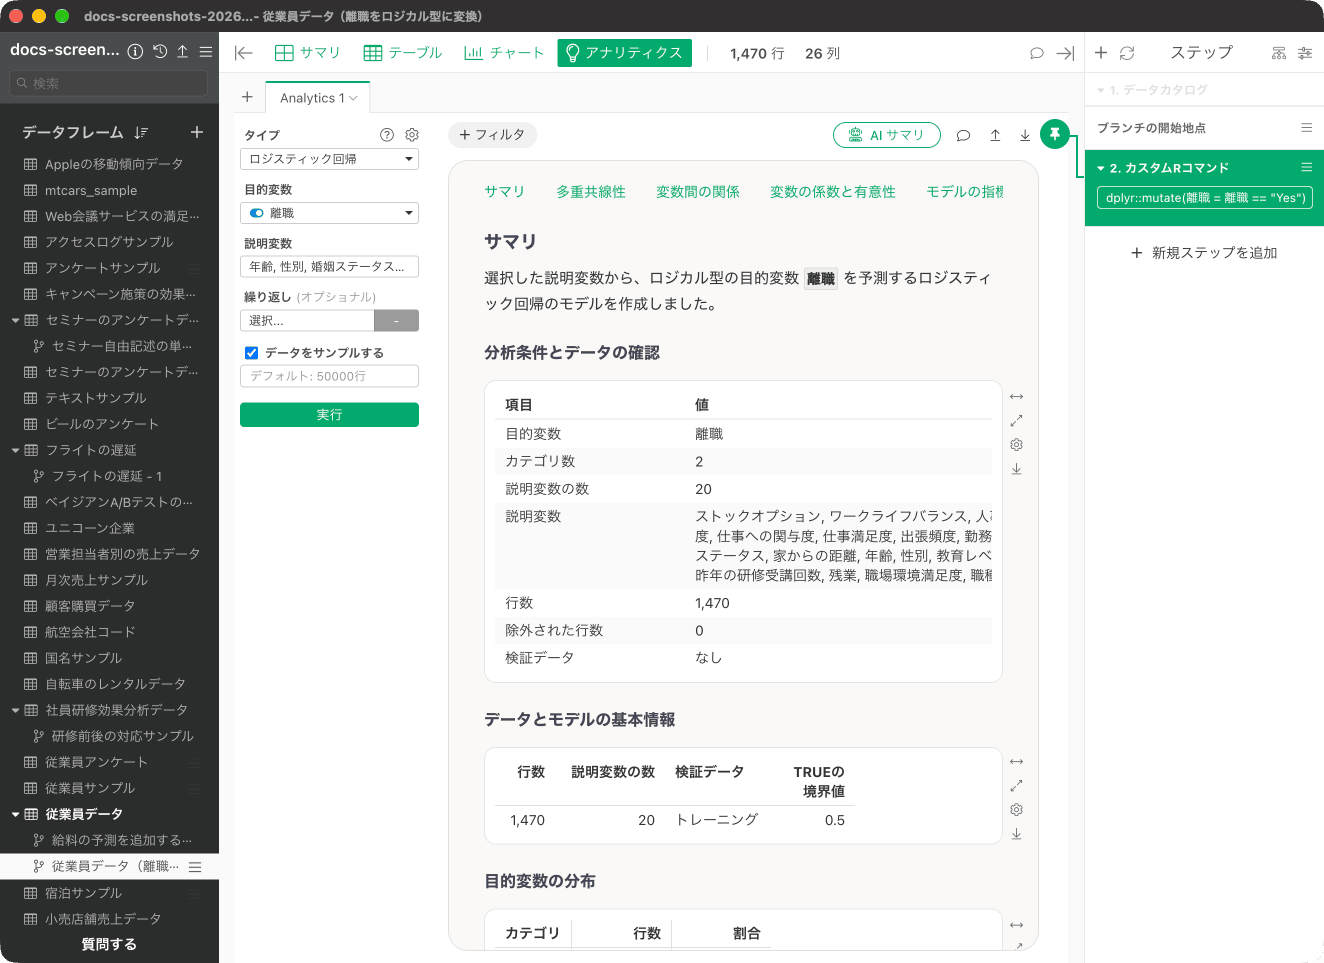
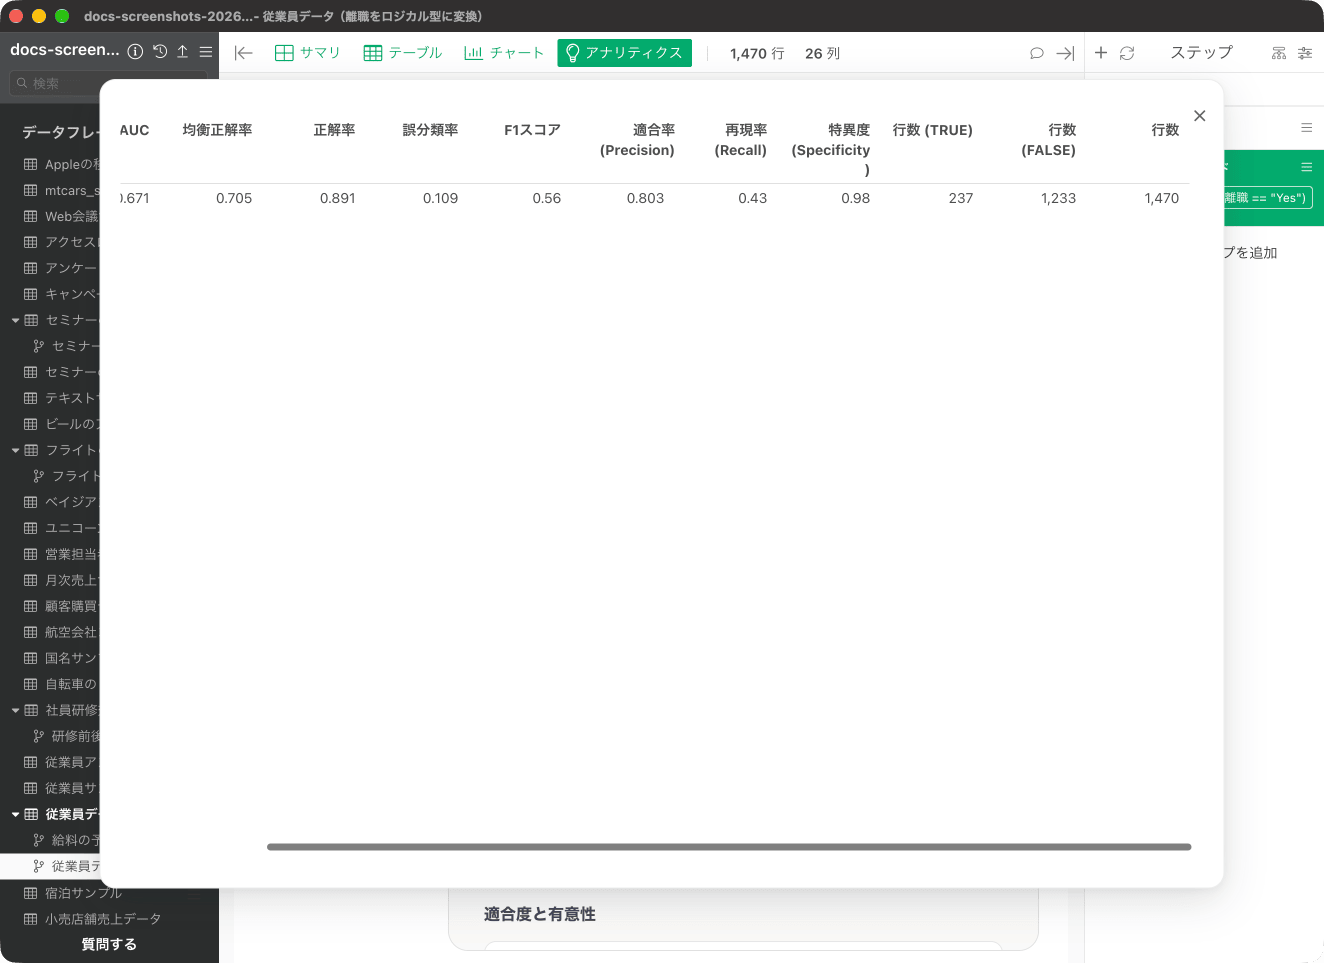
今回は従業員が「離職」しているかどうかを予測するロジスティック回帰のモデルを作成します。 元の従業員データでは「離職」が文字型の列で、そのままでは目的変数に選べません。そこで、データフレームに「カスタムRコマンド」のステップを追加し、dplyr::mutate(離職 = 離職 == "Yes") で「離職」をロジカル型に変換しています。変換後の「離職」はTRUEが237件、FALSEが1,233件です。
結果の解釈
説明変数の重要度
レポートの「変数間の関係」にある「説明変数の重要度」では、どの変数が目的変数とより相関が強いのか、予測するときにより重要なのかを調べることができます。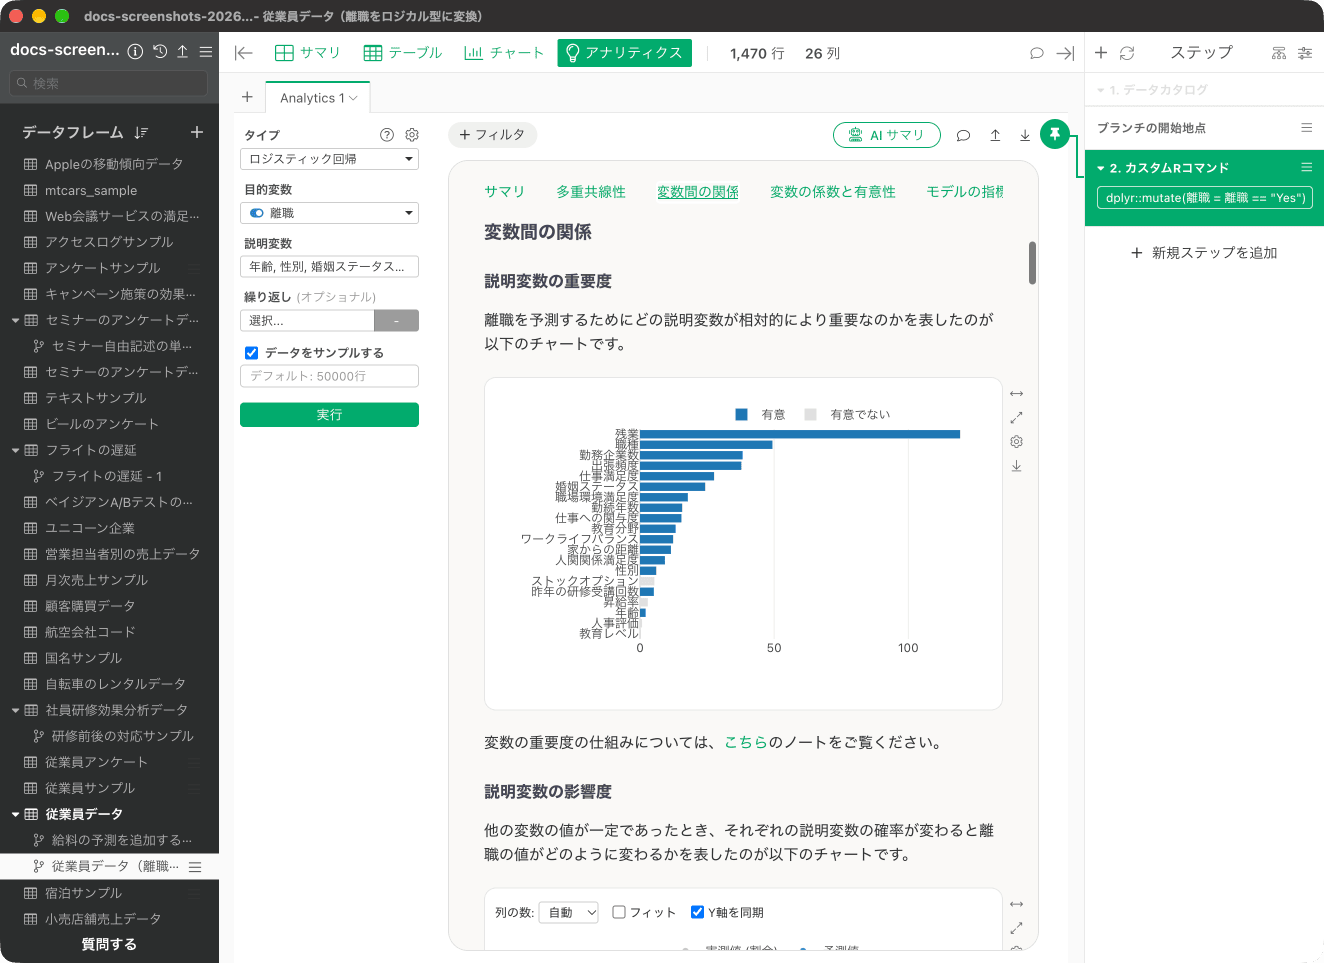
説明変数の影響度
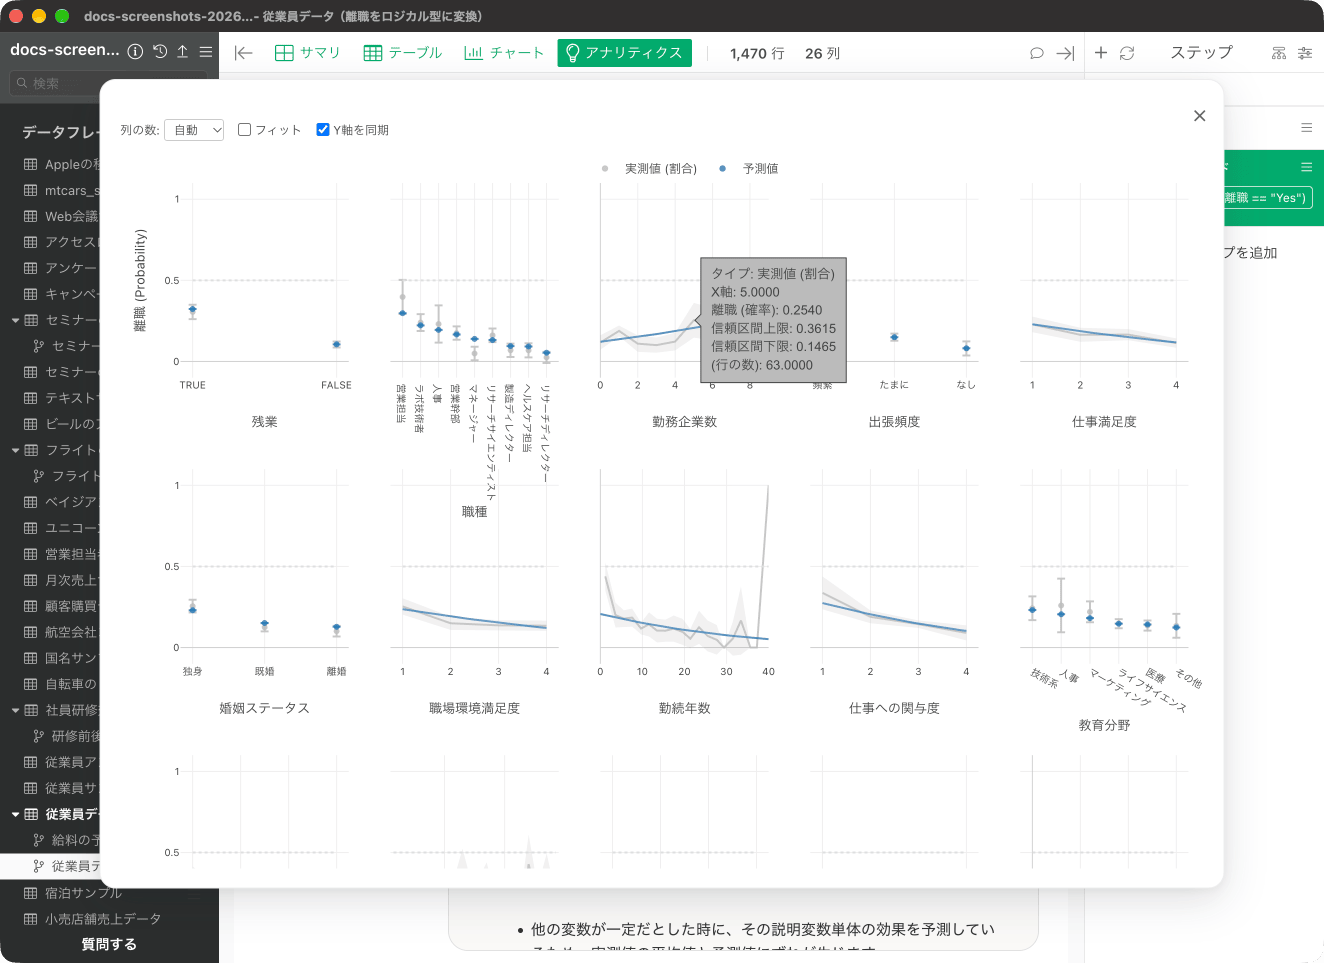
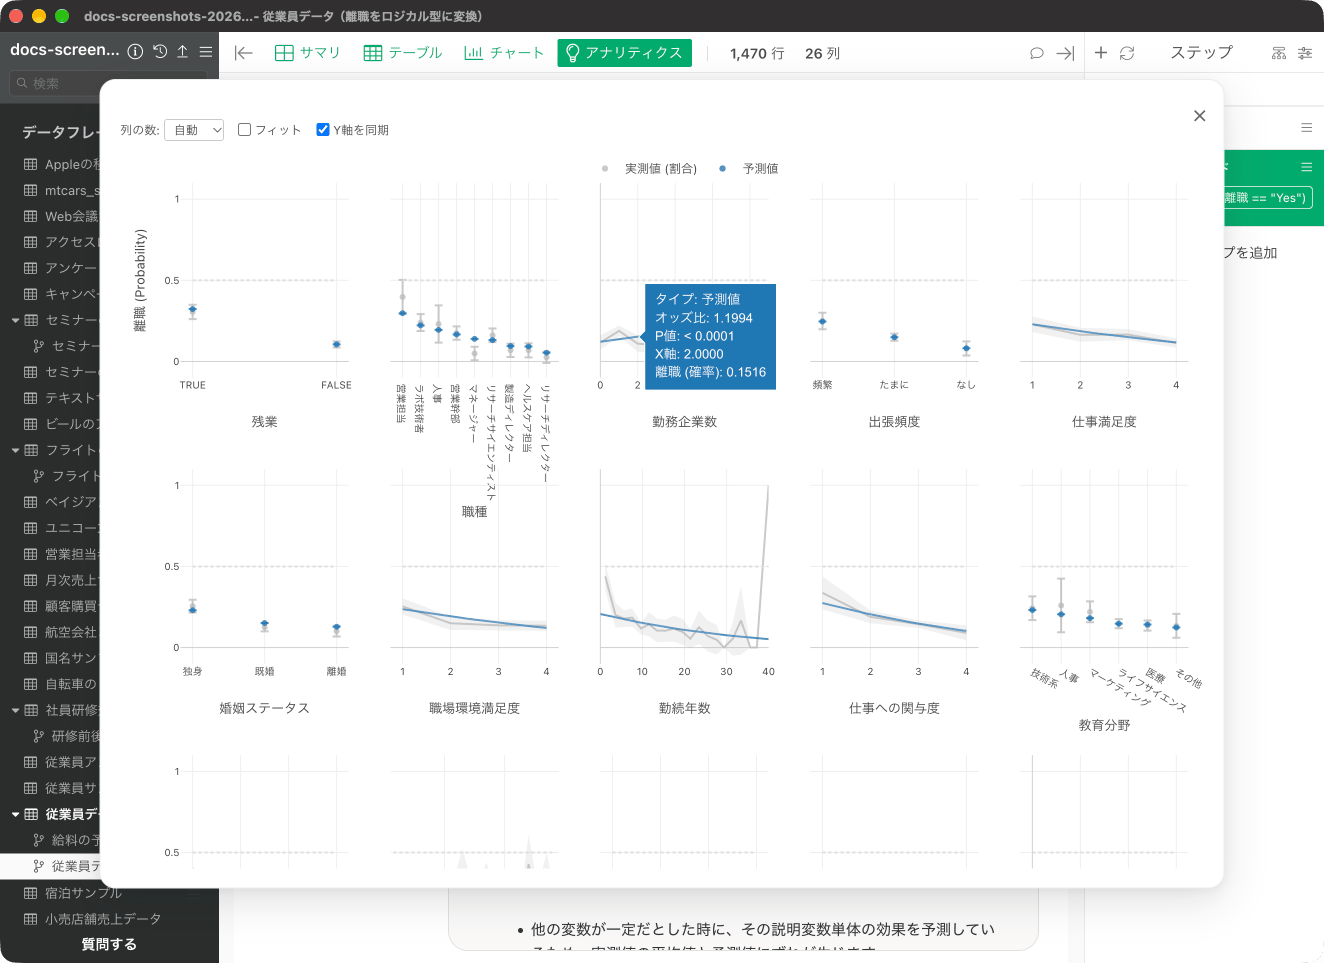
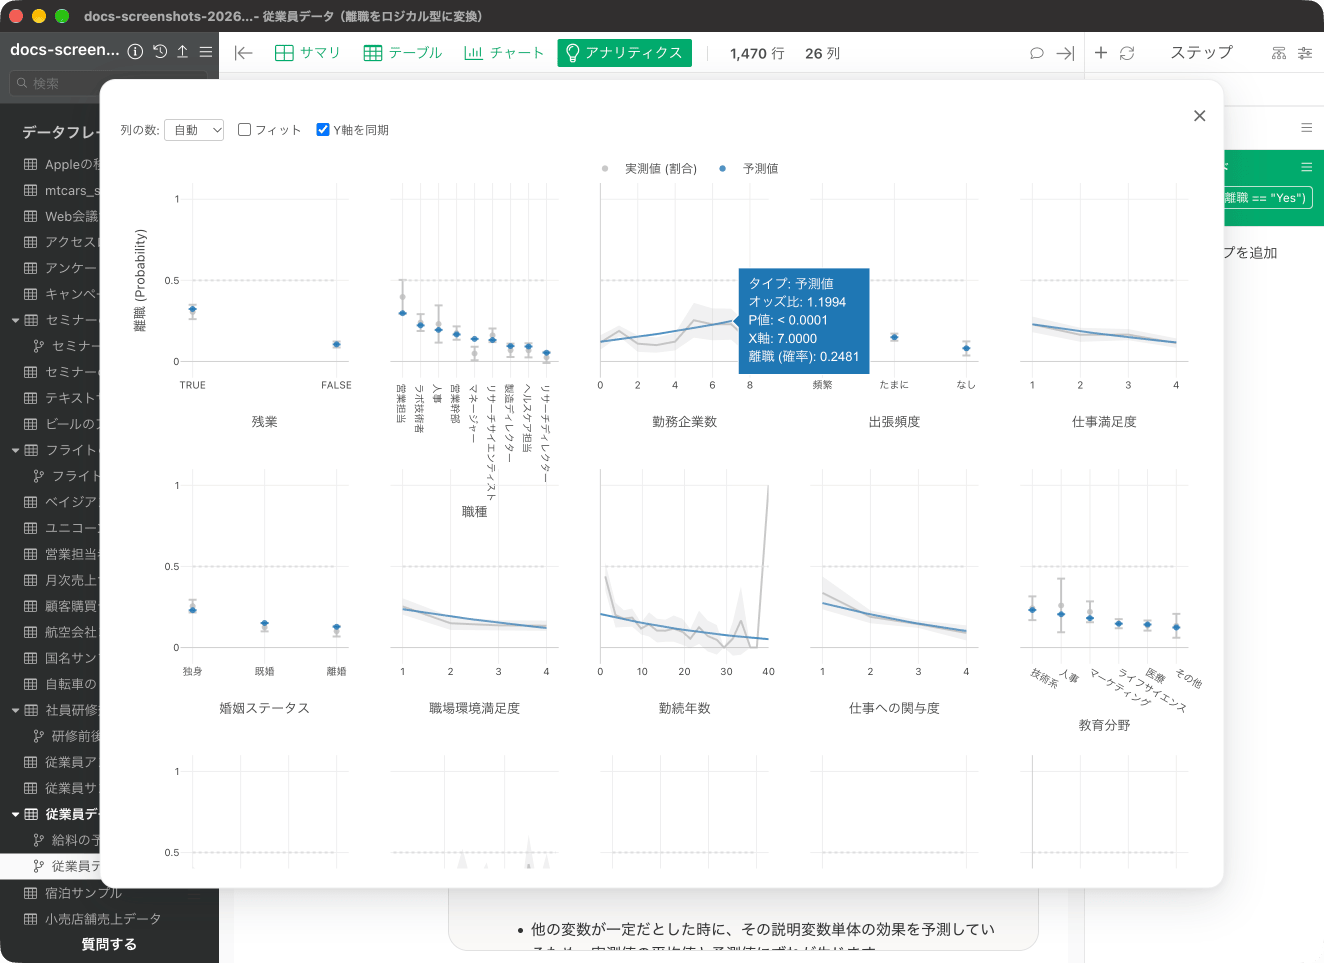
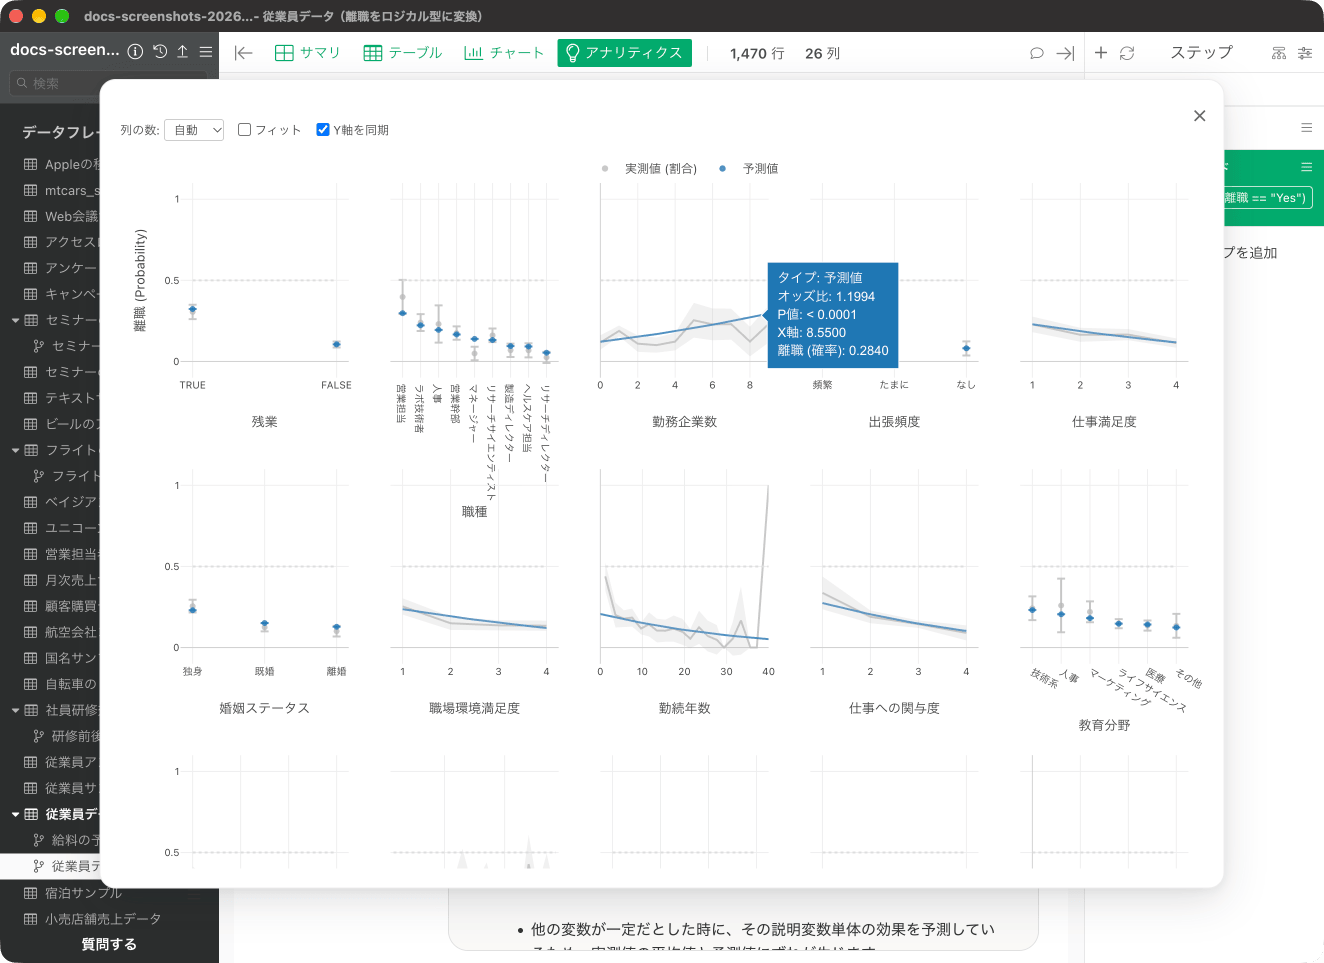
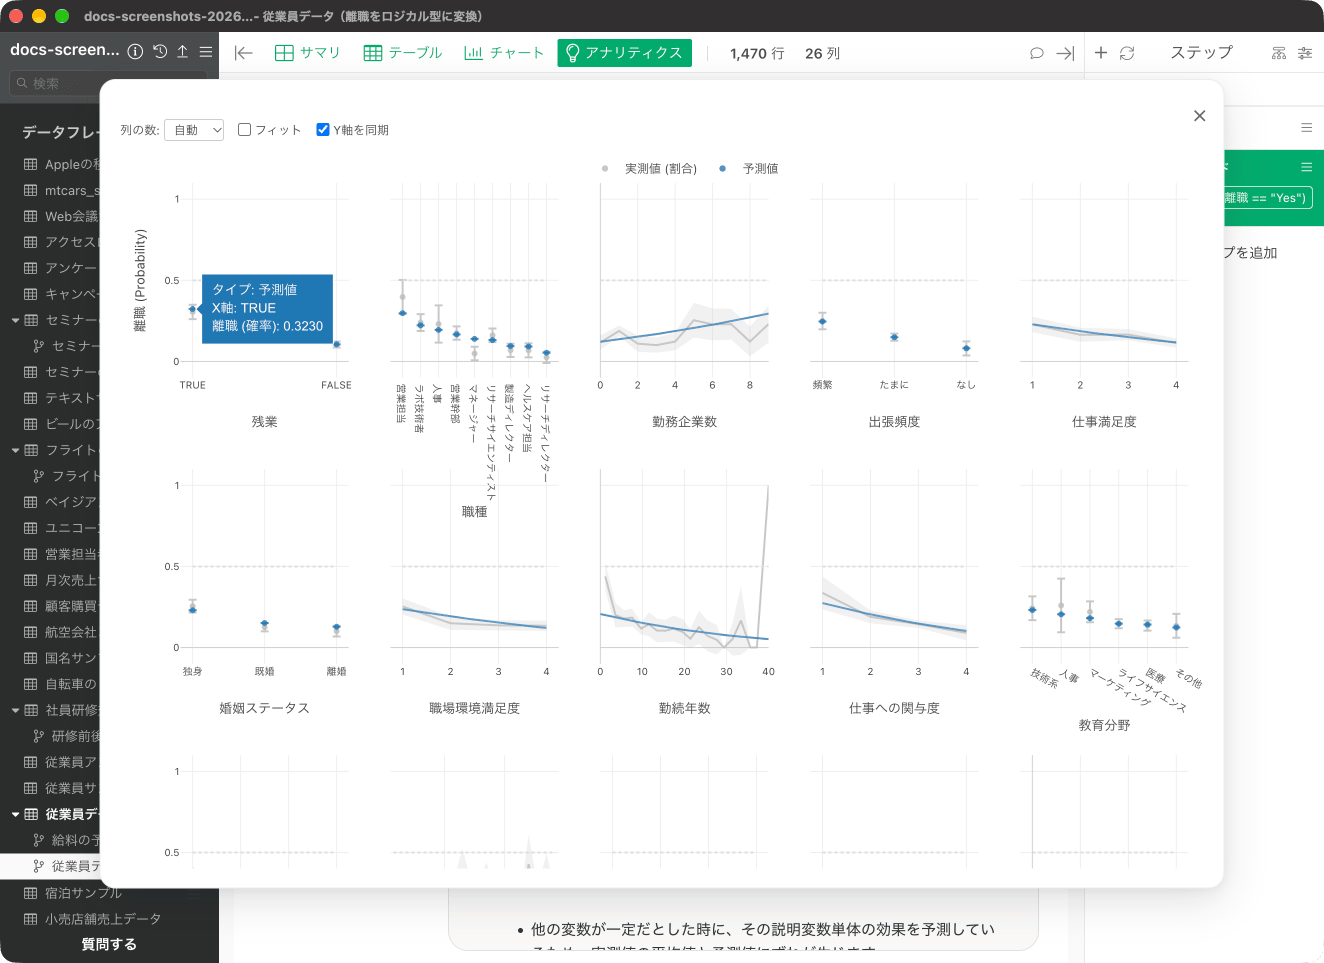
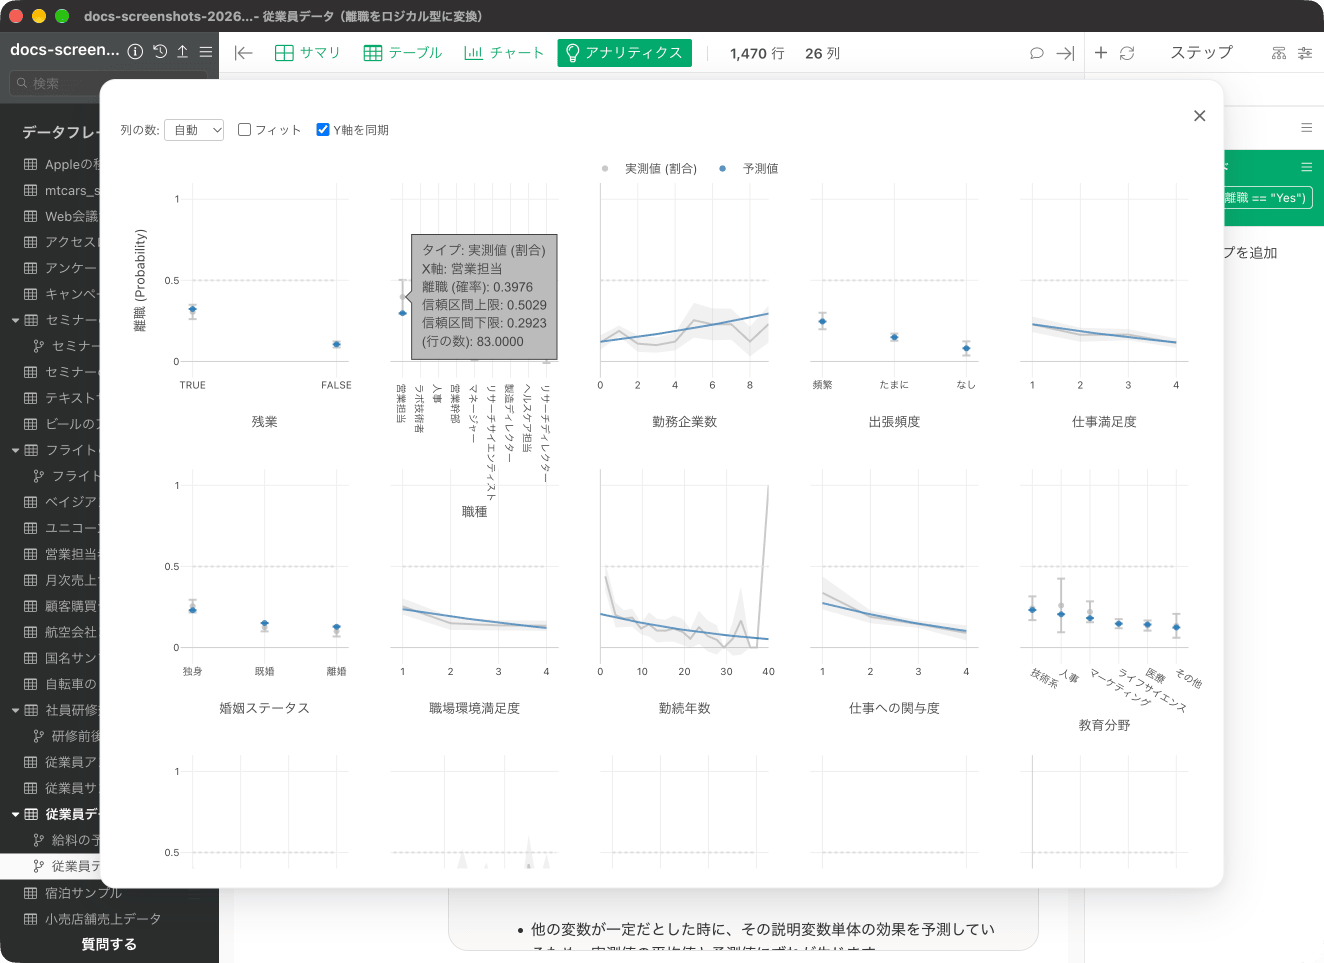
同じ「変数間の関係」にある「説明変数の影響度」では、それぞれの変数の値が変わると、離職の確率がどのように変わるのかがわかります。青い線(または点)は説明変数の値に対する予測値、グレーの線は実測値とその95%信頼区間、縦軸は離職の確率です。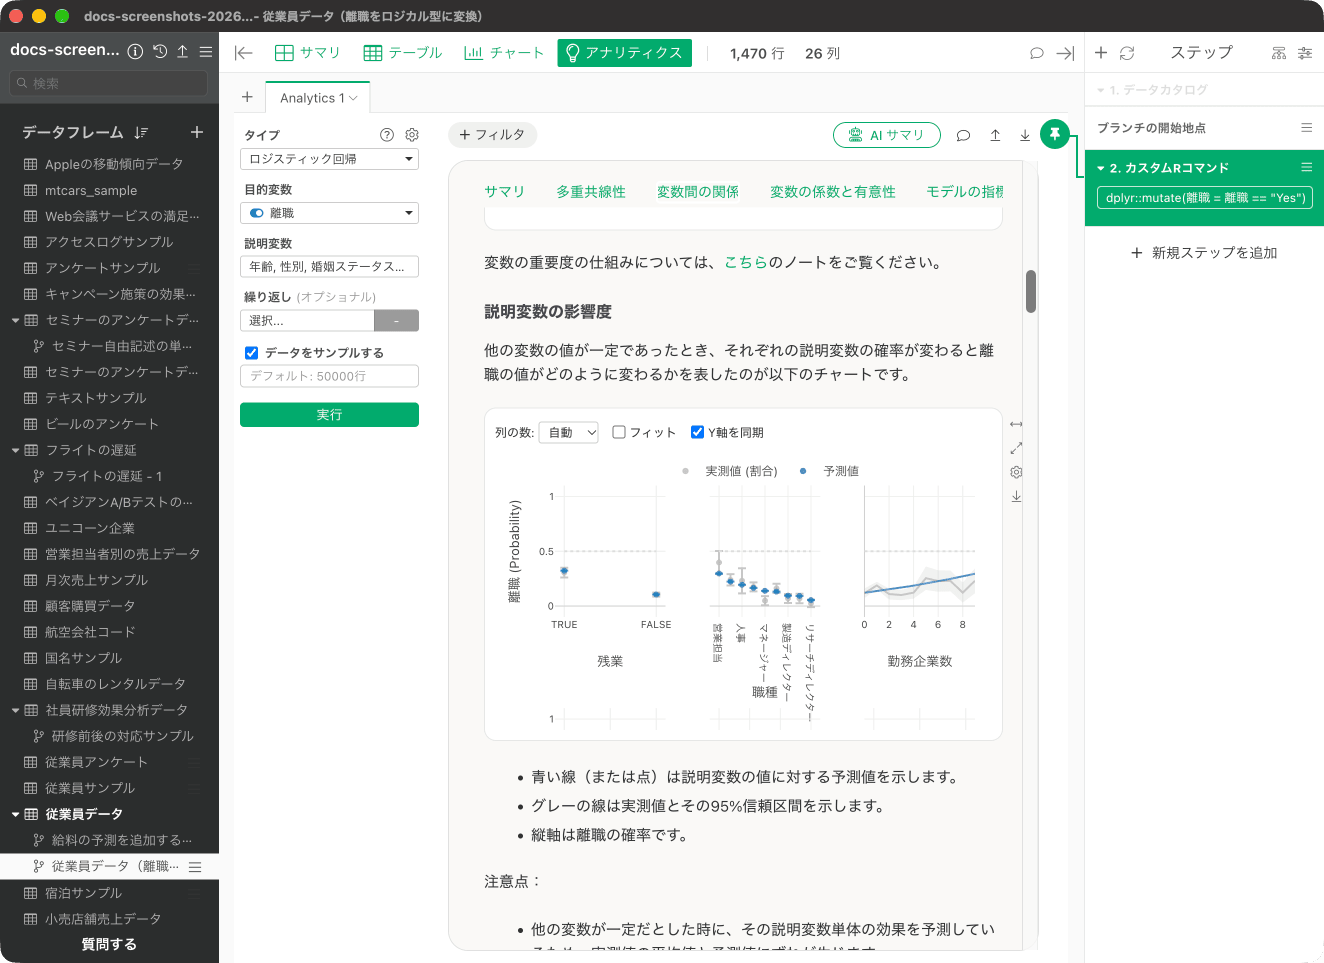
変数の係数と有意性
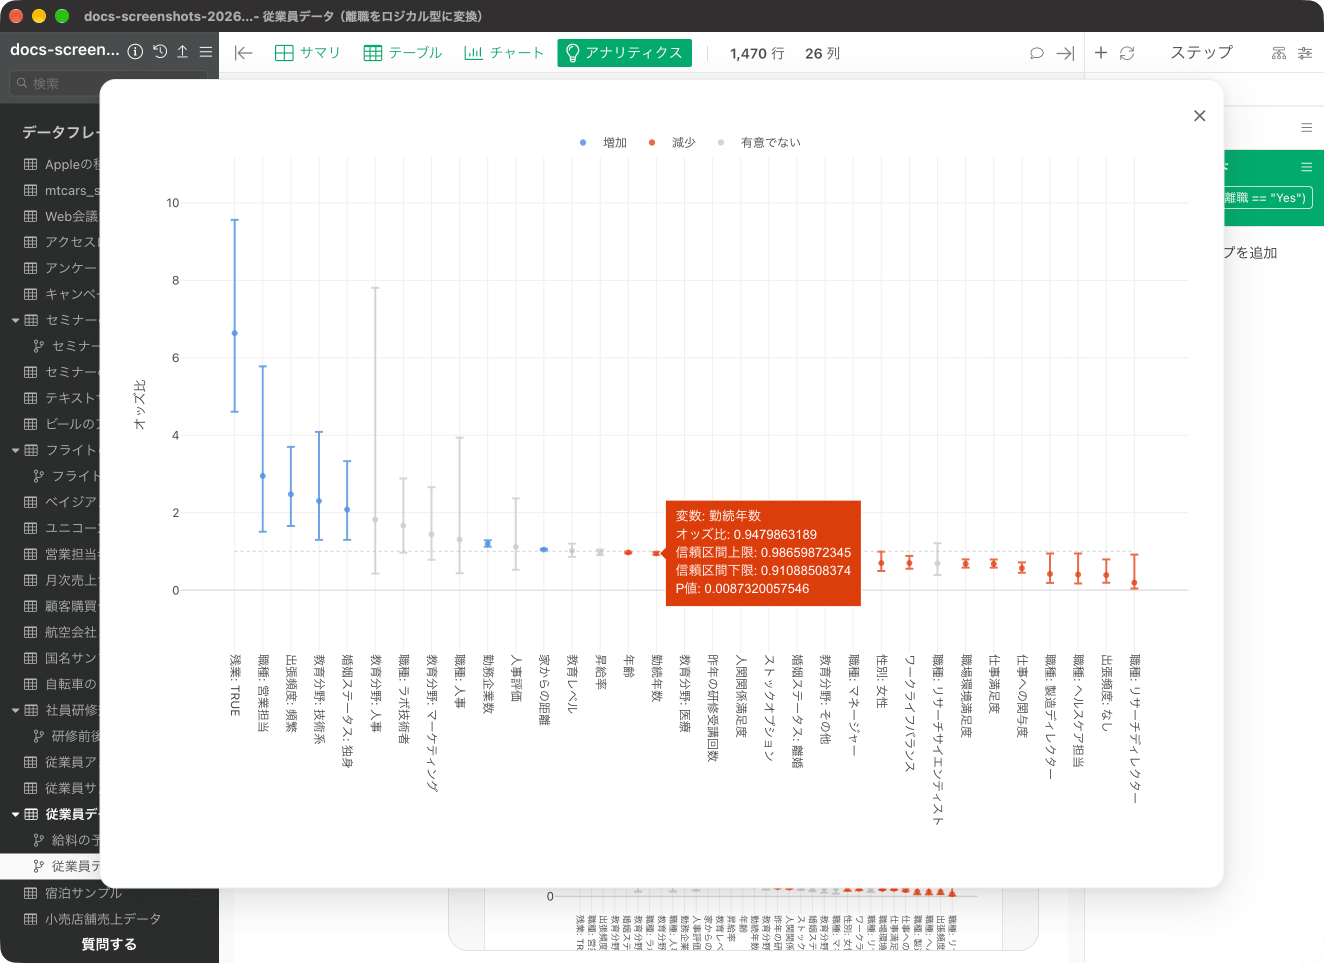
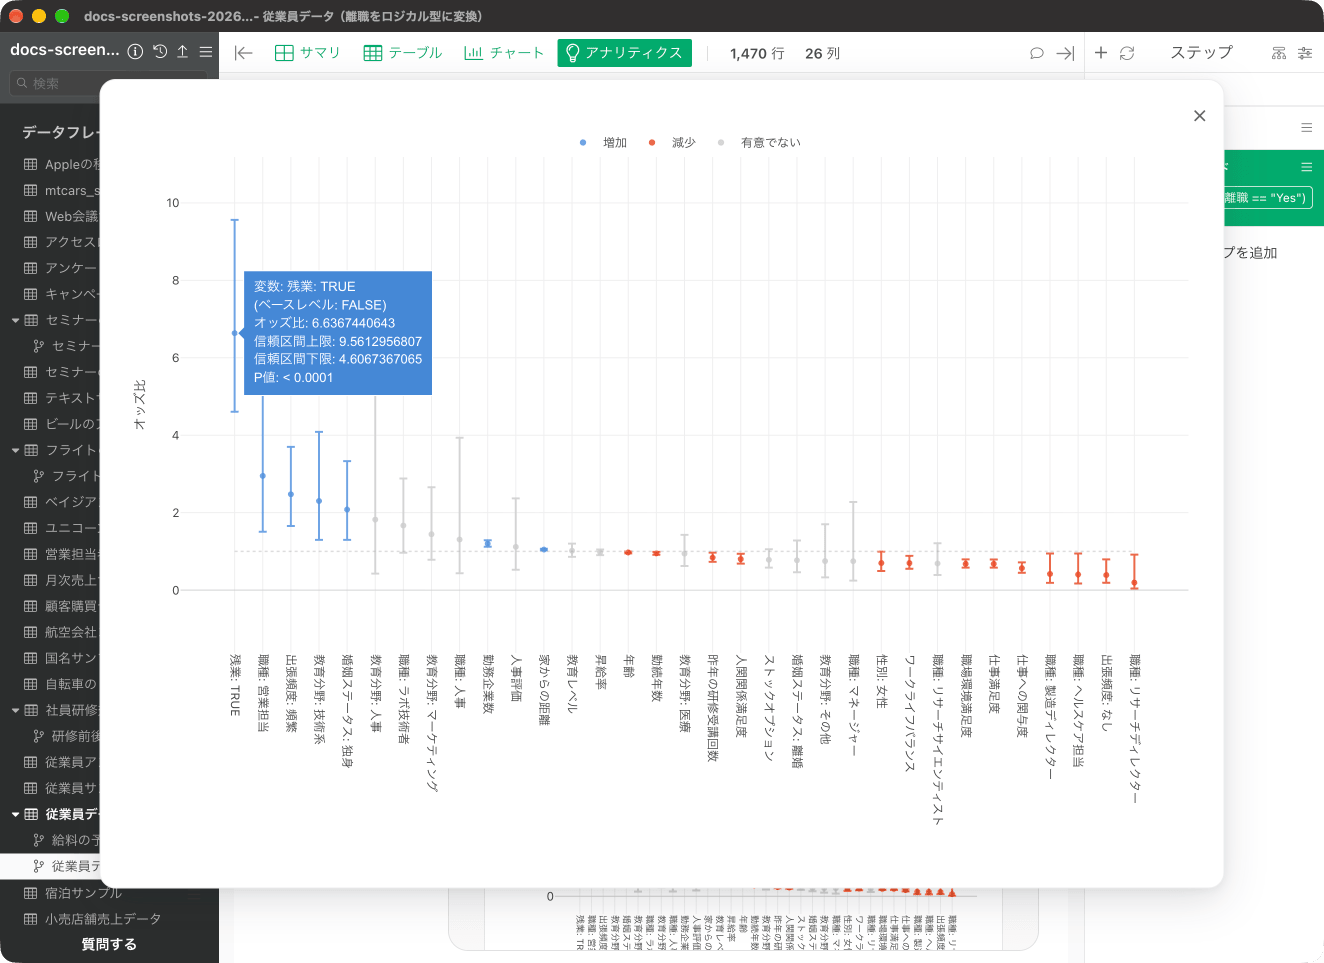
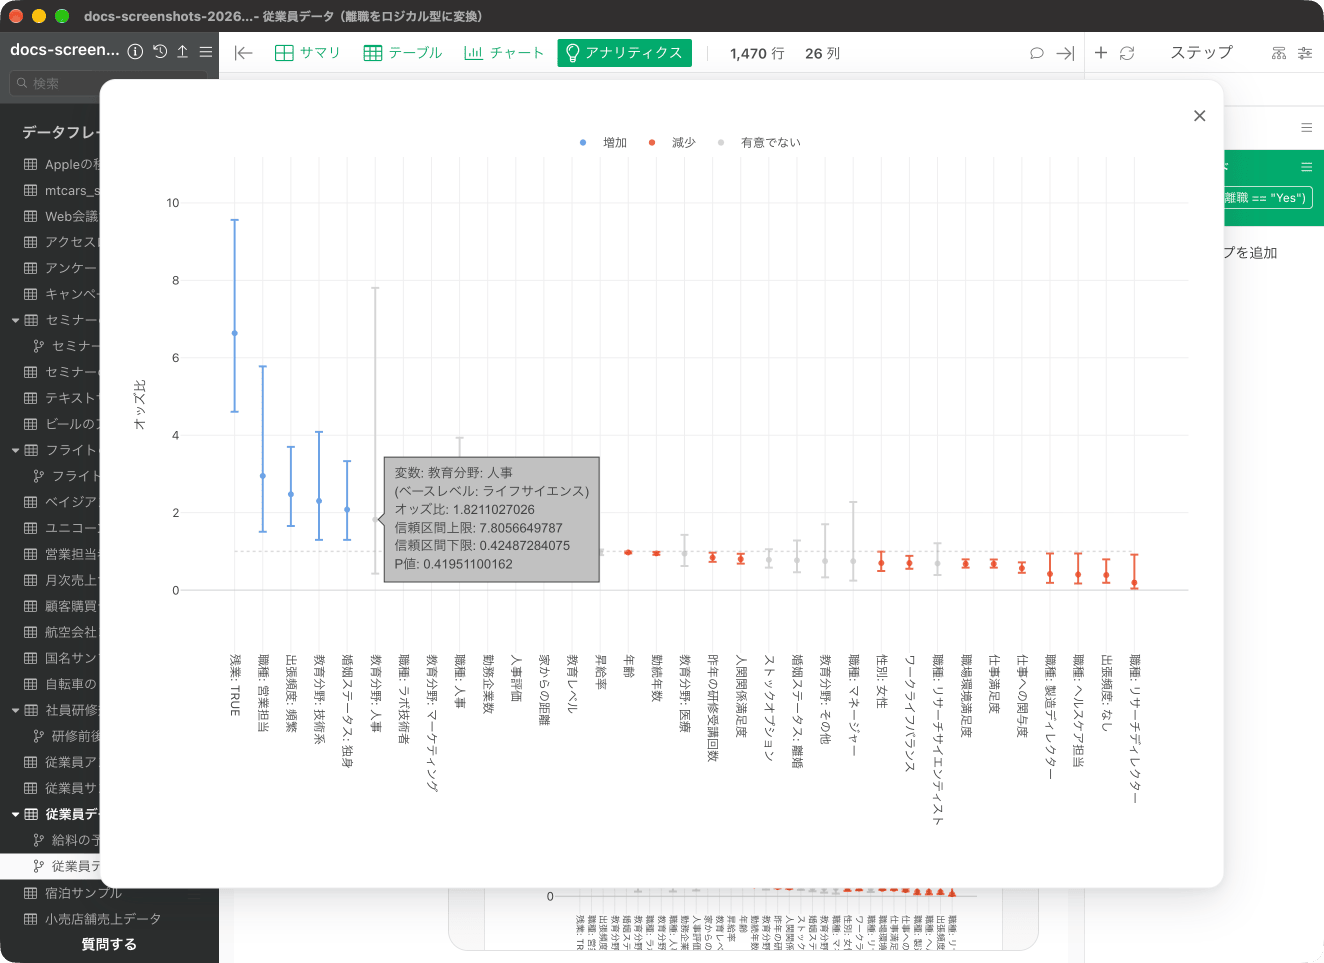
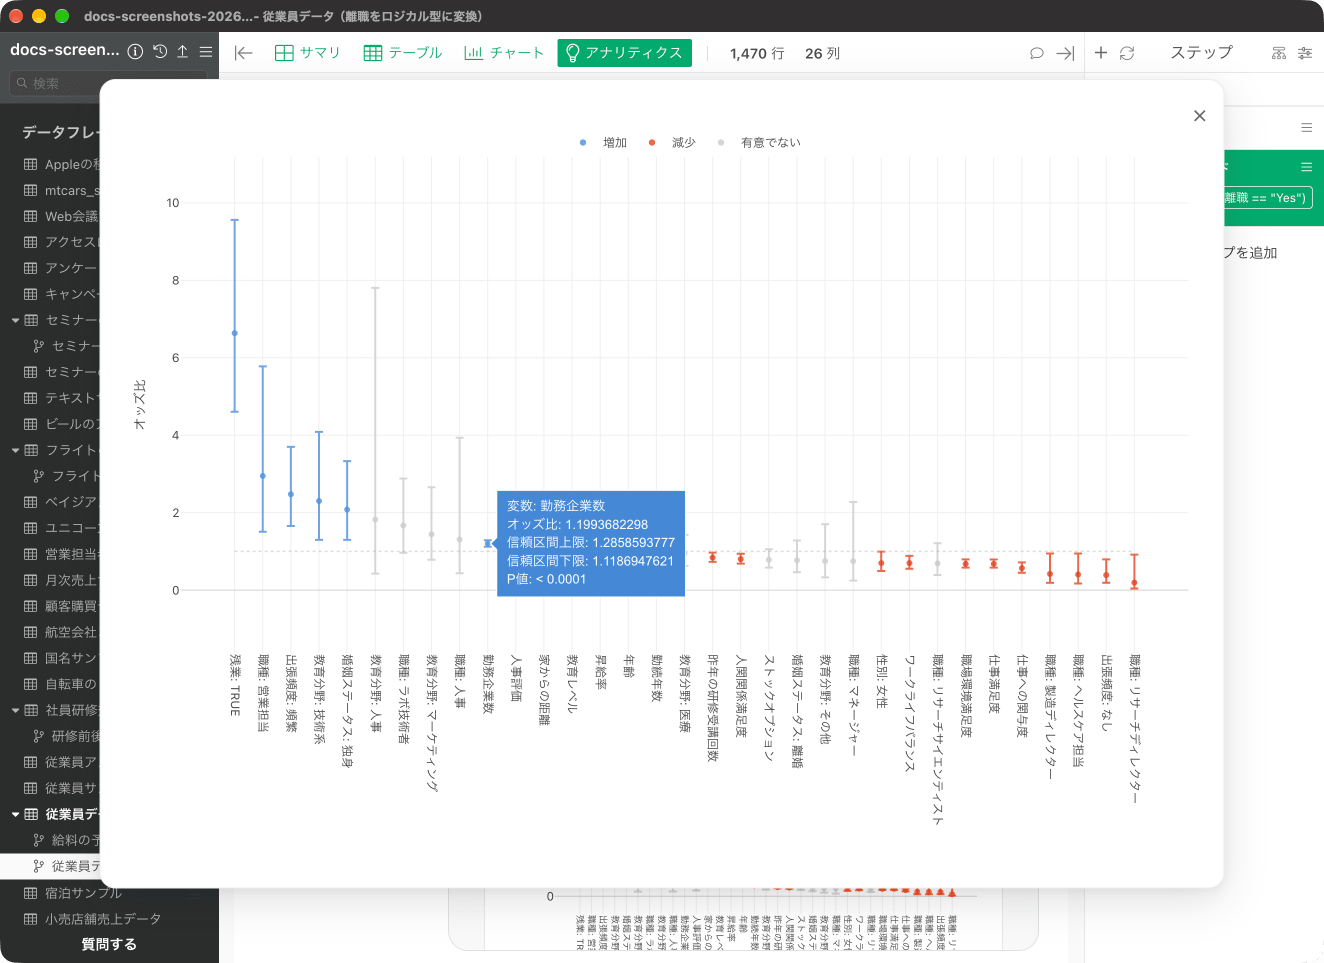
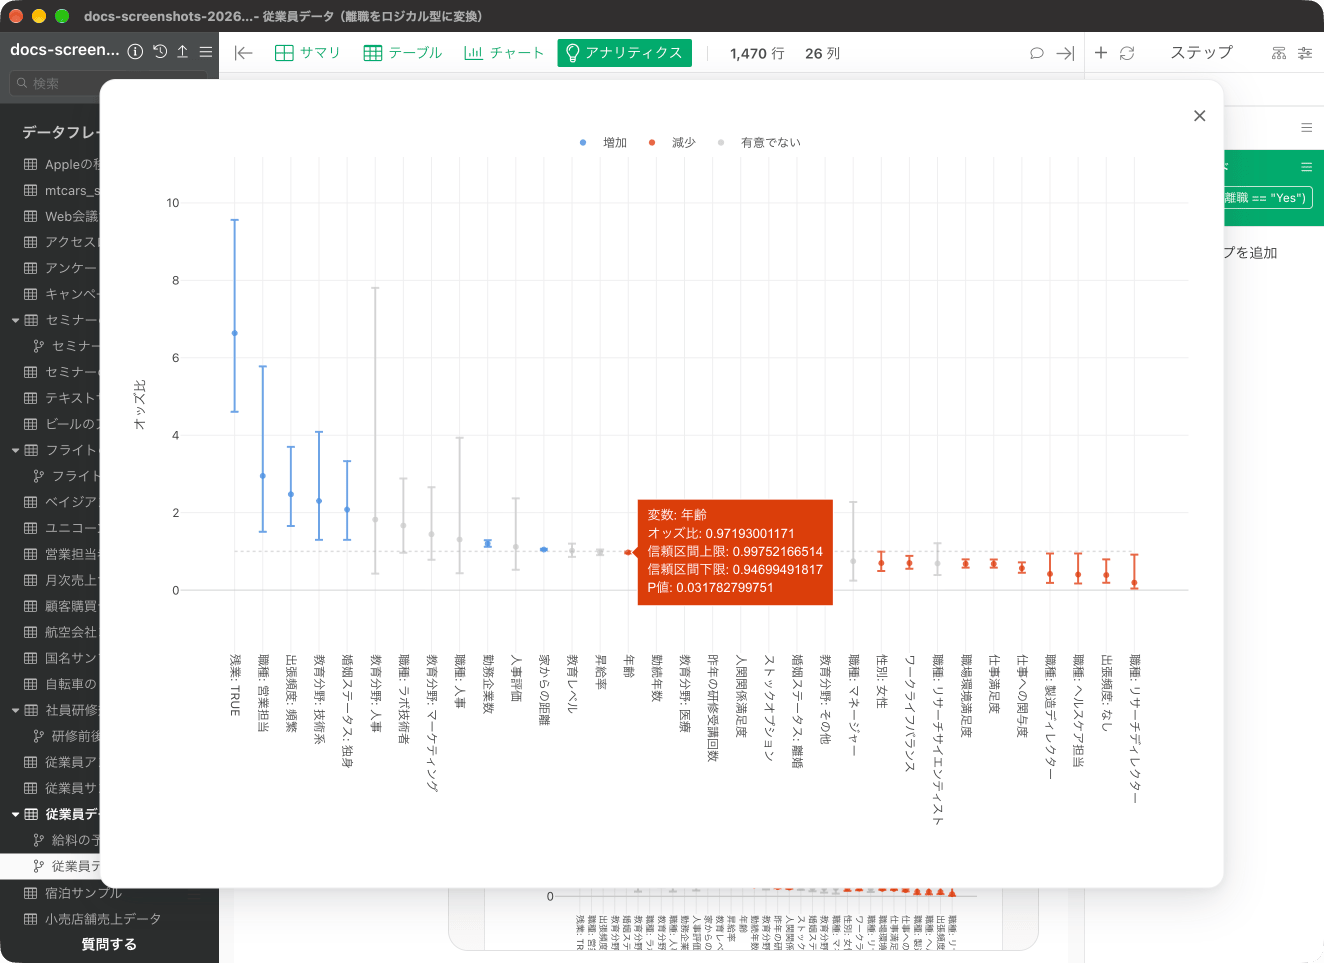
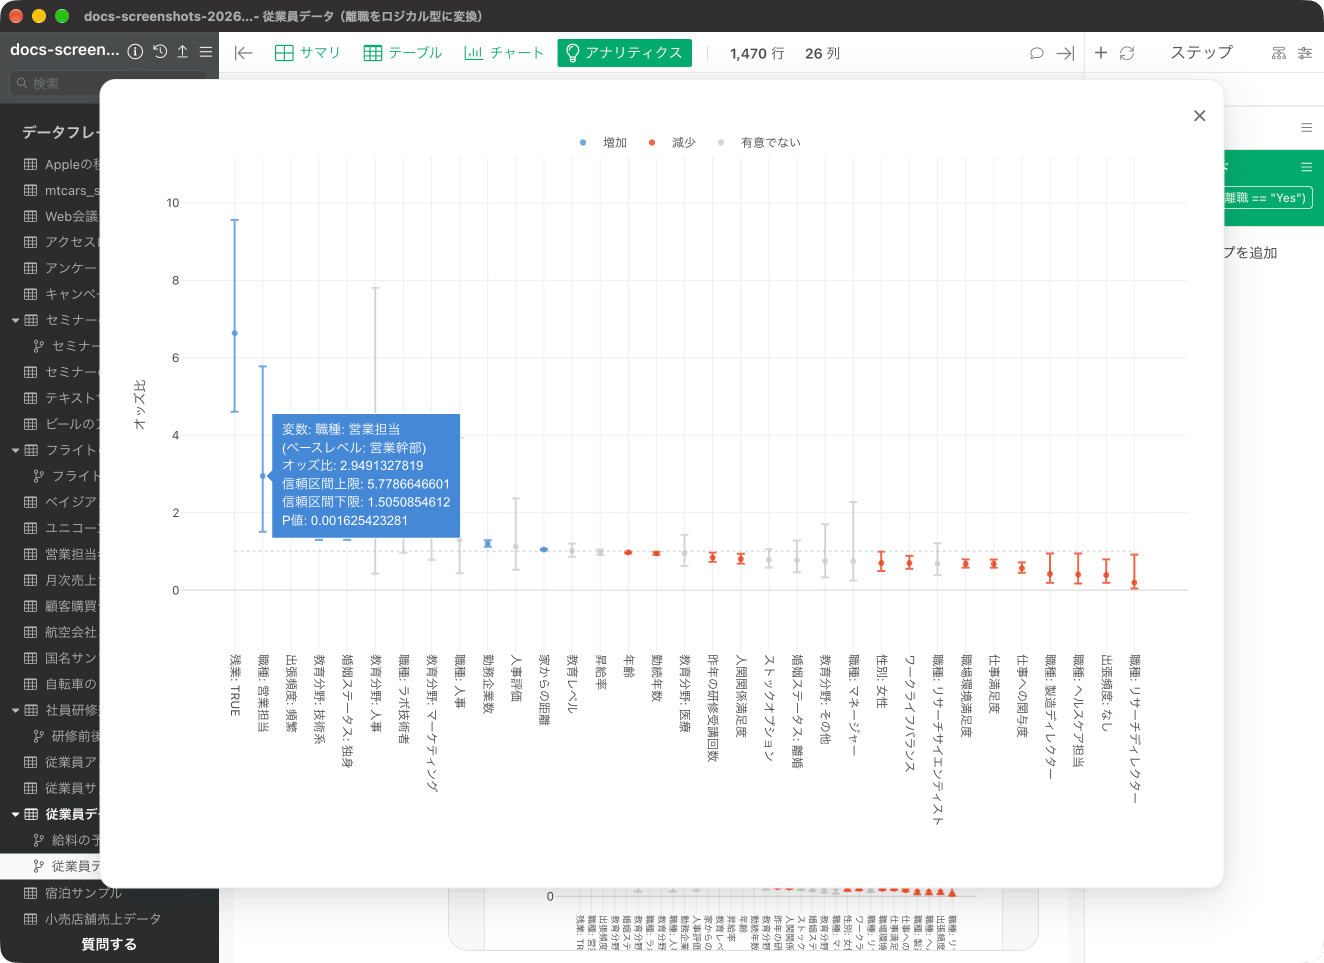
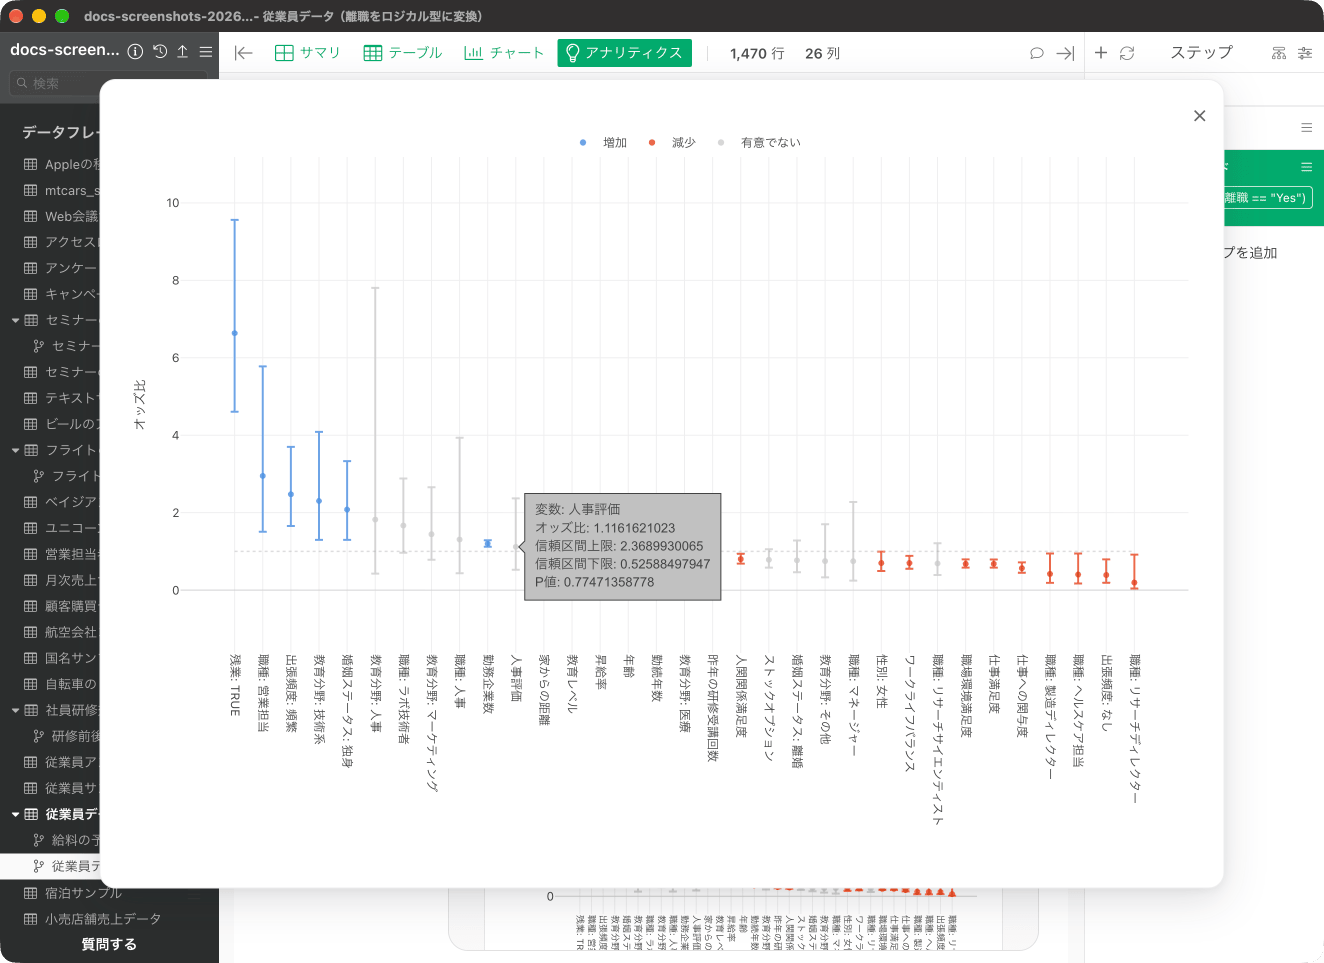
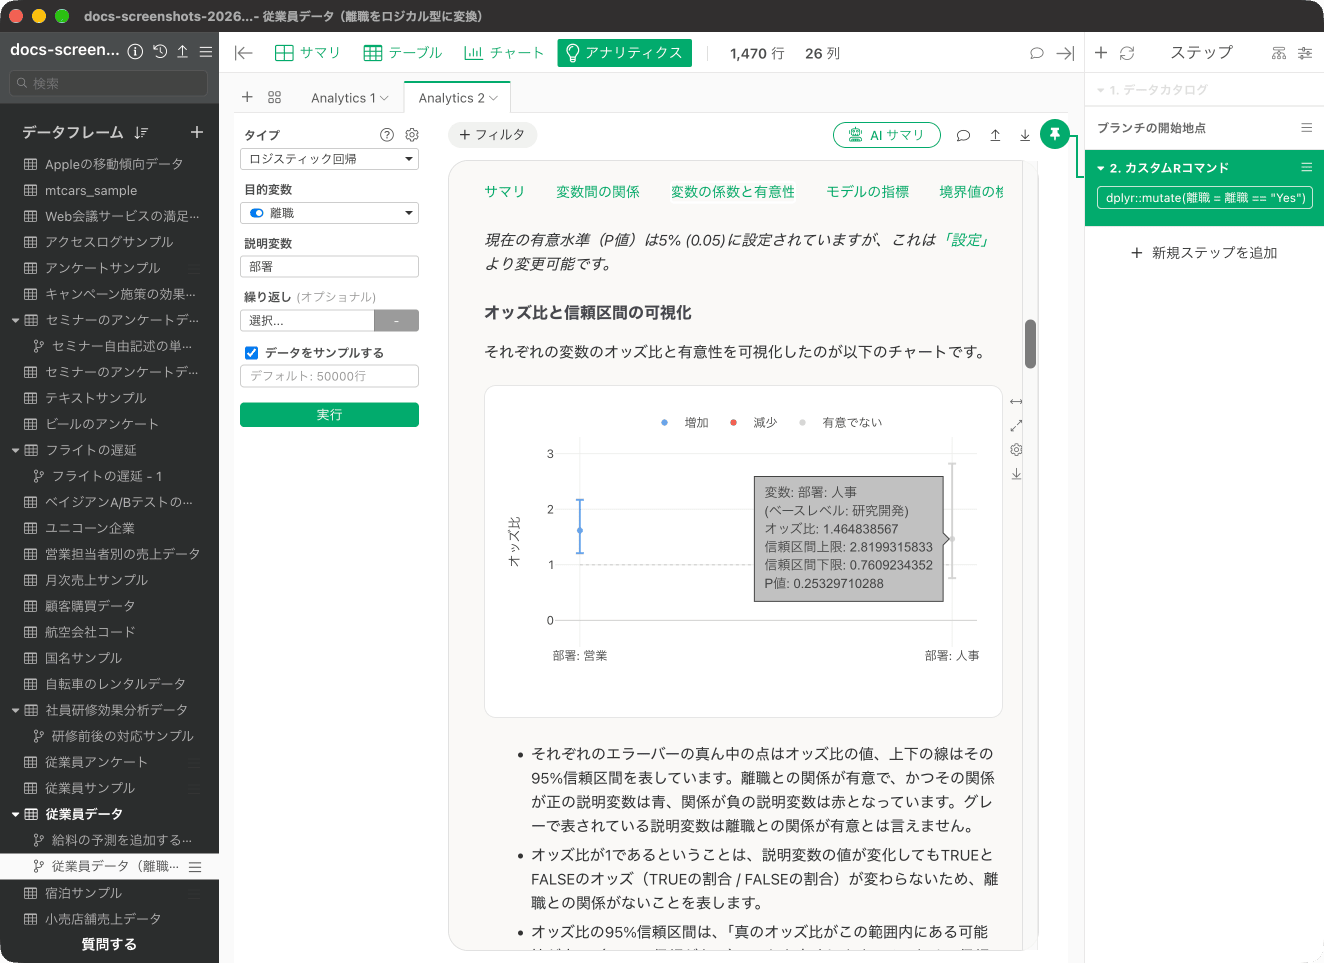
「変数の係数と有意性」では、それぞれの変数のオッズ比とその信頼区間、P値がわかります。表には「オッズ比」「信頼区間下限」などの列があり、右にスクロールすると続きが表示されます。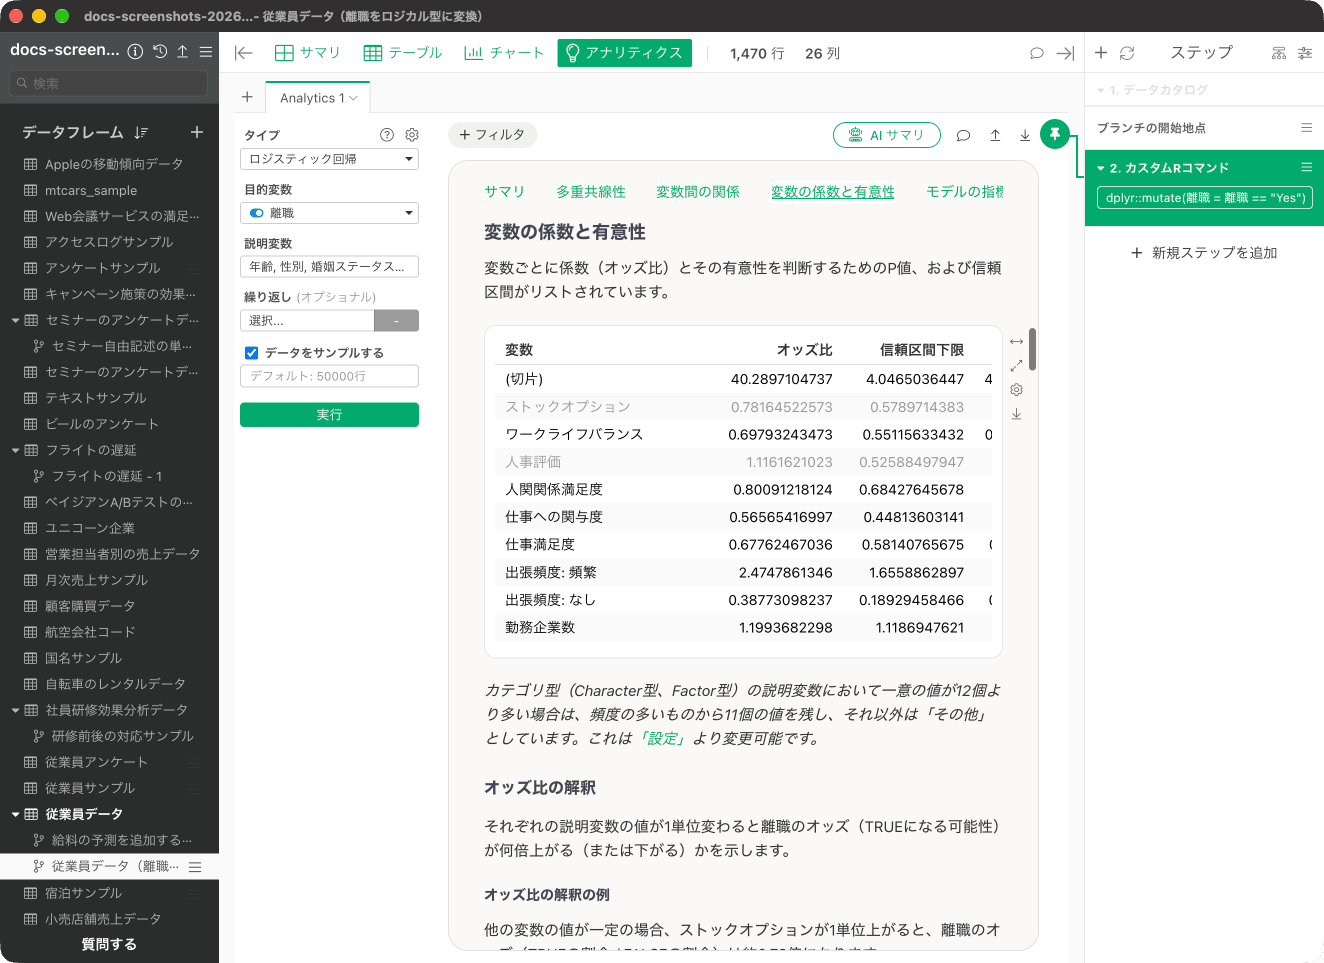
モデルの指標
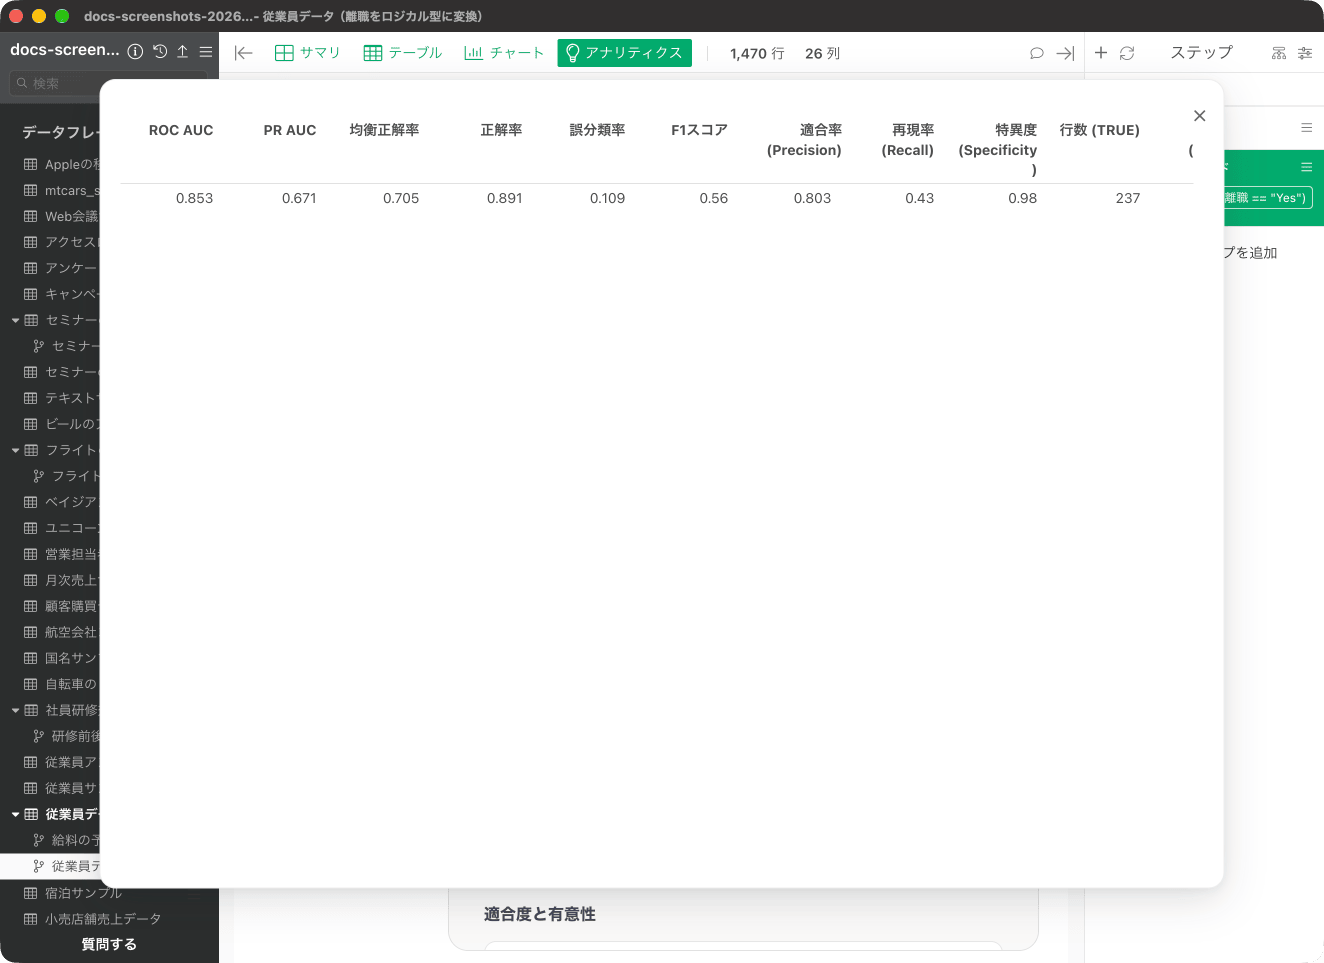
「モデルの指標」では、この予測モデルの評価を確認できます。「予測精度」には、ROC AUC、PR AUC、均衡正解率、正解率、誤分類率などが並びます。現在の指標はトレーニングデータに対する予測結果をもとに計算されており、未知データに対する予測精度を評価するにはテストデータを使うことが推奨されています。その場合は「設定」から「テストモード」を有効にしてください。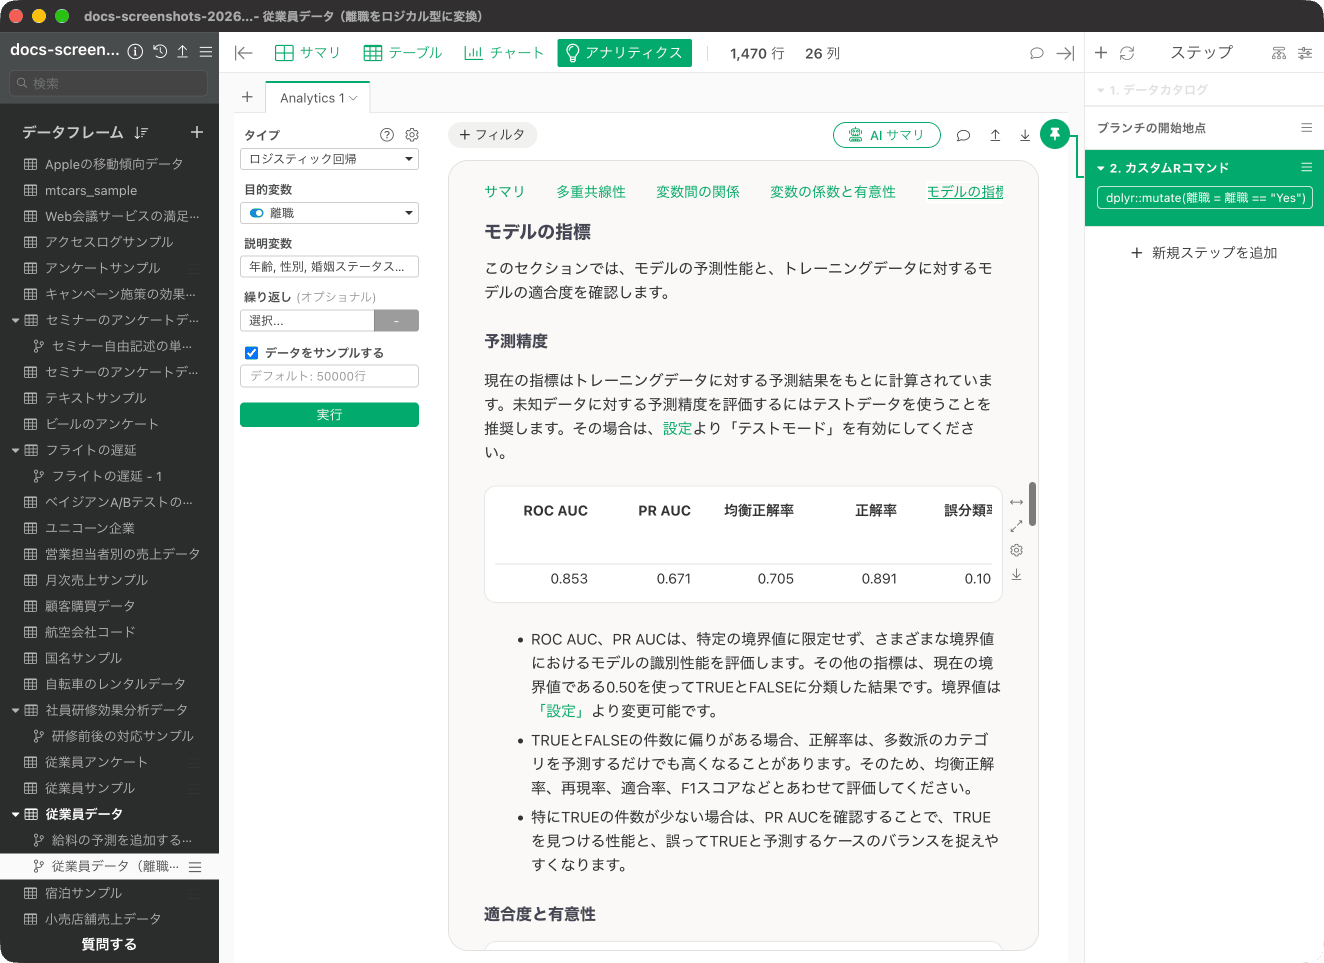
F1スコア
適合率と再現率の調和平均です。0から1の間の値をとり、1に近いほど良い指標です。正解率
実測値と予測値を比べたときに予測値が正解だった割合です。TRUEとFALSEの件数に偏りがある場合、正解率は、多数派のカテゴリを予測するだけでも高くなることがあります。そのため、均衡正解率、再現率、適合率、F1スコアなどとあわせて評価します。誤分類率
予測値と実測値を比べたときに予測値が不正解だった割合です。誤分類率は、タイプ1エラー(第一種過誤/偽陽性/False Positive)の件数とタイプ2エラー(第二種過誤/偽陰性/False Negative)の件数の合計を、全件数で割った値です。適合率(Precision)
「TRUE」と予測したデータの中で、実際に正解が「TRUE」だった割合です。再現率(Recall)
実測値が「TRUE」のときに、予測モデルが「TRUE」と予測できている割合です。 上記の指標につきましては下記のノートで詳細をご紹介していますので、ご参考ください。- ロジカル型予測モデルの評価指標: AUC & F値 - リンク
予測確率の分布
「モデルの指標」の「予測確率の分布」では、このロジスティック回帰のモデルで離職を予測した確率を、実際のデータでTRUEだったとき、FALSEだったときに分けて、それぞれ分布(密度曲線)にして可視化しています。分布の上には、実測値と予測値を対応表にまとめた混同行列も表示されます。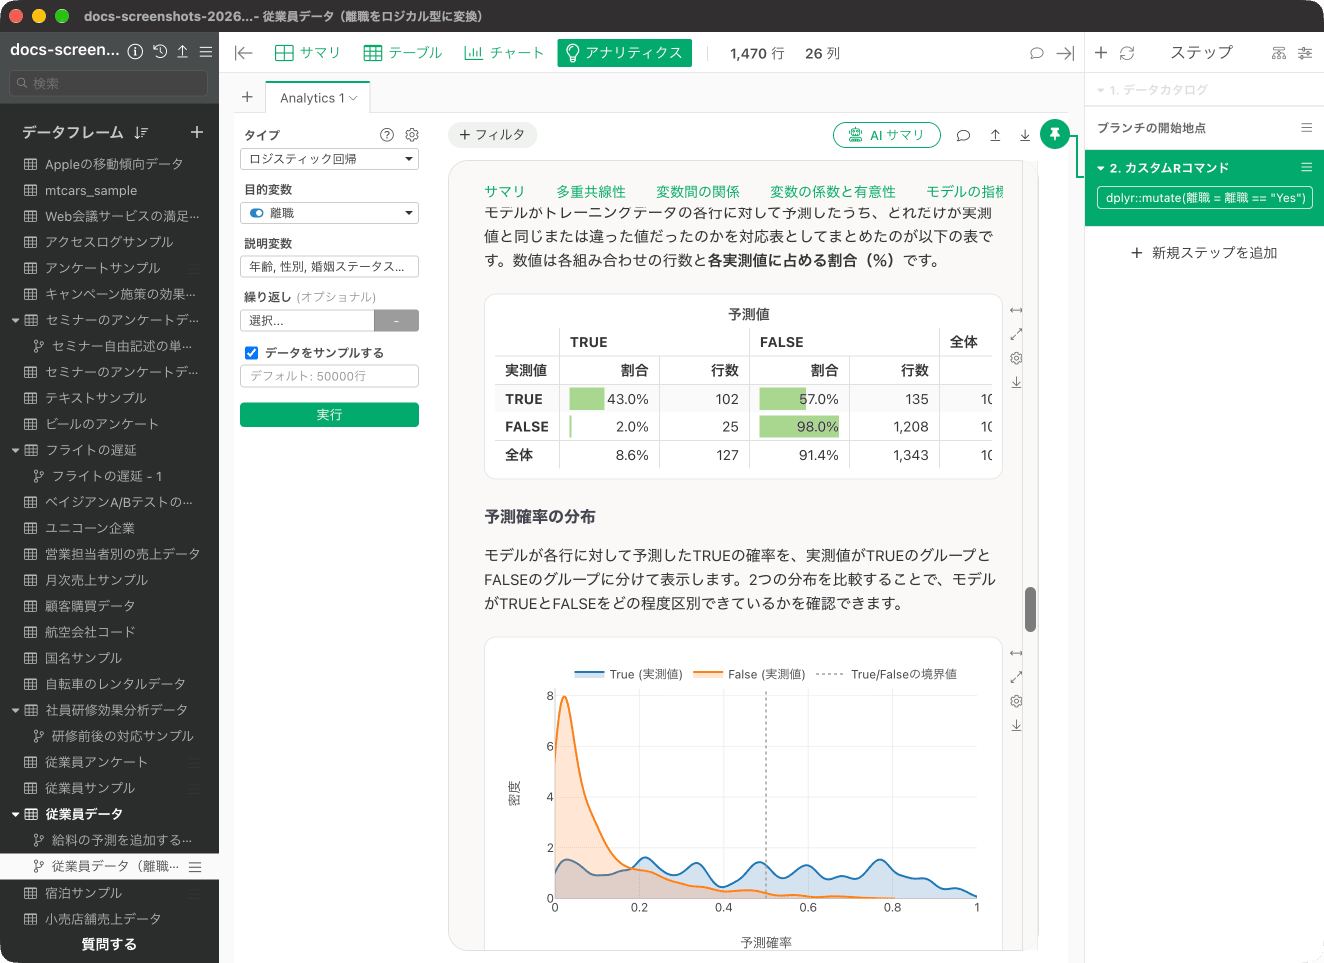
ROC曲線
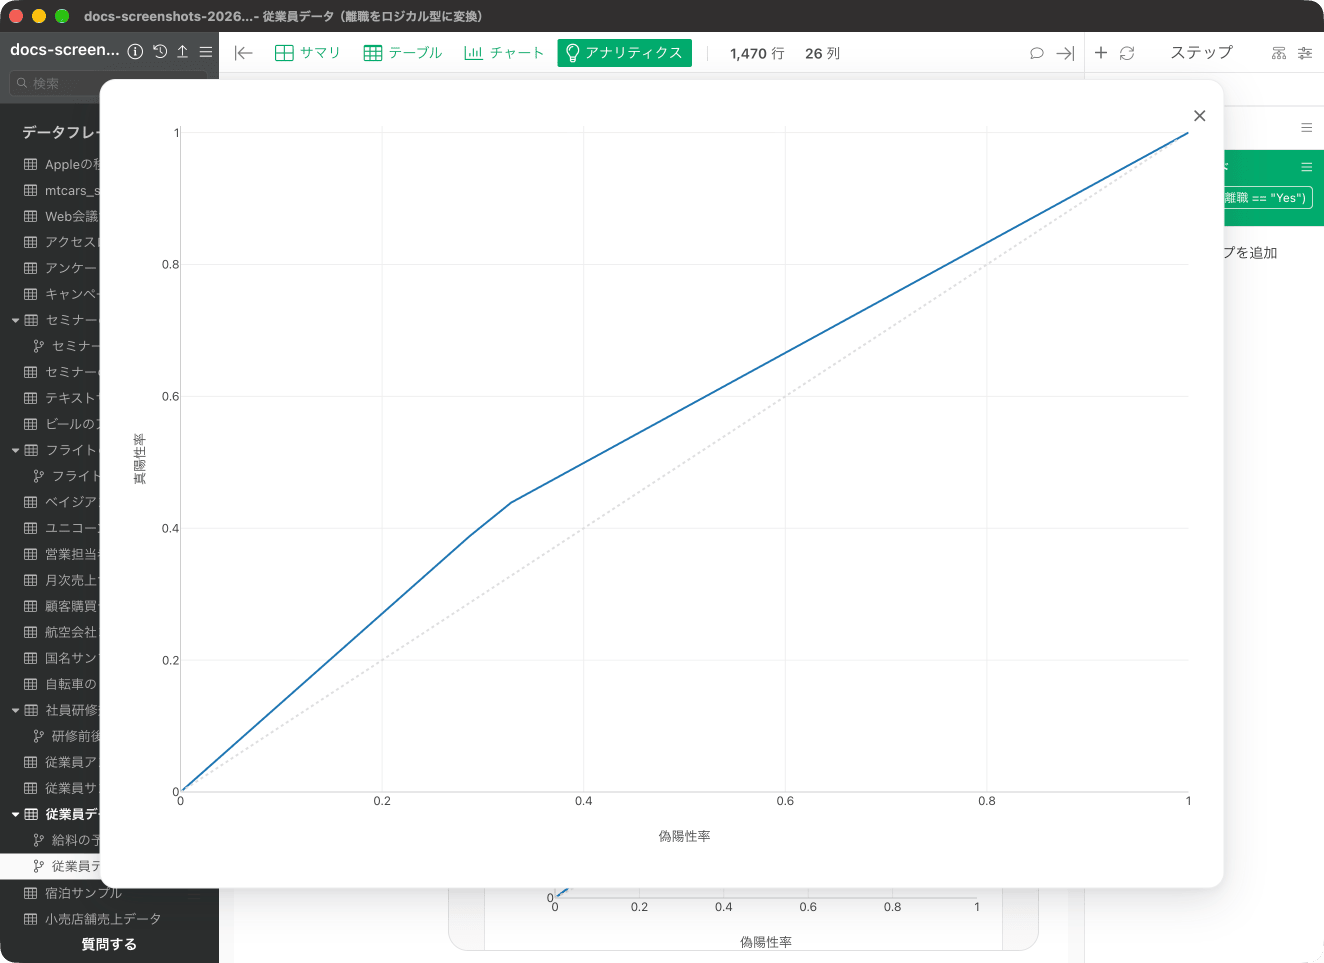
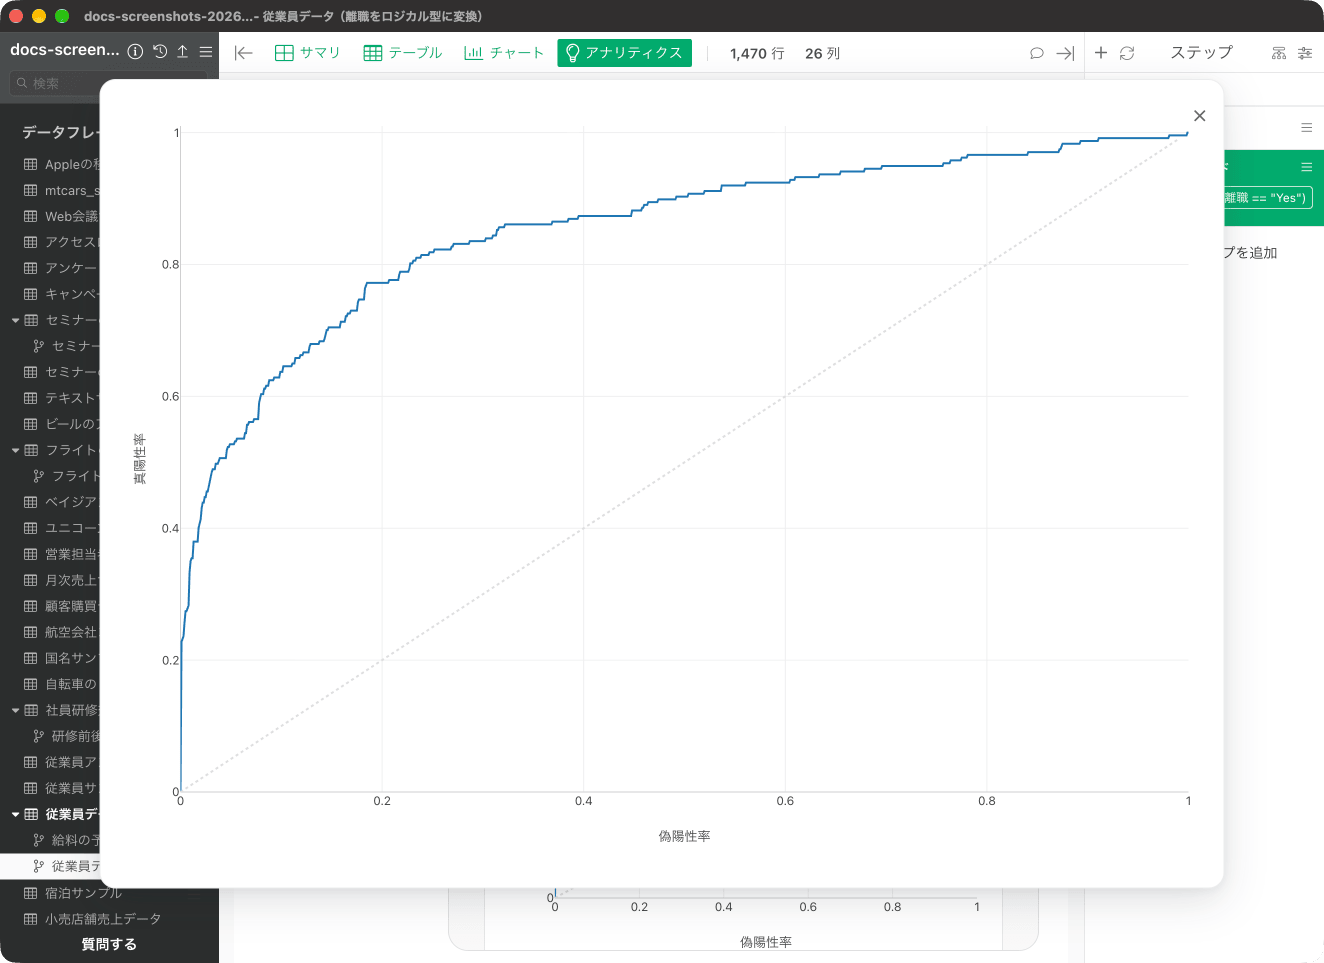
「モデルの指標」の「ROC曲線」では、ROC AUCの元となる面積をROC曲線から確認できます。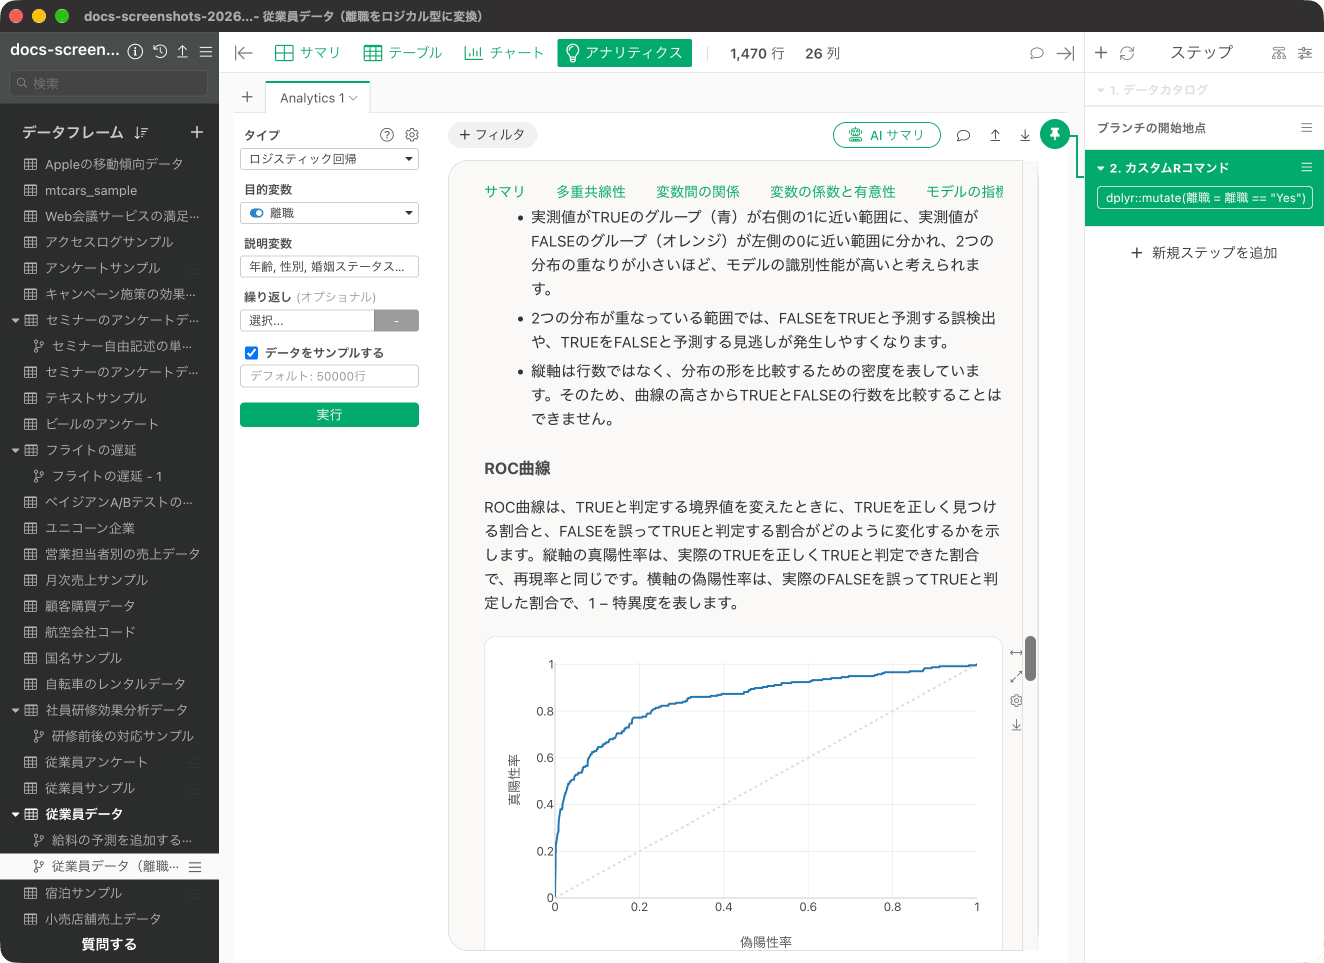
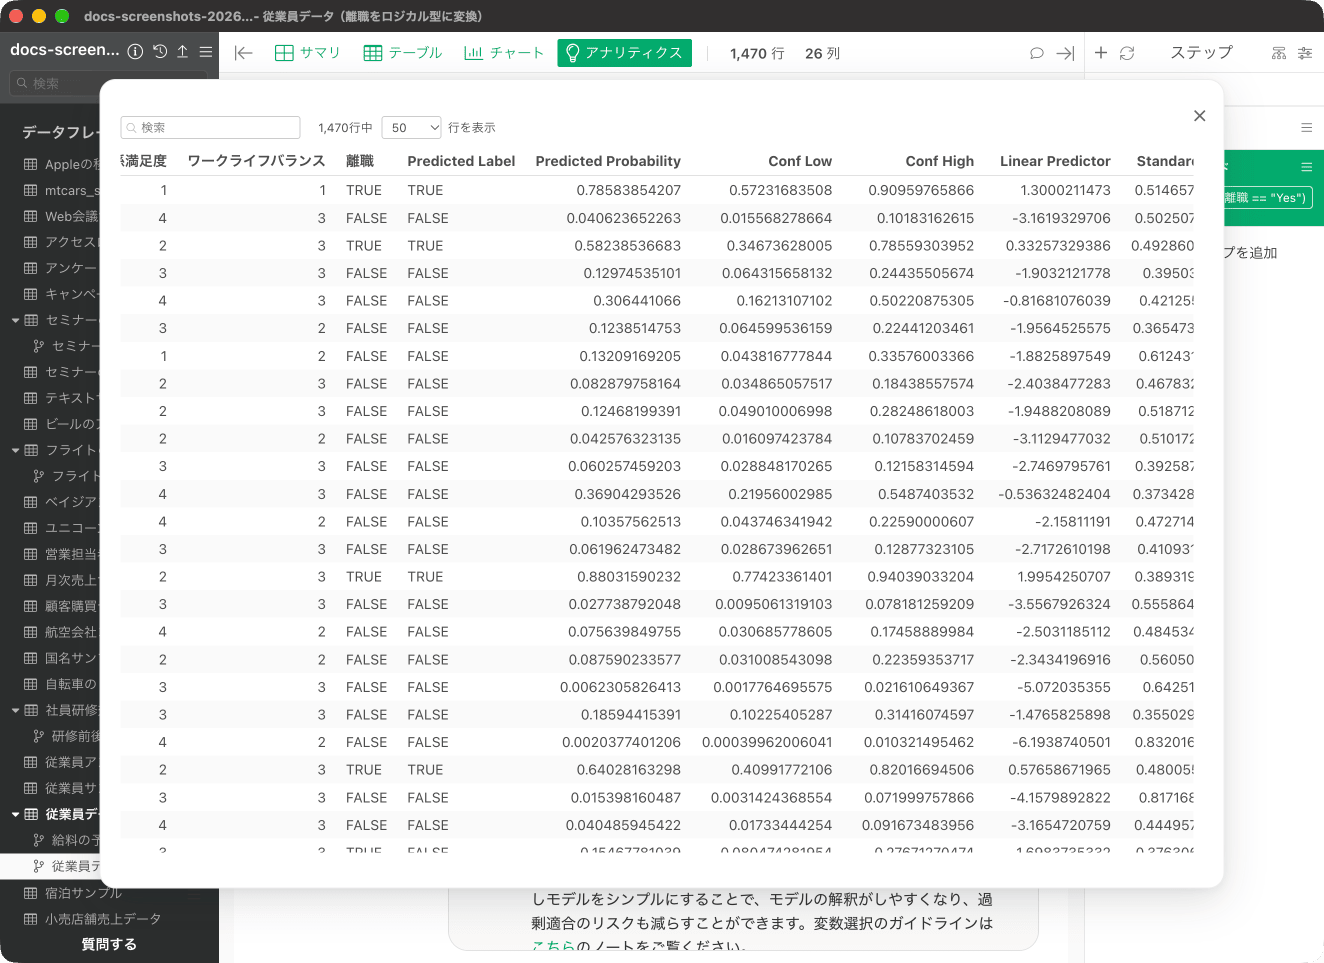
予測結果
「予測結果」では、モデルに使用したデータと予測値がテーブル形式で表示されます。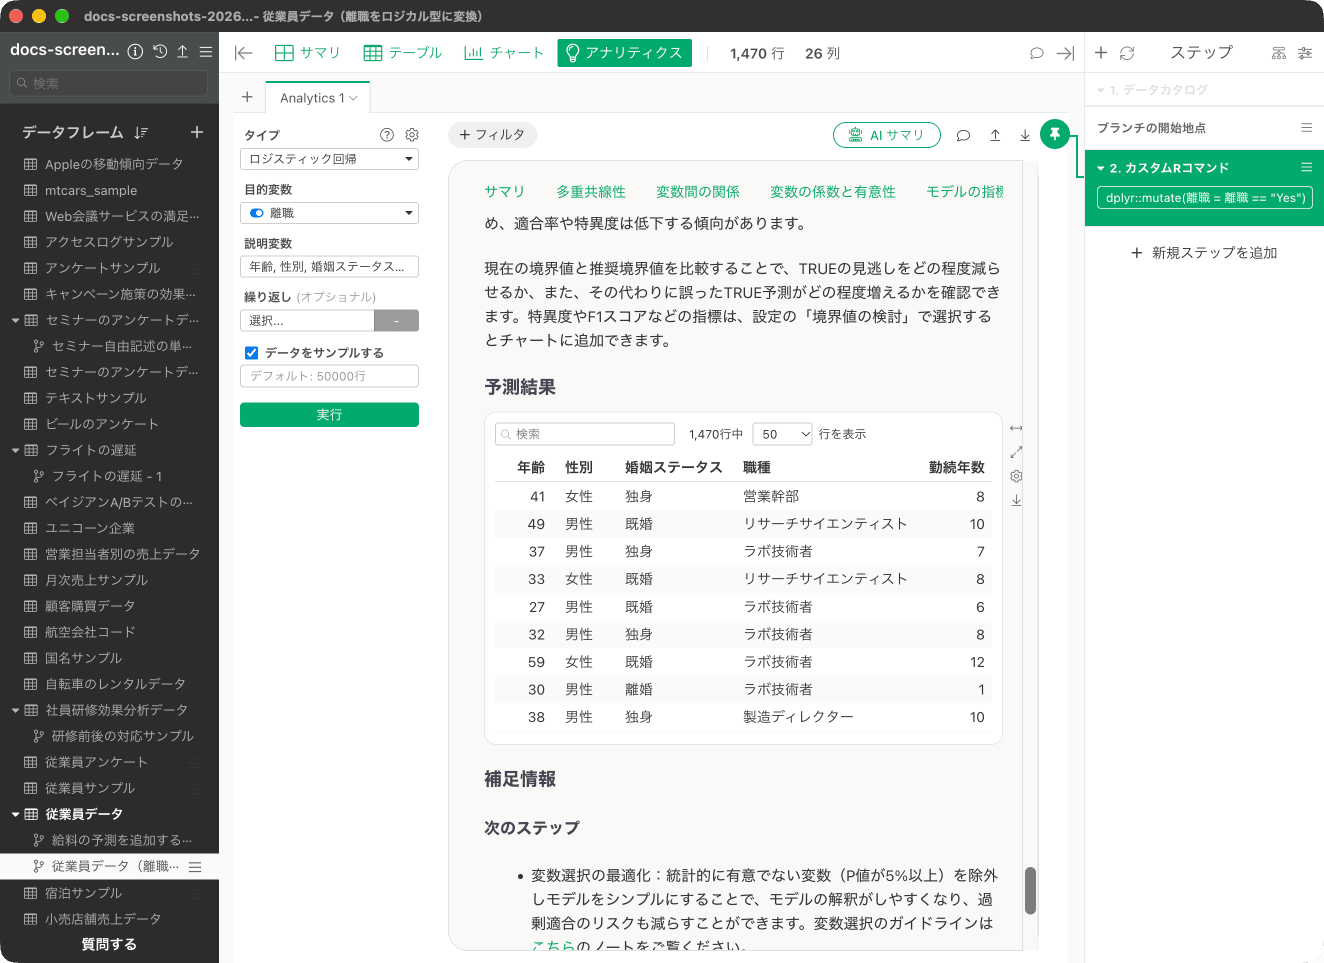
ロジスティック回帰に関するよくある質問
オッズは何を表していますか
TRUEの確率がFALSEの確率に比べて何倍かを表しており、下記のように計算できます。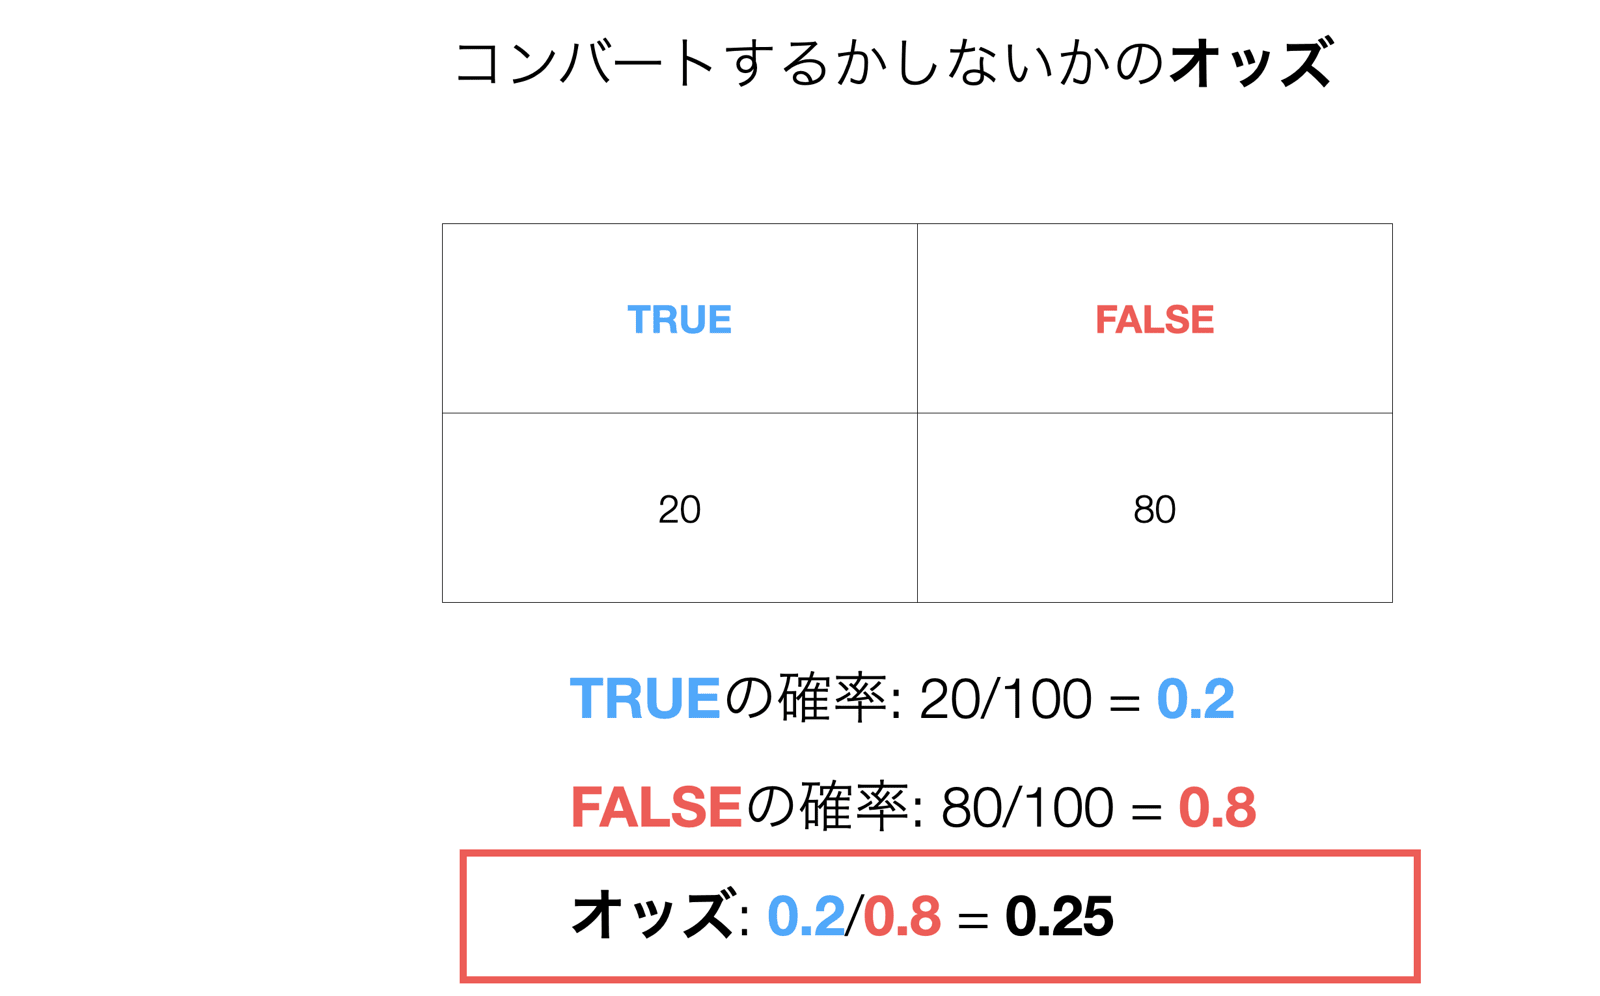
説明変数が数値型の時のオッズ比は何を表していますか
オッズ比とは、説明変数の値が増えた時に、オッズが何倍で増えていくのかを表しています。 下記の例では、視聴時間が増えた時にオッズが2倍ずつで増えているため、オッズ比は「2」となっています。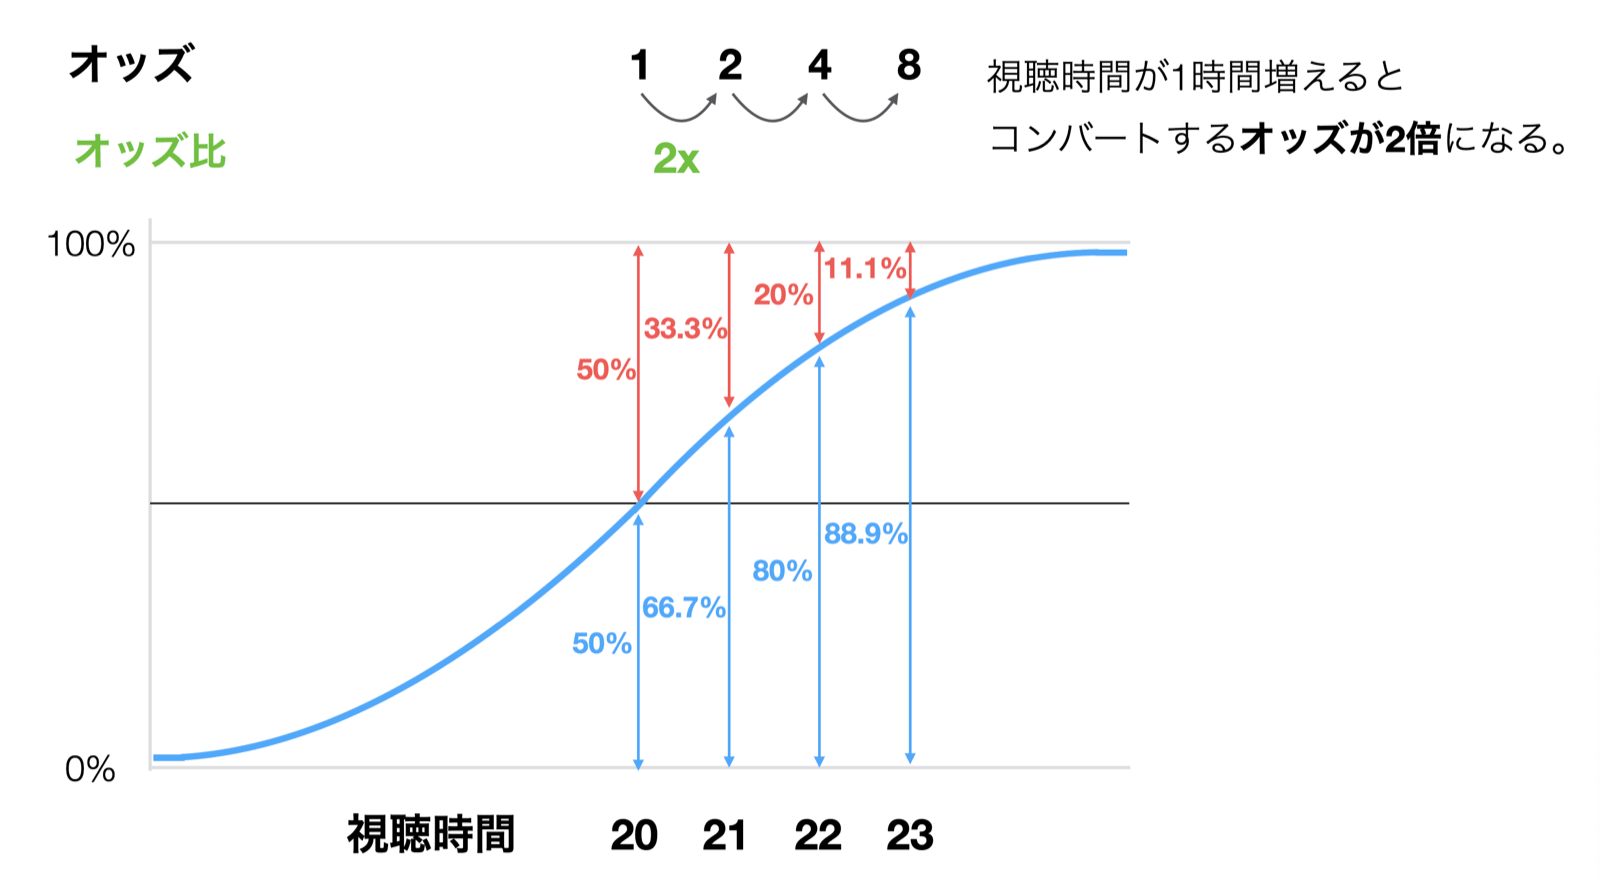
説明変数がカテゴリ型の時のオッズ比は何を表していますか
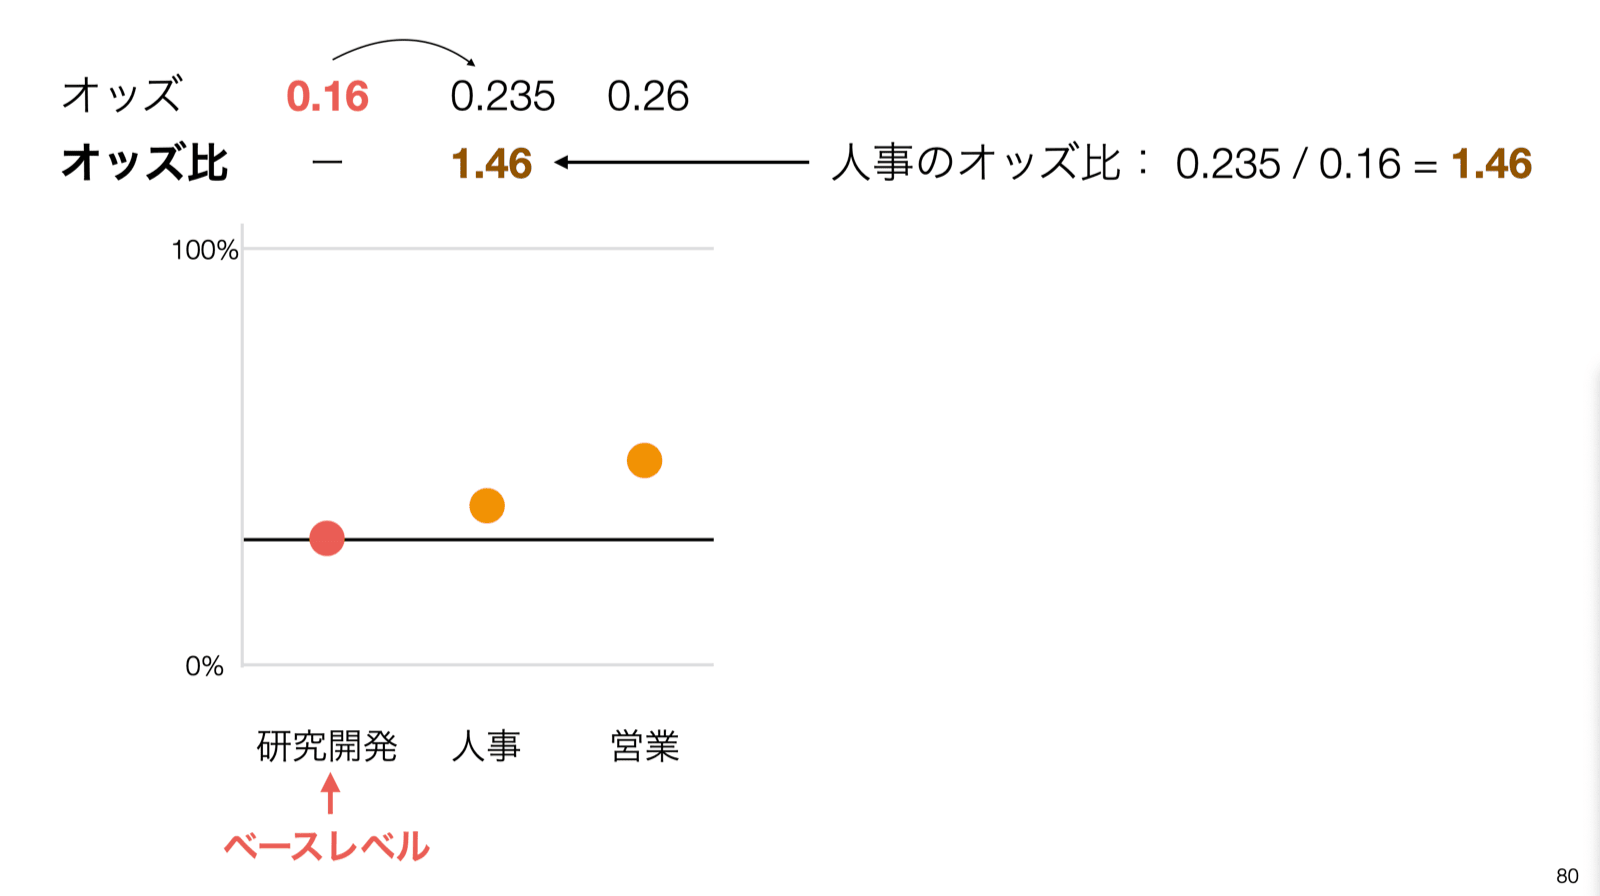
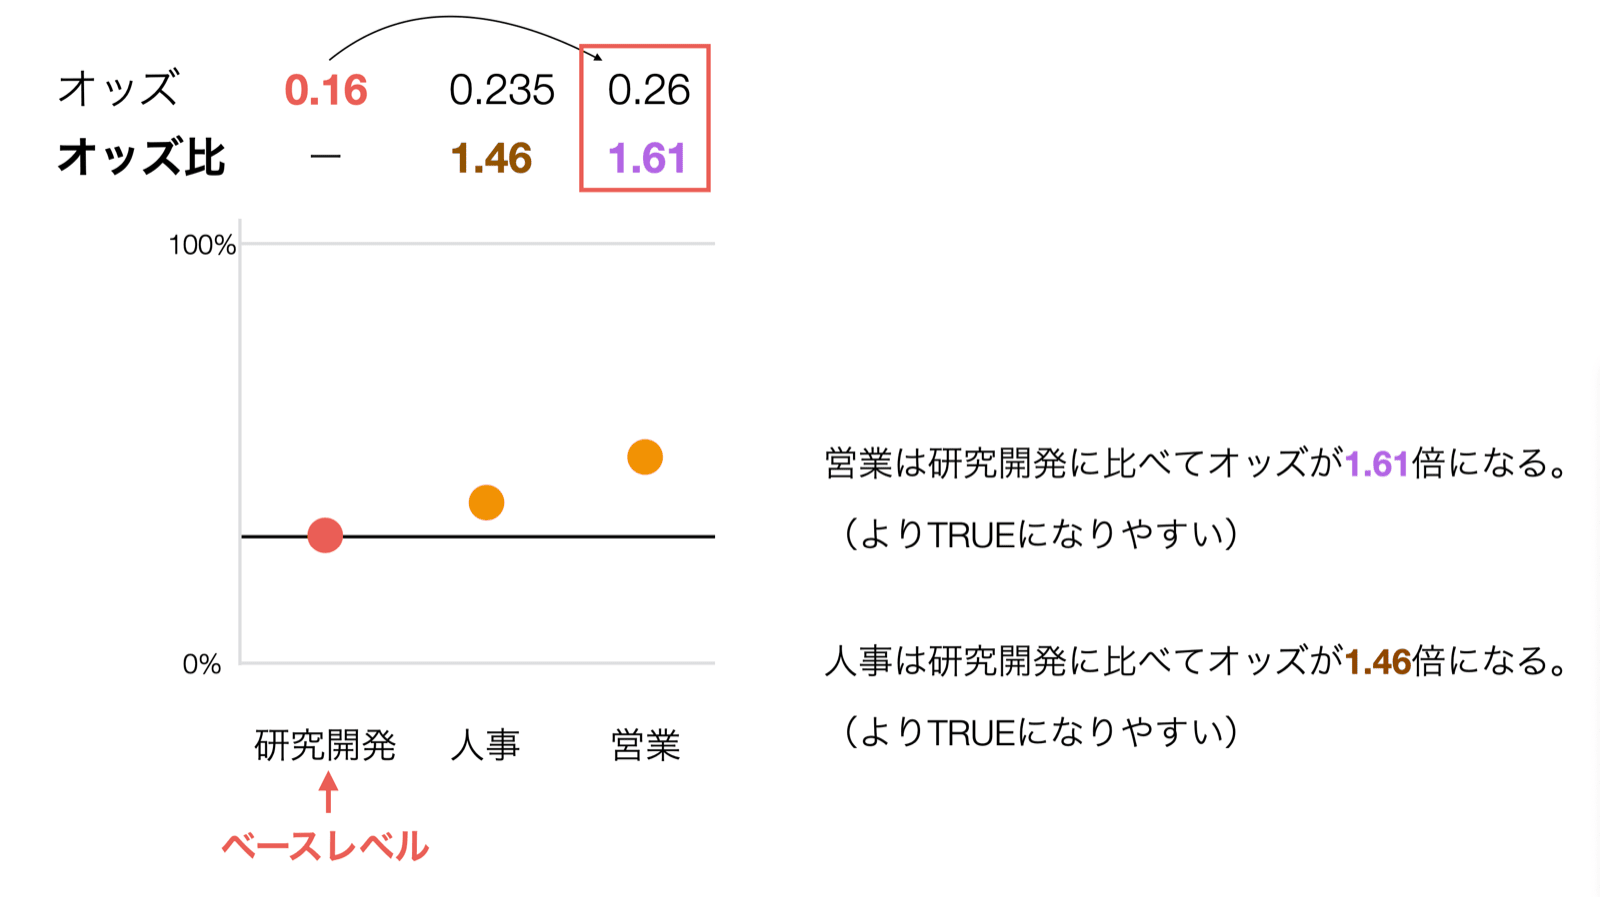
説明変数がカテゴリ型の時のオッズ比は、ベースレベルのオッズと比べて、それぞれの値のオッズが何倍であるかを求めています。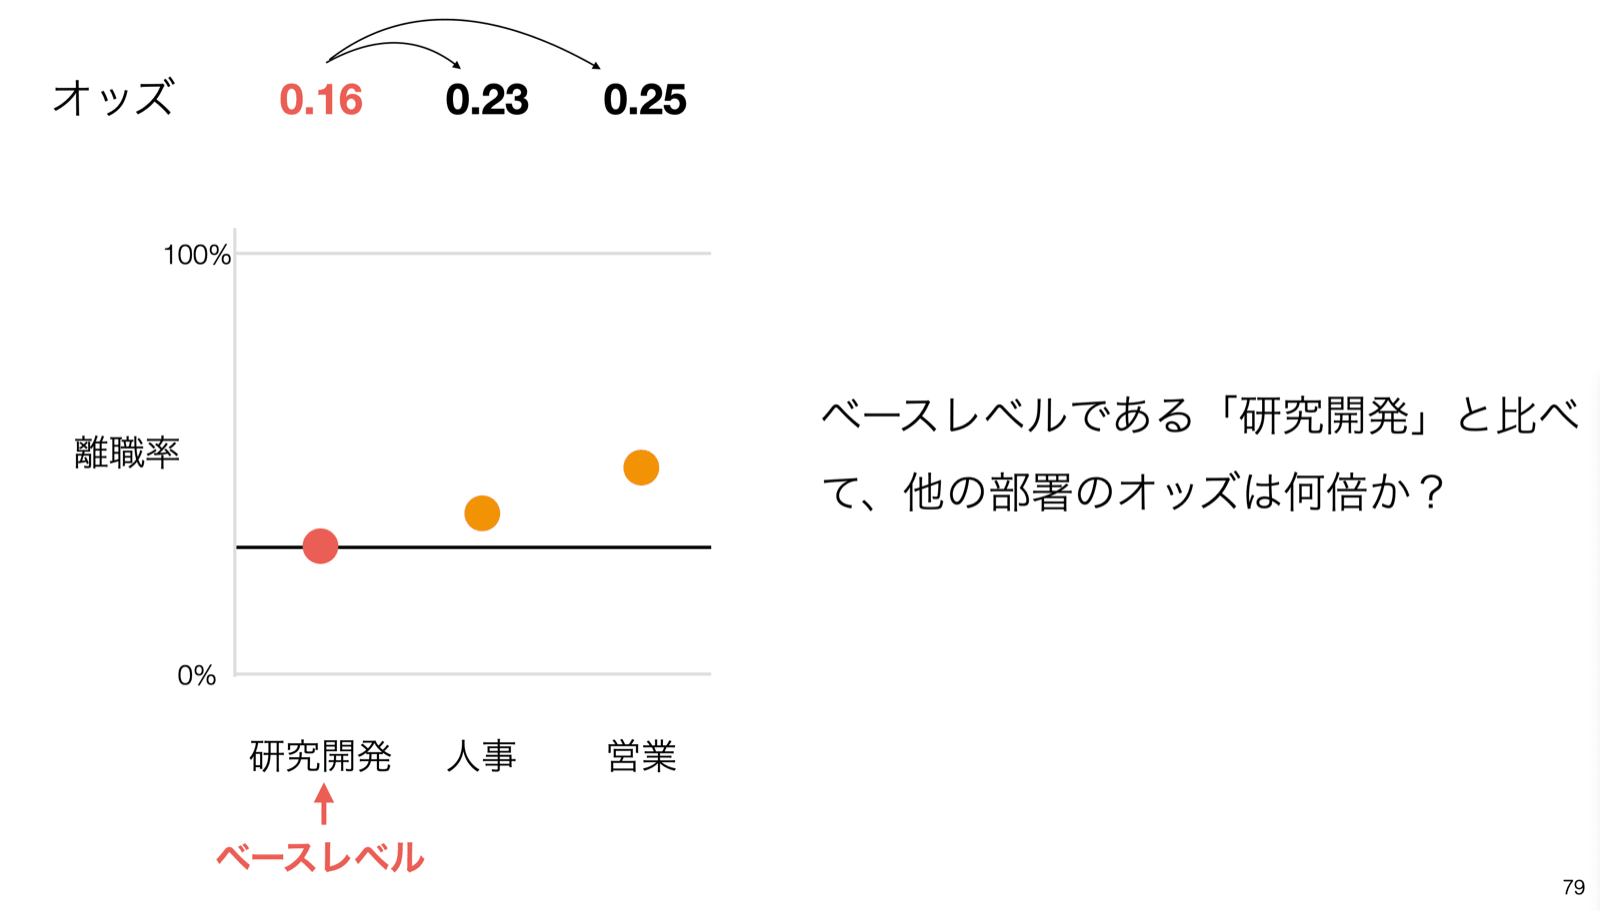
人事のオッズ / 研究開発(ベースレベル)のオッズ)で求めたものが人事のオッズ比になります。
データサイズが少ない時でも、カテゴリ型の説明変数のオッズ比は高く算出されますか
前提として、データサイズが少なかったとしても、TRUEとFALSEの比率が変わらなければ、オッズ自体の値は変わりません。- 100人いて20人がTRUE、80人がFALSEの時
- 10人いて2人がTRUE、8人がFALSEの時
Q: 「変数の係数と有意性」で表示される係数は標準化回帰係数ですか、それとも、偏回帰係数ですか?
「変数の係数と有意性」で表示される係数は説明変数の値を標準化した後の係数(標準化回帰係数)ではなく、「元の単位」における係数(偏回帰係数)となります。説明変数にあるカテゴリ型の列のベースレベルを変更したい
ロジスティック回帰などの統計のモデルでのカテゴリ型の列を説明変数に選択して実行した際には、ベースレベルと比べて特定の値だった時に有意なのかどうかが分かるようになっており、ベースレベルはその列の値で最頻値(行の数が最も多い)が自動的に選ばれます。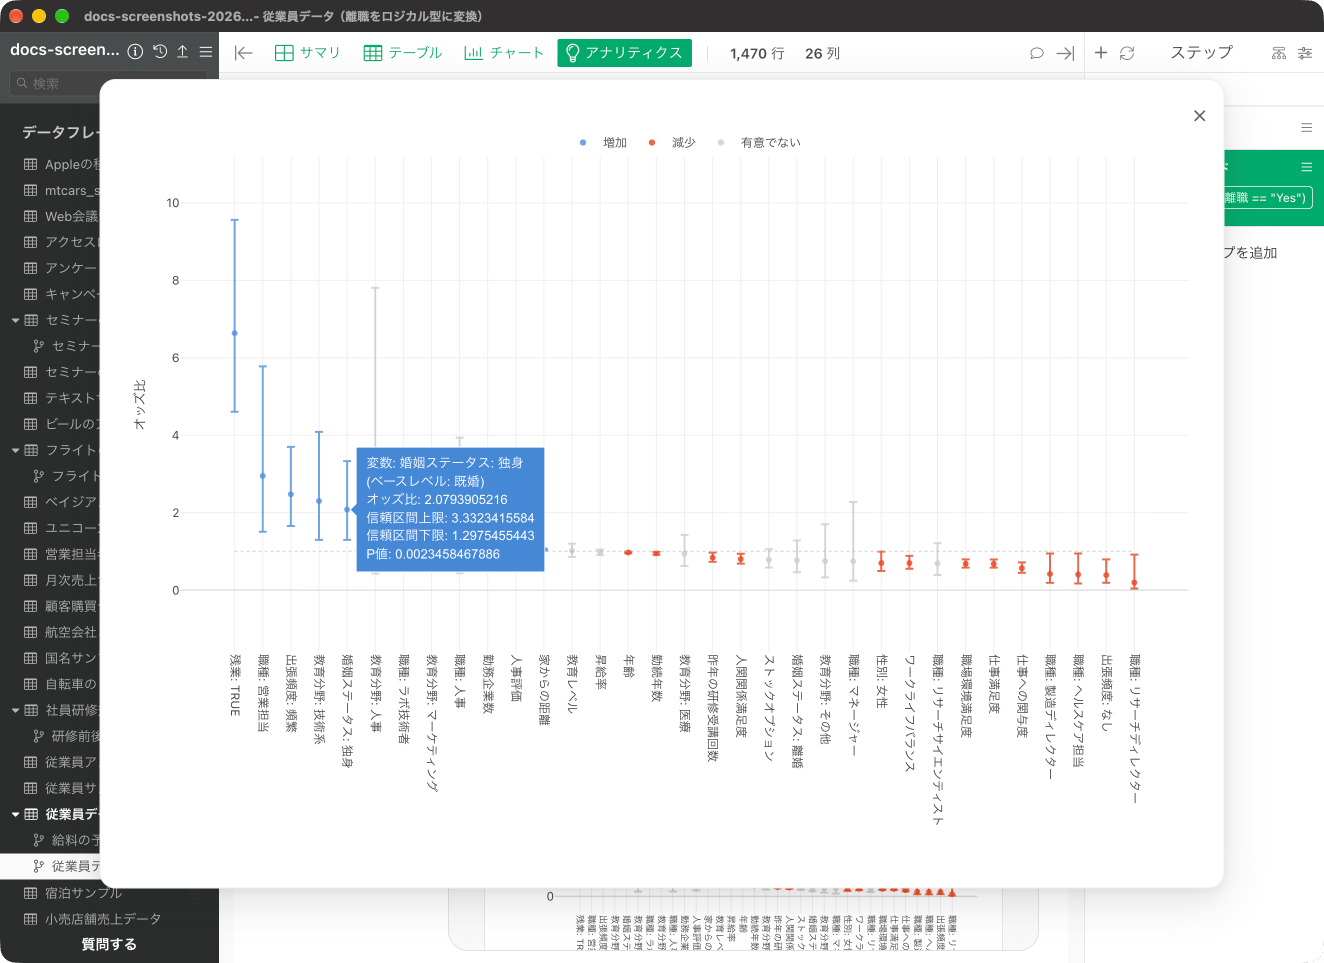
Q: 「説明変数の影響度」で表示されている実測値はどのように求められているのですか?
「説明変数の影響度」の実測値はそれぞれの説明変数のデータタイプによって表示が異なります。 詳しくはこちらのノートをご覧ください。Q: 「説明変数の影響度」で表示されている予測値はどのように求められているのですか?
予測値のチャートはPartial Dependence Plot(PDP)と呼ばれるもので、注目している変数の値を変化させたときに、予測結果がどう変わるかを可視化したチャートとなります。詳しくはこちらのノートをご覧ください。Q: 閾値はどのように変更できますか?
「設定」の「モデル評価」にある「分類の境界値」に値を指定することで閾値を変更できます。閾値のデフォルトは0.5になっており、0.5以上の場合はTRUEと予測、0.5よりも小さい場合はFALSEと予測されています。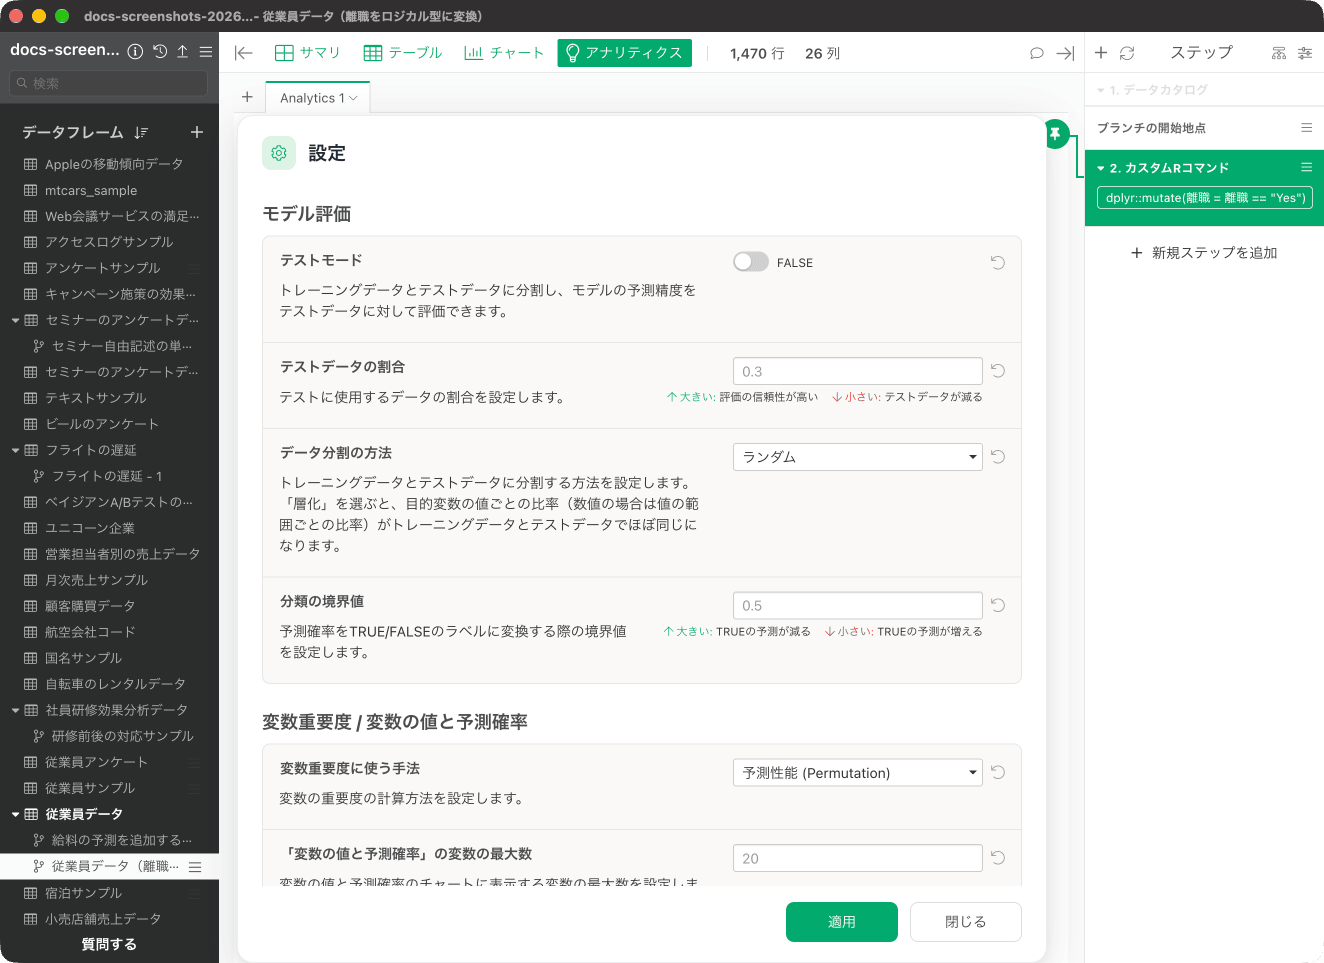
Q: 予測精度を上げるためにしきい値などの調整はどうすれば良いですか。どちらを優先すれば良いですか。
F値を最もよくするしきい値にすることもできますが、ドメインによってどちらを重視したいかは変わります。Q: タイプ1とタイプ2エラーで、どれくらいなら許せるかの基準値はありますか?
各タイプのエラーが起きたときの損害をどこまで許容できるかによって判断することになります。Q: 「多重共線性」でVIFが10を超える変数が複数あった時にはどのように説明変数を除いたらいいですか?
VIFが10を超える変数が複数あった時の説明変数の選び方については、こちらの投稿をご参照ください。Q: 単回帰では有意にならない変数が、重回帰にすると有意になりました。どう解釈すればいいのでしょうか。
単回帰では有意な関係がないと見えていたものが、重回帰にすると有意になることを負の交絡(Negative Confounding)と言います。詳しくはこちらをご覧ください。Q: オッズ比の信頼区間はどのように求められていますか?
Exploratoryでは、ロジスティック回帰を実行したときにオッズ比とその信頼区間を「変数の係数と有意性」から確認できます。