何ができるか
線形回帰を使うと、次の質問に答えられます。- このデータ(説明変数)を使うことで、目的変数(例:売上)のばらつきの何%を説明できるか。
- どの変数が目的変数を予測するうえで重要か。
- 変数の値が変わると、目的変数の値はどのように変わるか。
- その説明変数は、目的変数の変化を説明するうえで有意と言えるか。
- 他の変数が一定のとき、変数の値が1上がると、目的変数の値はどれだけ上がる(または下がる)か。
必要なデータ
線形回帰を作成するためには、1行が1観察対象(例:1行が1従業員)となっているデータが必要です。 また、目的変数として使用できるデータタイプは「数値型」の列で、説明変数におけるデータタイプには特に縛りはありません。しかし、線形回帰などの統計系のモデル作成時には、説明変数どうしの相関があまりにも強い時に発生する「多重共線性」などの問題を考慮する必要があります。サンプルデータ
今回はサンプルデータとして、従業員データを使用していきます。 このデータは1行が1従業員のデータで、列には年齢や給料、職種など従業員の属性を表す列があります。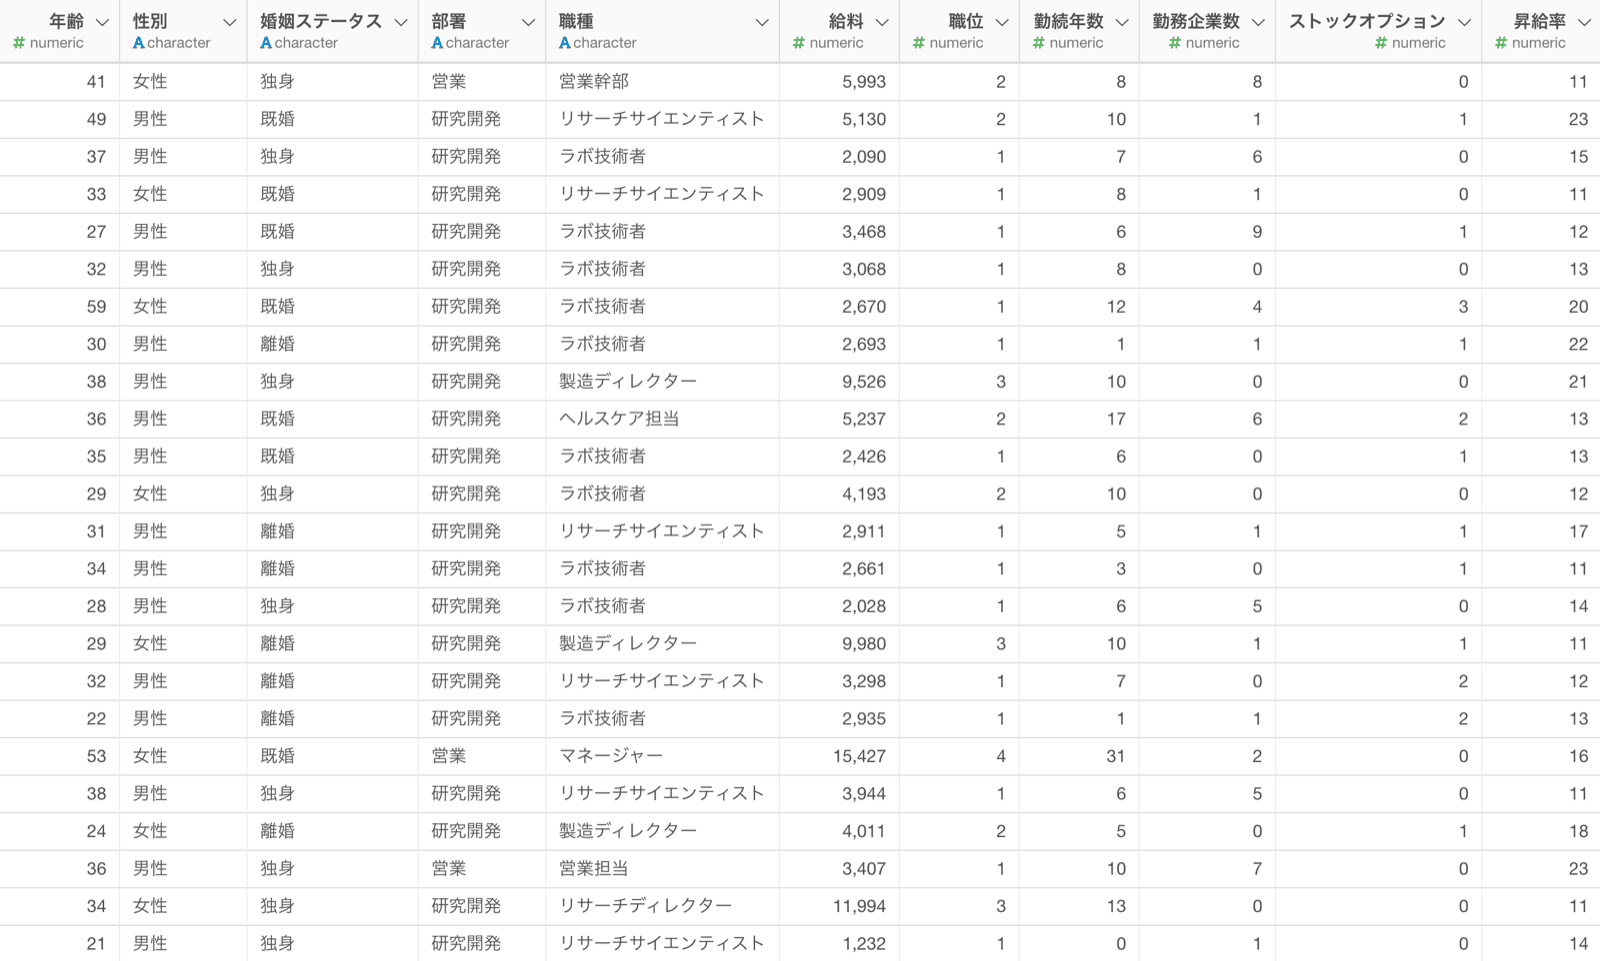
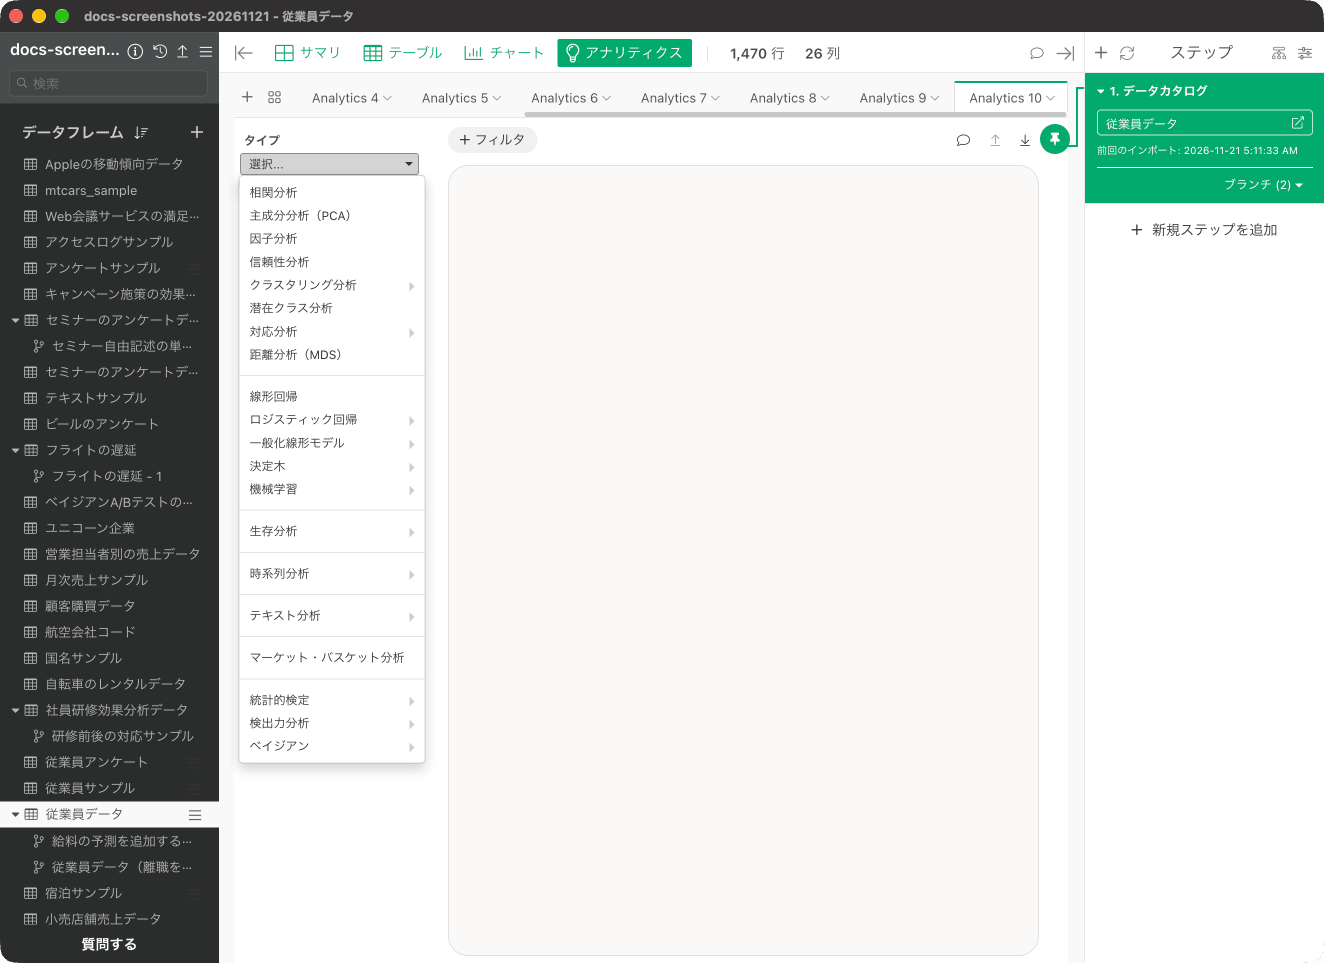
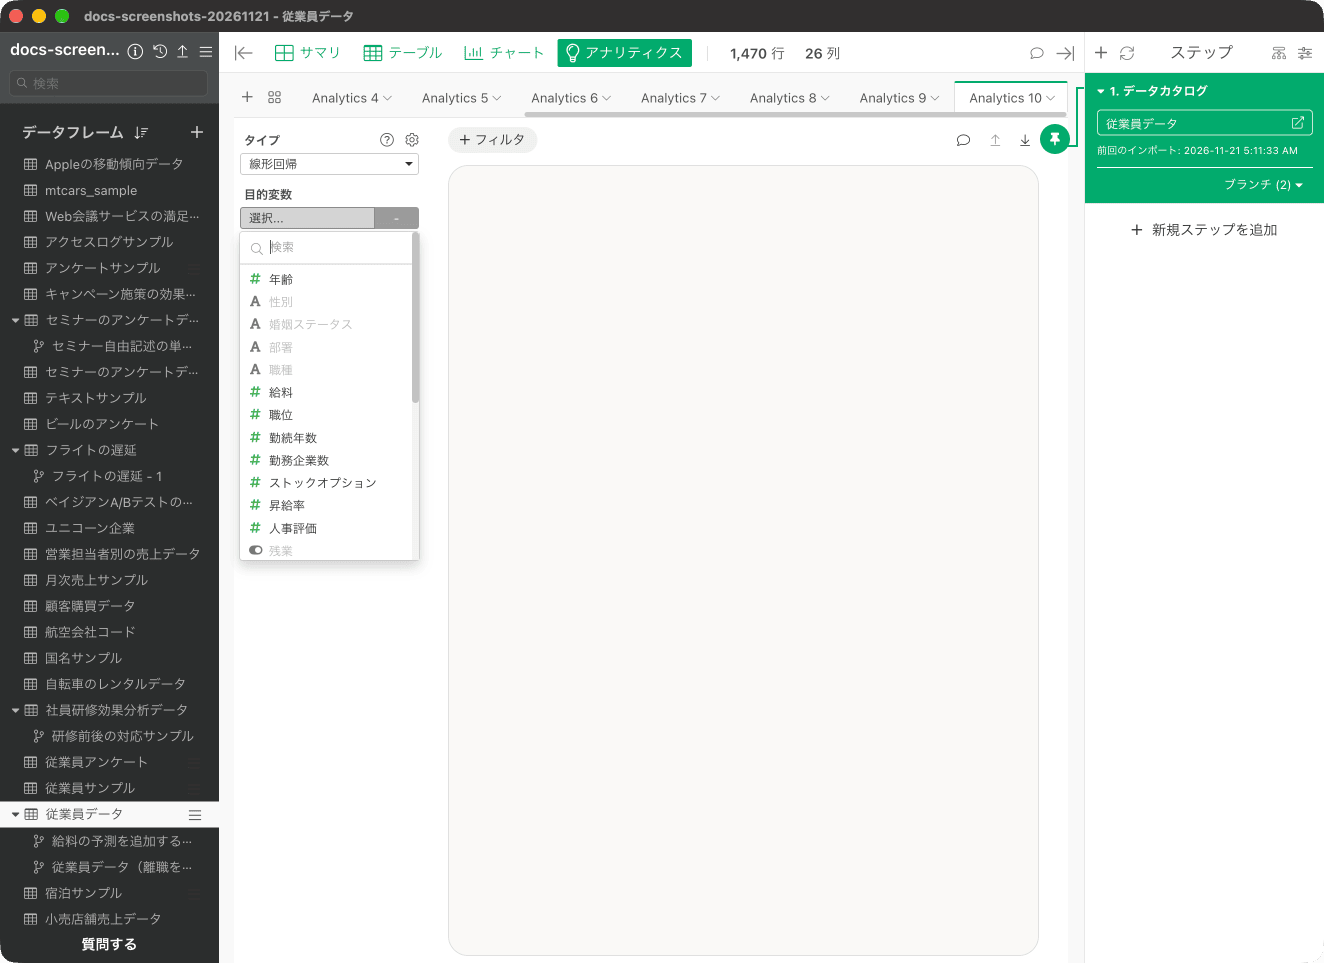
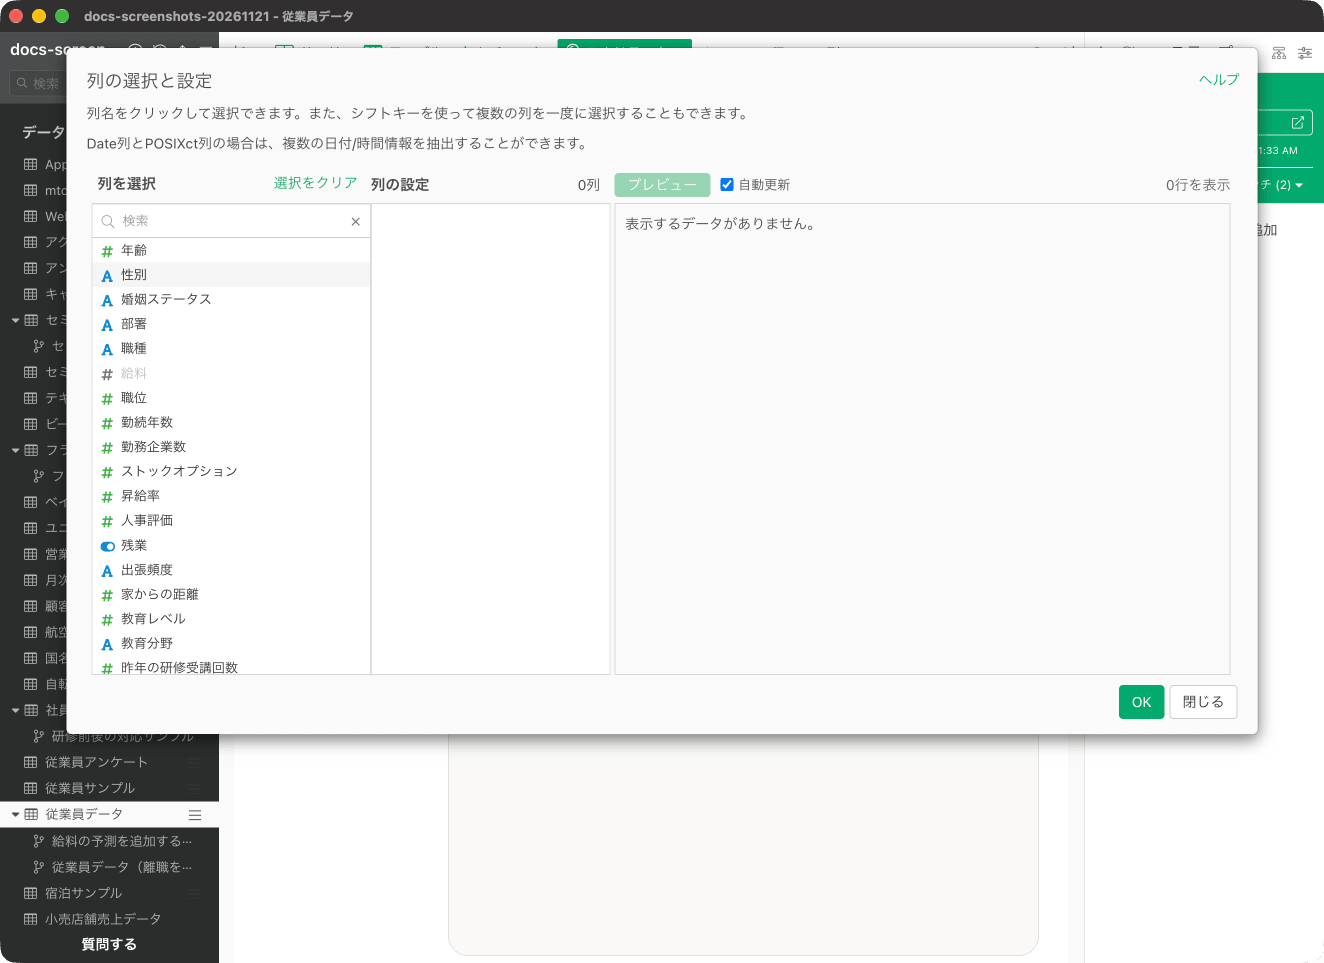
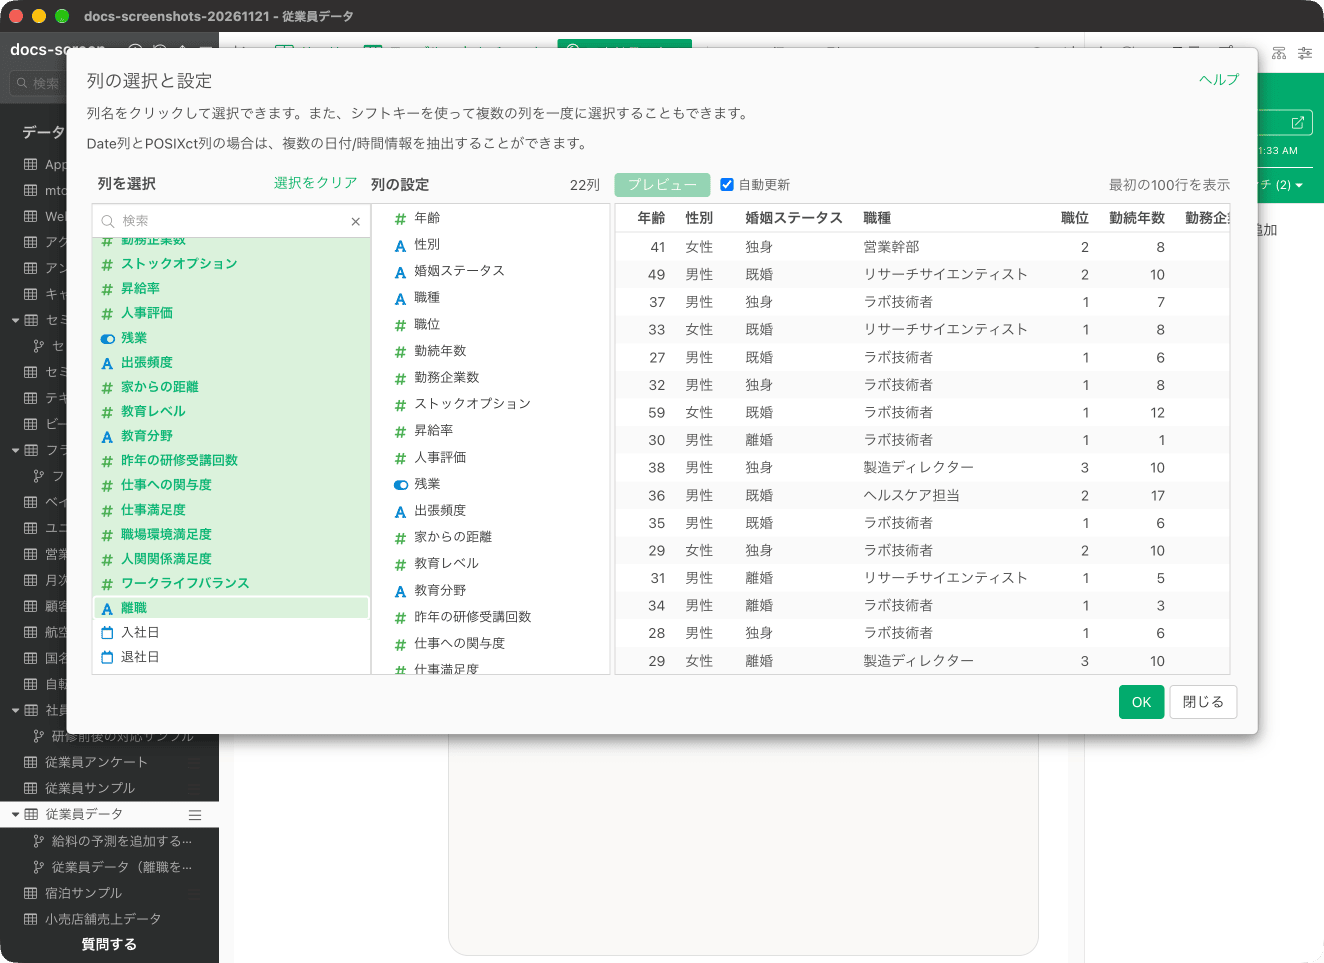
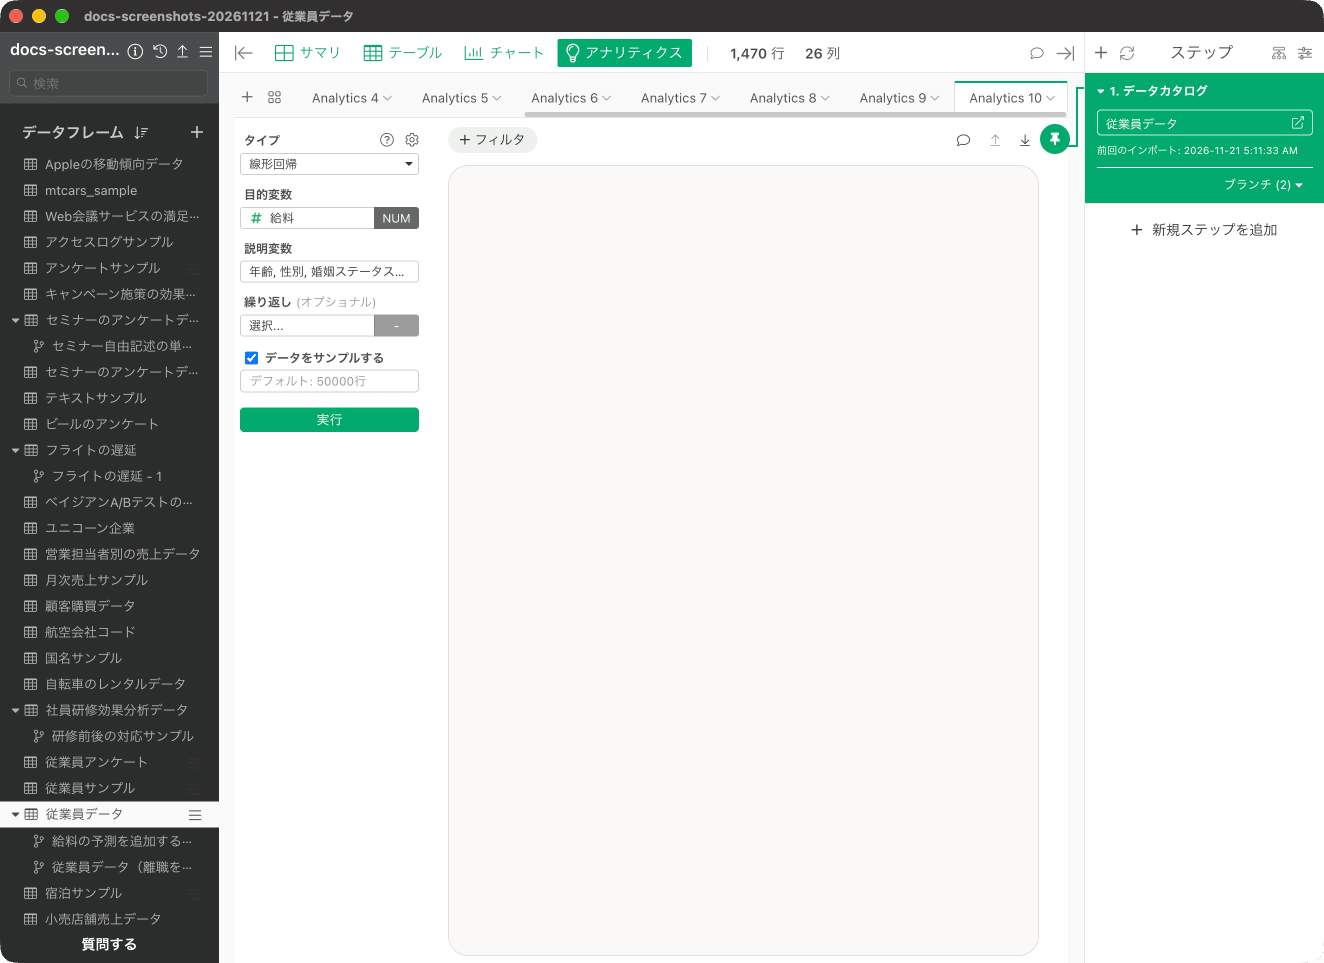
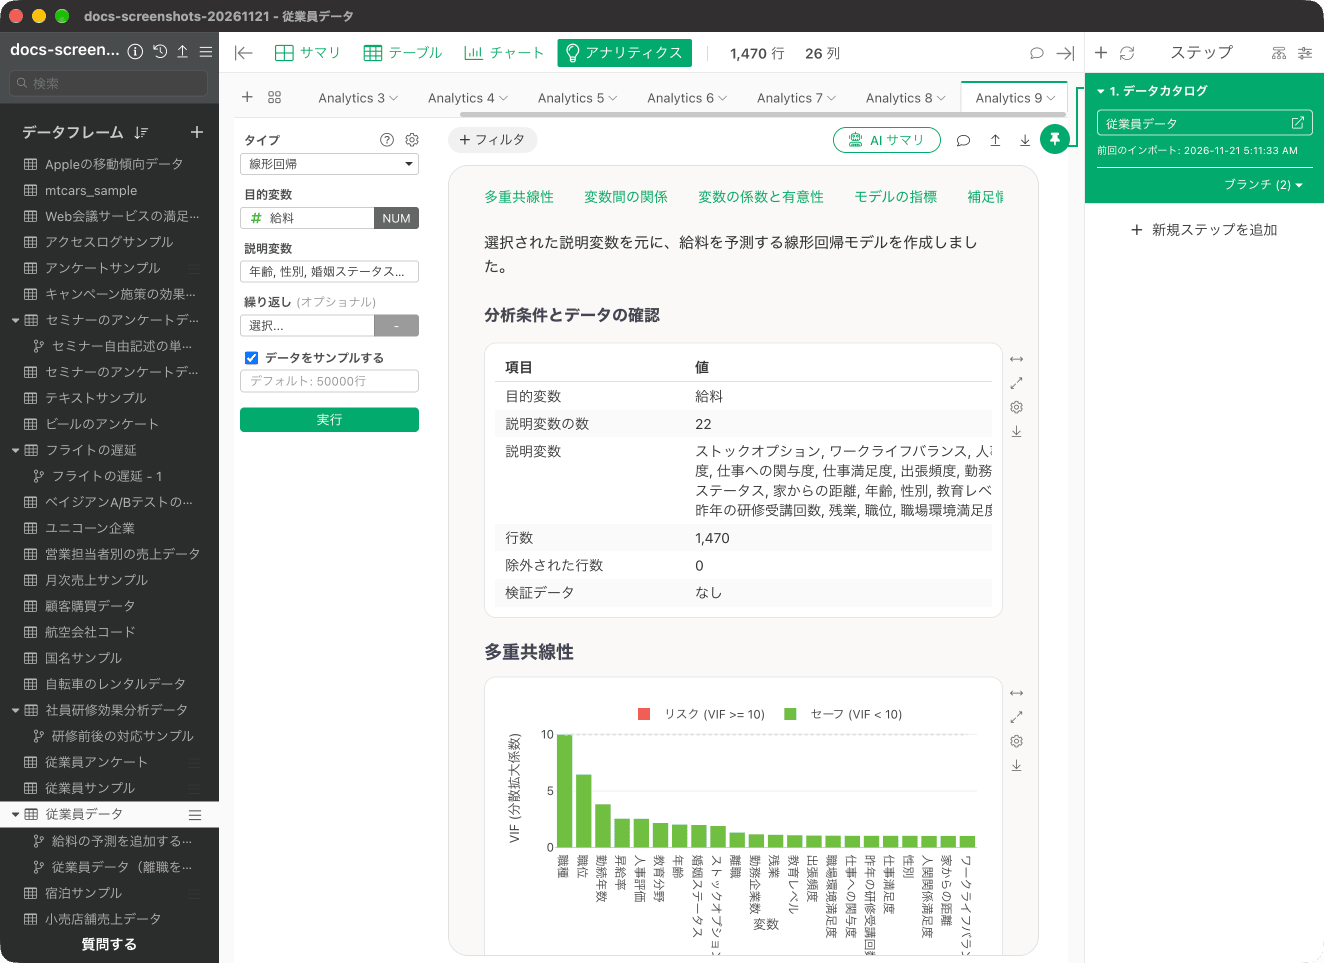
線形回帰のモデルを作成する
今回は従業員の「給料」を予測する線形回帰のモデルを作成します。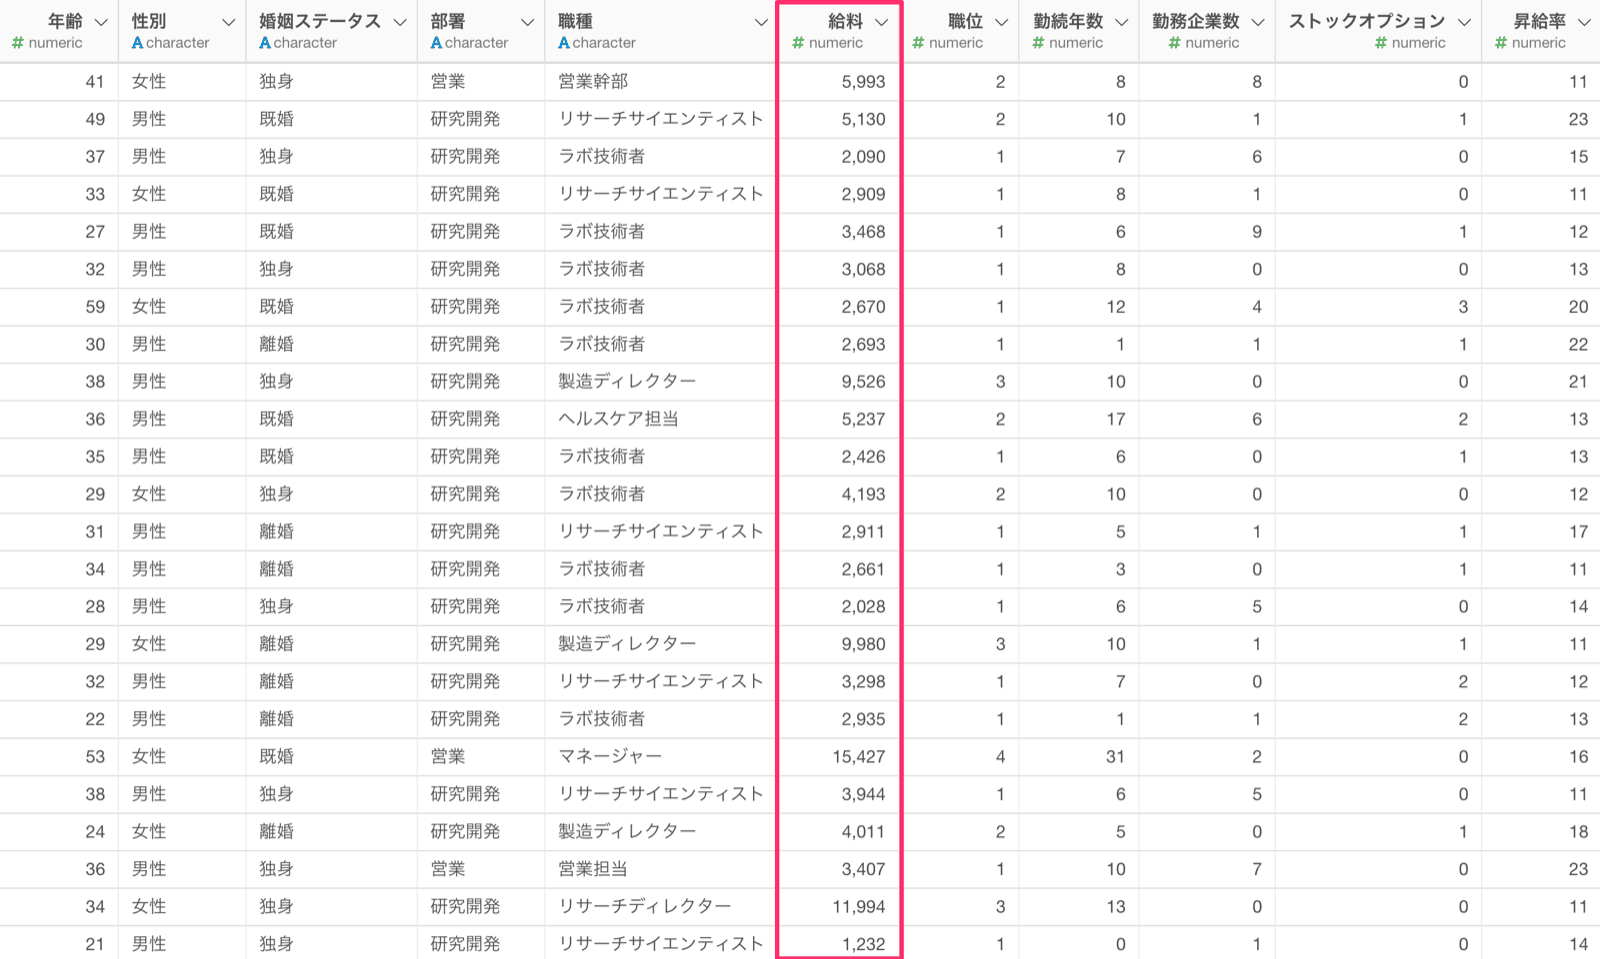
結果の解釈
説明変数の重要度
「変数間の関係」にある「説明変数の重要度」では、給料を予測するためにどの説明変数が相対的により重要なのかを調べることができます。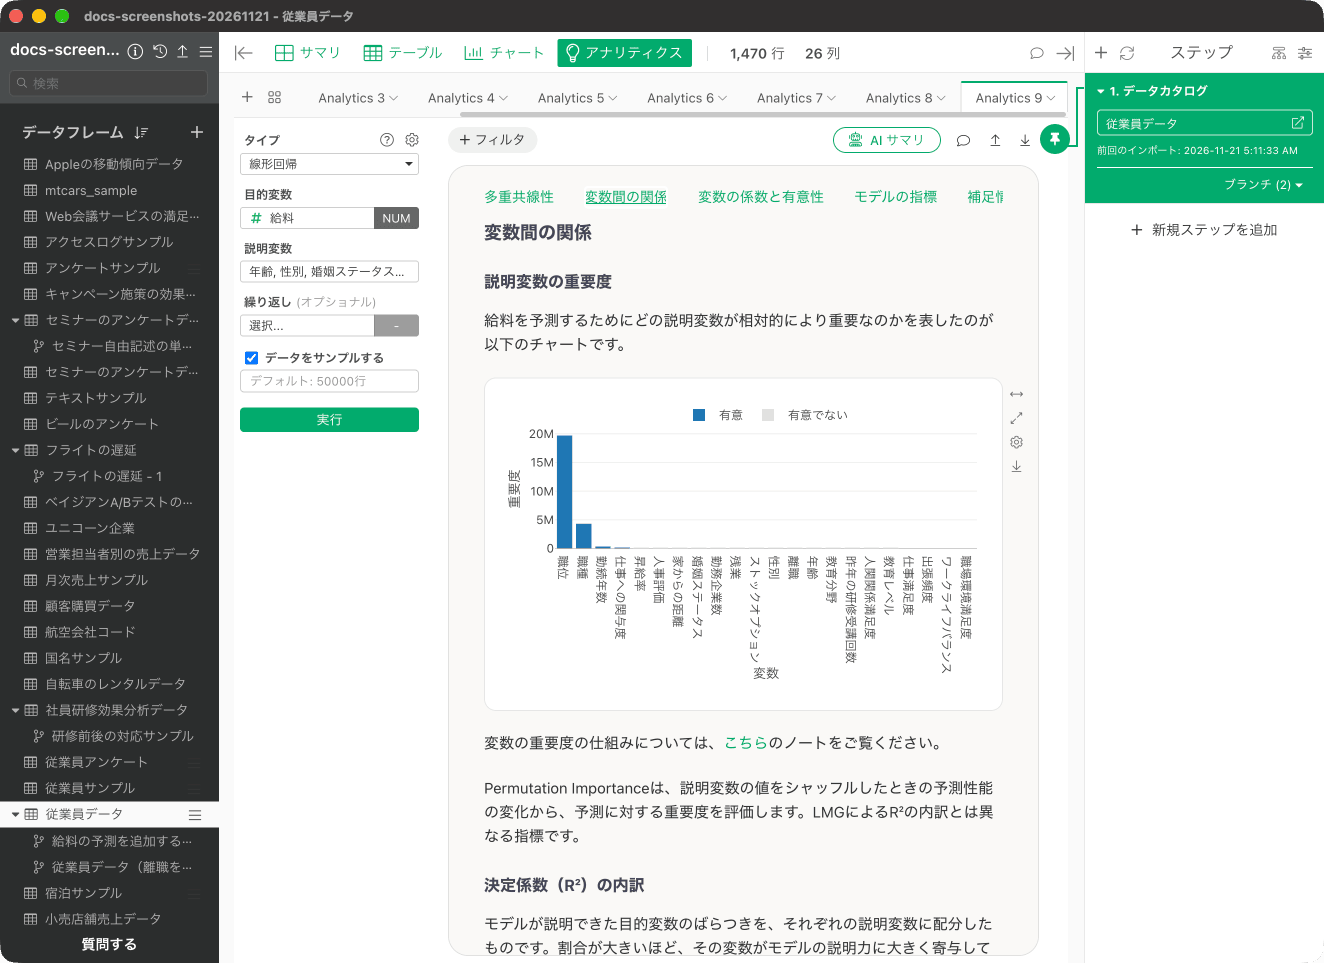
説明変数の影響度
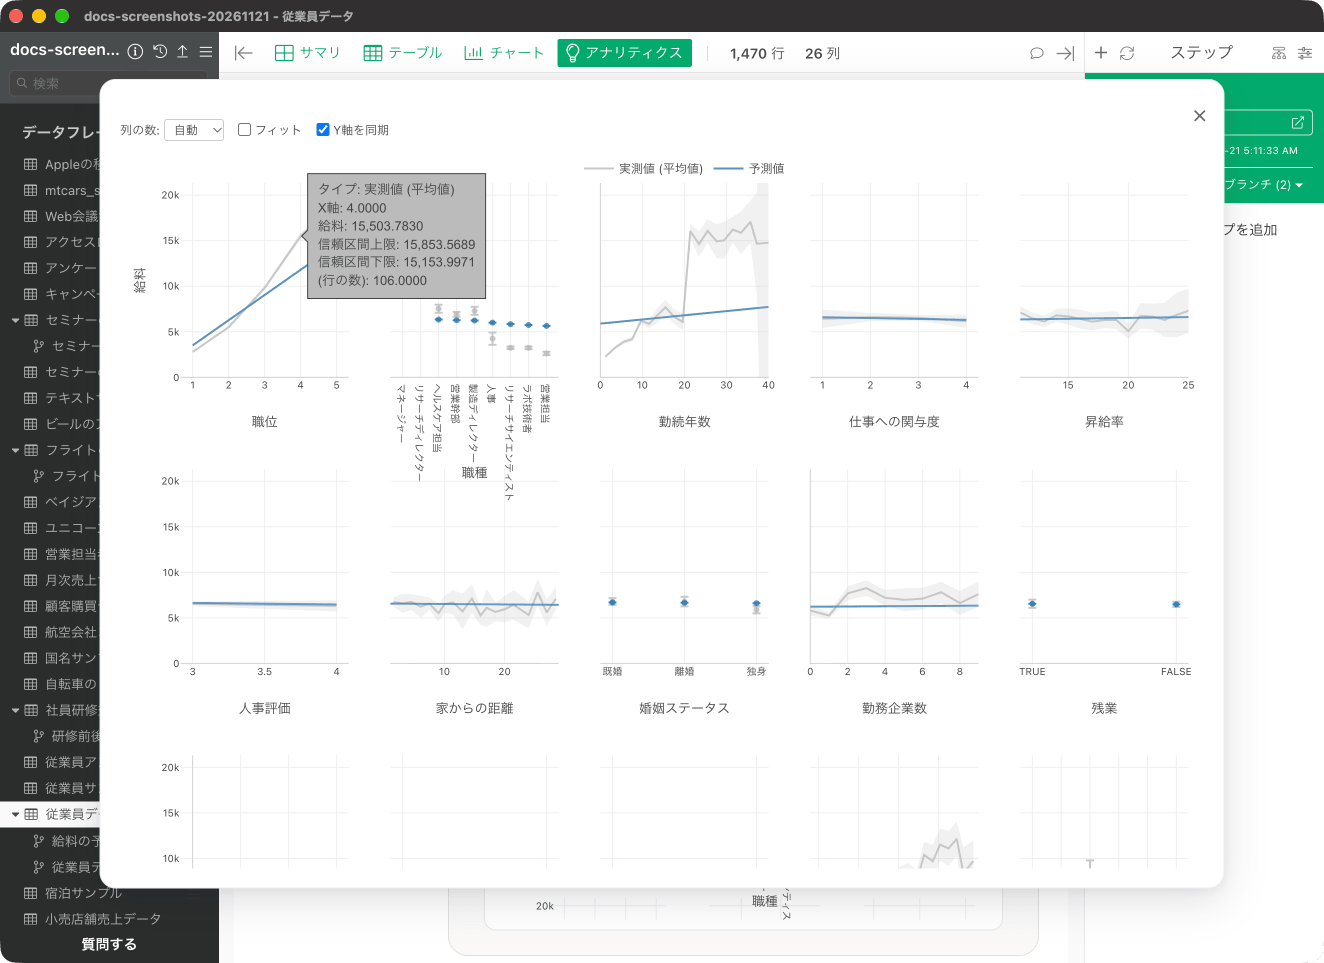
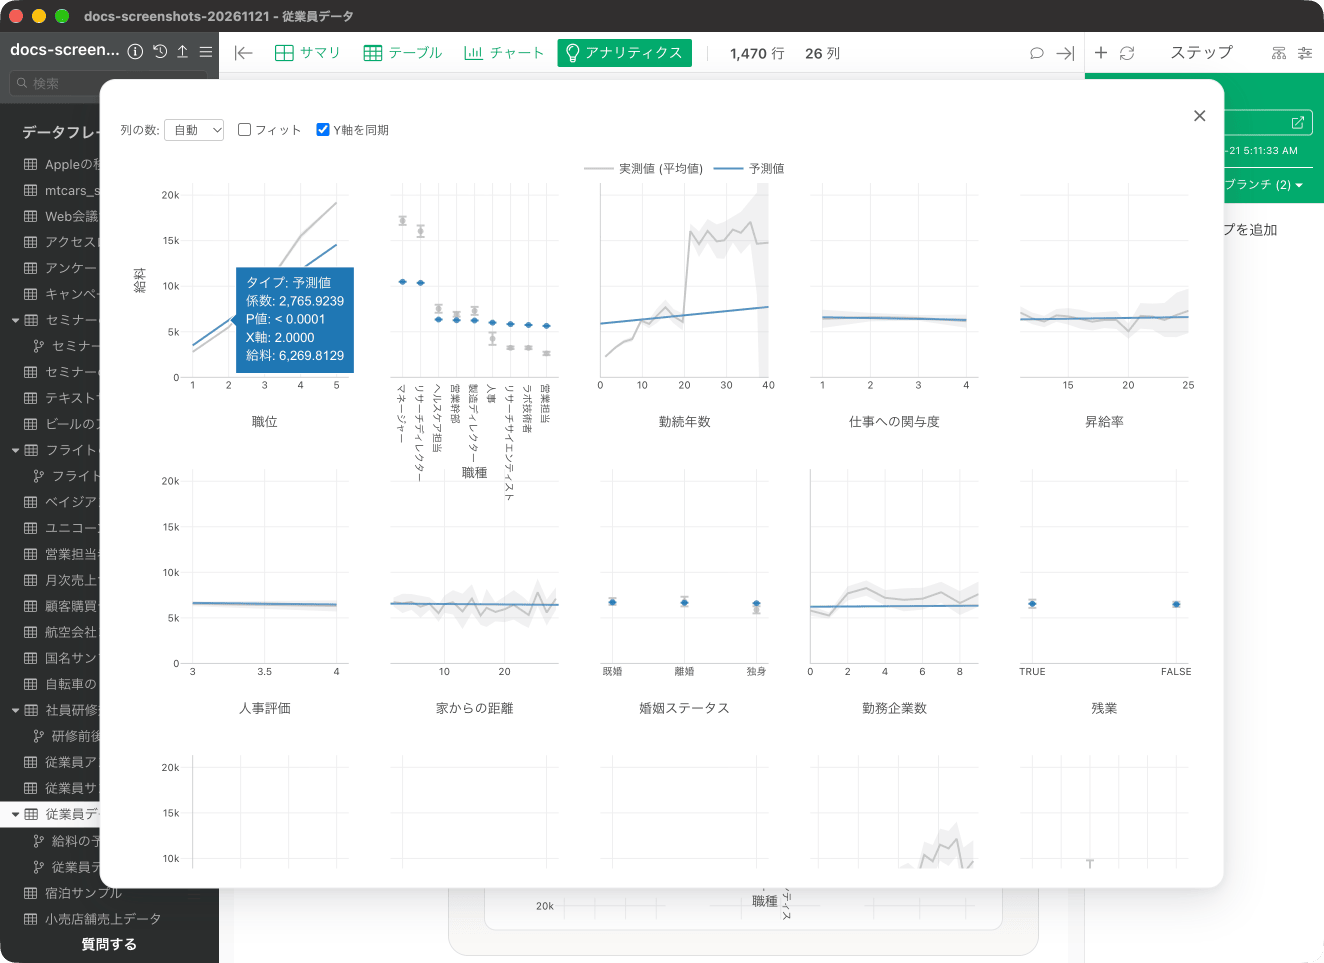
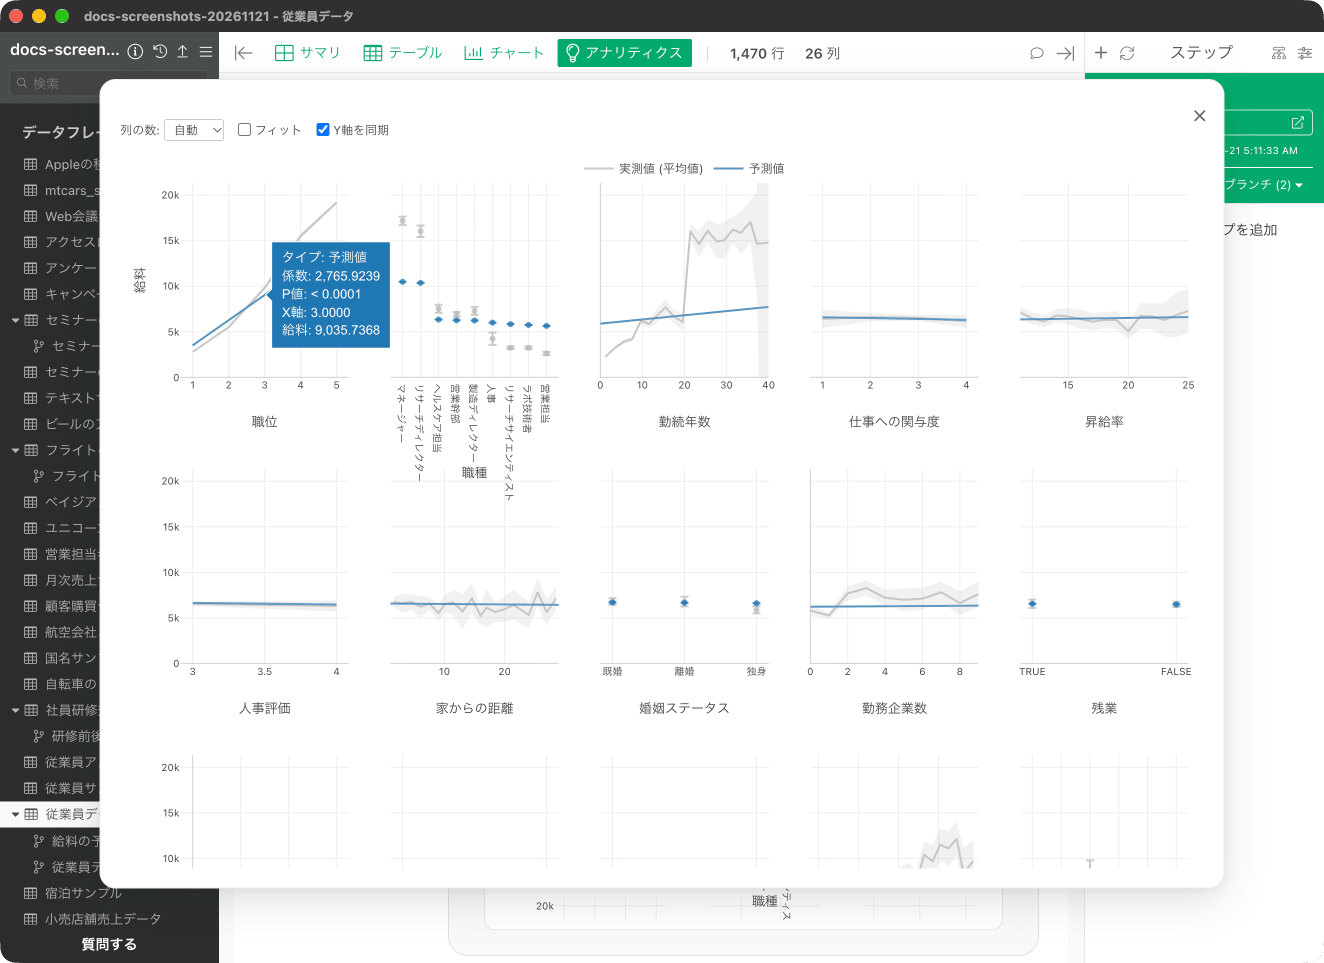
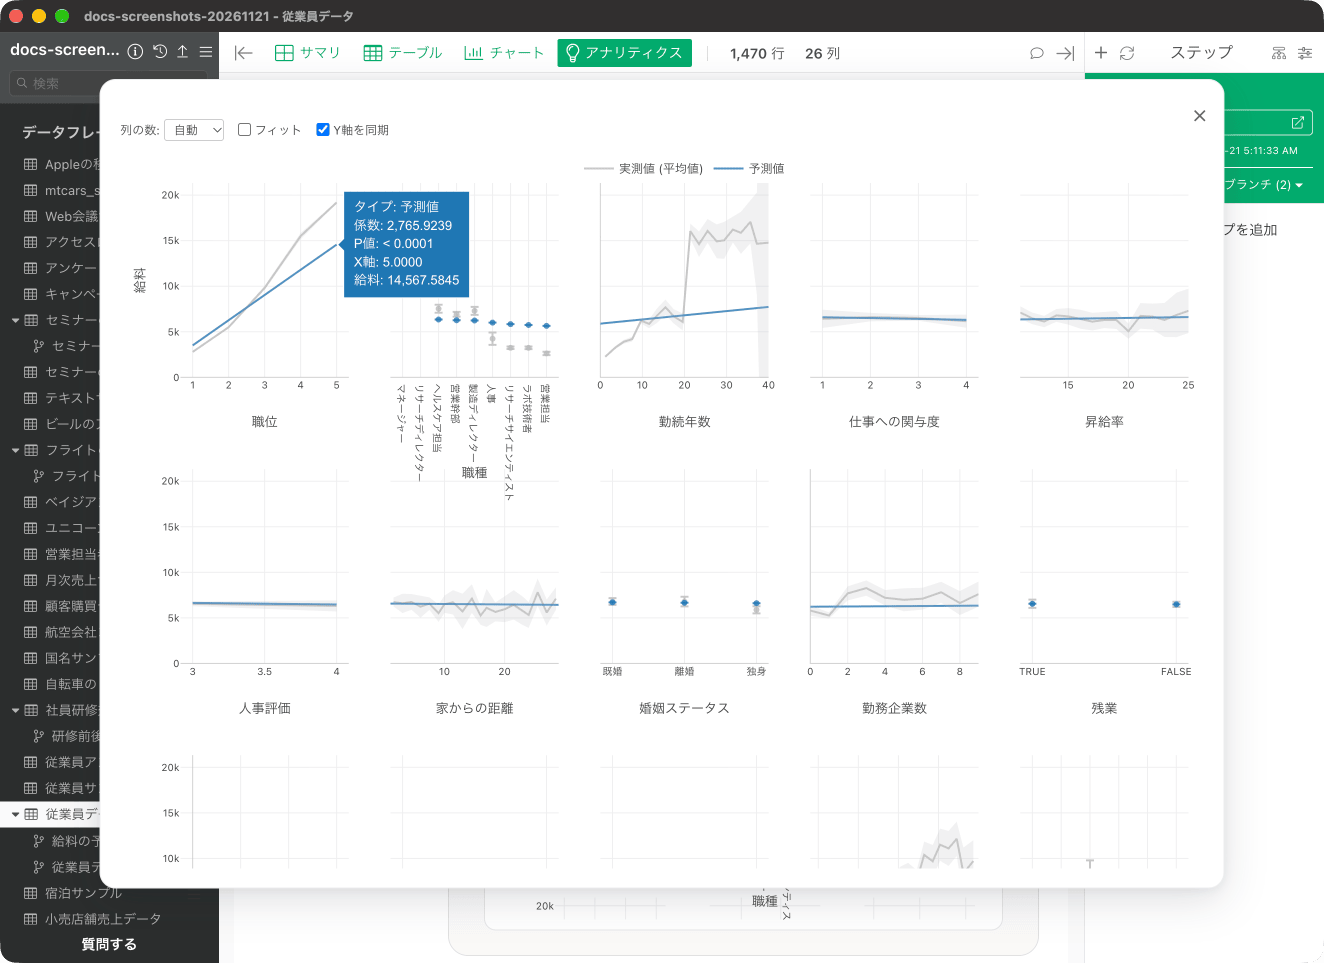
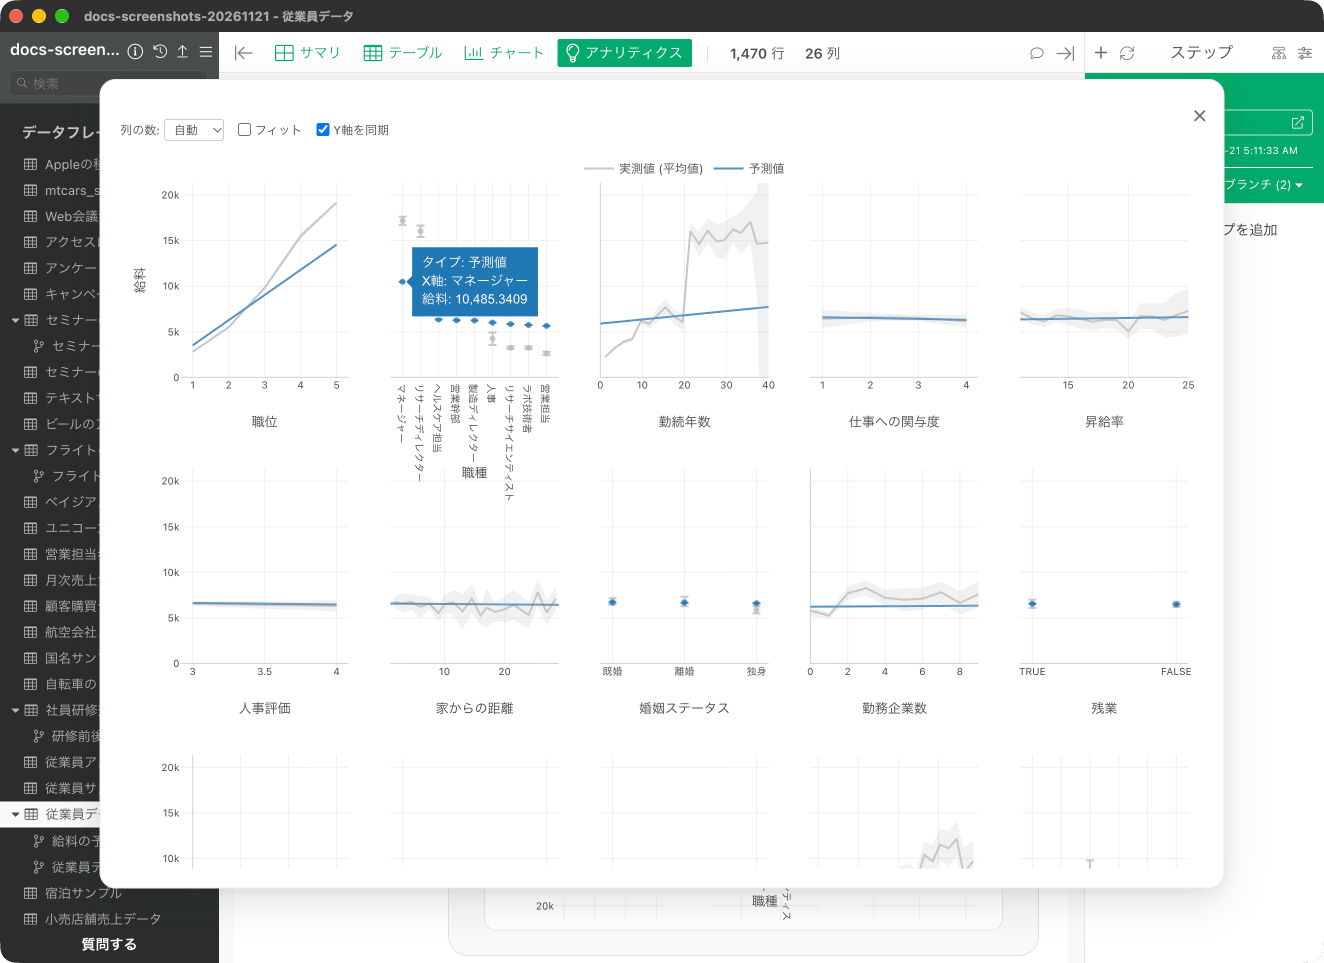
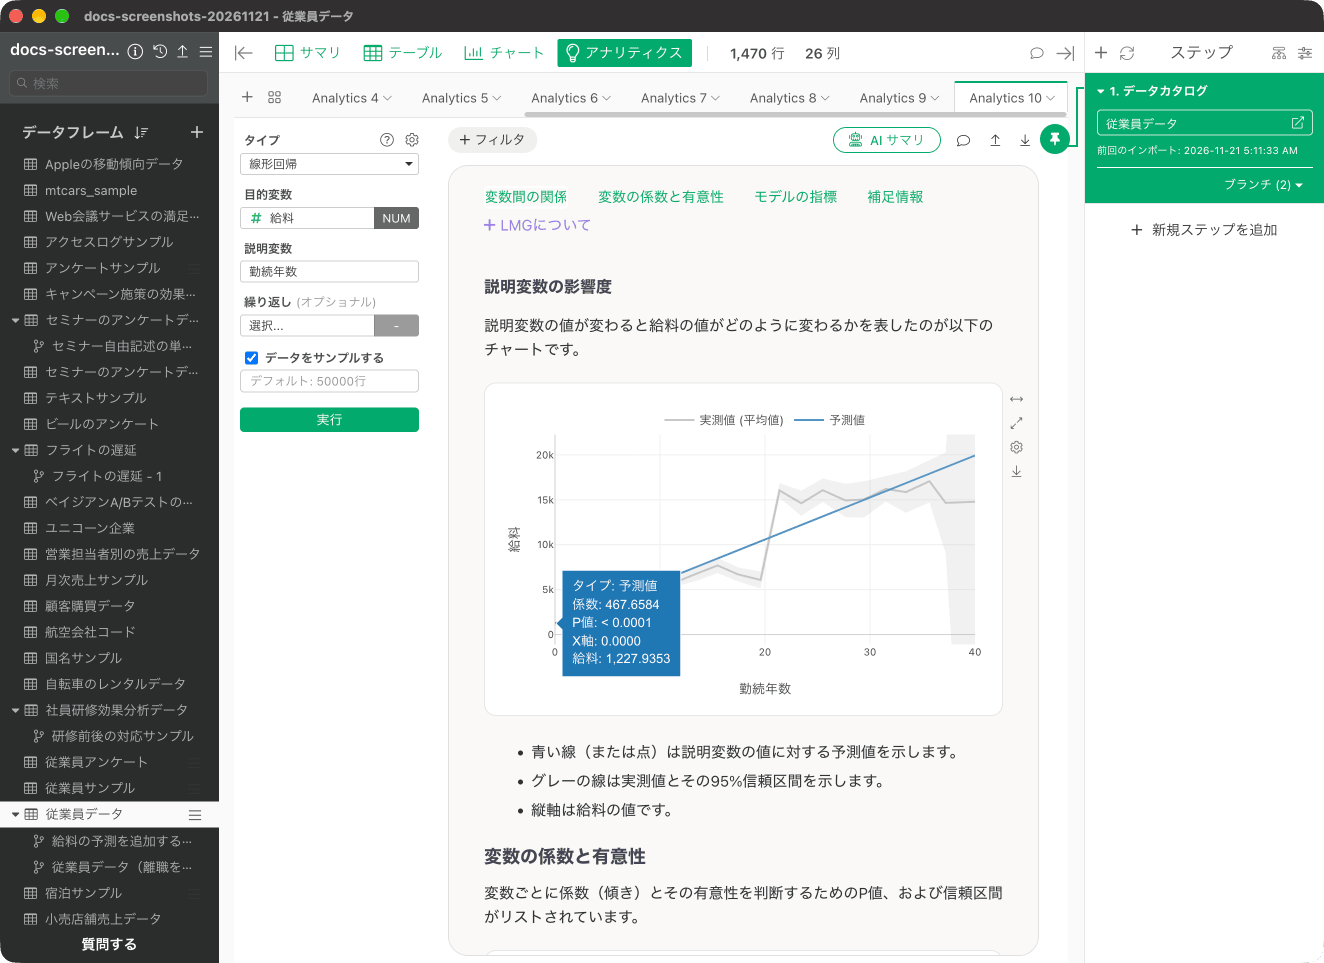
「変数間の関係」の「説明変数の影響度」では、他の変数の値が一定であったとき、それぞれの説明変数の値が変わると給料の値がどのように変わるのかがわかります。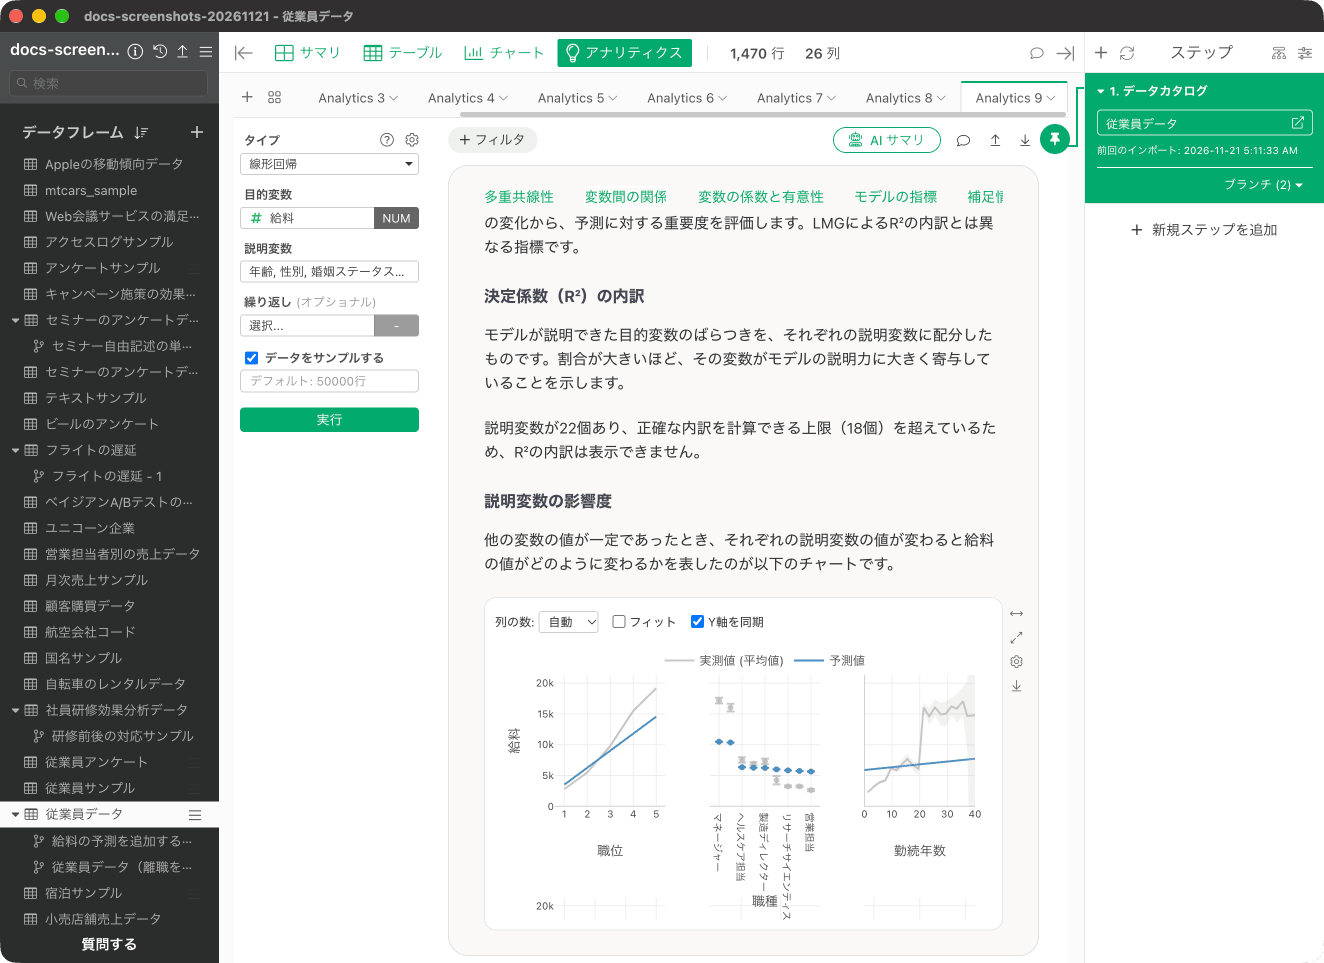
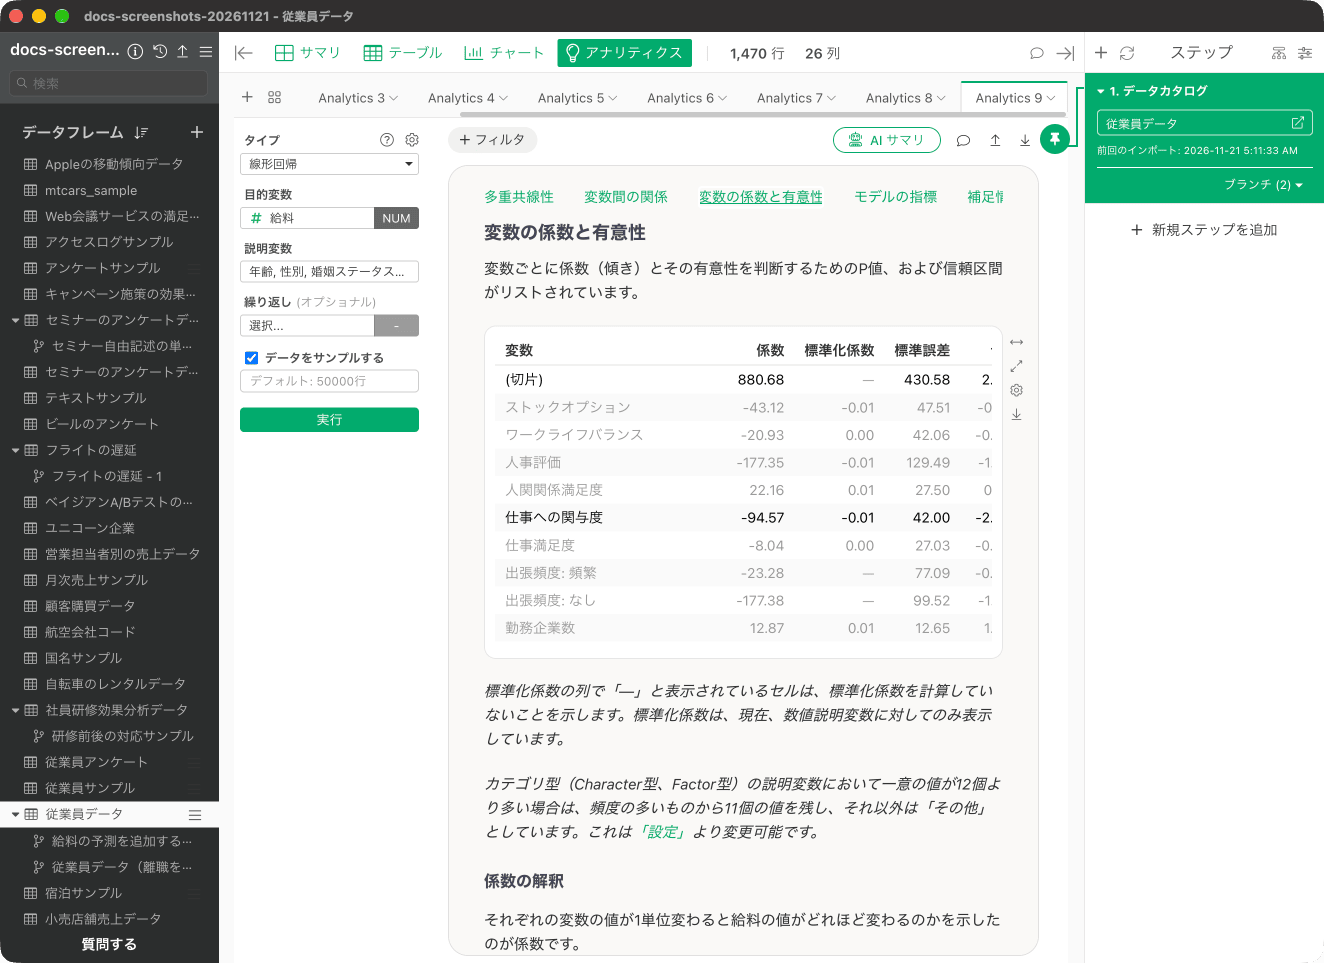
変数の係数と有意性
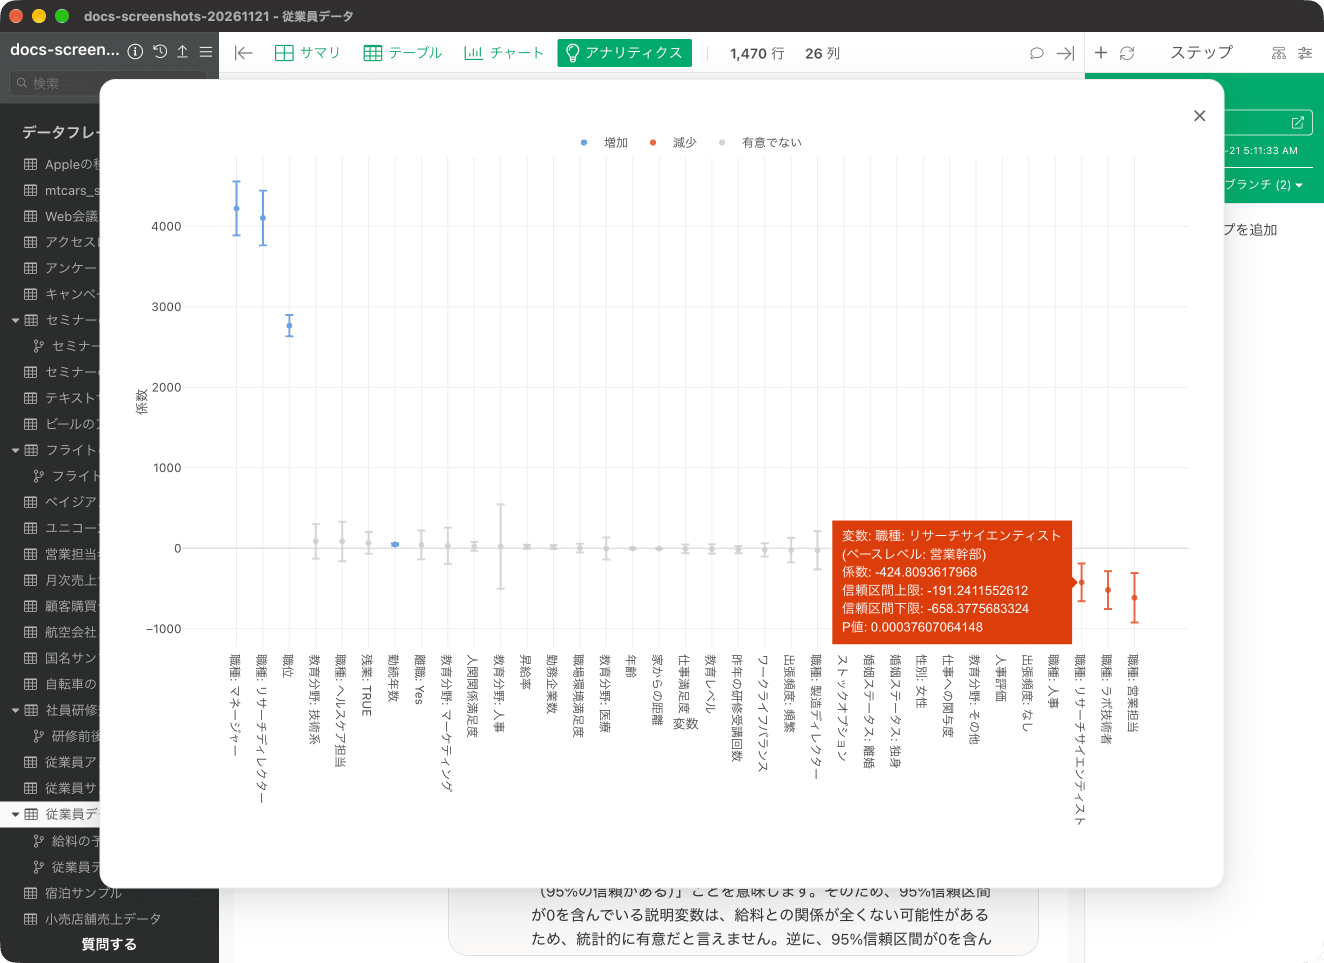
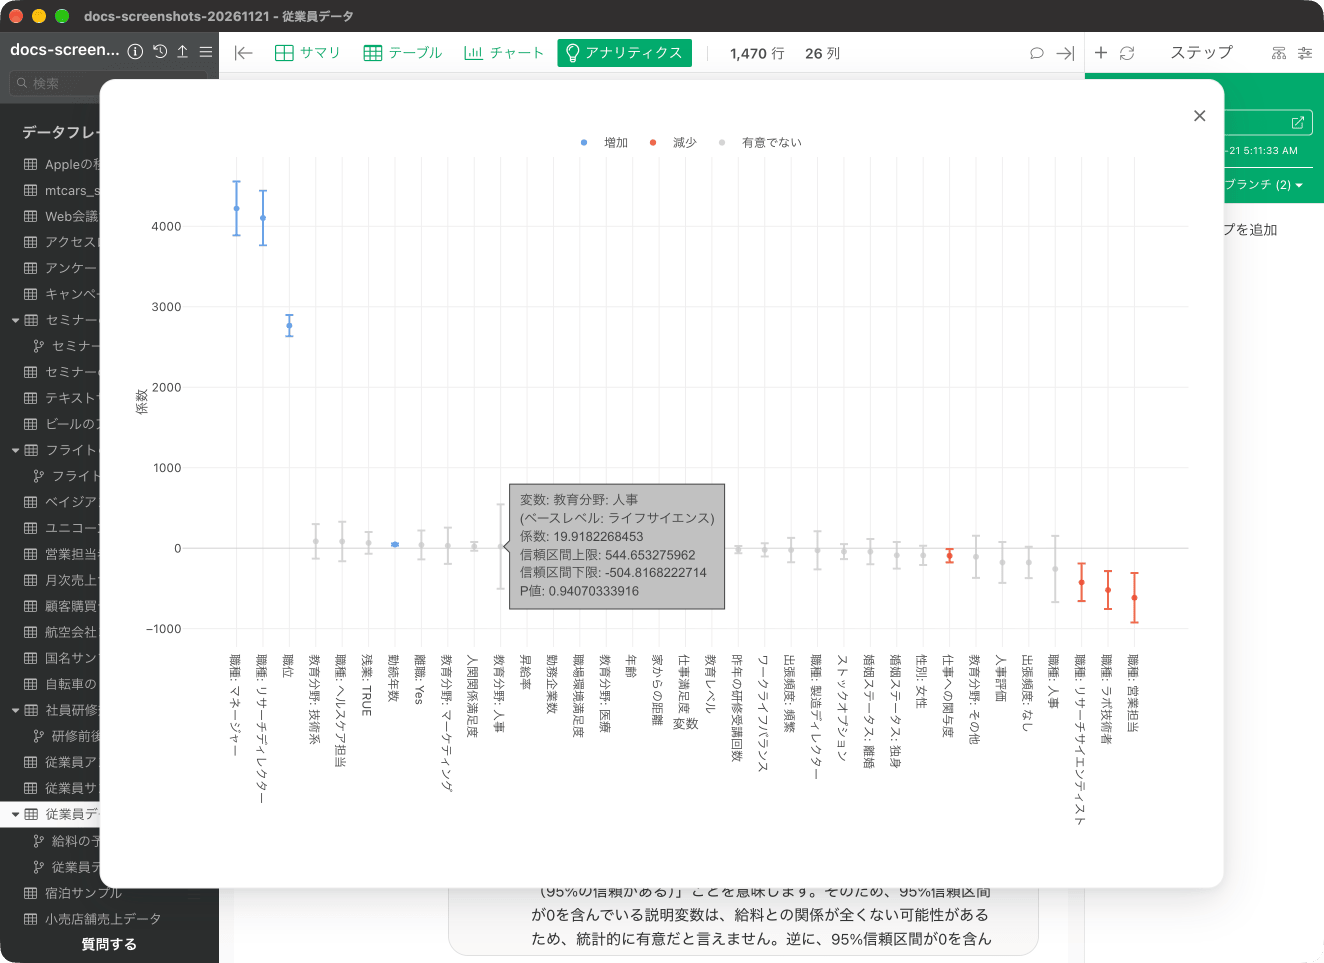
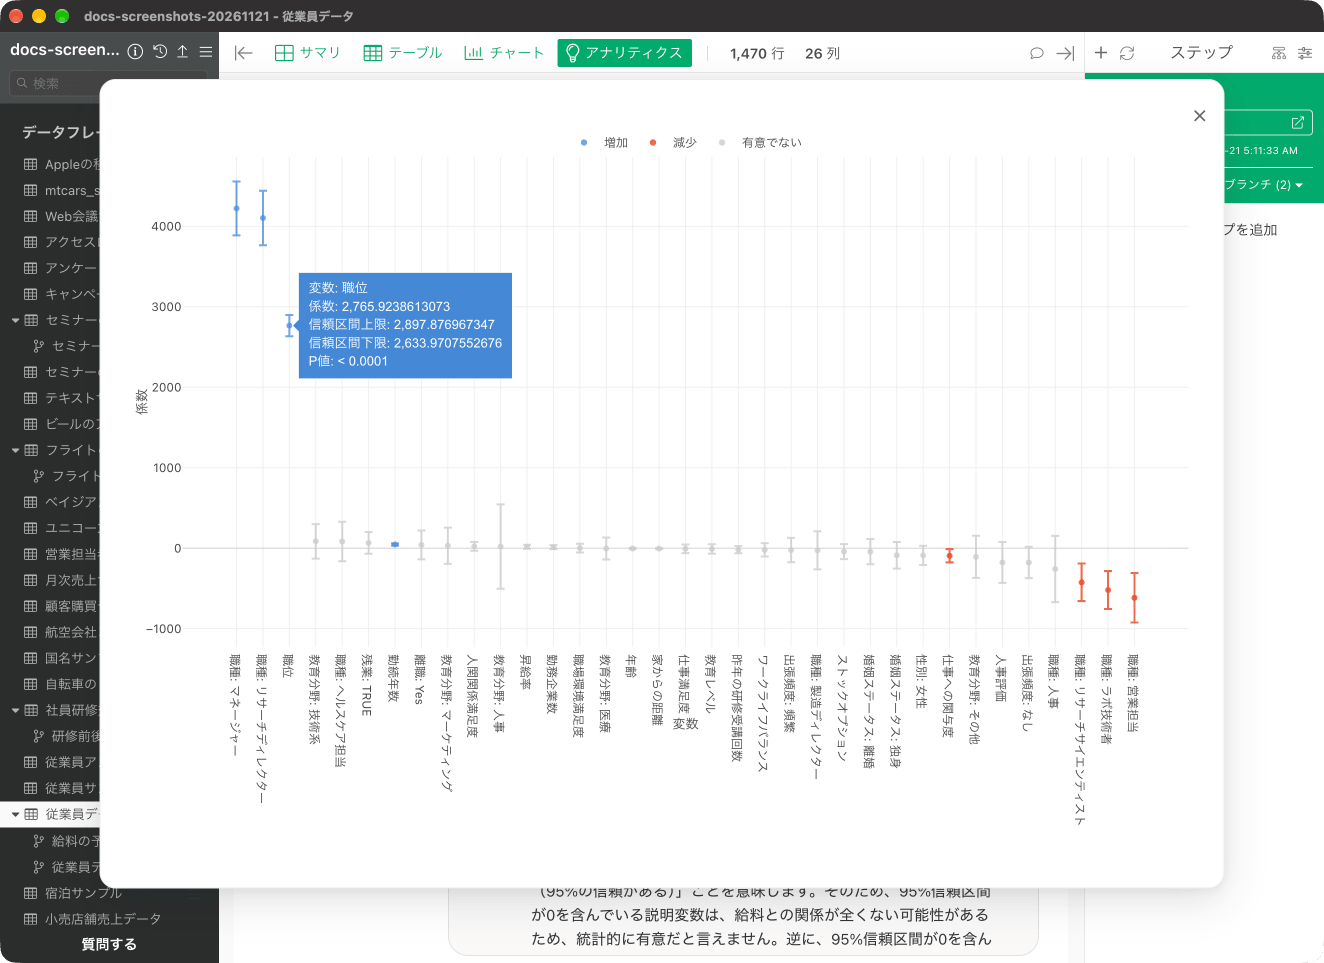
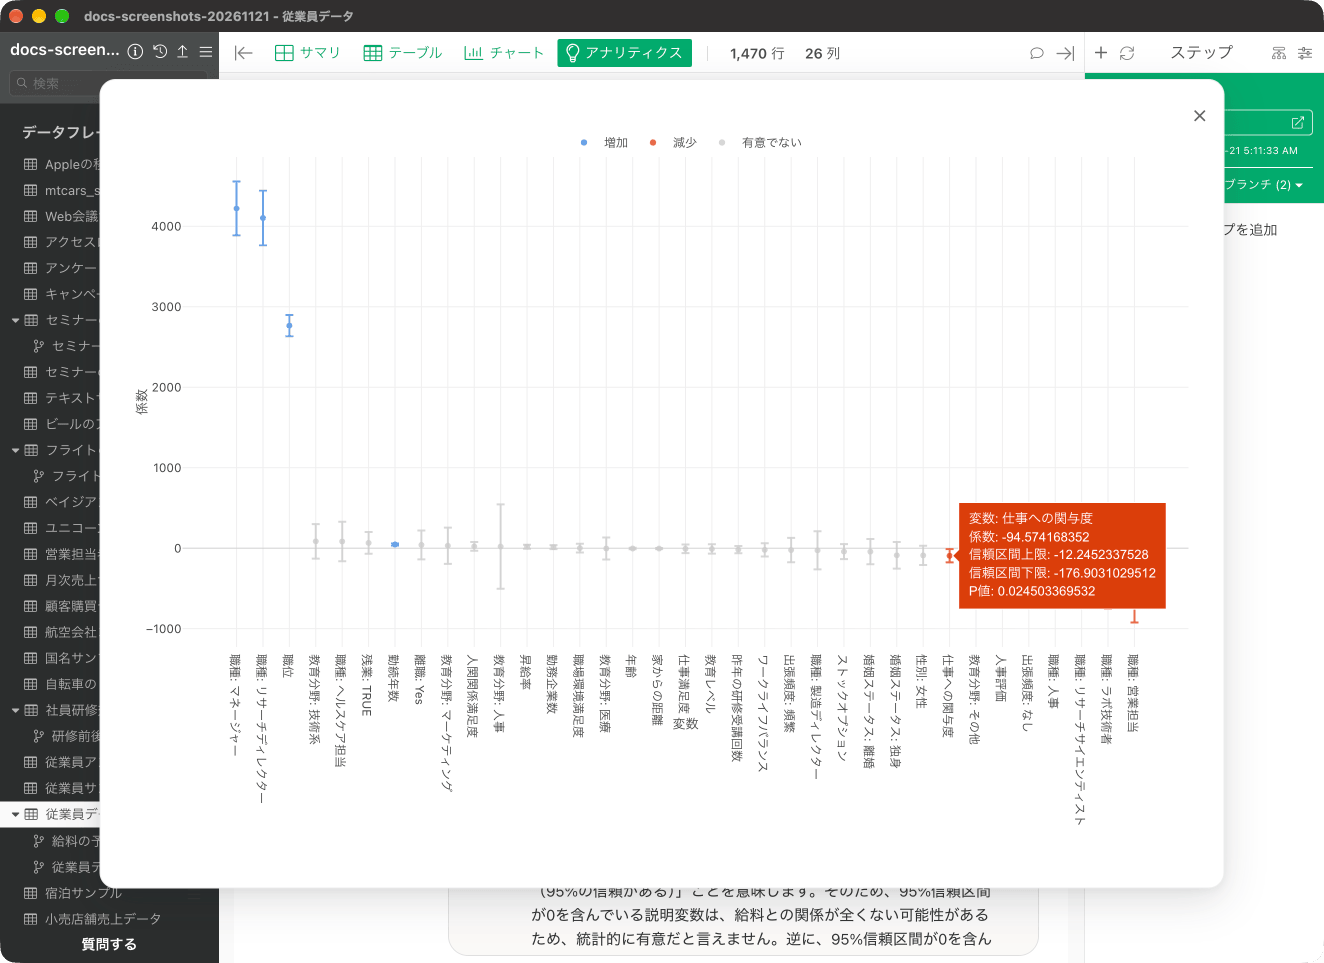
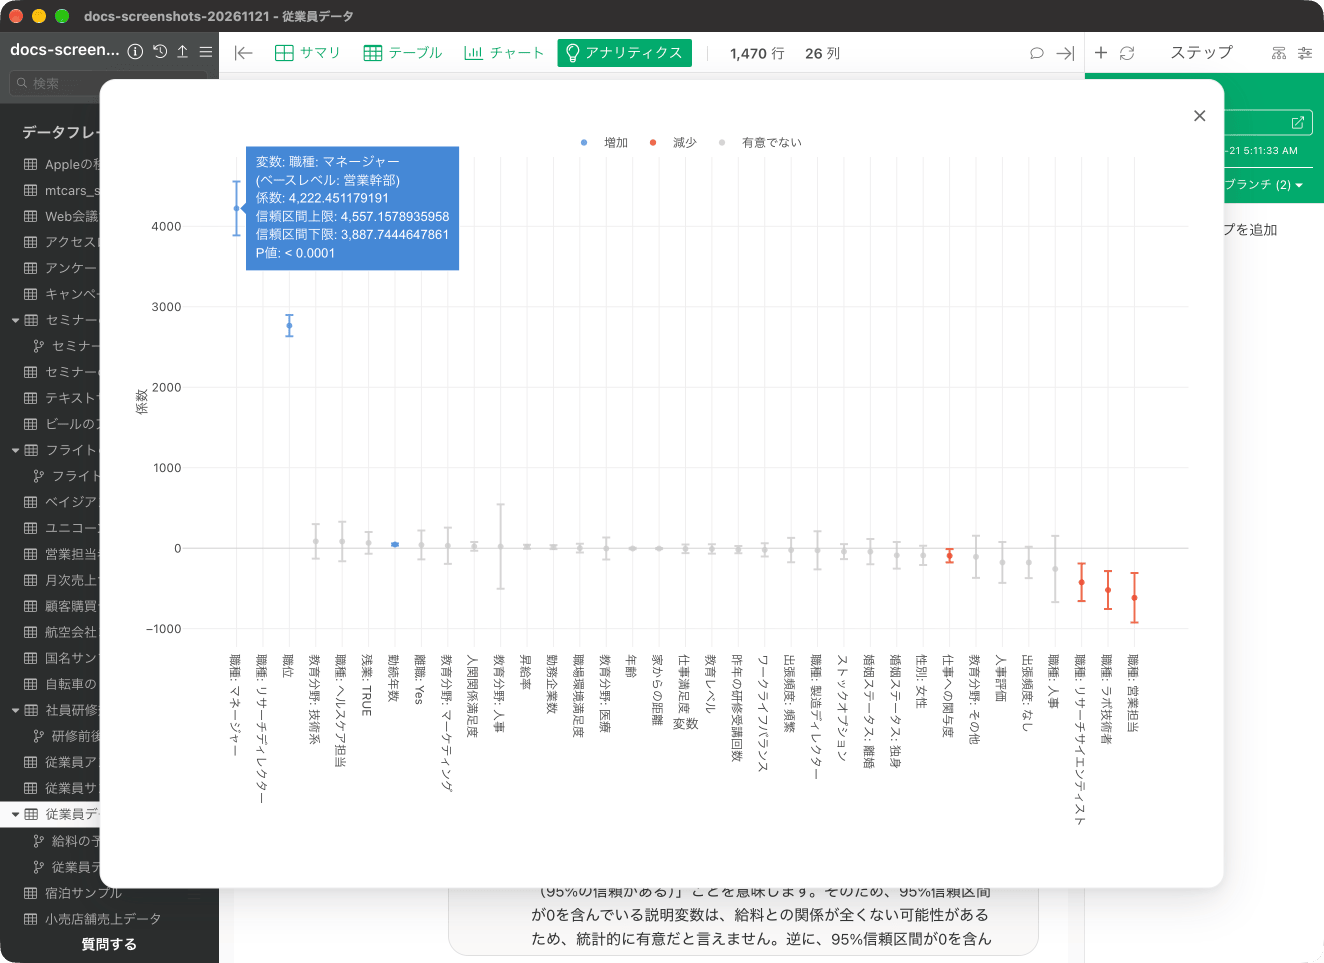
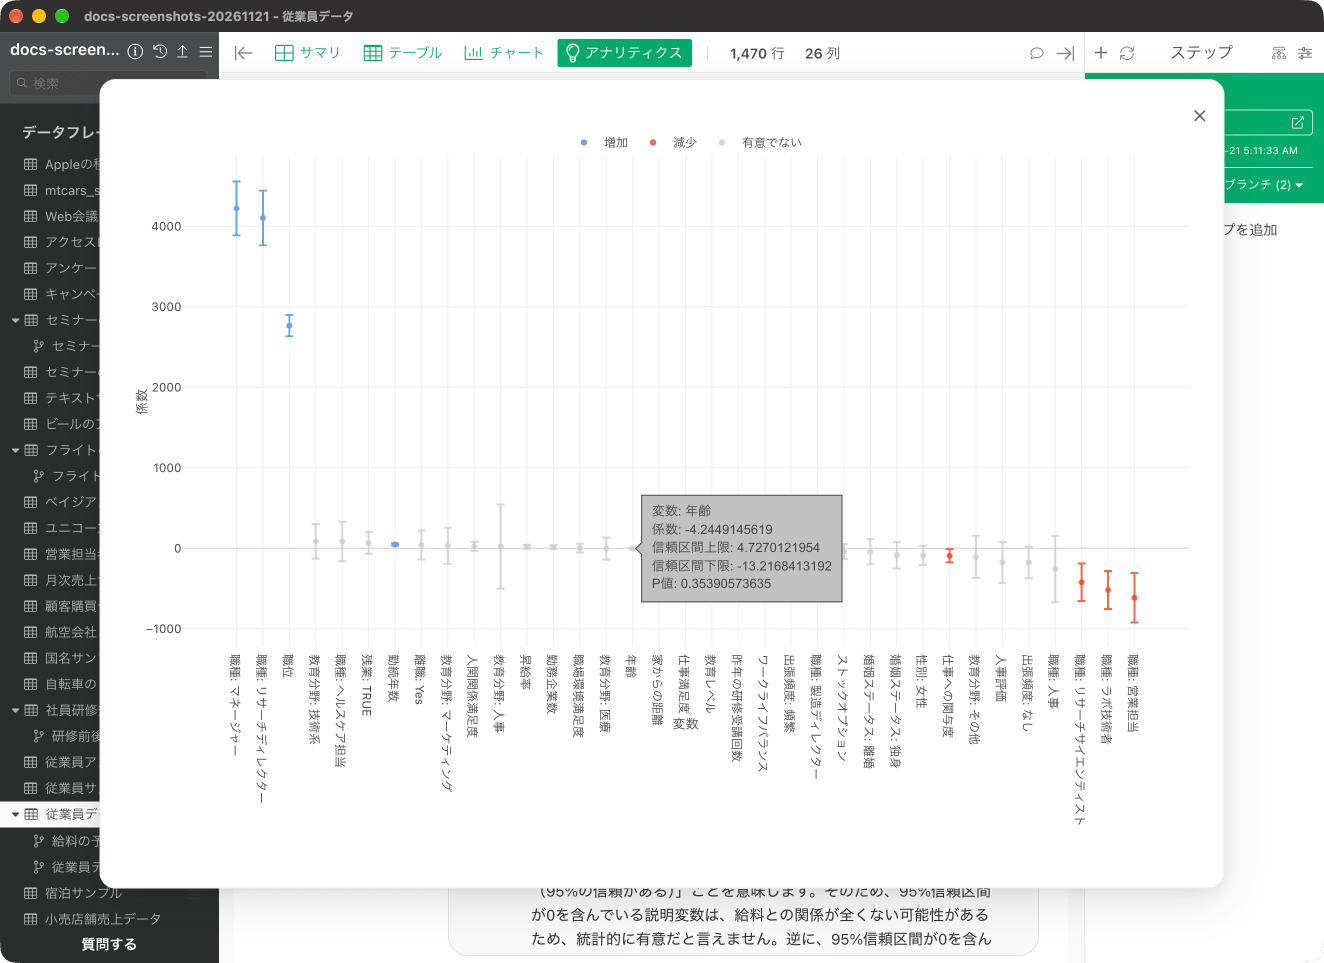
「変数の係数と有意性」にある「係数と信頼区間の可視化」では、それぞれの変数の傾きとその信頼区間、有意性がわかります。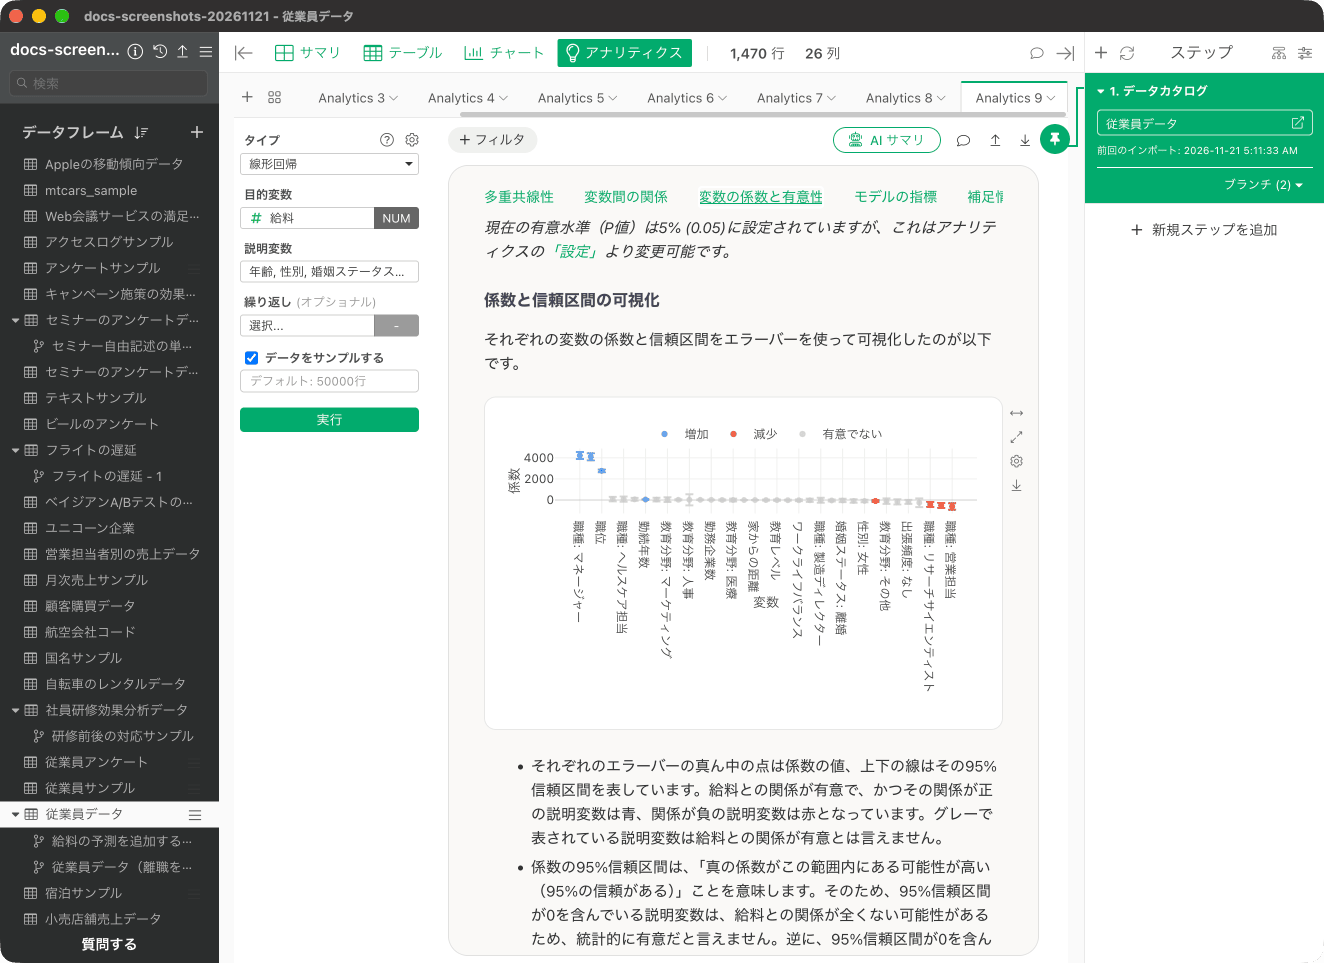
モデルの指標
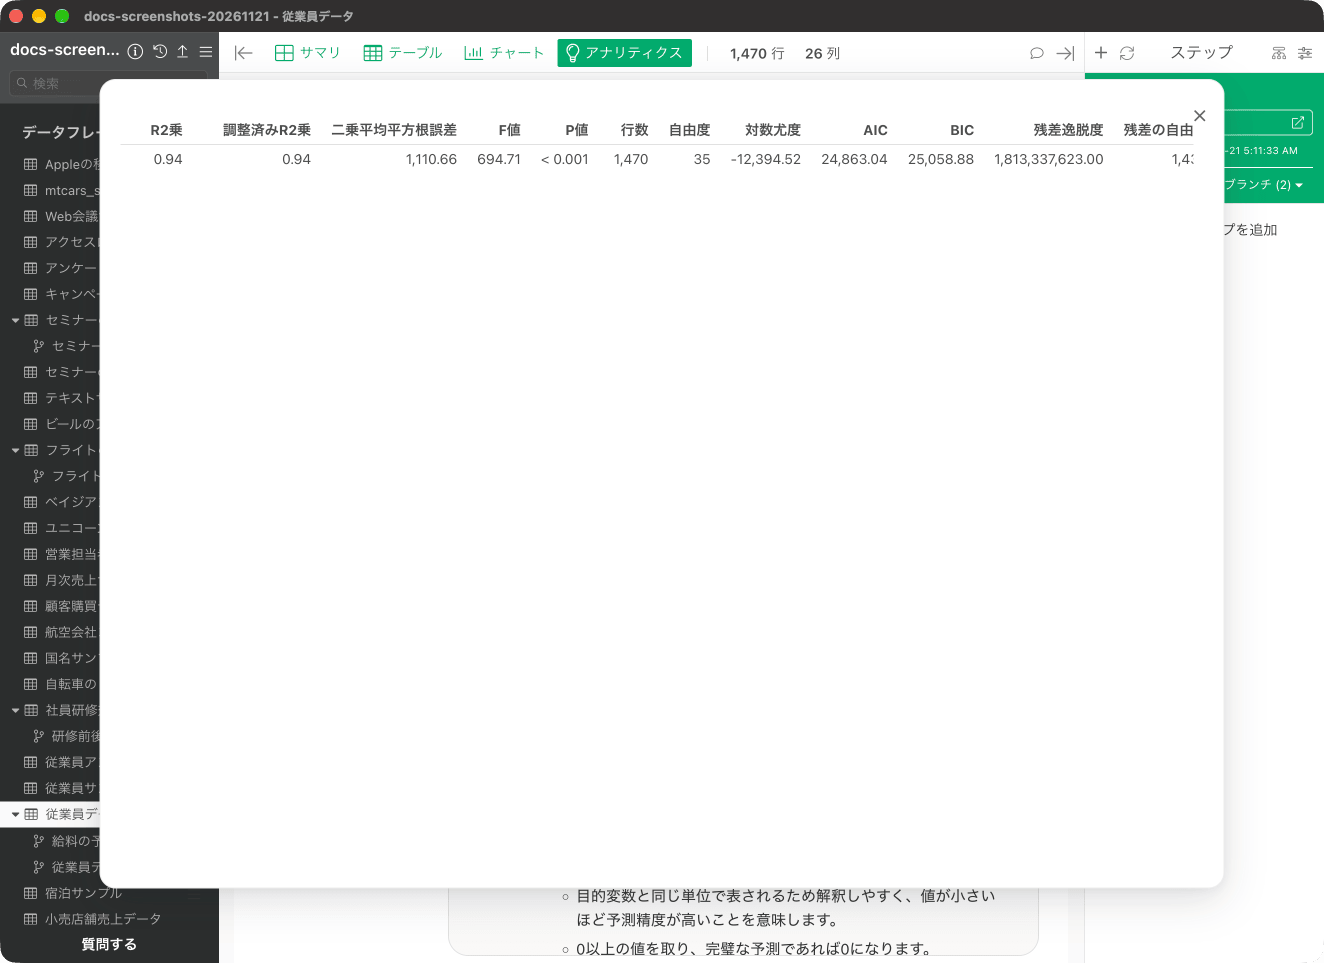
「モデルの指標」では、この予測モデルの評価を確認できます。表には「R2乗」「調整済みR2乗」「二乗平均平方根誤差」「F値」「P値」が並びます。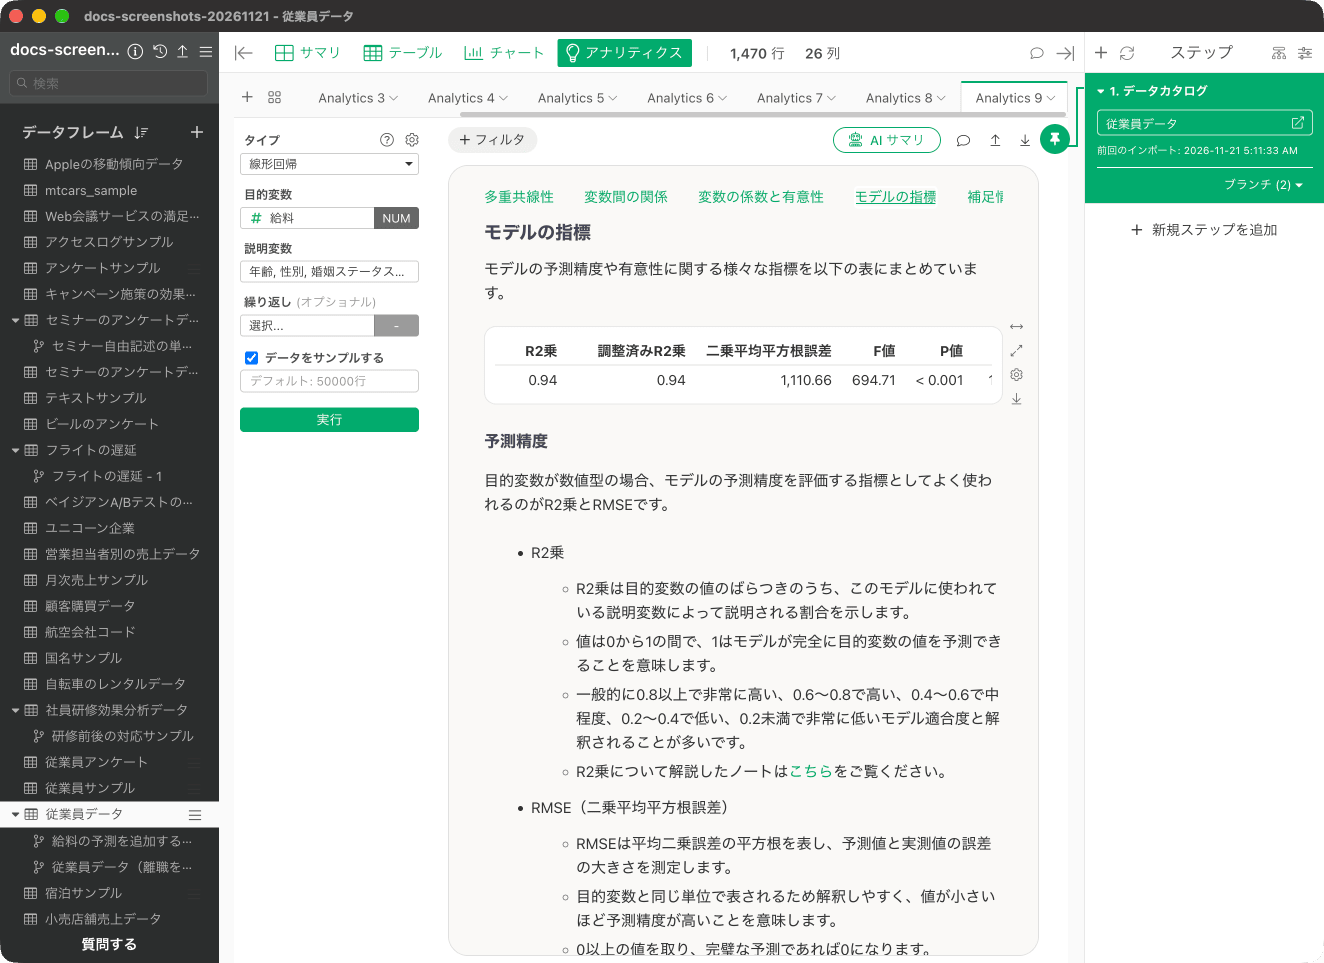
予測結果
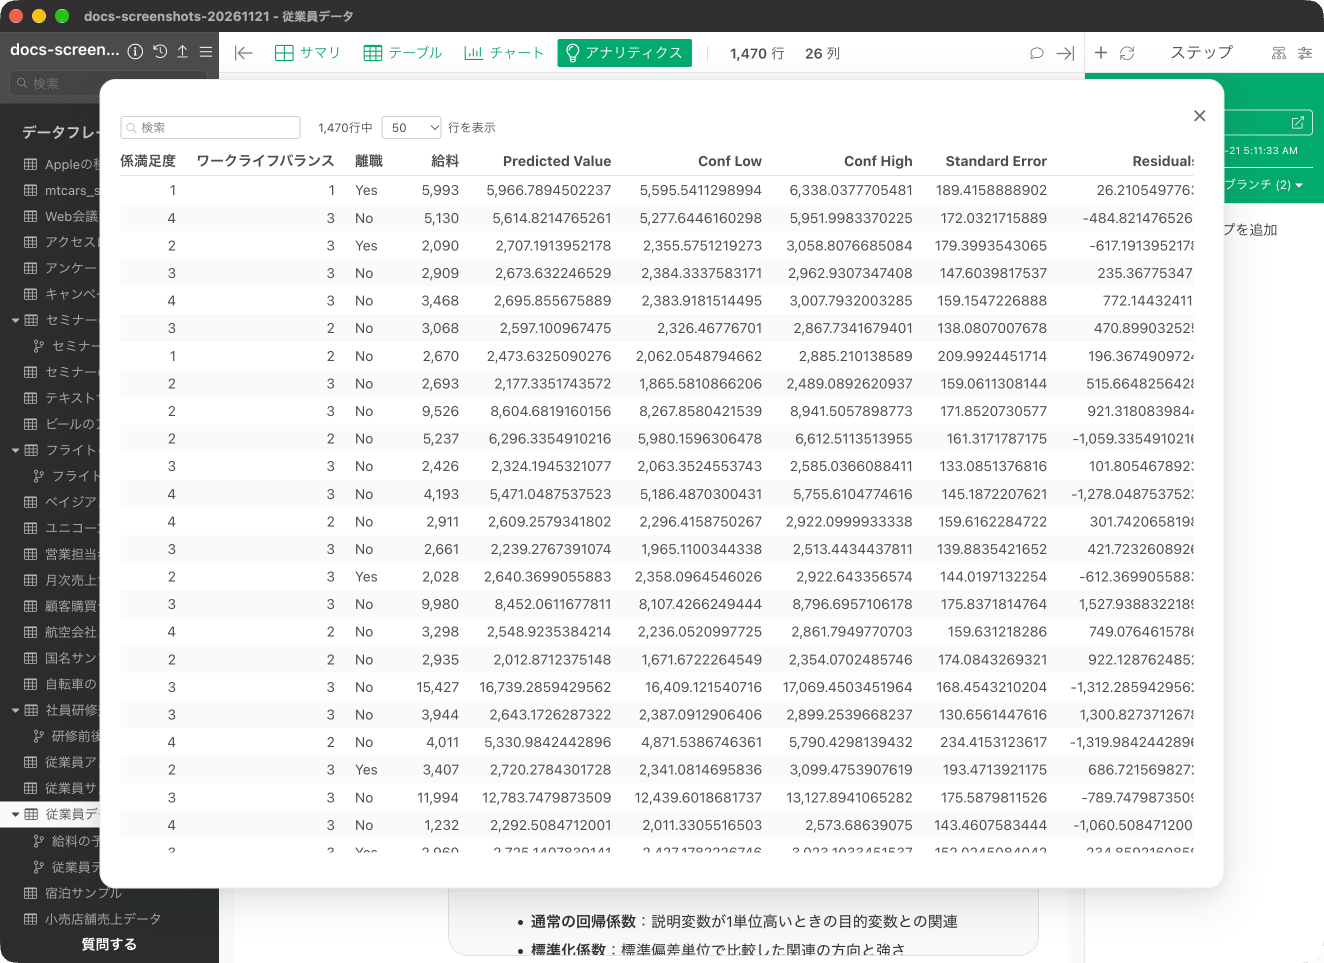
「補足情報」の前にある「トレーニングデータに対する予測」の「予測結果」では、モデルに使用したデータと予測値がテーブル形式で表示されます。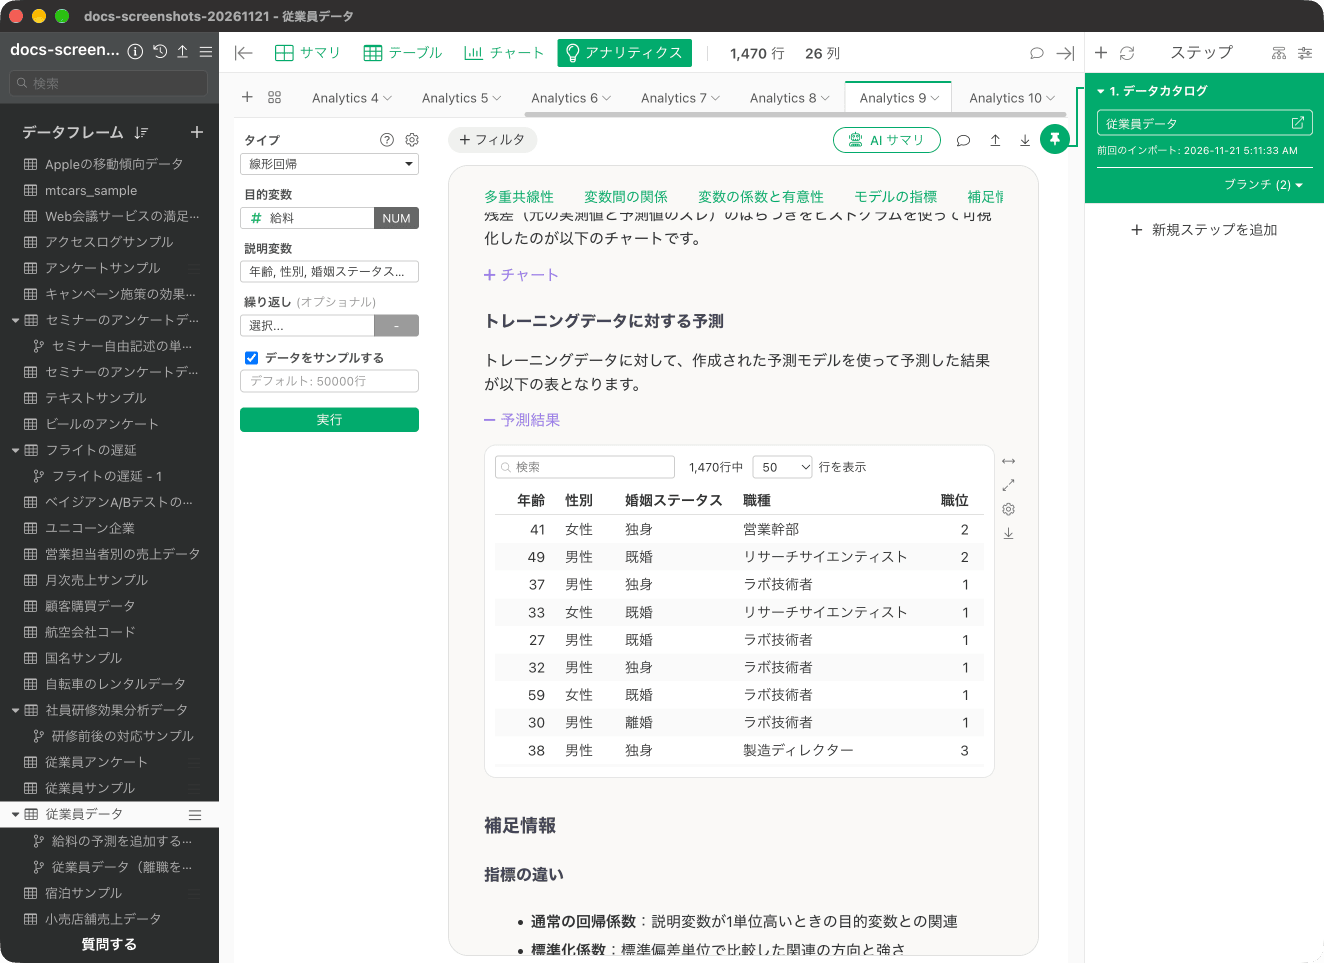
線形回帰に関するよくある質問
Q: 「説明変数の影響度」で表示されている実測値はどのように求められているのですか?
「説明変数の影響度」の実測値はそれぞれの説明変数のデータタイプによって表示が異なります。 詳しくはこちらのノートをご覧ください。Q: 「説明変数の影響度」で表示されている予測値はどのように求められているのですか?
予測値のチャートはPartial Dependence Plot(PDP)と呼ばれるもので、注目している変数の値を変化させたときに、予測結果がどう変わるかを可視化したチャートとなります。詳しくはこちらのノートをご覧ください。Q: 説明変数に割り当てているカテゴリ列の全ての値が表示されない。
線形回帰で説明変数にカテゴリ列を割り当てた際は、一意な値の数が12個より多い時は、頻度の多いものから11個の値を残し、それ以外は「その他」としてまとめられます。「設定」の「データの前処理」にある「説明変数のカテゴリ数の最大値」(初期値は12)を変更していただくことで、使用するカテゴリ数を調整いただけます。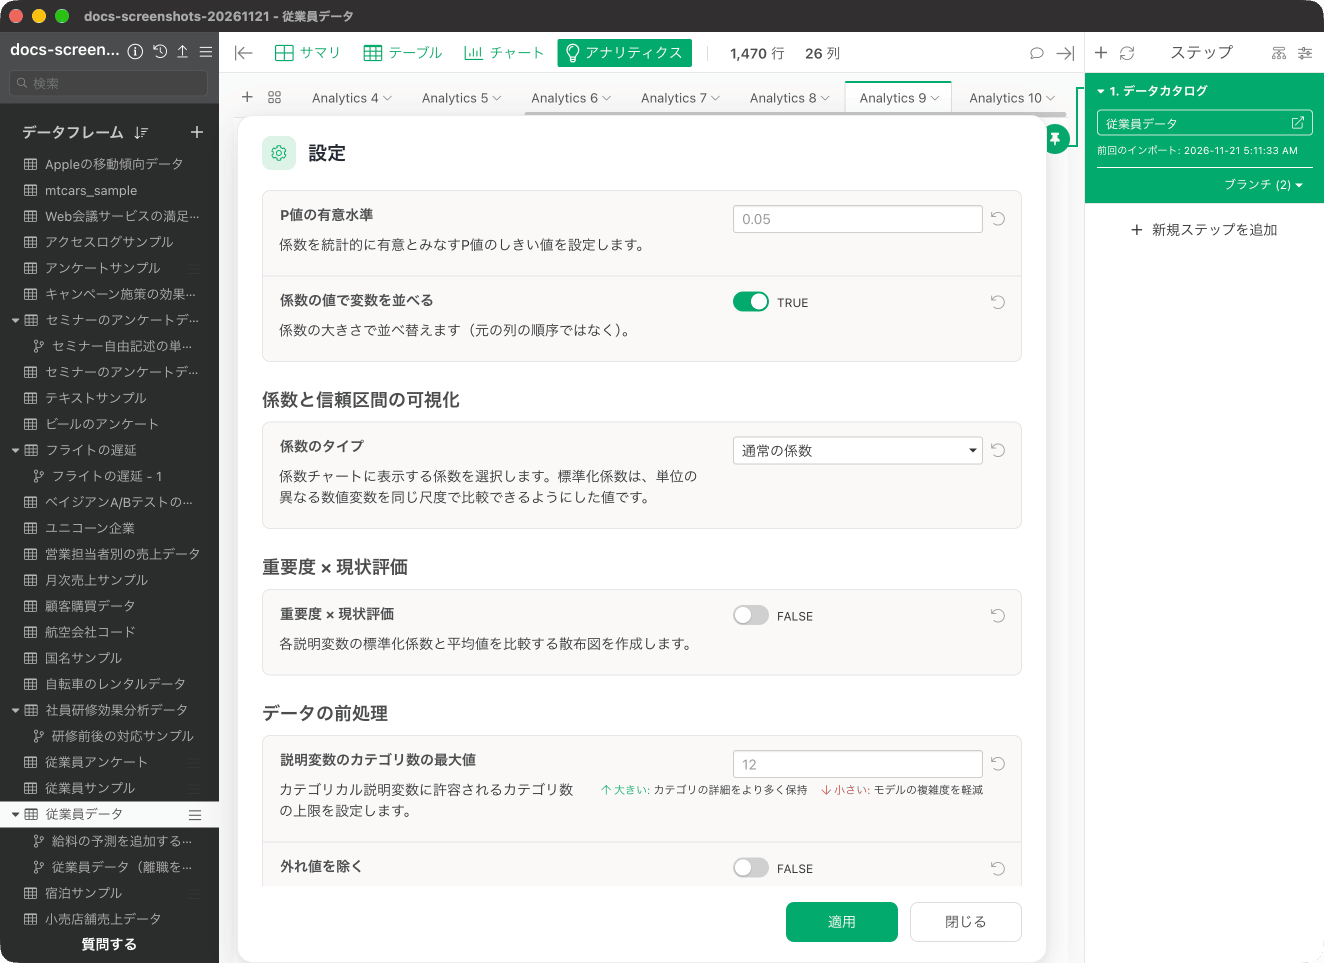
Q: 説明変数にあるカテゴリ型の列のベースレベルを変更したい
線形回帰などの統計のモデルでのカテゴリ型の列を説明変数に選択して実行した際には、ベースレベルと比べて特定の値だった時に有意なのかどうかが分かるようになっており、ベースレベルはその列の値で最頻値(行の数が最も多い)が自動的に選ばれます。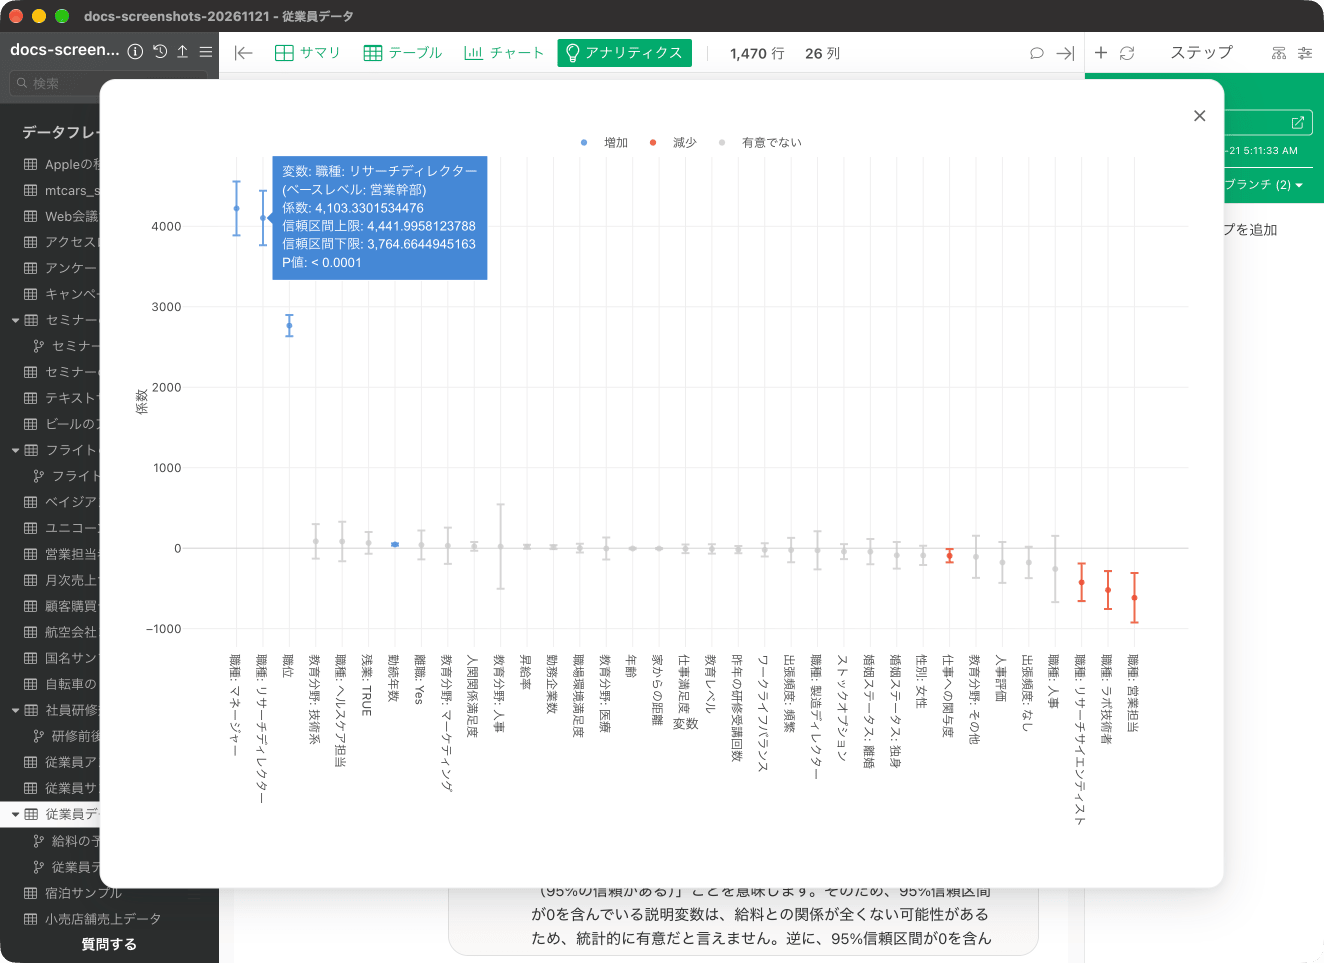
Q: 「変数の係数と有意性」で表示される「係数」は標準化回帰係数ですか、それとも、偏回帰係数ですか?
「変数の係数と有意性」の「係数」は説明変数の値を標準化した後の係数(標準化回帰係数)ではなく、「元の単位」における係数(偏回帰係数)となります。標準化した係数は、同じ表の「標準化係数」の列にあります。Q: 説明変数が一つのときと、複数の時で予測値や傾き(係数)が異なるのはなぜでしょうか?
線形回帰などの統計の予測モデルで、説明変数が一つの時は「単回帰」と呼びます。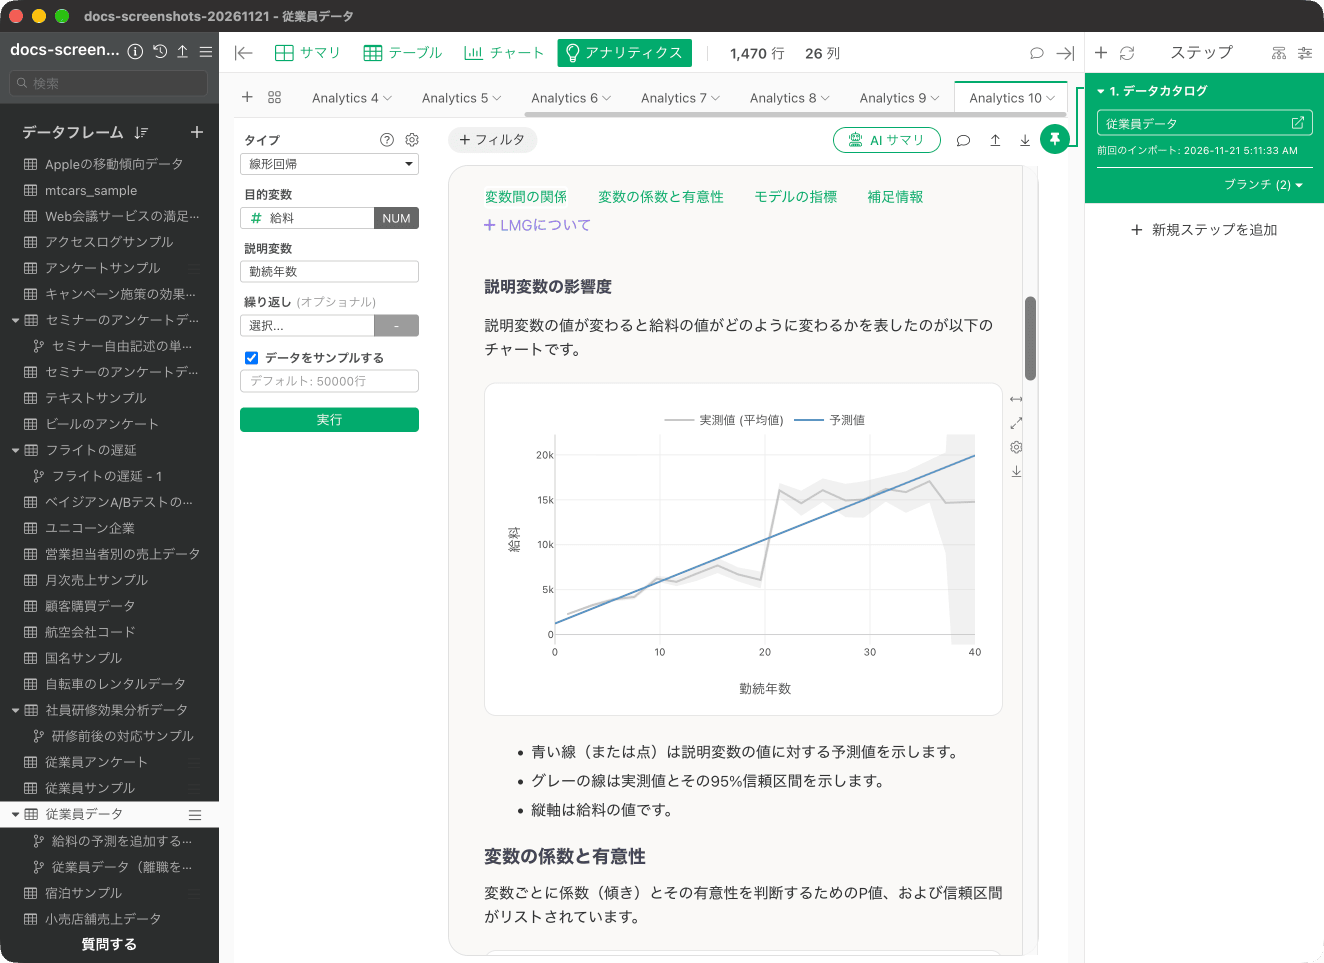
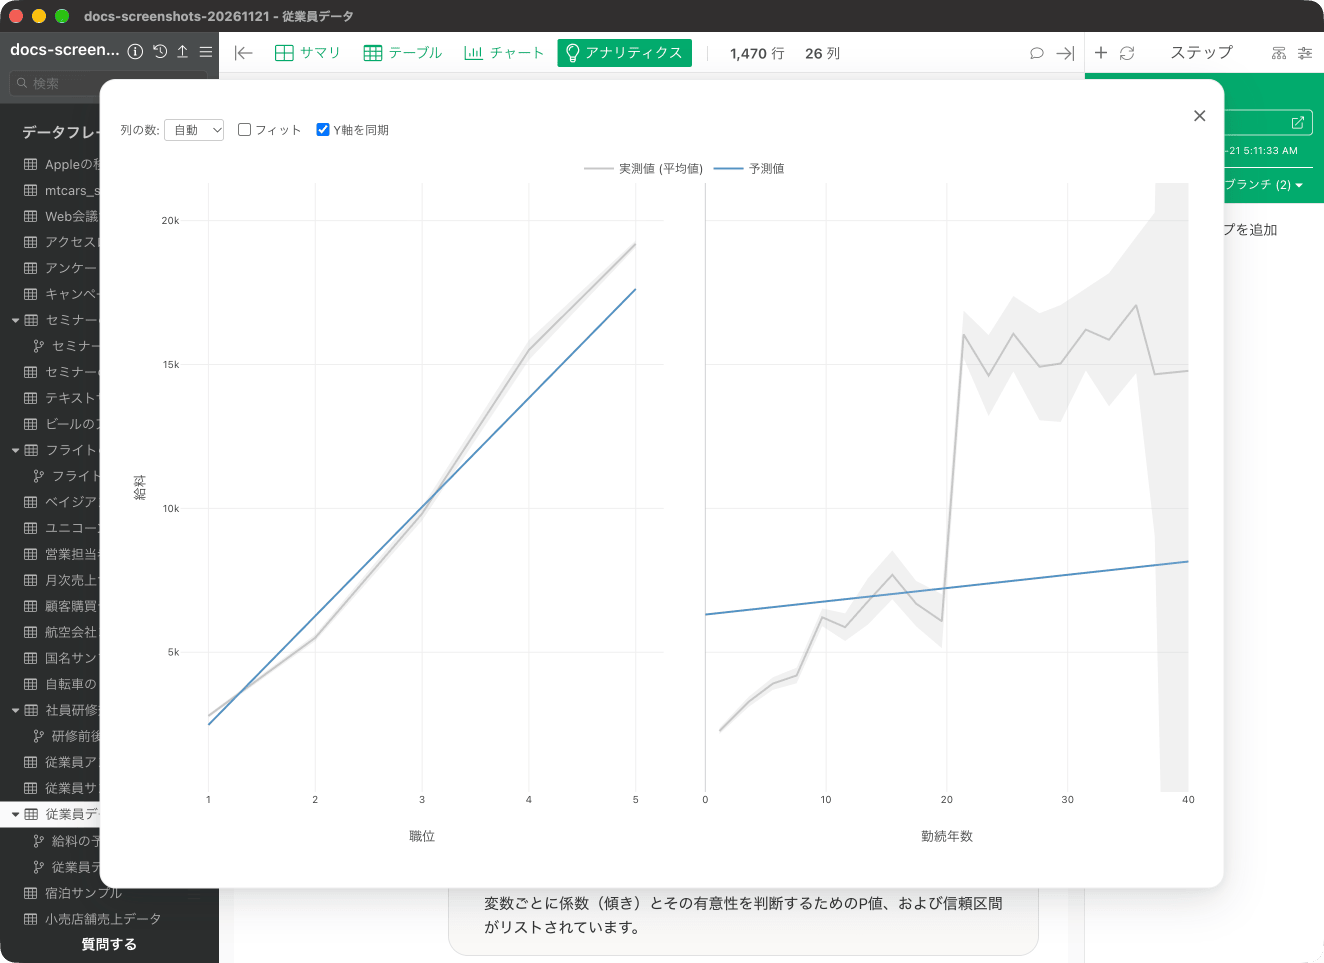
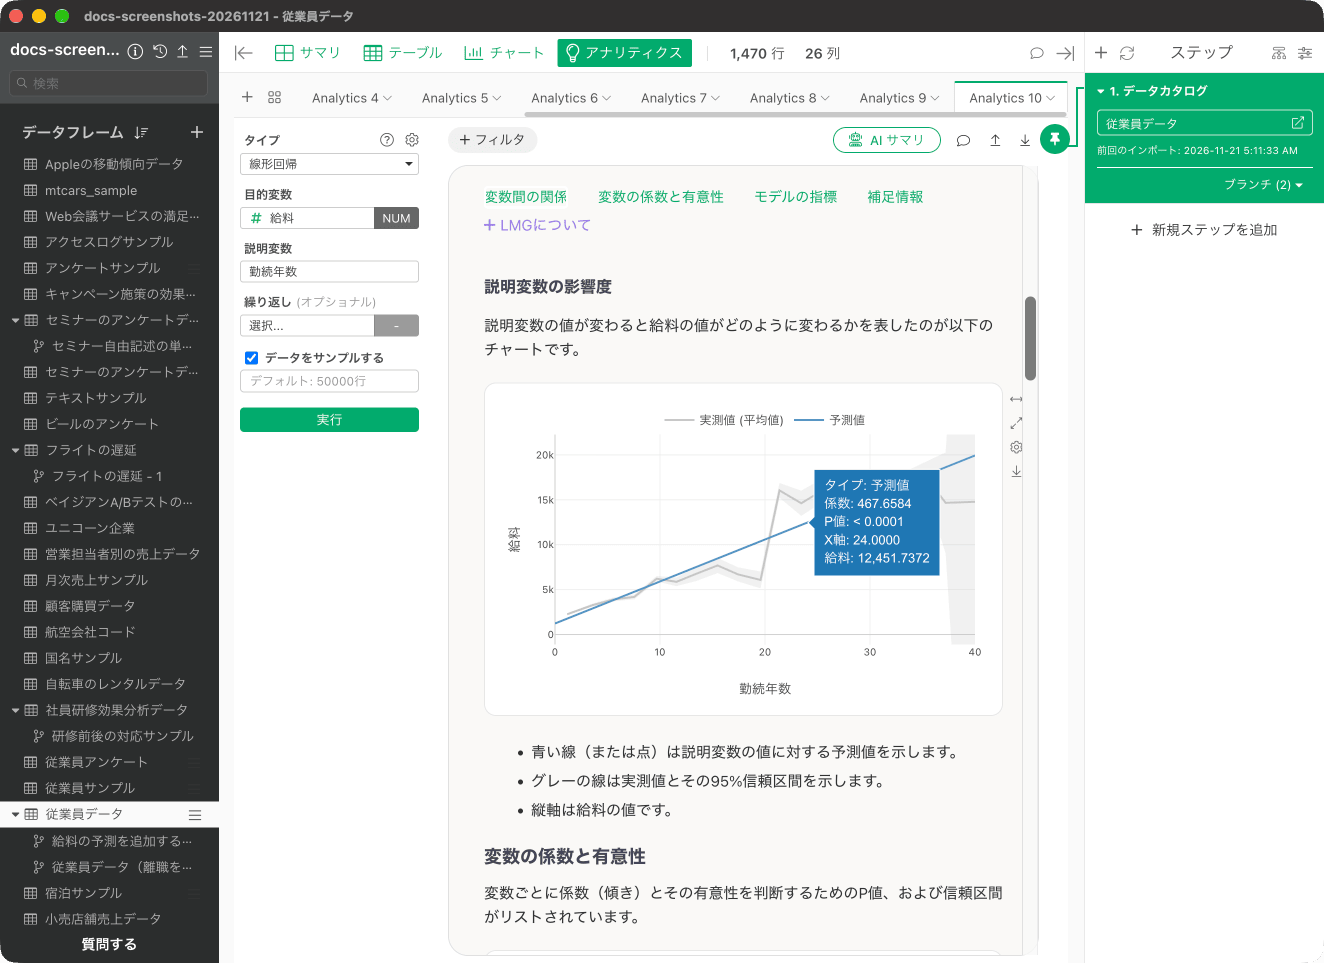
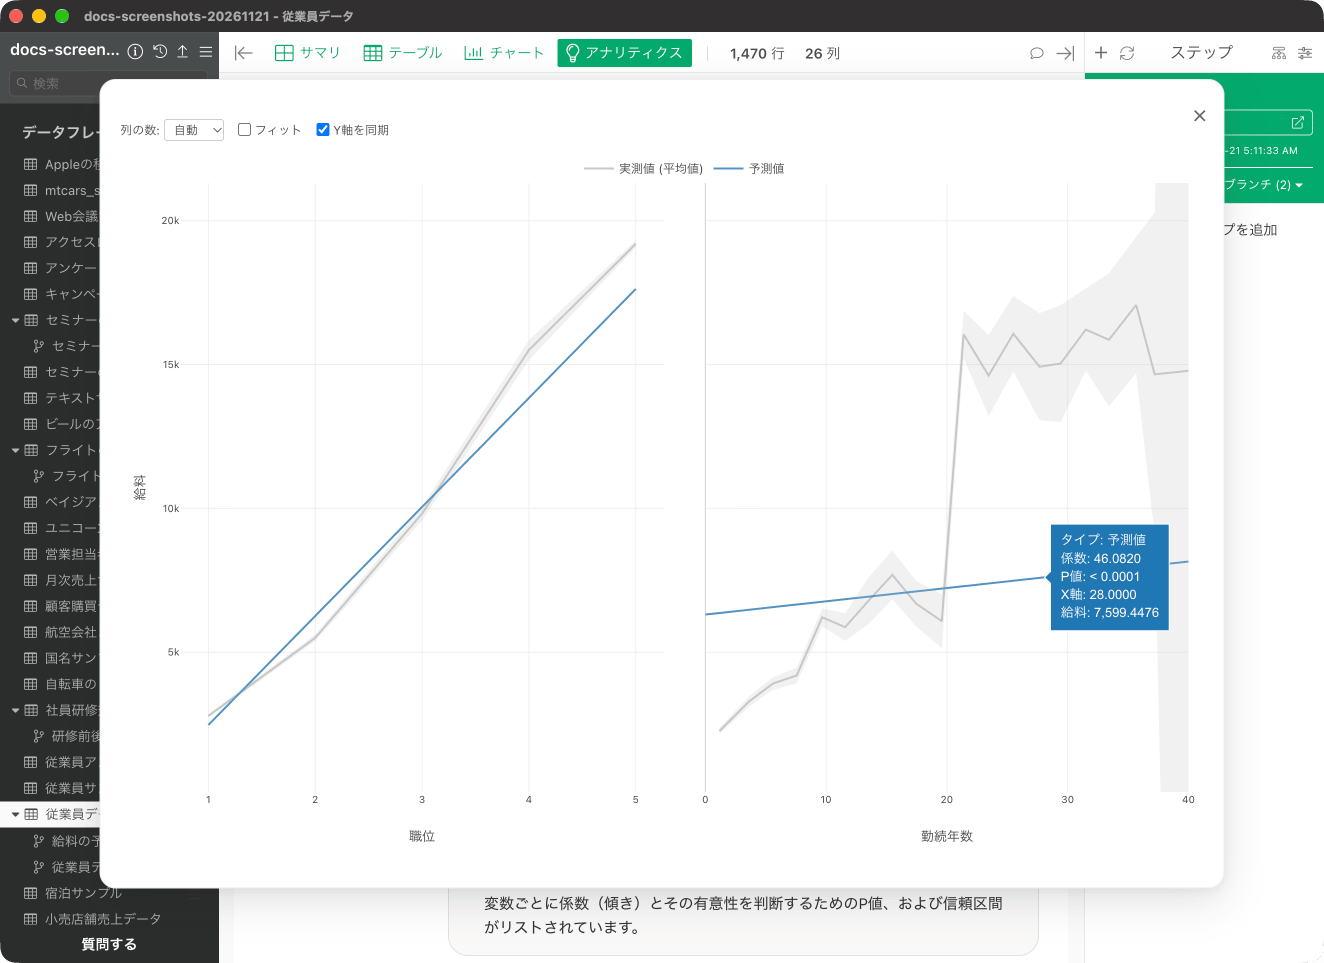
Q: 説明変数の値が上がると目的変数の値を増加させる関係があると思っていたんですが、結果は係数がマイナスになっています。どう解釈したら良いでしょうか?
係数の値だけではなく、係数の信頼区間の上限と下限を見て、0を跨いでいないか確認してみてください。もし、0を跨いでいる場合は係数がマイナスになるかもしれないしプラスになるかもしれないので、有意とは言えない変数になります。もし、信頼区間が0を跨いでいない状態で係数がマイナスになっている場合は、他の変数の効果を一定とした時にその変数の独立した効果として目的変数の値を下げる方に影響していると判断できます。Q: 不要な変数を減らした方がよりいいモデルになるんですか?
モデルの予測精度をよくしたいならば、ノイズになるような変数は削った方がよい場合が多いです。ただ、モデルによっては1,000行のうち10行のみを予測するのにそのデータが役立つといった場合もあるので、できるだけ入れるという考え方もあります。 もし、因果関係を明確にしたいという目的なら、予測力の向上には不要な変数でも加えておくと「〜が一定だったとしたら」という因果関係の話ができることがあります。因果関係を調べるときには、まずドメイン知識をもとにバックドア基準などの変数選択基準をもとに、因果効果を見積もるのに最適な変数セットを選ぶべきという考えもあります。Q: 「多重共線性」でVIFが10を超える変数が複数あった時にはどのように説明変数を除いたらいいですか?
VIFが10を超える変数が複数あった時の説明変数の選び方については、こちらの投稿をご参照ください。Q: 変数重要度は、係数の大きさと関係しているのでしょうか?
変数重要度と係数の大きさには基本的には関係がありません。一般的に、重回帰において係数はそれぞれ単位が違うため、変数重要度のようにお互いを比較できません。変数重要度は特定の変数の値をシャッフルしたときに元の予測よりどれだけ精度が落ちているかをもとに計算され、こちらはお互いに比較できる値です。Q: 変数重要度で単位が違う変数どうしを比較してもいいのでしょうか?
係数どうしでは、変数の単位が違う場合は比較することはできないのですが、変数重要度(Permutation Importance)の場合は単位の違いは気にしなくて大丈夫です。Q: 変数重要度は具体的にどのような計算をしていますか?
変数重要度については、下記のノートで詳しく紹介しておりますので、そちらをご参考ください。 https://exploratory.io/note/kanaugust/56-Svv7VWV8tA また、変数重要度の仕組みについては、以下のようになります。- 学習済みのモデルは固定したまま、評価用のデータで1つの説明変数の列の値だけをランダムに並べ替え(シャッフルし)、予測し直す。
- 並べ替える前に比べて、予測誤差がどれだけ悪くなったか(誤差の増加量)を計算する。
- これを全ての変数で繰り返す。
- 予測誤差の増加量をもとに、それぞれの変数の相対的な重要度を評価する。
Q: 単回帰では有意にならない変数が、重回帰にすると有意になりました。どう解釈すればいいのでしょうか。
単回帰では有意な関係がないと見えていたものが、重回帰にすると有意になることを負の交絡(Negative Confounding)と言います。詳しくはこちらをご覧ください。Q: 線形回帰でのt値やP値は何を表しているのでしょうか。
線形回帰でのt値は、推定された係数をその標準誤差で割った値です。P値は、係数が0であるという帰無仮説のもとで、今回得られた値以上に絶対値の大きいt値が得られる確率です。Q: 「変数の係数と有意性」の表に表示されている「(切片)」は何を表しているのでしょうか。
「(切片)」は線形回帰のモデルでの切片(Intercept)を表します。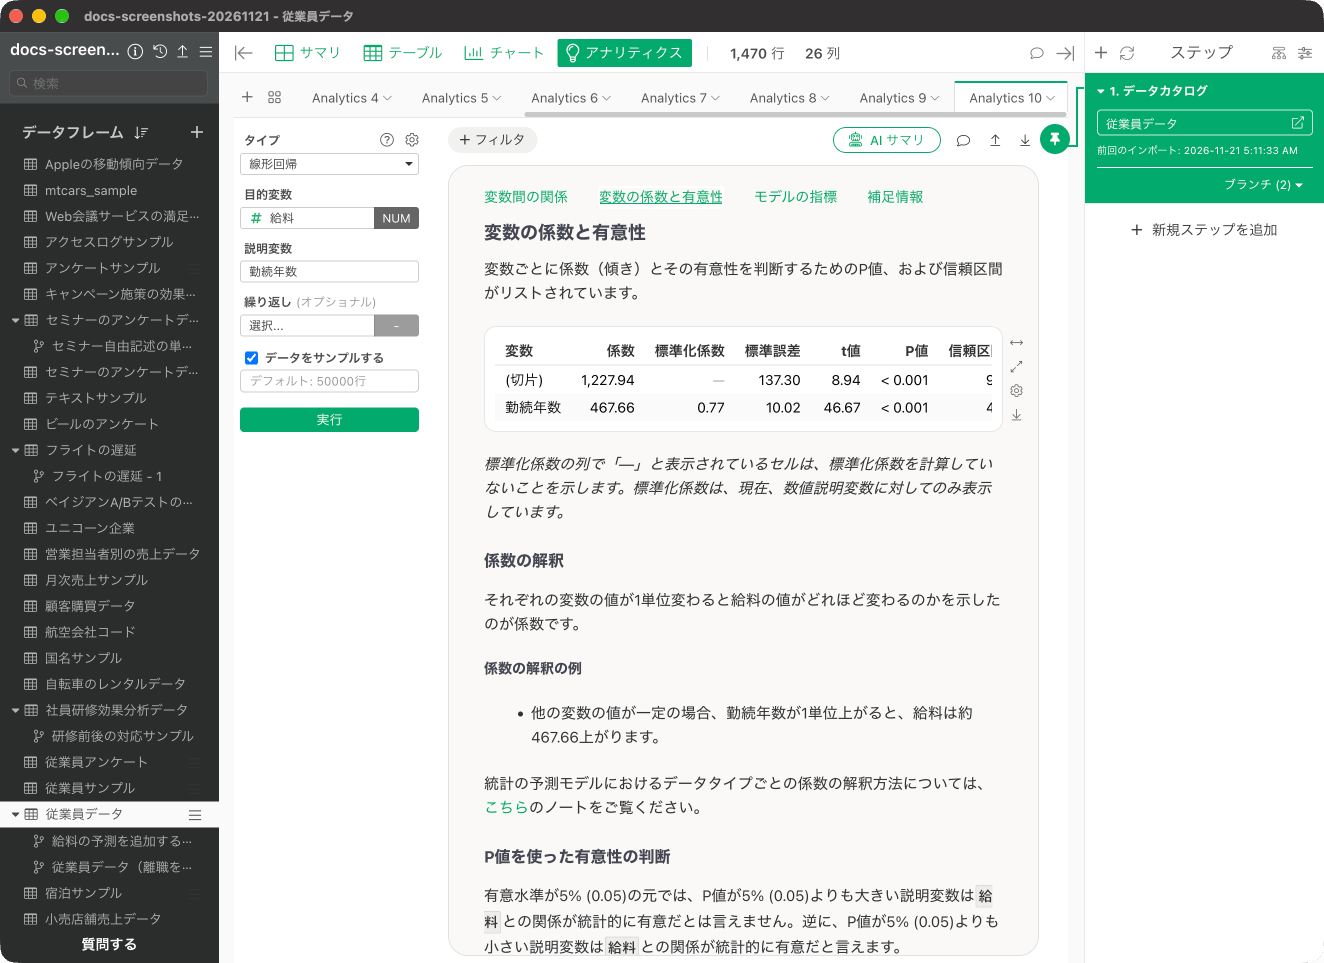
Q: 説明変数でP値は有意になっているが、R2乗が低い時の解釈について
説明変数と目的変数で有意な関係性があっても、R2乗を見ると使用している説明変数では目的変数の3%ほどしか説明できていないことがあります。 どの変数が関係しているのかを知るためには、説明変数と目的変数の関係性は貴重な情報になります。しかし、これらの変数で将来の値を予測していきたいとなると、目的変数のばらつきを説明する能力が低いので、うまく予測できるモデルにはなりません。 そのため、他の変数を探してモデルに追加してみて、予測精度が向上しているかを確認していく方法が良いかと思います。Q: データの行数より説明変数(列)の数の方が多い時に、一部の説明変数しかモデルで使用されない。
線形回帰などのアルゴリズムでは、データの行数が説明変数よりも多いことを前提としています。 例えば、データの行数が30行で、説明変数に100列指定して線形回帰を実行したとします。 その場合は、目的変数である1つの列と説明変数の29列しか使用されずにモデルが作られます。 そのため、データの行数が指定している説明変数よりも多いか確認してから、線形回帰を実行してください。Q: 予測に利用したデータ量に対して、予測されたデータ量が少ない。
予測に利用したデータ量に対して、予測されたデータ量が少ないときには、数値型の説明変数に欠損値が含まれていることが想定されます。 Exploratoryでは数値列のデータの中に欠損値があると、欠損値を含む行を除いて線形回帰を実行します。Q: 説明変数に欠損値があった場合はどのように扱われますか。
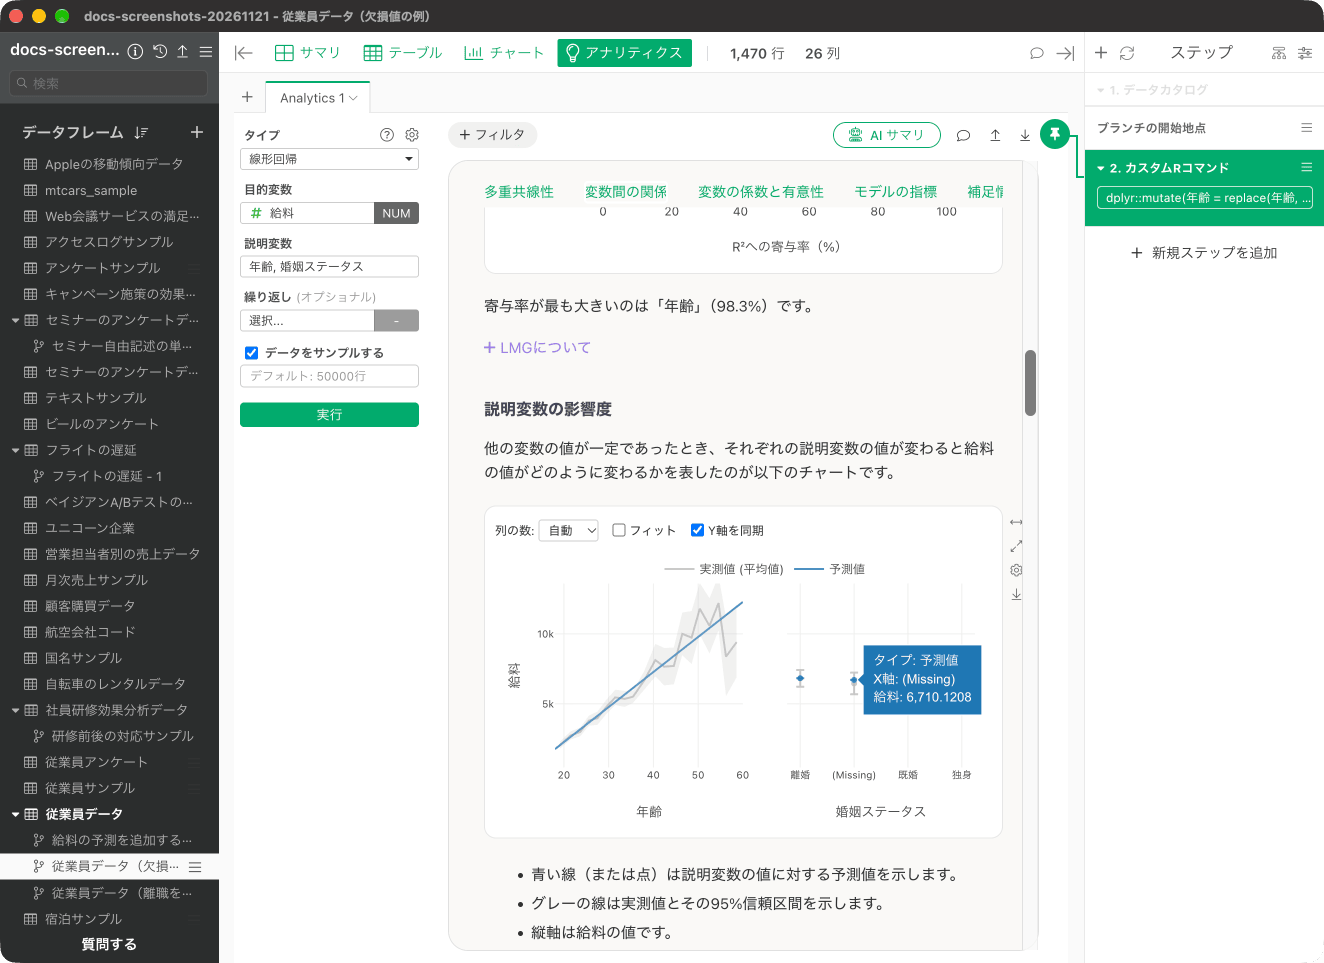
説明変数が数値型の場合 Exploratoryでは数値列のデータの中に欠損値があると、欠損値を含む行を除いて線形回帰のアルゴリズムを実行しています。 例えば、年齢の列に147行の欠損値があったとします。この例のデータは説明用に作ったものです。元の従業員データから分岐(ブランチ)を作り、「カスタムRコマンド」のステップで、行番号を10で割った余りが0の行は年齢を、1の行は婚姻ステータスを欠損値(NA)にしています。これにより、年齢と婚姻ステータスに別々の147行の欠損値ができます。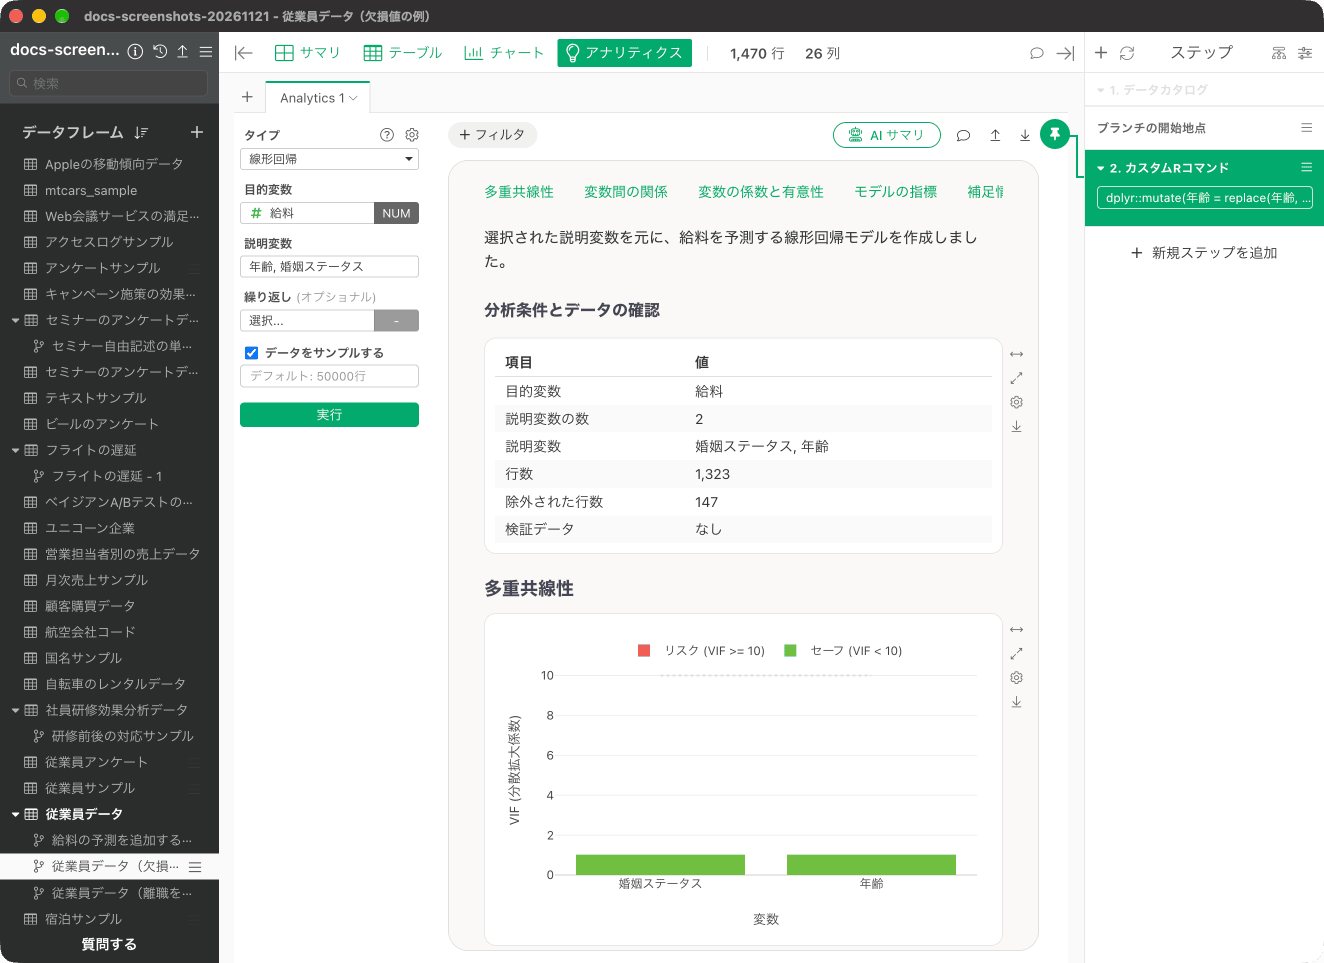
Q: データのサンプルは何を表しますか?
Exploratoryで線形回帰などのアルゴリズムの実行した時には、「データをサンプルする」にチェックが付いている場合は、使用するデータの行数に上限(デフォルトは50,000行)を設けて実行しています。データがこの上限より少ない場合は、全ての行が使われます(上の例でも、1,470行の元データがそのまま使われています)。 サンプルするデータの行数を変更したい場合は、上限の行数を指定する、またはチェックを外してサンプリングを解除していただくことで、使用するデータの行数を変更できます。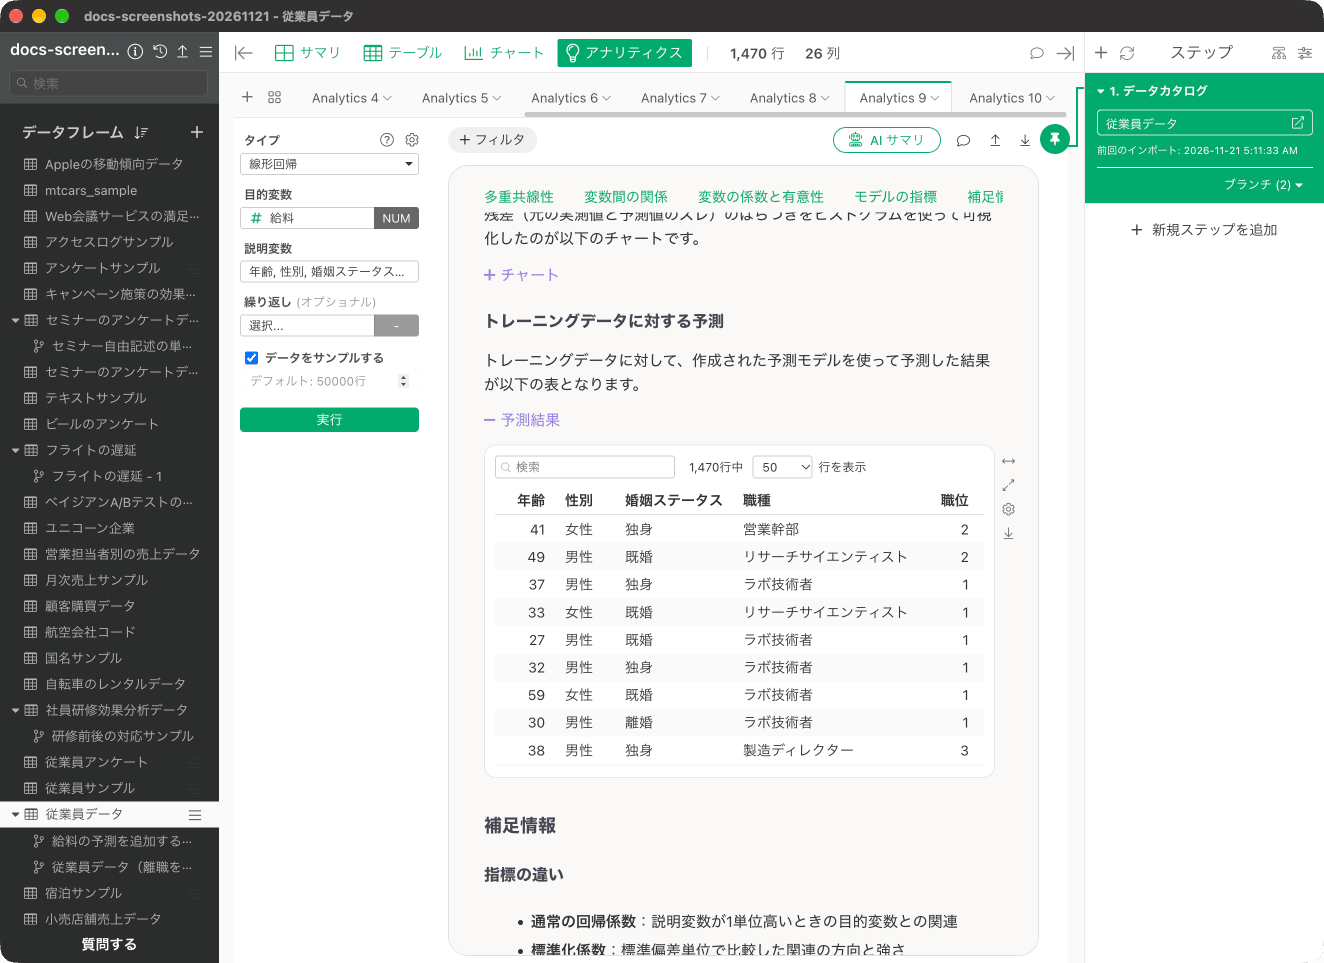
Q: 線形回帰で標準偏回帰係数を求めることはできますか。
まず、線形回帰の「変数の係数と有意性」の表を確認してください。表の「標準化係数」の列に、数値型の説明変数について標準化した係数が表示されます。 また、線形回帰を実行する前に数値列を「標準化」しておき、そのデータを使って「変数の係数と有意性」を見た時の係数も、標準偏回帰係数に該当します。