何ができるか
ランダムフォレストを使うと、次の質問に答えられます。- 目的変数が数値型の場合:このデータ(説明変数)を使うことで、目的変数(例:売上)のばらつきの何%を説明できるか。
- 目的変数がロジカル型の場合:このデータ(説明変数)を使うことで、目的変数(例:コンバージョン)のTRUE、FALSEをどれだけうまく分けられているか。
- どの変数が目的変数を予測するうえで重要か。
- 変数の値が変わると、目的変数の値はどのように変わるか。
必要なデータ
ランダムフォレストを作成するためには、1行が1観察対象(例:1行が1従業員)となっているデータが必要です。 また、目的変数として使用できるデータタイプは、「数値型」と「ロジカル型」の両方を扱うことができます。説明変数におけるデータタイプには特に縛りはありません。しかし、説明変数同士の相関が強い場合は影響度を取り合ってしまい、変数重要度の順番が低く見積もられることがあります。サンプルデータ
今回はサンプルデータとして、従業員データを使用していきます。 このデータは1行が1従業員のデータで、列には年齢や給料、職種など従業員の属性を表す列があります。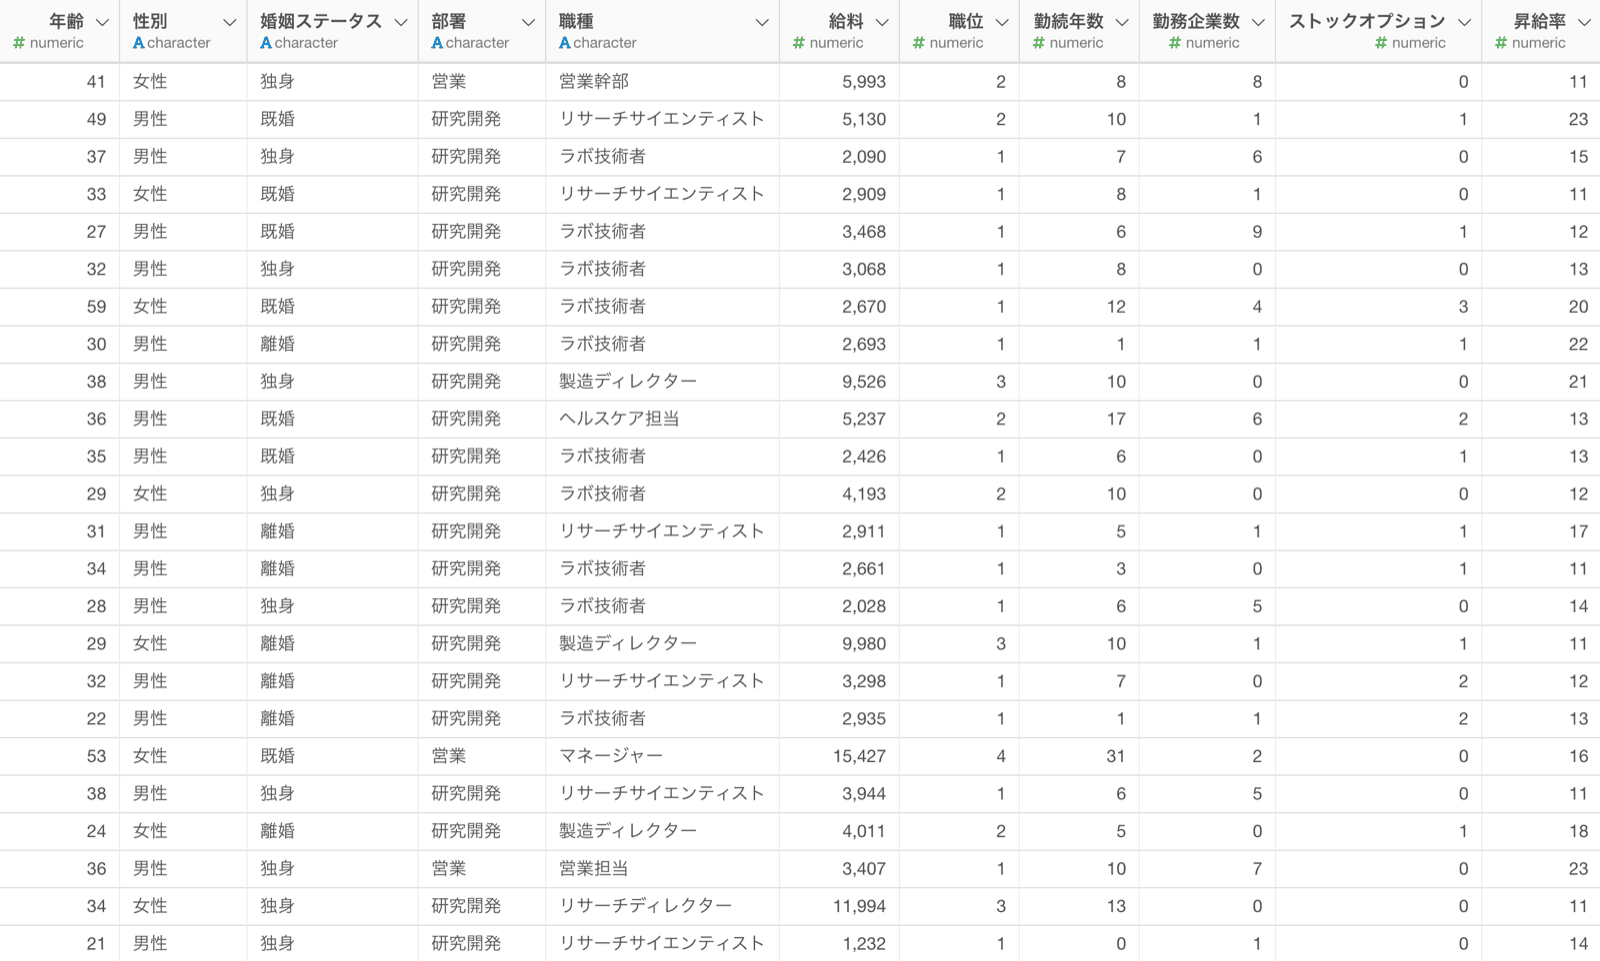
数値型を目的としたランダムフォレストのモデルを作成する
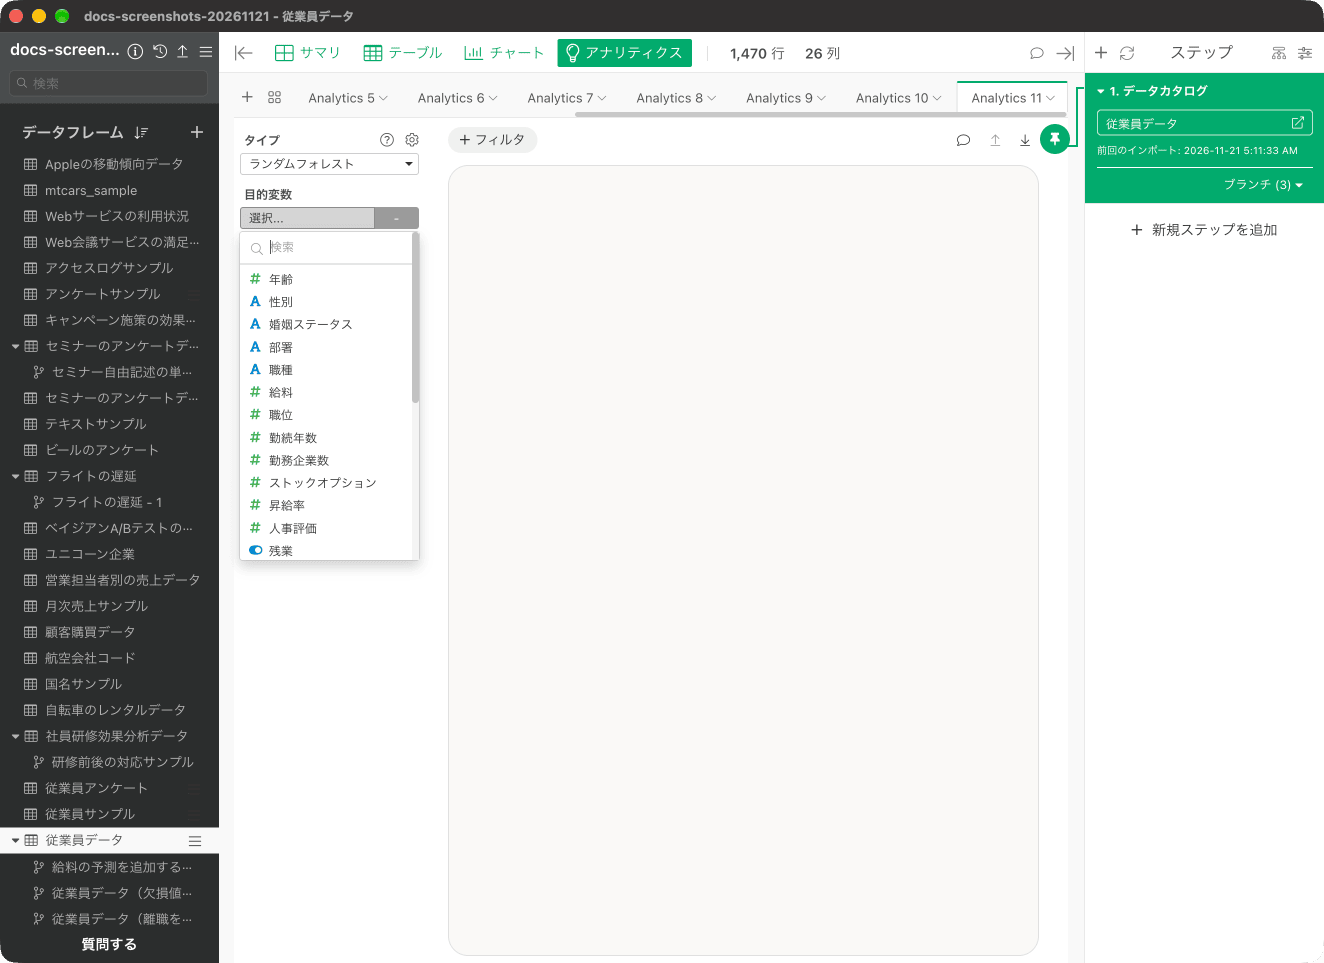
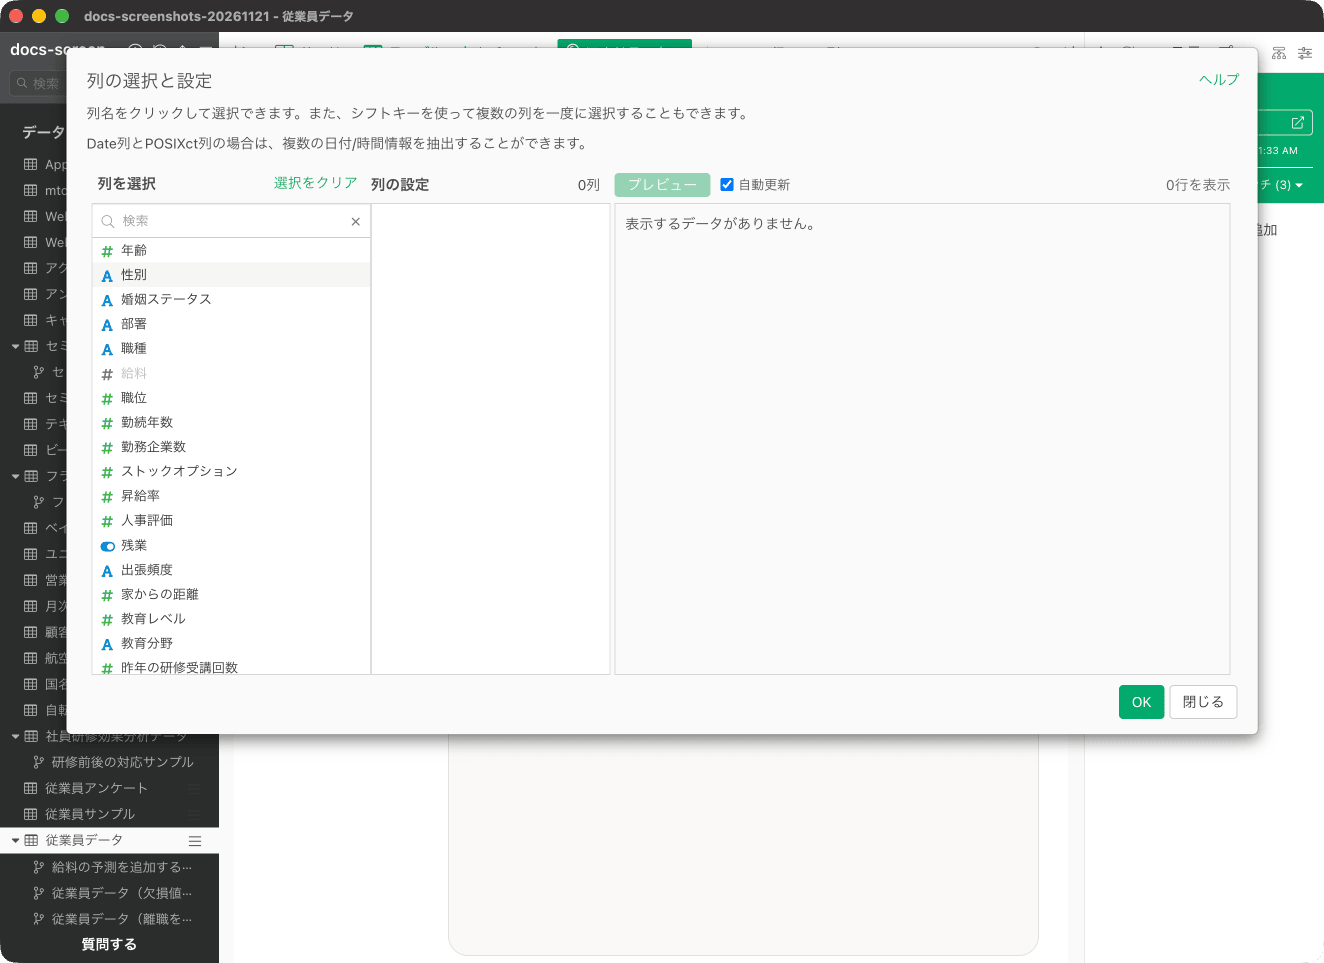
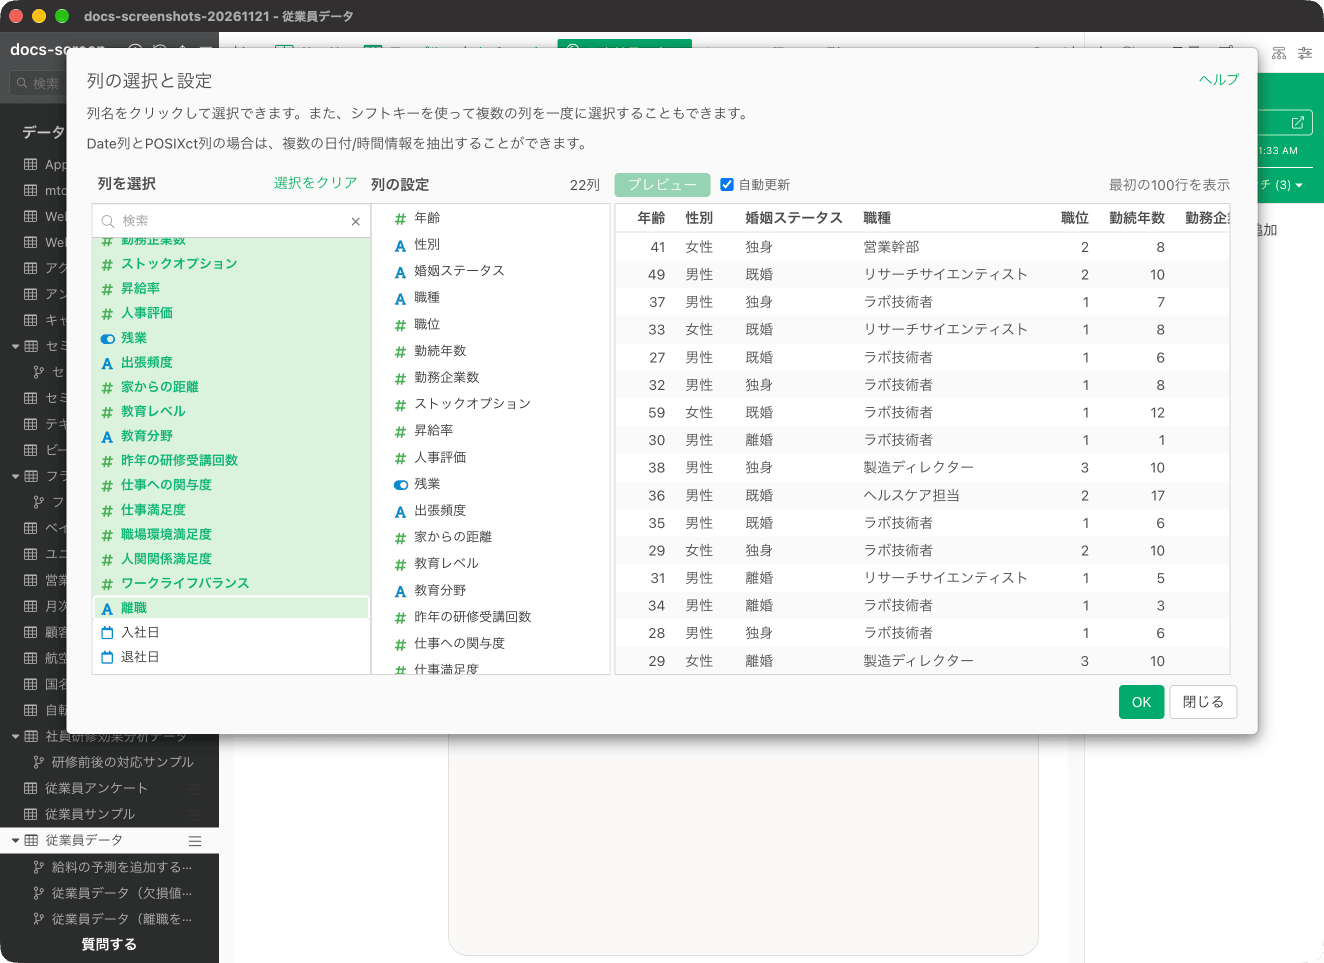
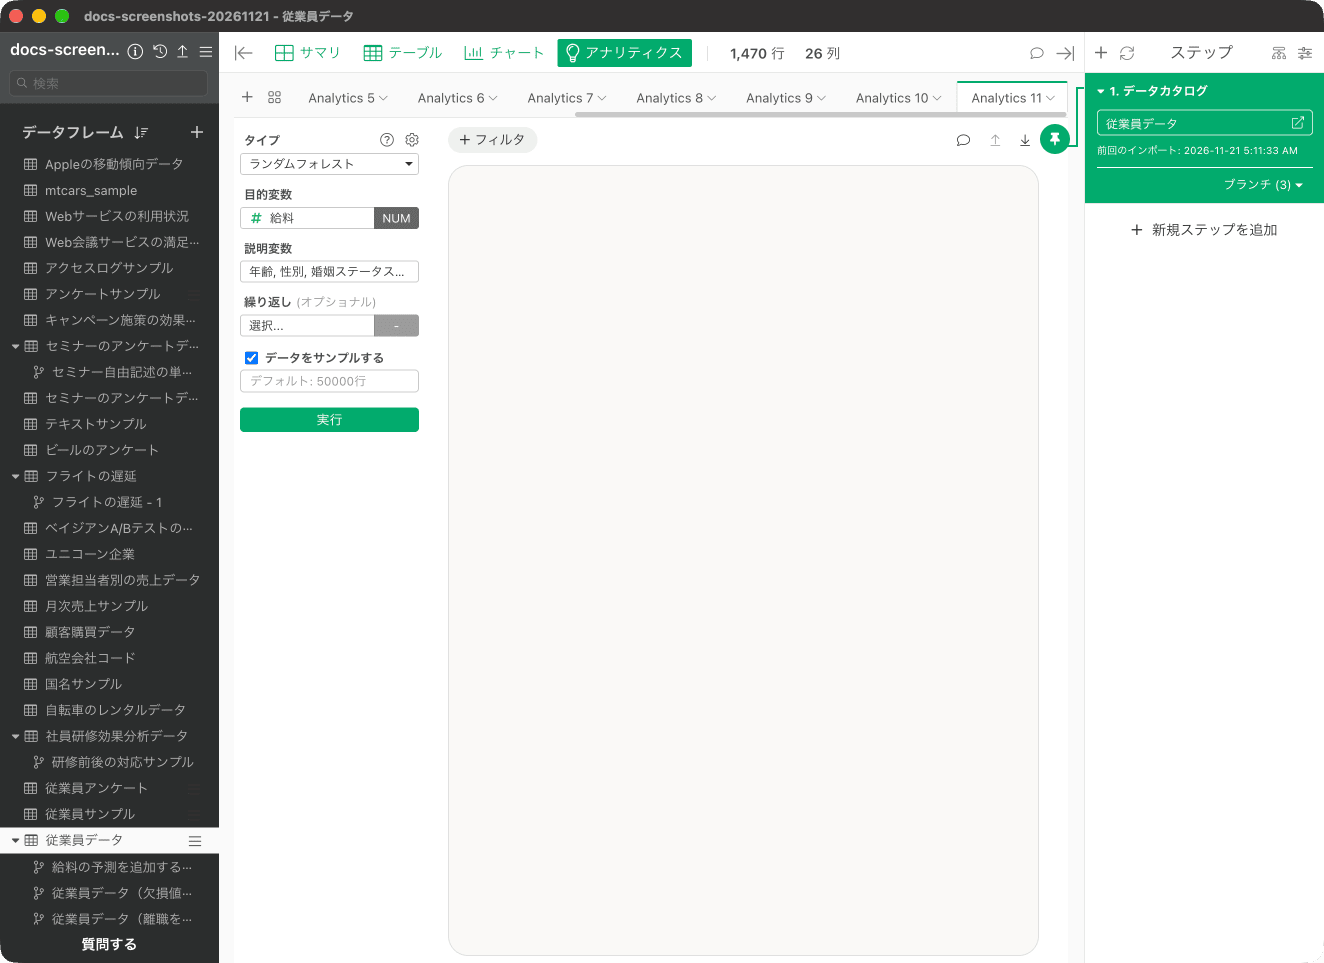
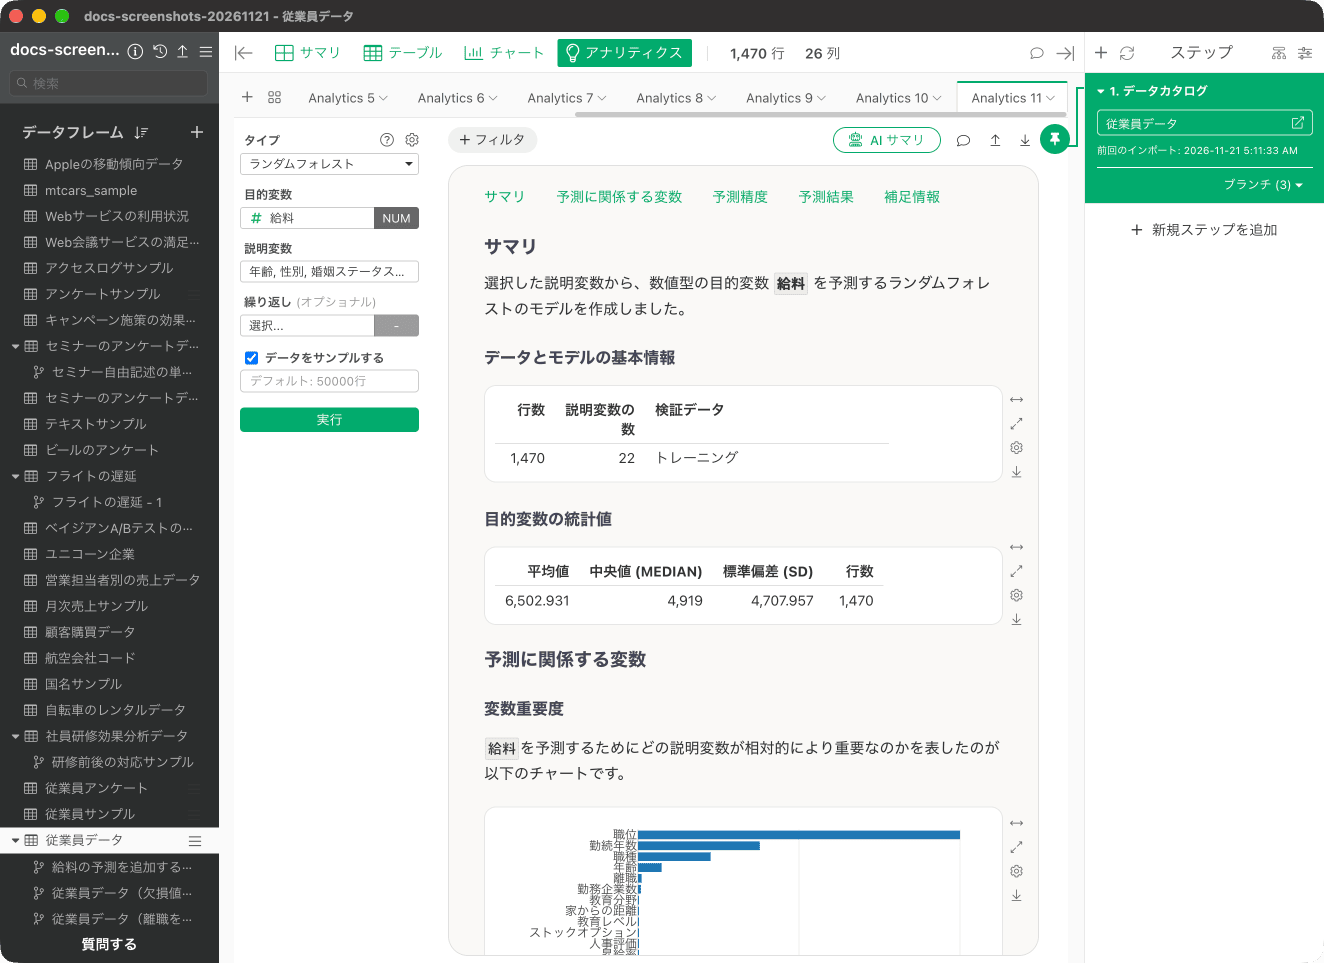
従業員の「給料」を予測するランダムフォレストのモデルを作成します。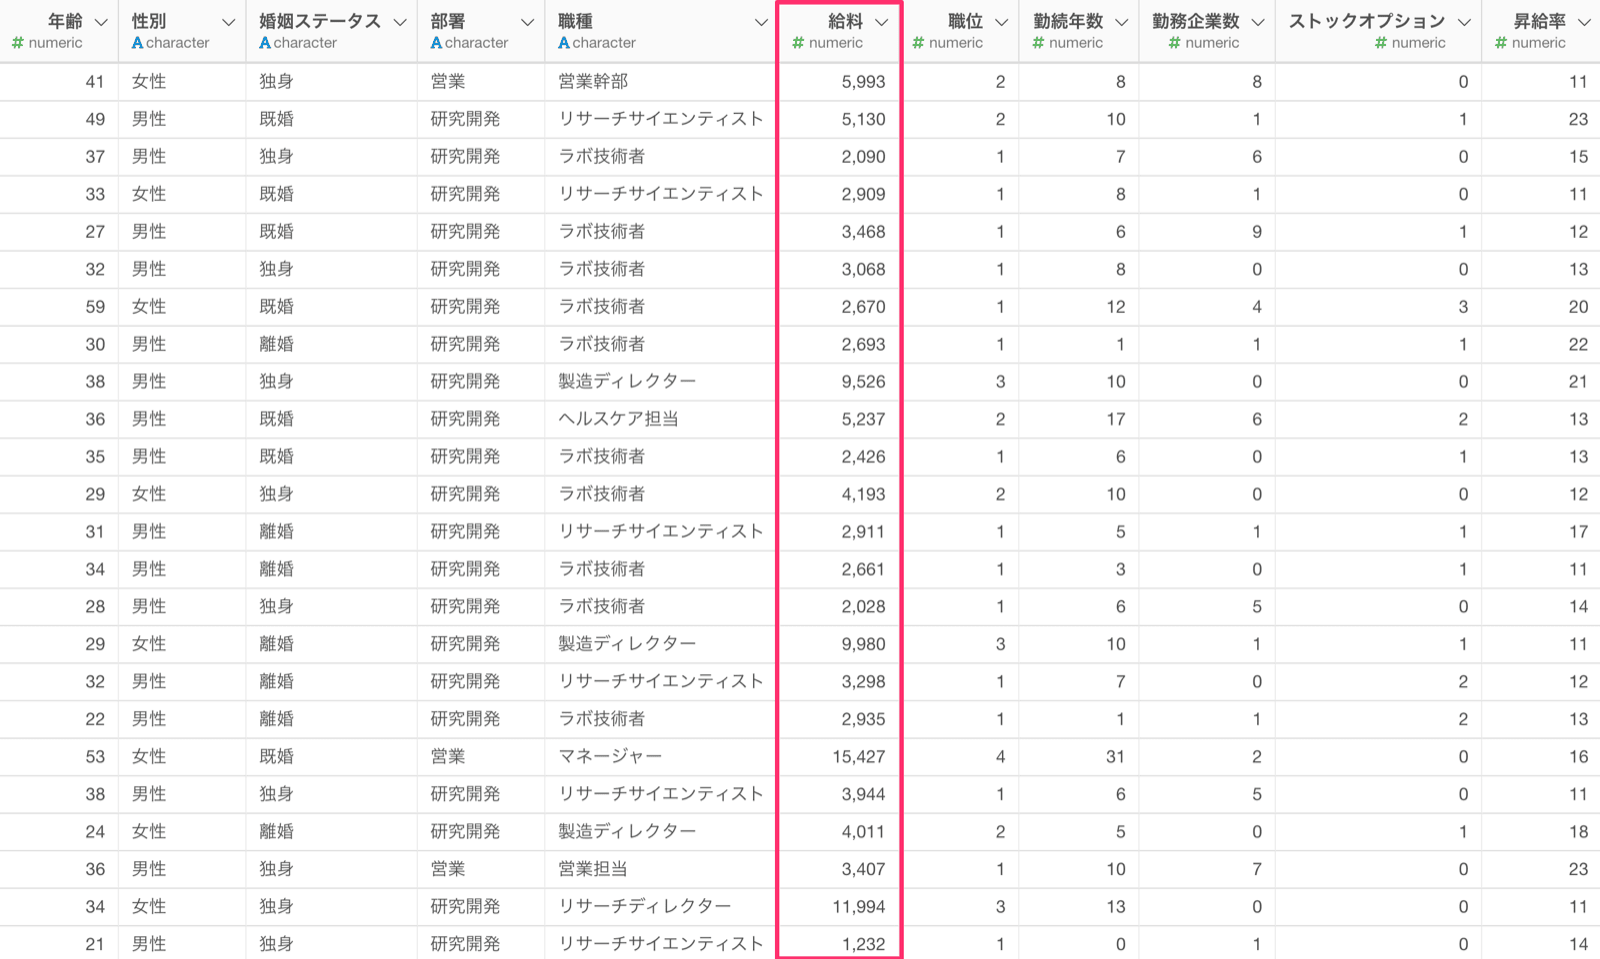
結果の解釈
変数重要度
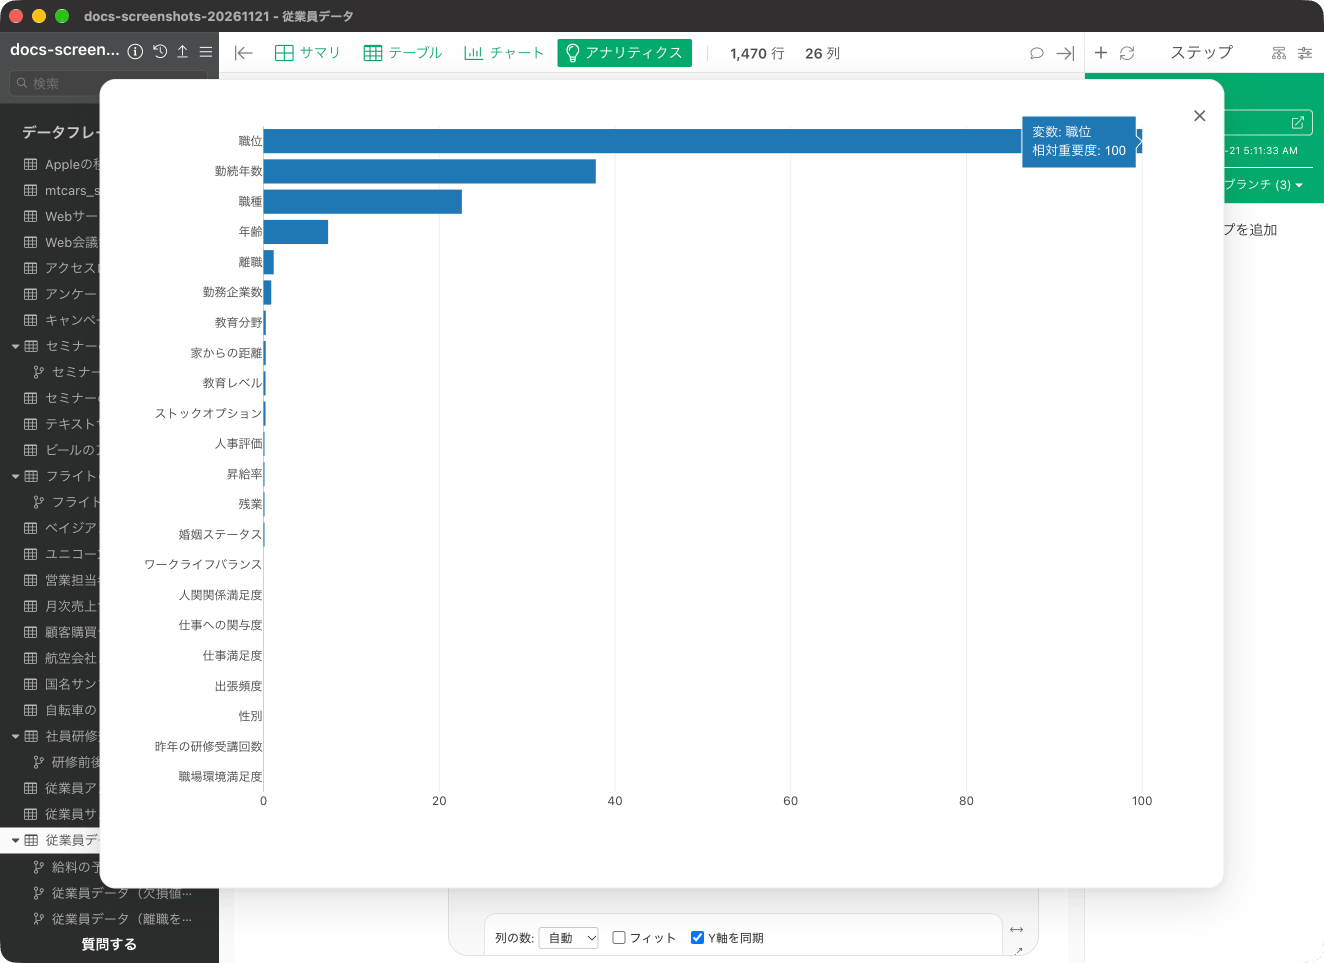
「予測に関係する変数」の「変数重要度」では、どの変数が目的変数との関係がより強いのか、予測する時により重要なのかを調べることができます。各変数の重要度は予測性能の低下量(Permutation)で計算され、最大値が100になるよう正規化されています。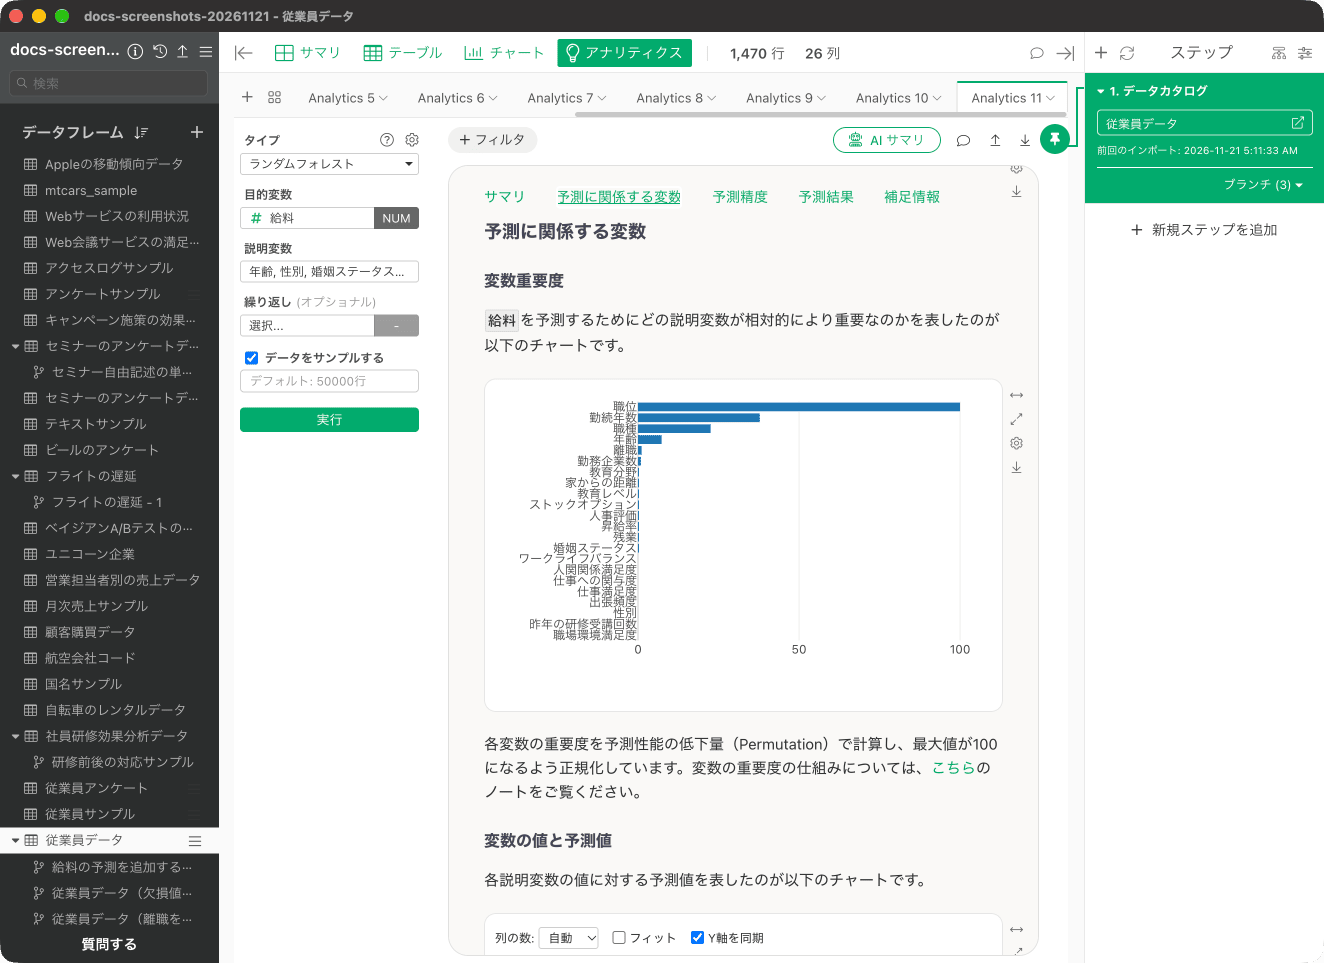
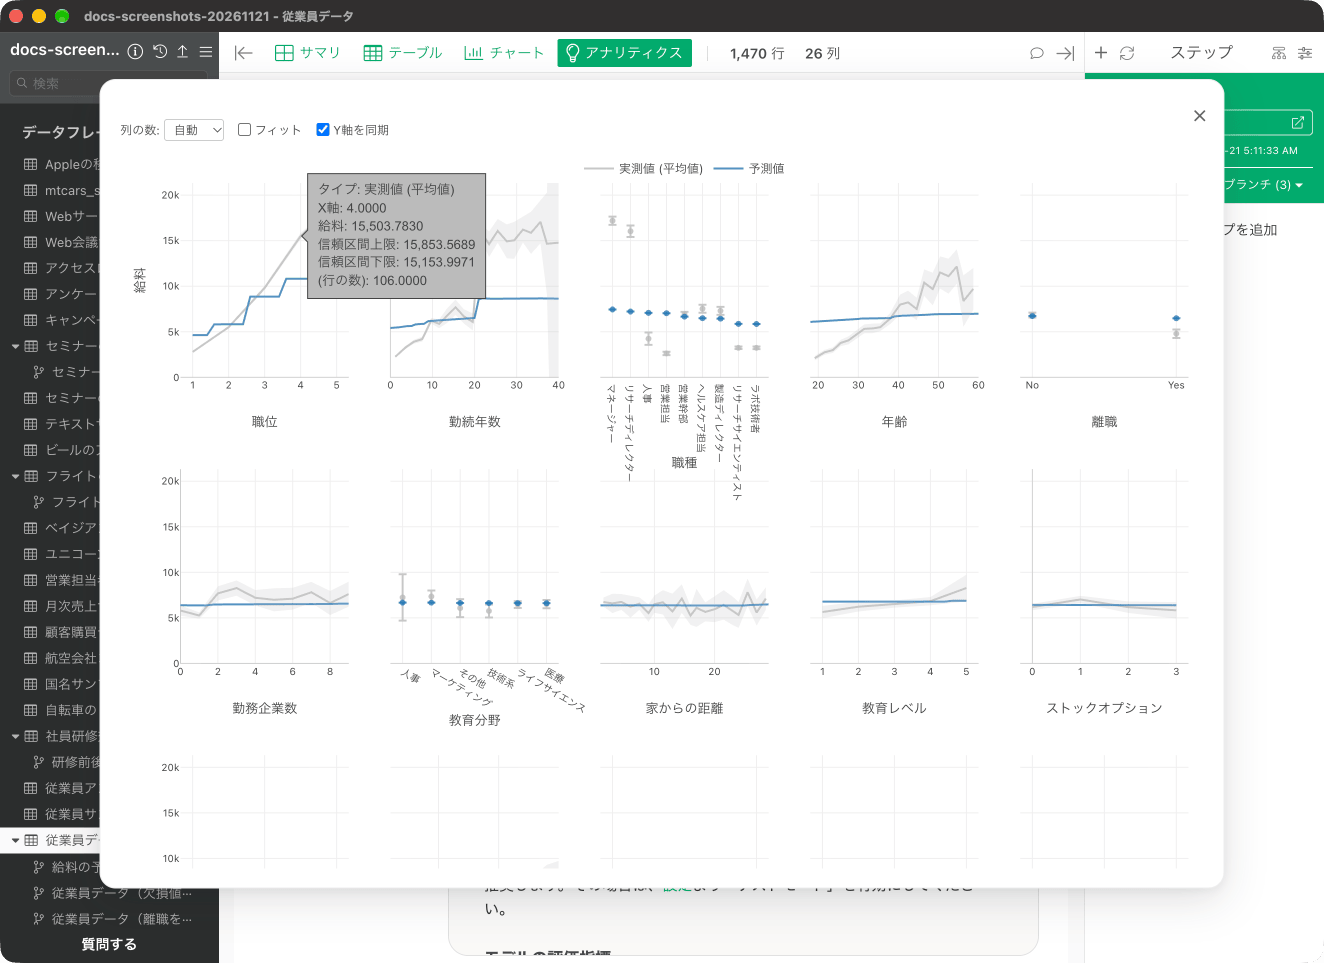
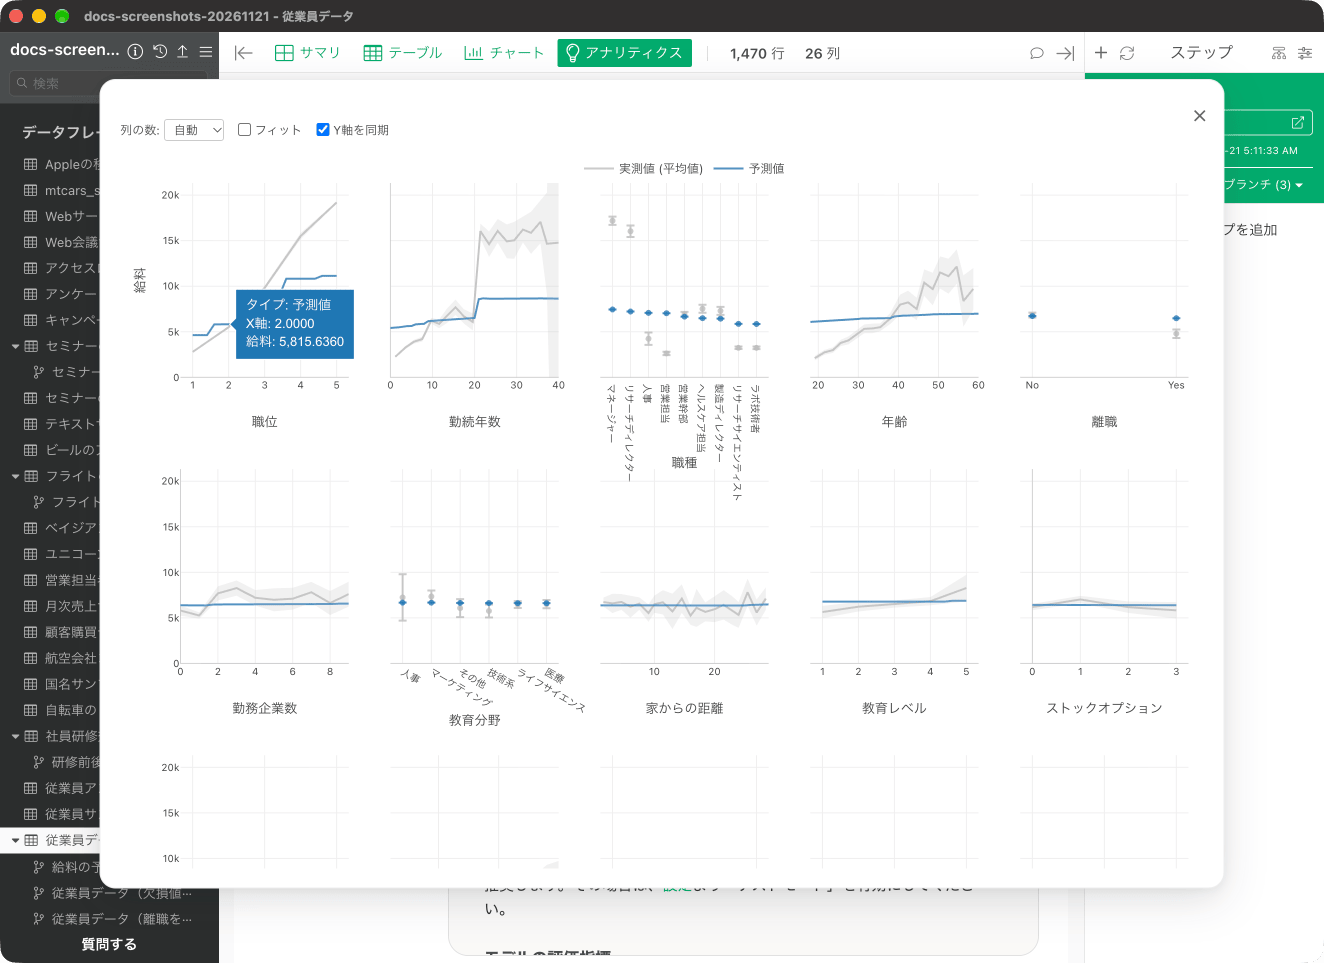
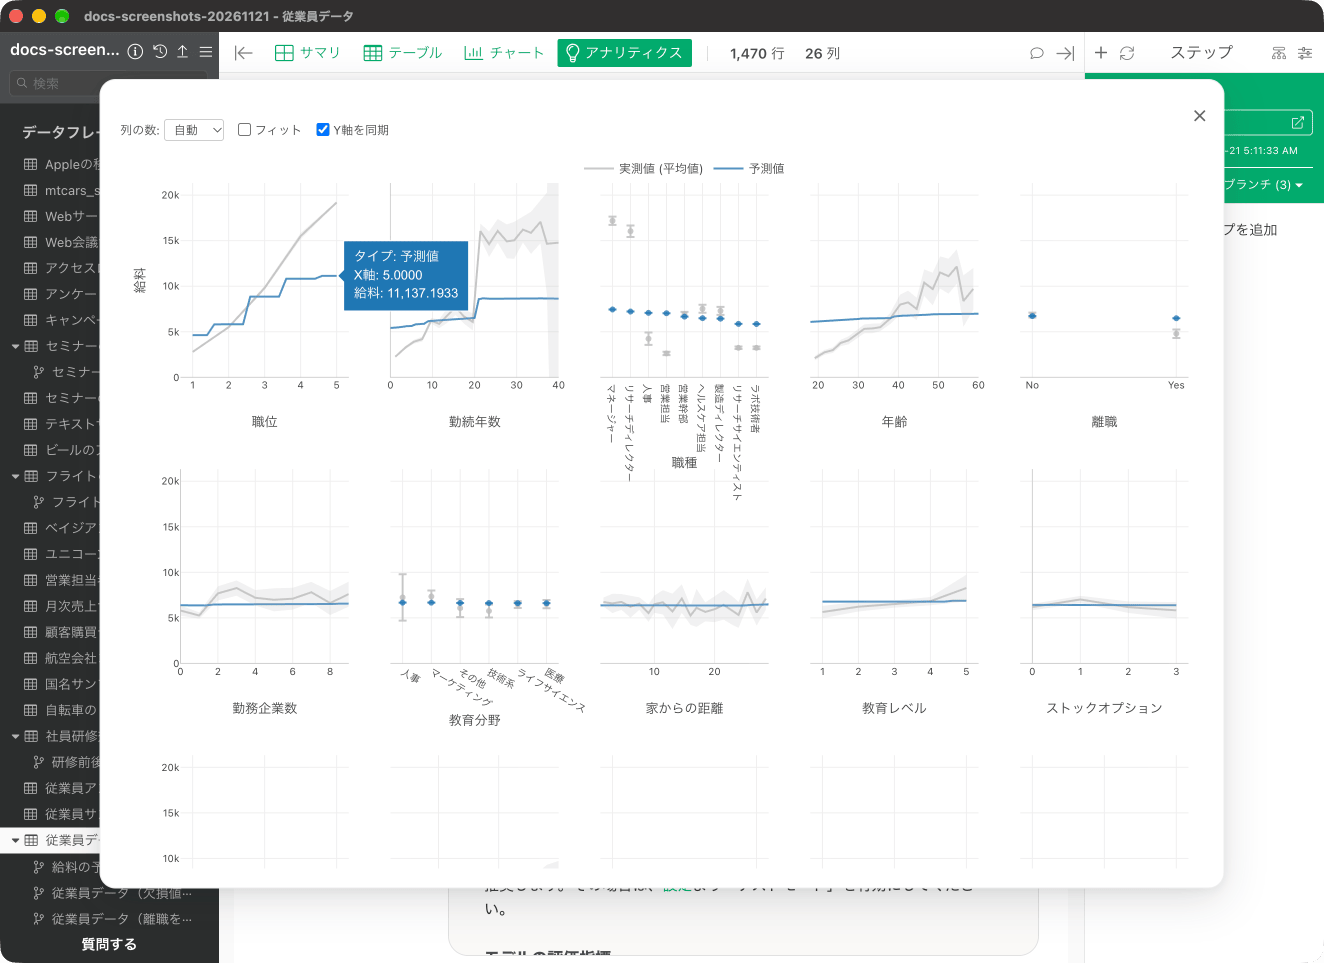
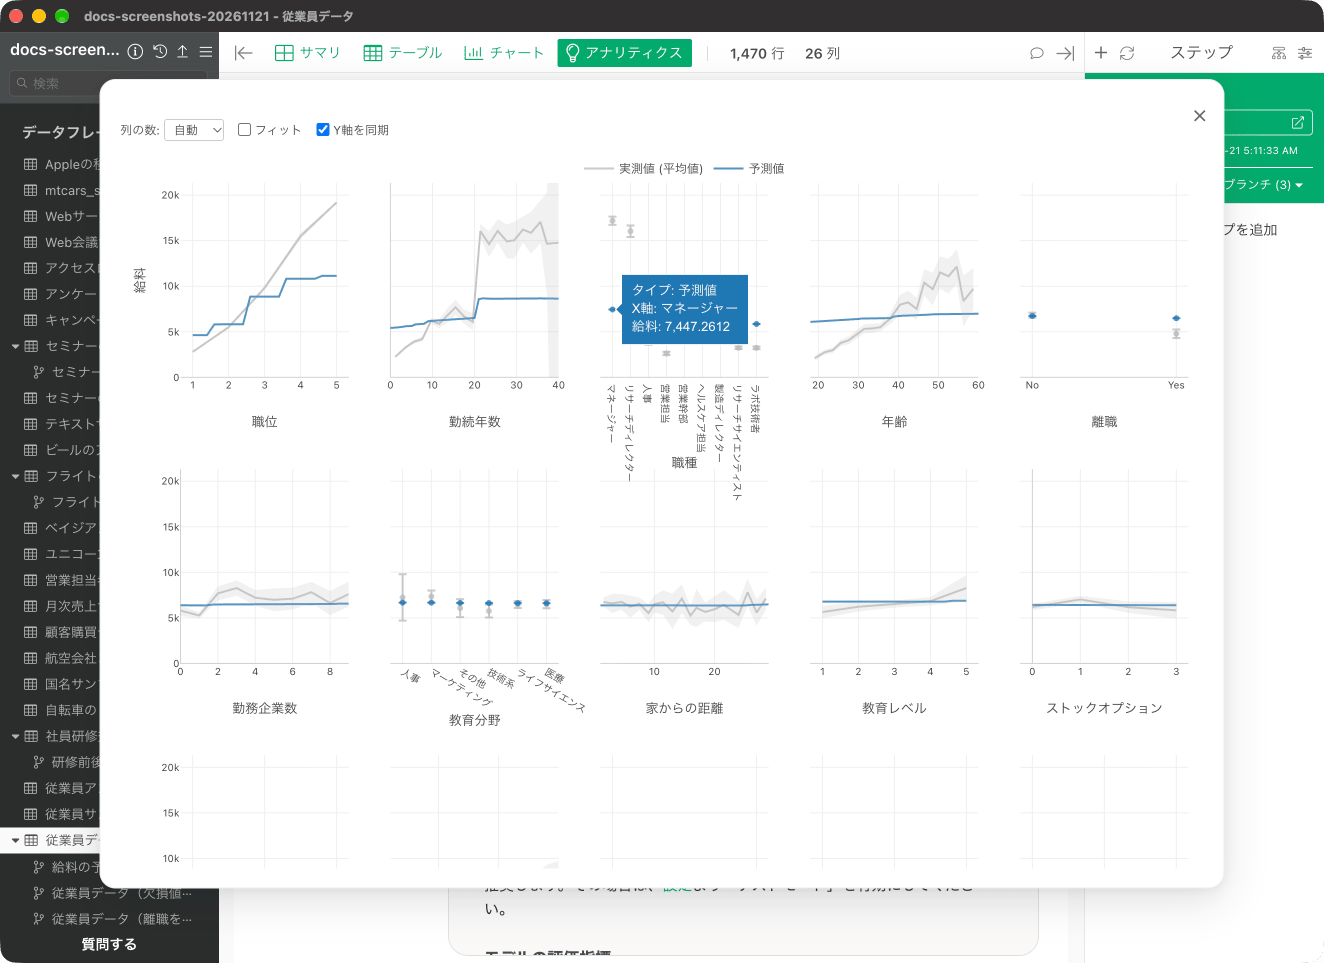
変数の値と予測値
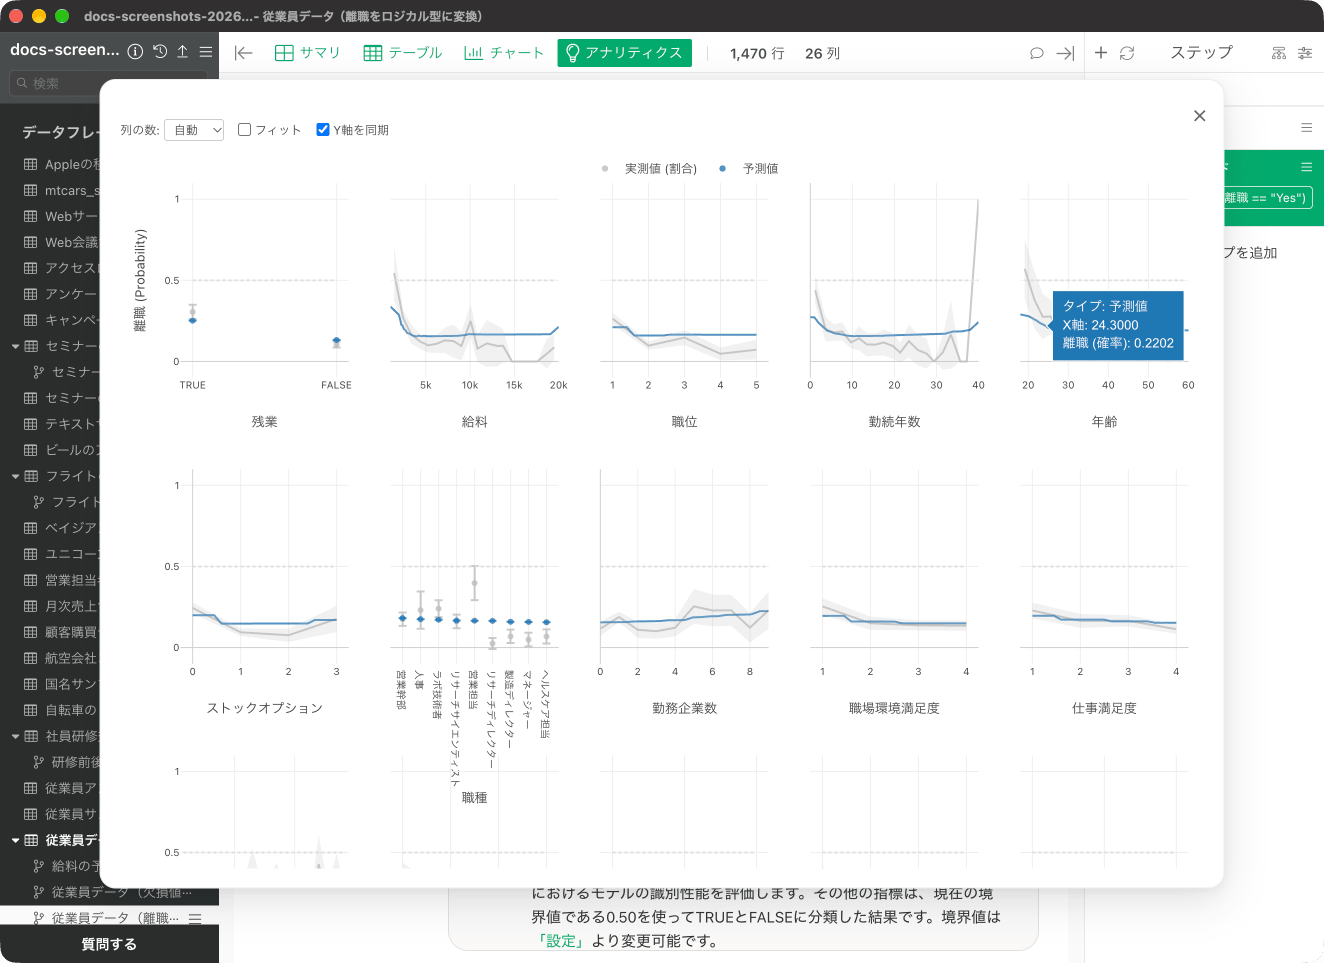
「予測に関係する変数」の「変数の値と予測値」では、それぞれの変数の値が変わると、目的変数の値はどのように変わるのかがわかります。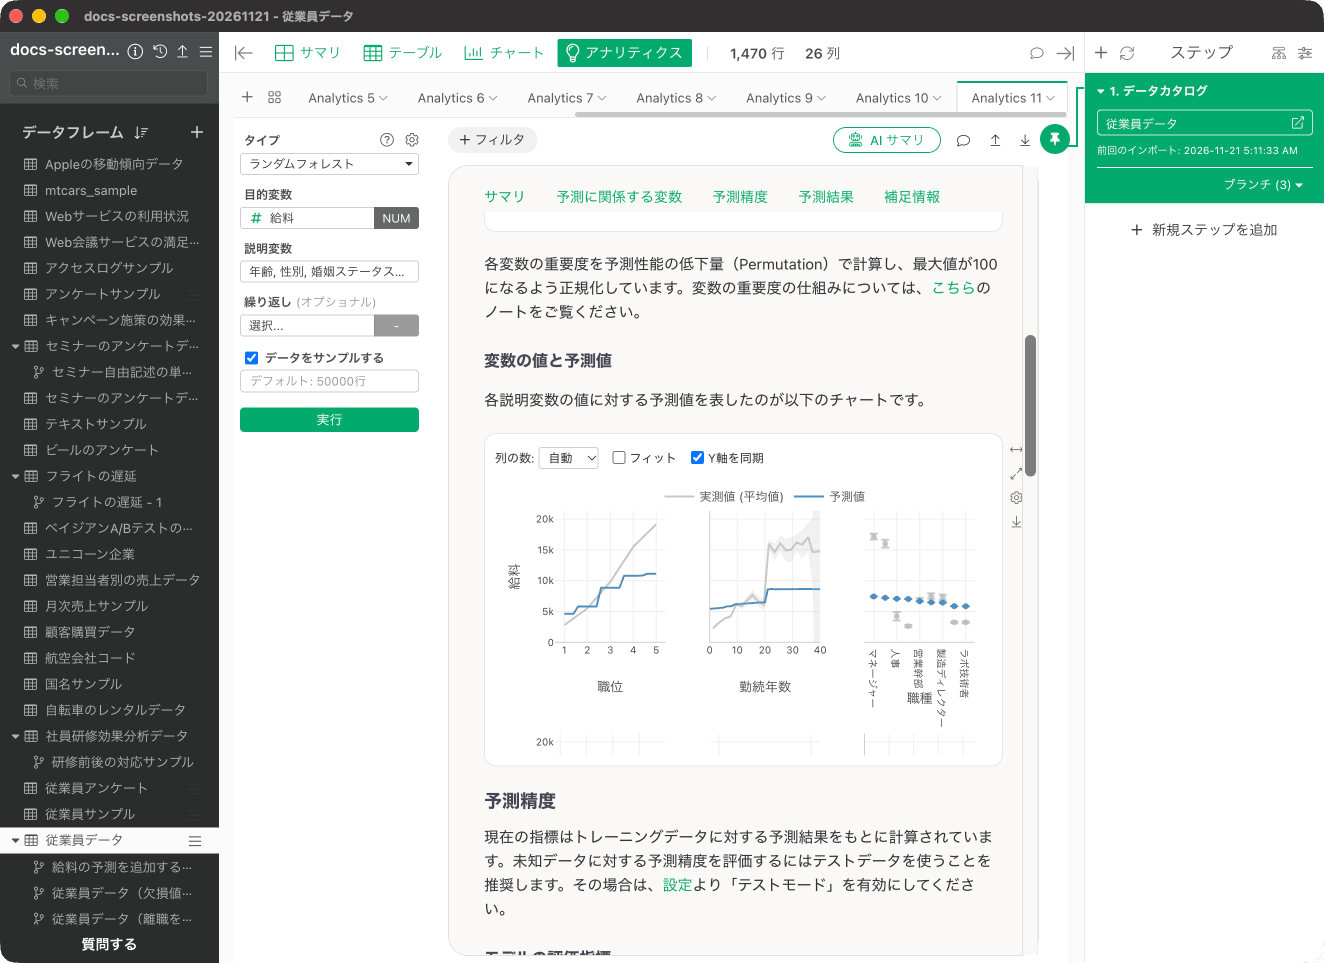
予測精度
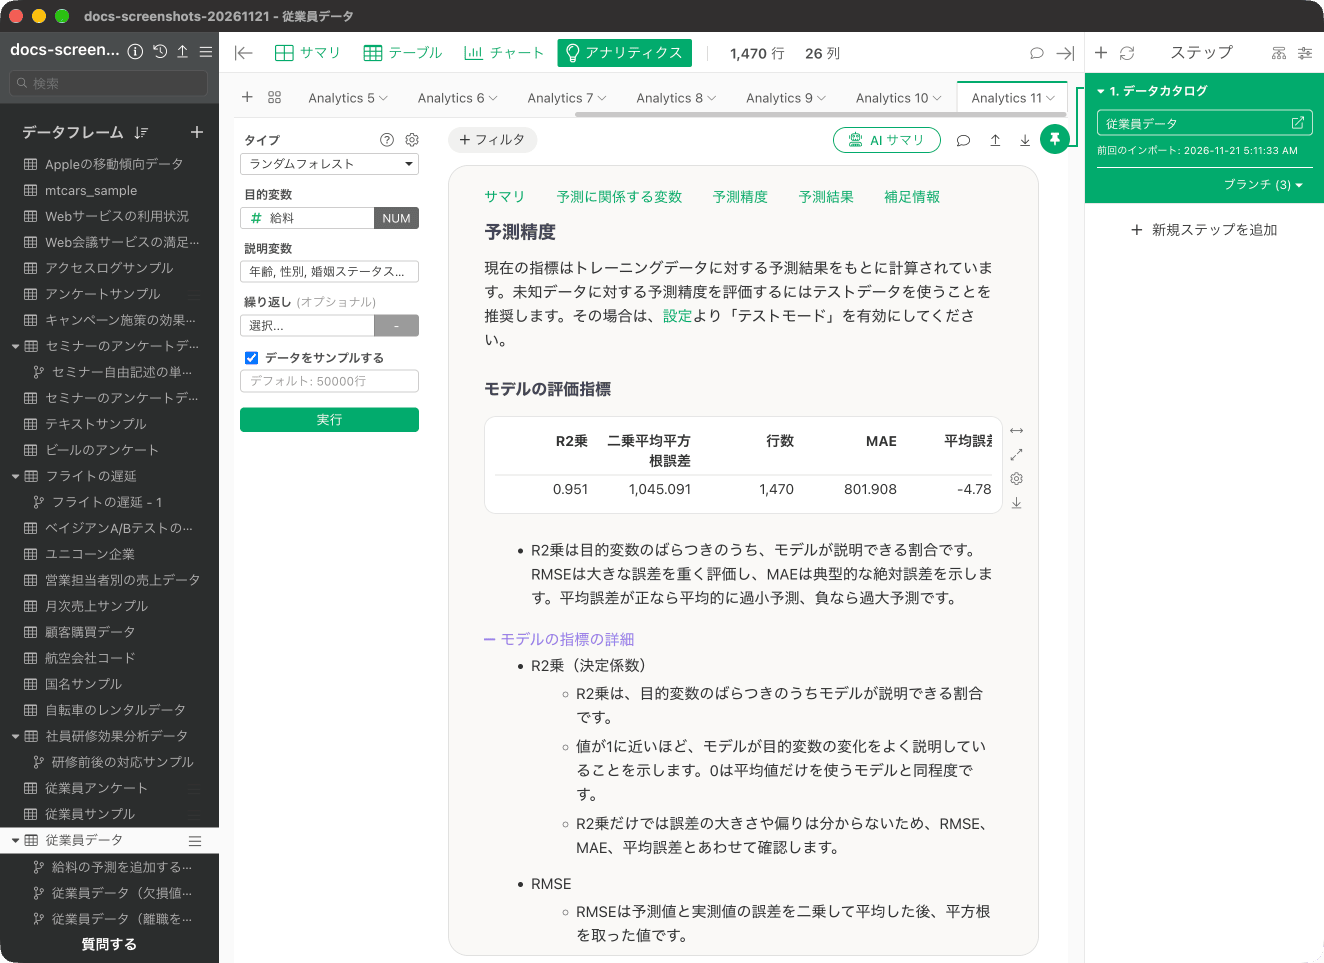
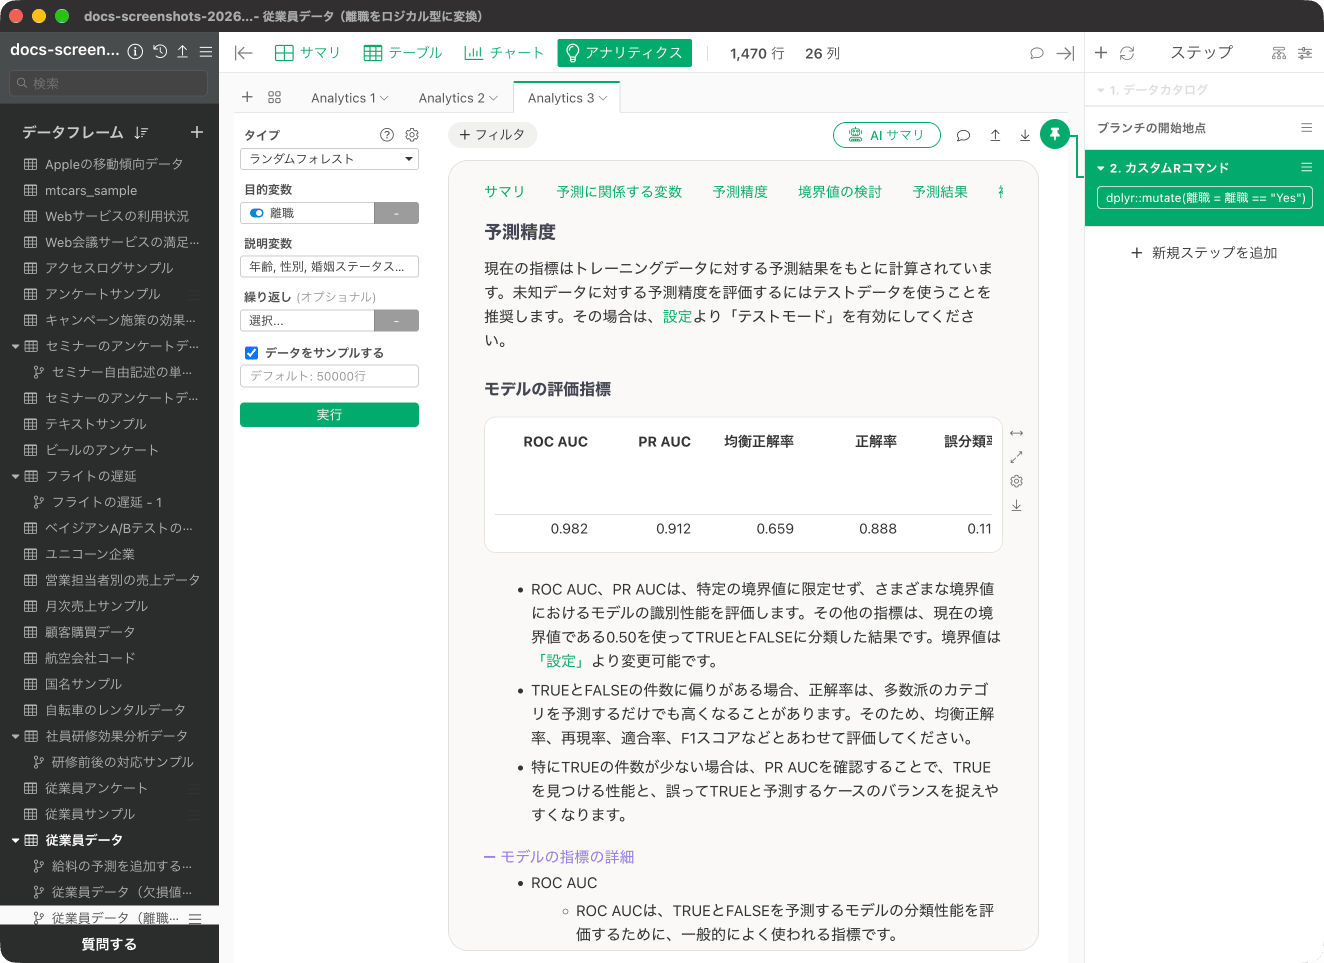
「予測精度」の「モデルの評価指標」では、この予測モデルの評価を確認できます。現在の指標はトレーニングデータに対する予測結果をもとに計算されており、未知データに対する予測精度を評価するにはテストデータを使うことが推奨されています。その場合は「設定」から「テストモード」を有効にしてください。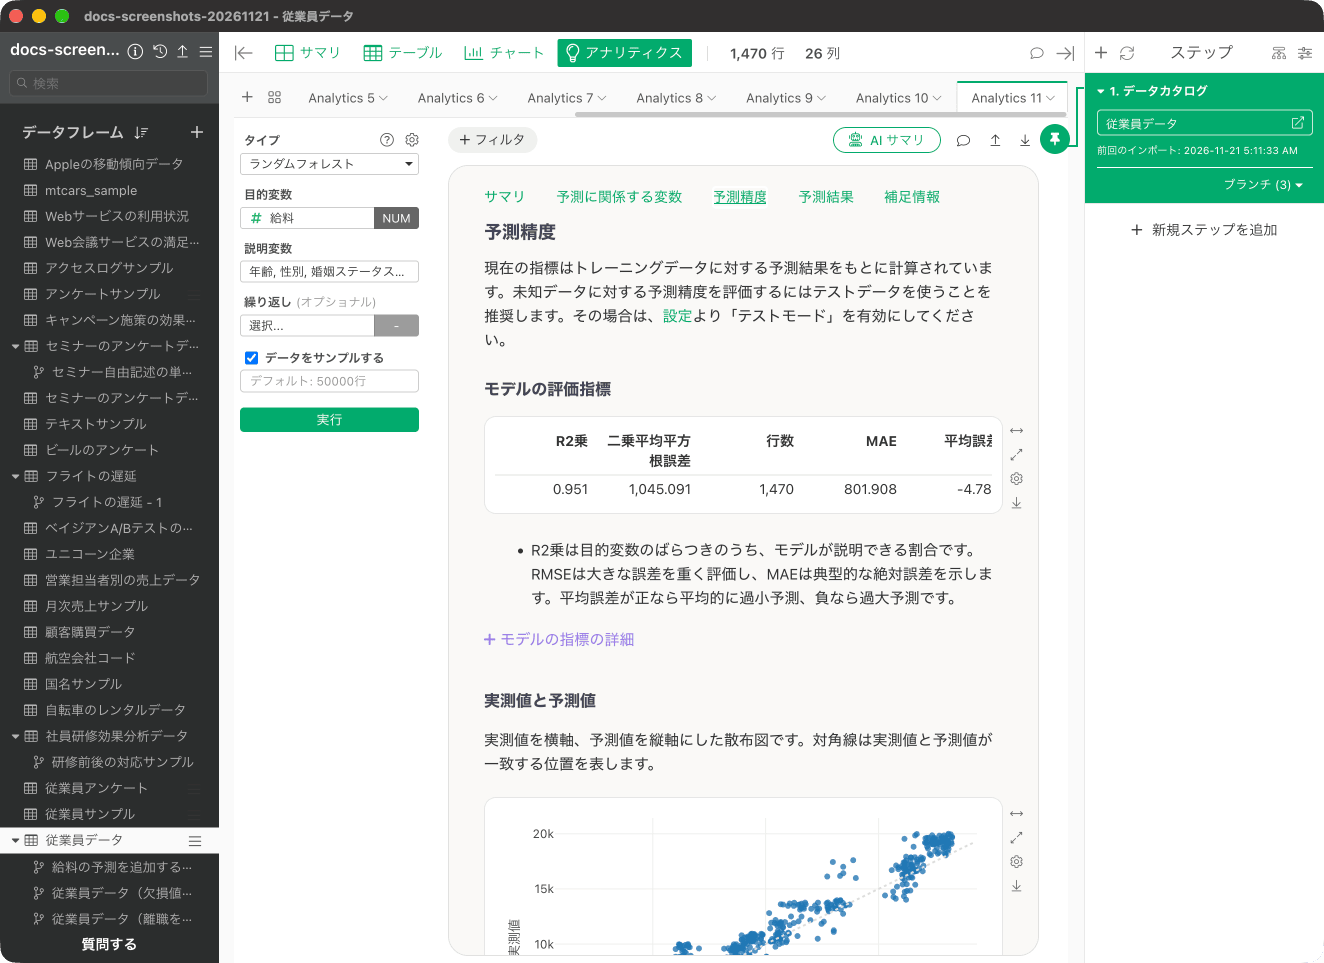
予測結果
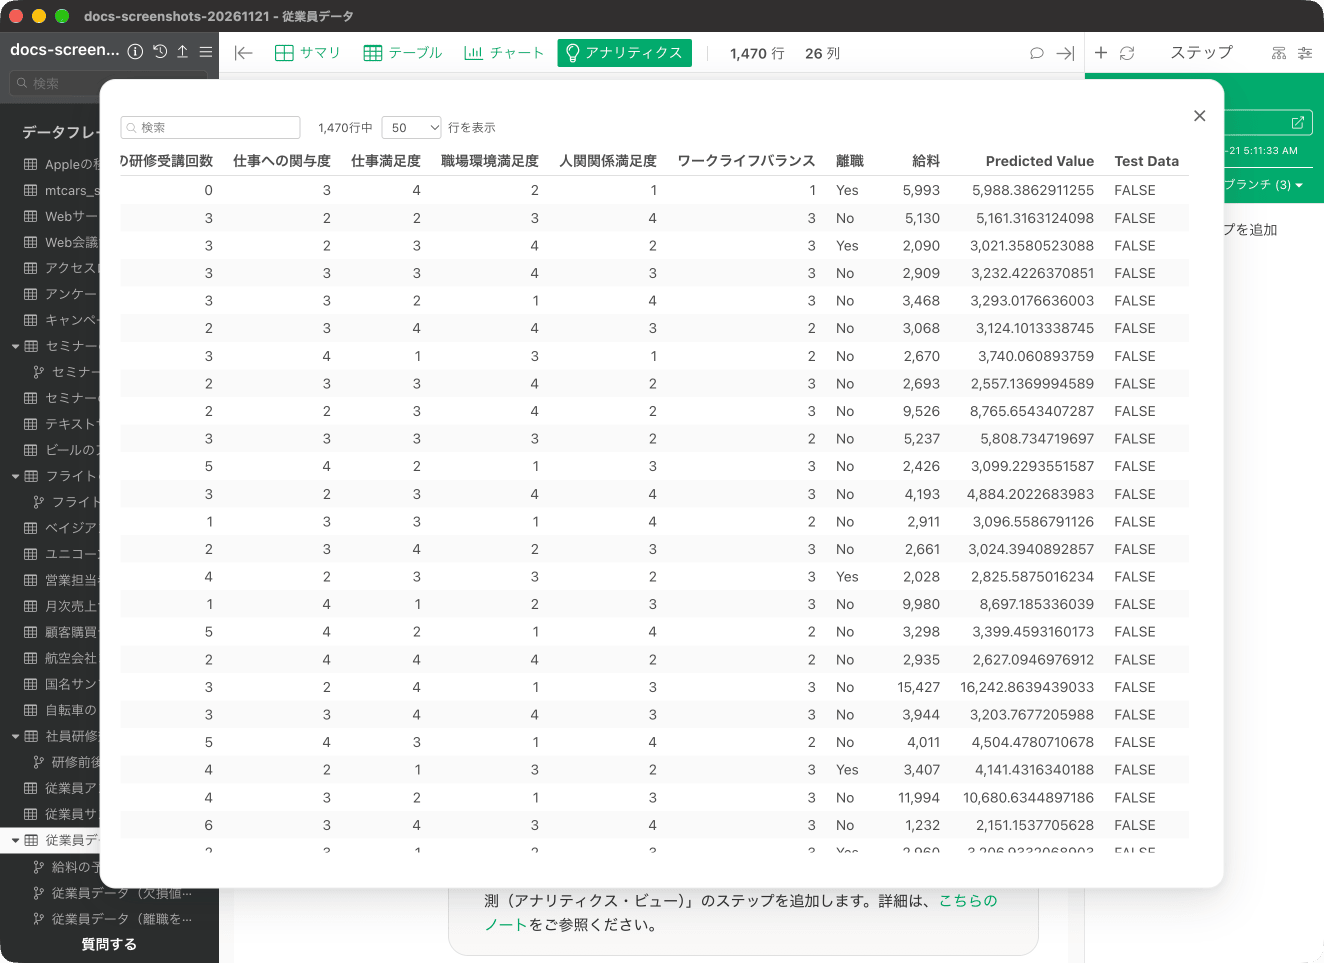
「予測結果」では、モデルに使用したデータと予測値がテーブル形式で表示されます。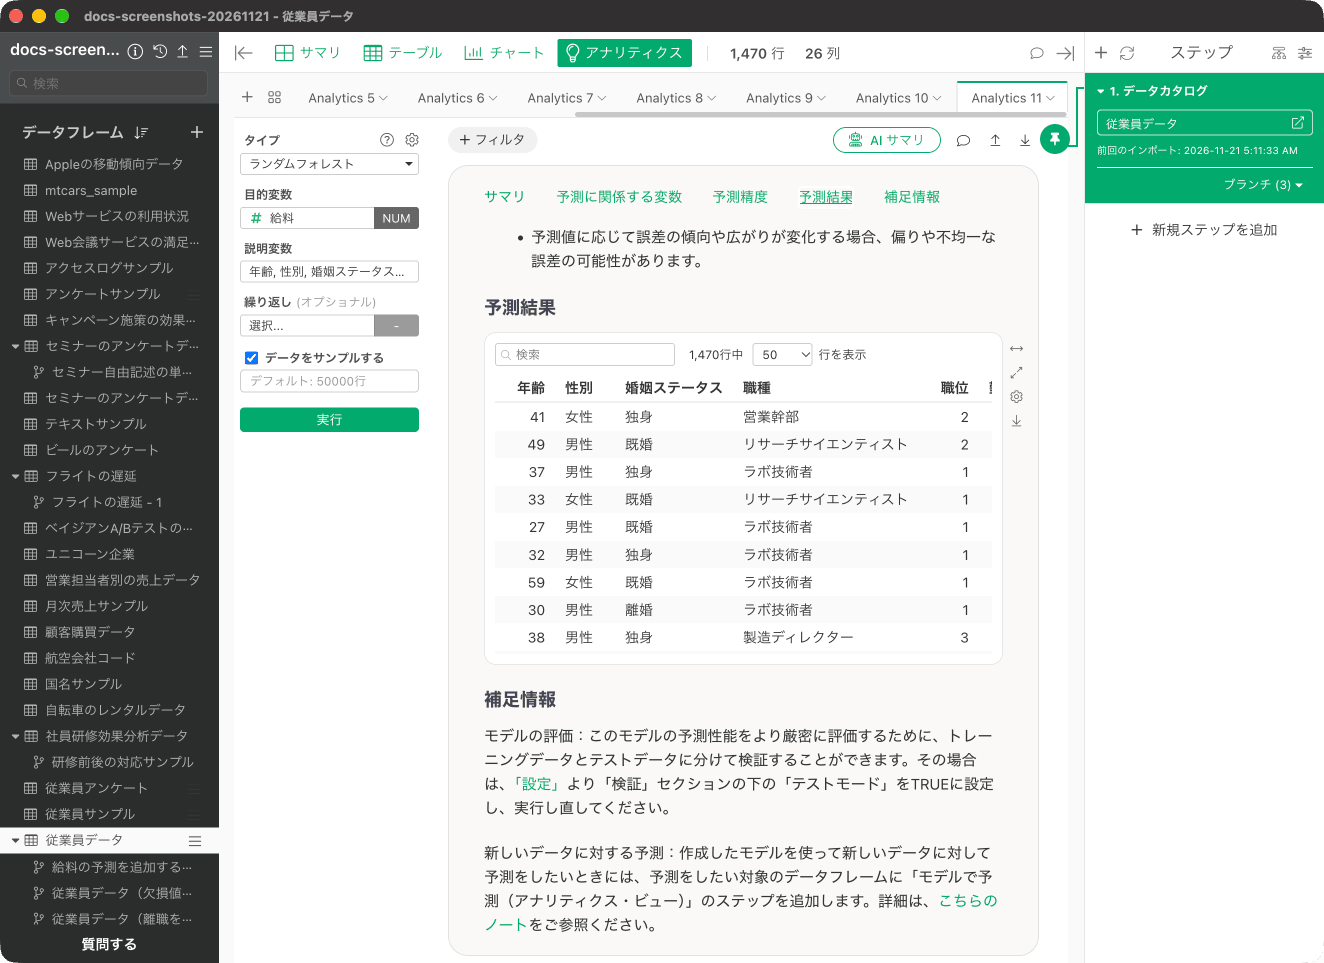
ロジカル型を目的としたランダムフォレストのモデルを作成する
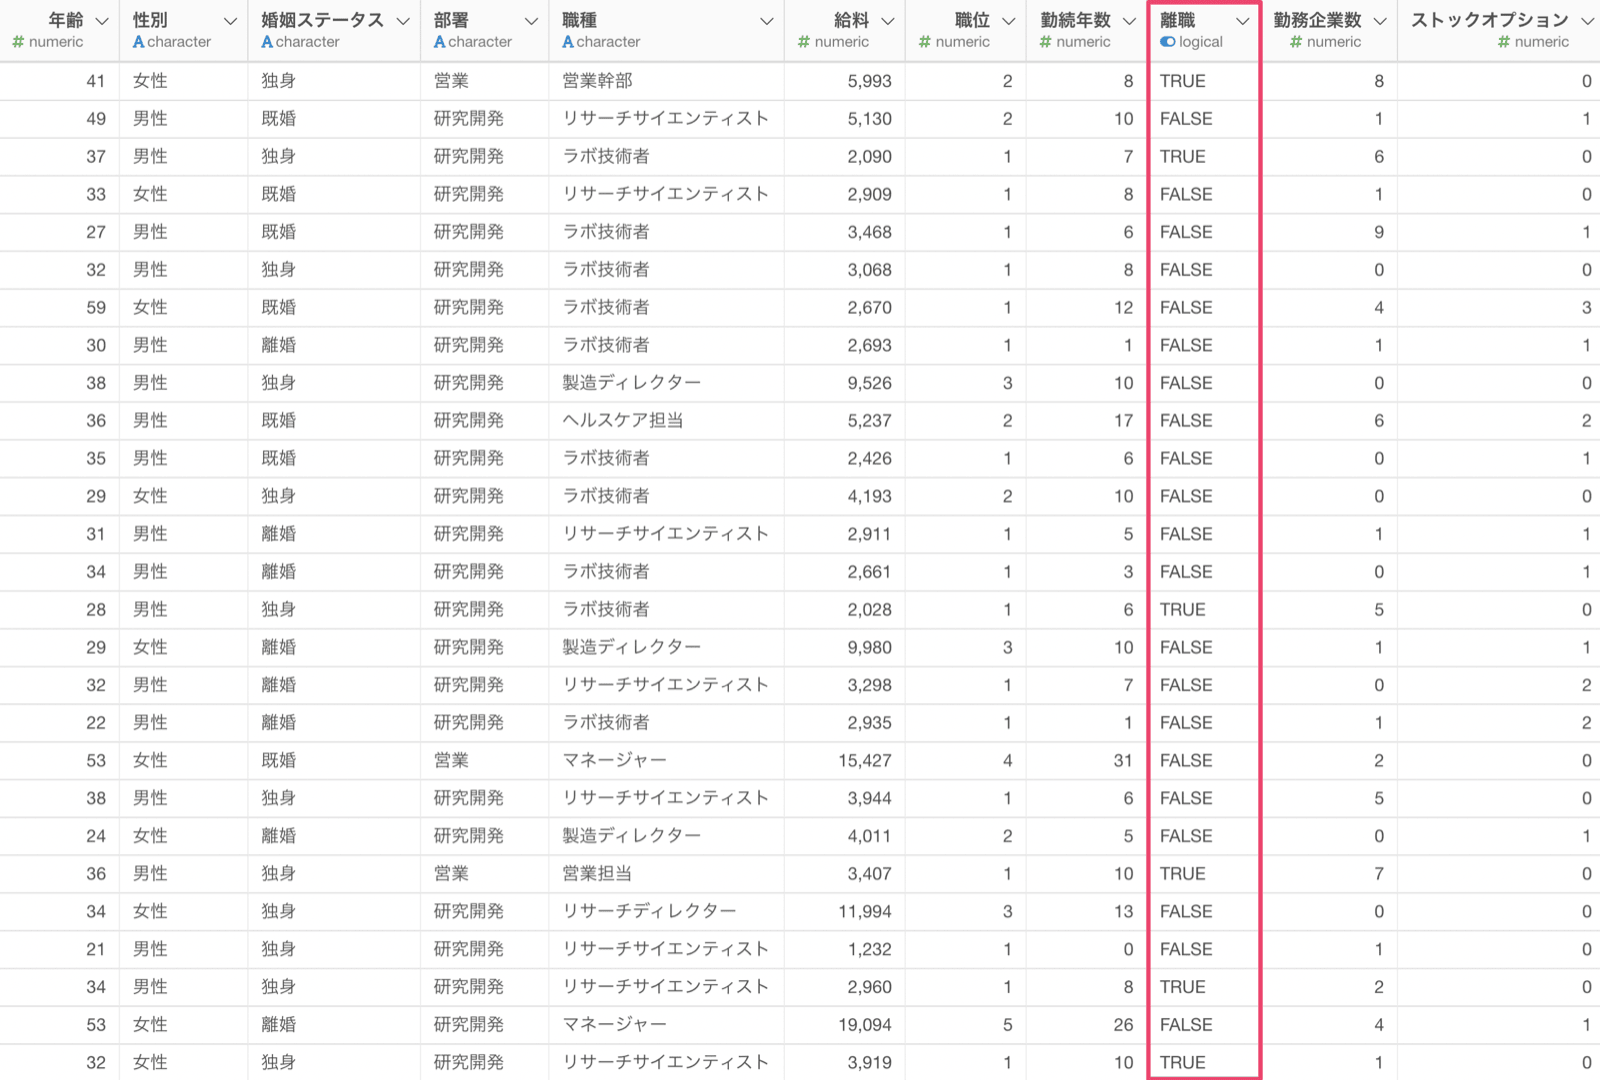
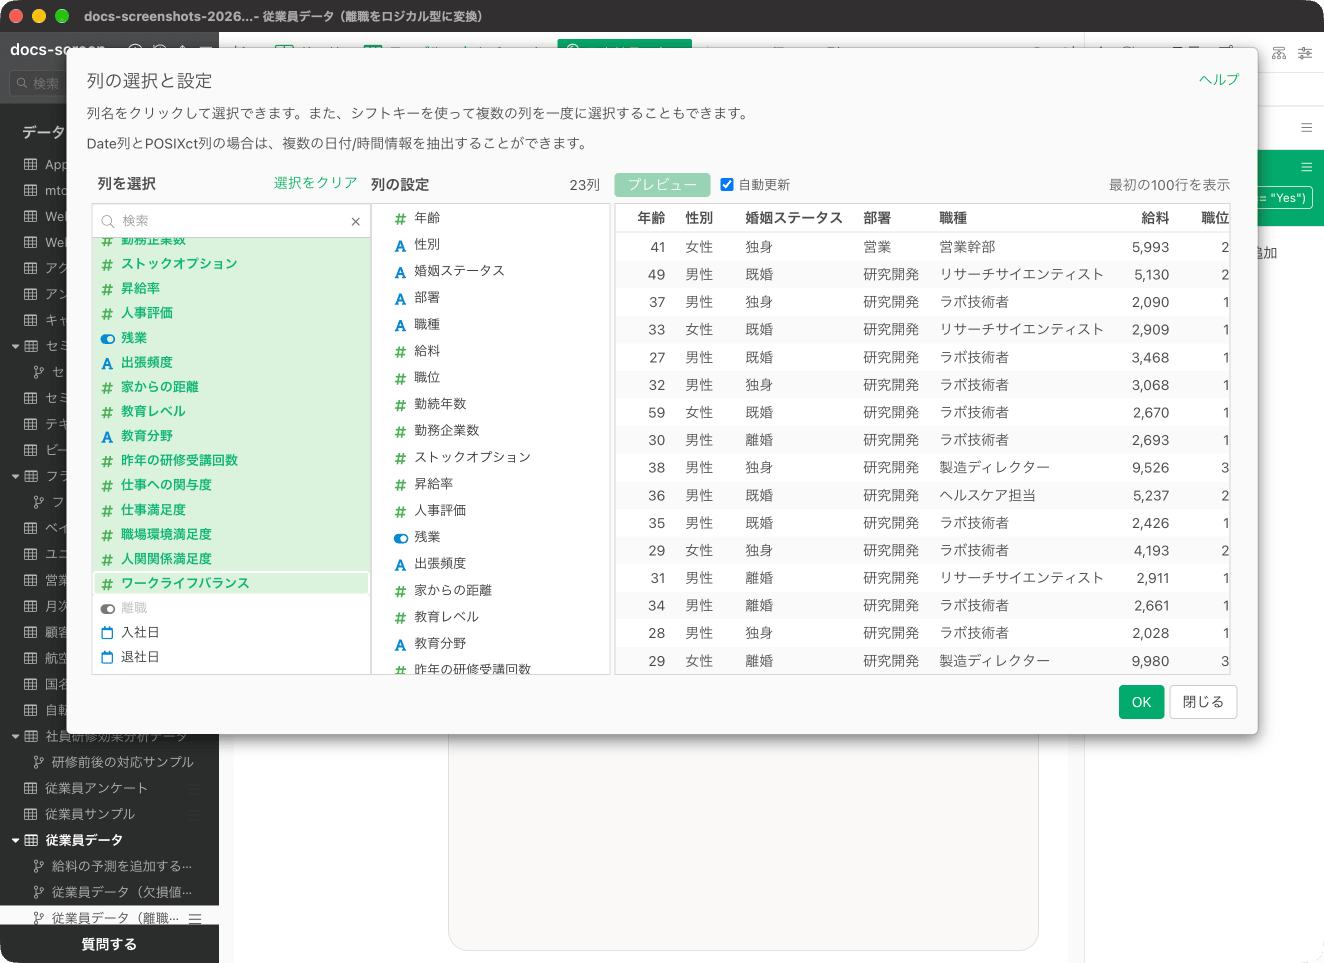
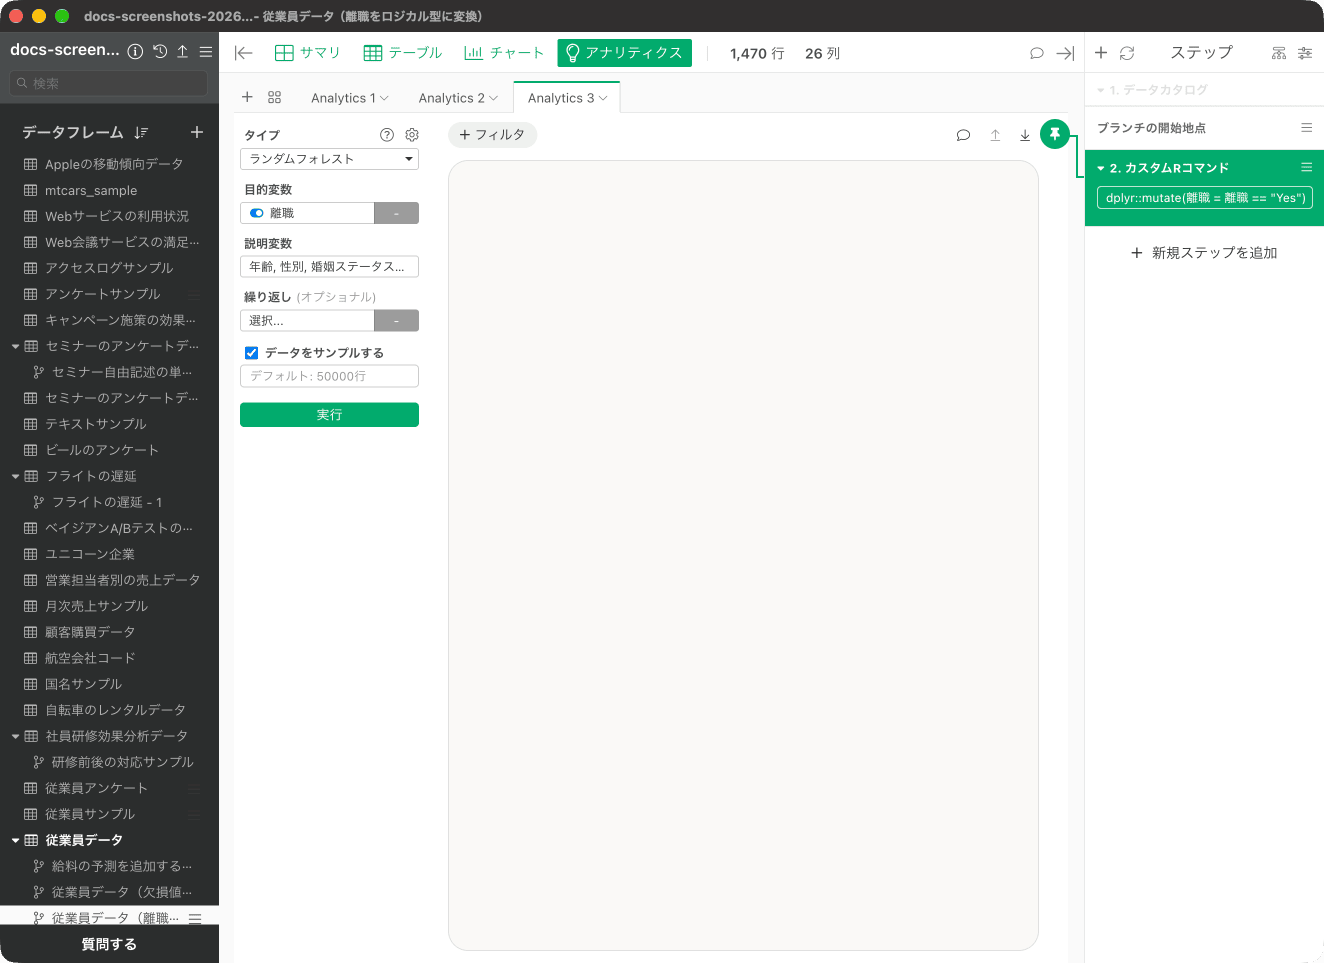
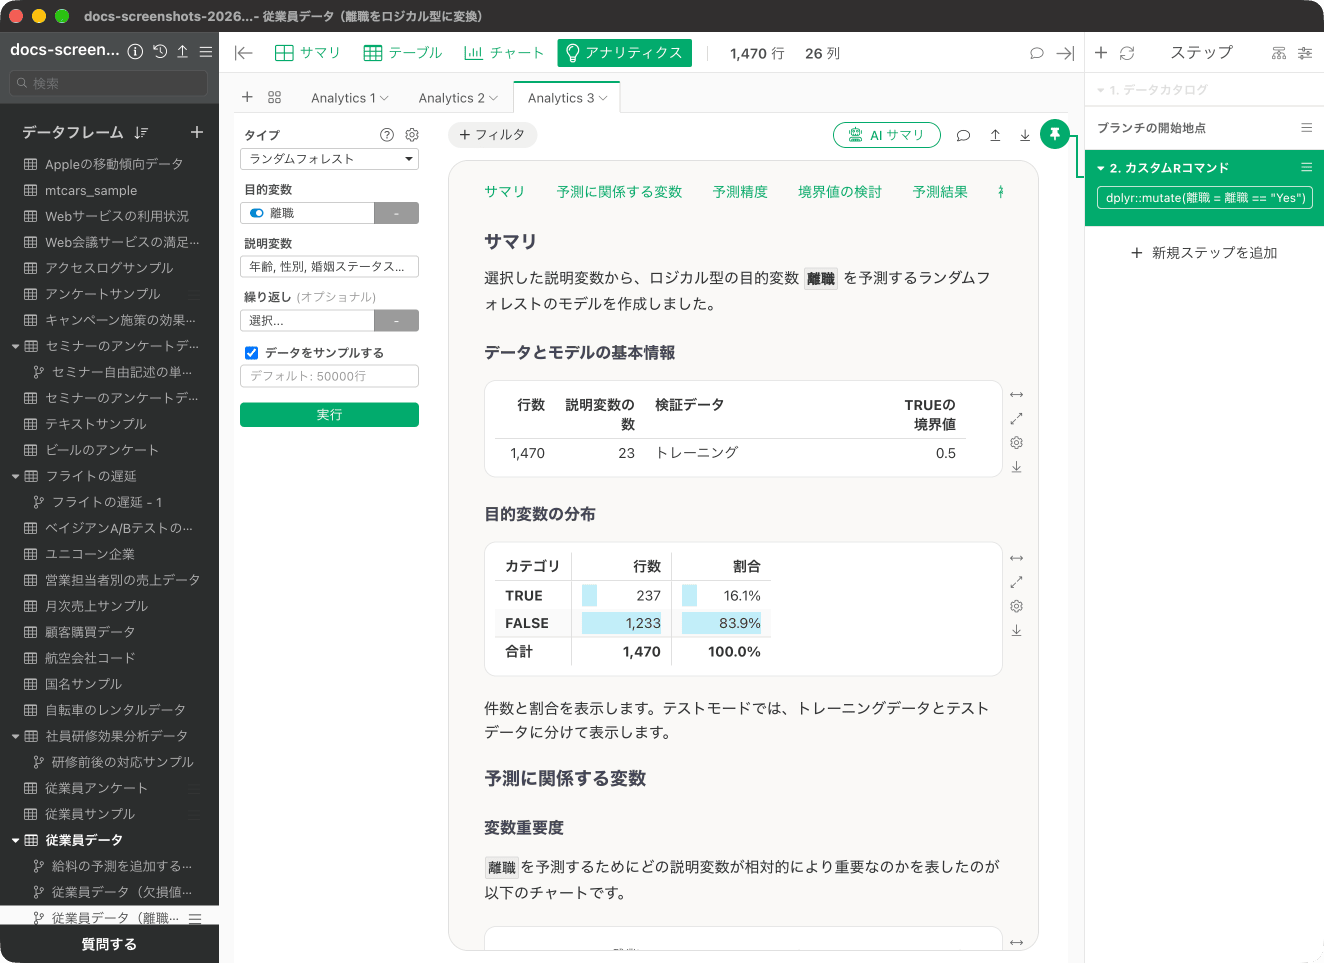
従業員が「離職」しているかどうかを予測するランダムフォレストのモデルを作成します。元の従業員データでは「離職」が文字型のため、ロジスティック回帰と同じく、「カスタムRコマンド」でdplyr::mutate(離職 = 離職 == "Yes") を実行して、ロジカル型に変換したデータフレームを使います。
結果の解釈
先程の数値型で紹介しているものは一部省いて説明しています。変数重要度
「予測に関係する変数」の「変数重要度」を見ると、残業、給料、職位、勤続年数、年齢が離職を予測する上で重要な変数のようです。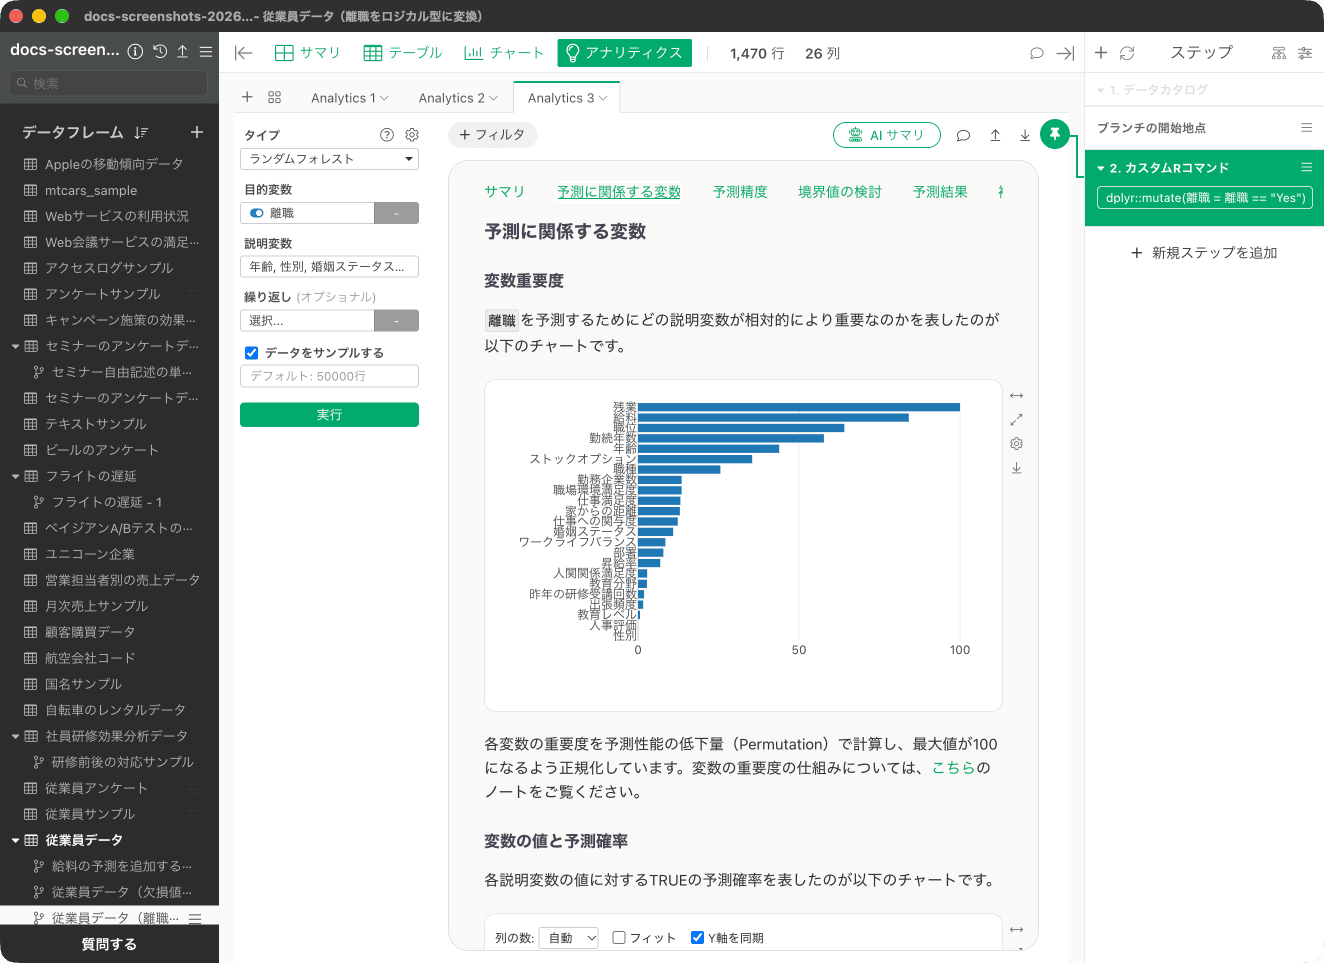
変数の値と予測確率
それぞれの変数の値が変わると、離職の予測確率がどのように変わるかを「変数の値と予測確率」で確認します。 残業が TRUE の場合の予測確率は0.2513で、していない場合に比べて離職の確率が高いようです。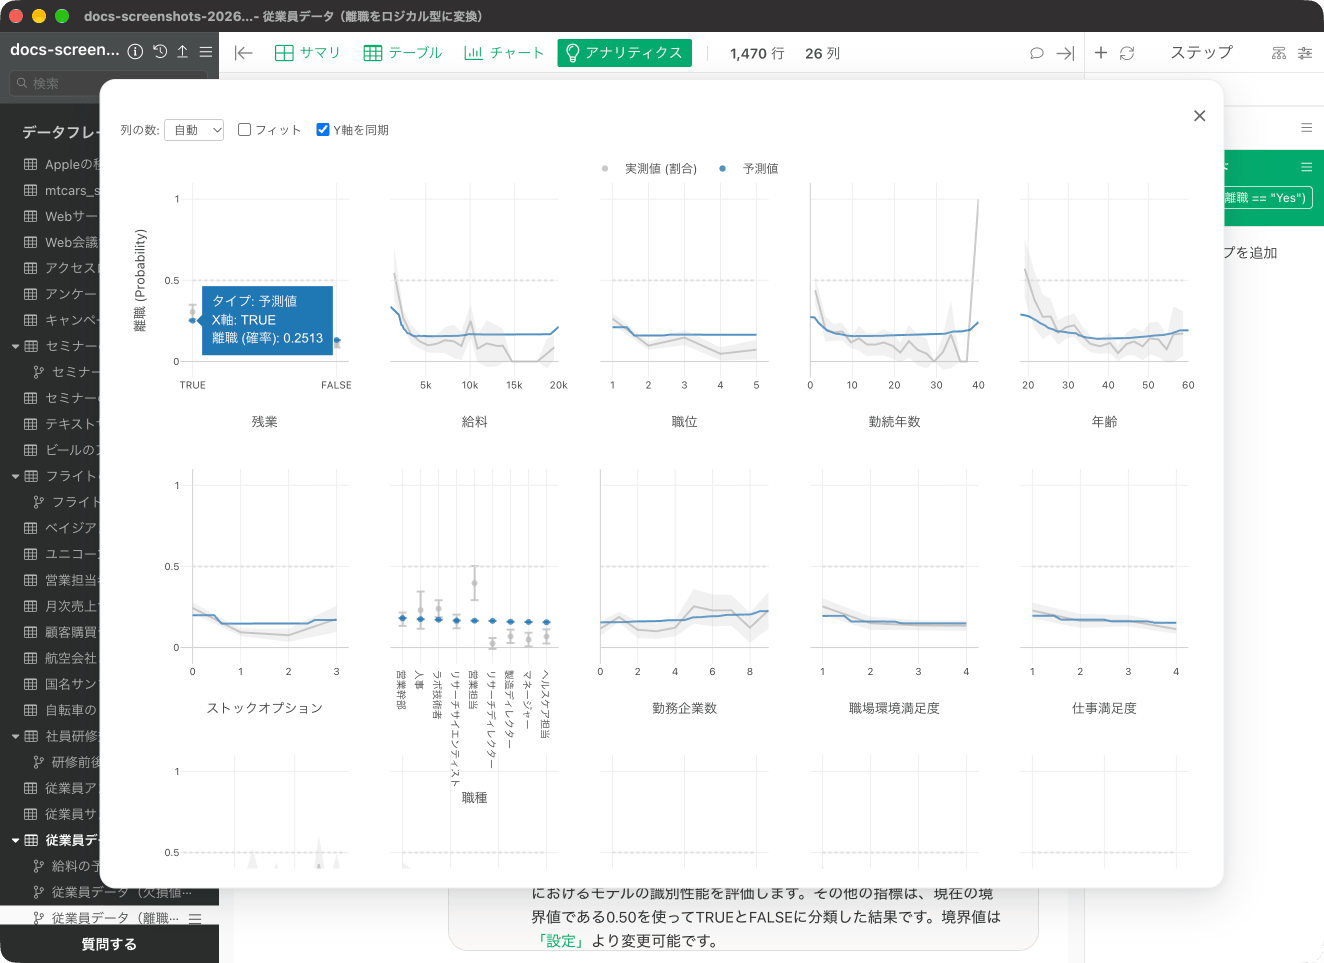
予測精度
「予測精度」の「モデルの評価指標」では、この予測モデルの評価を確認できます。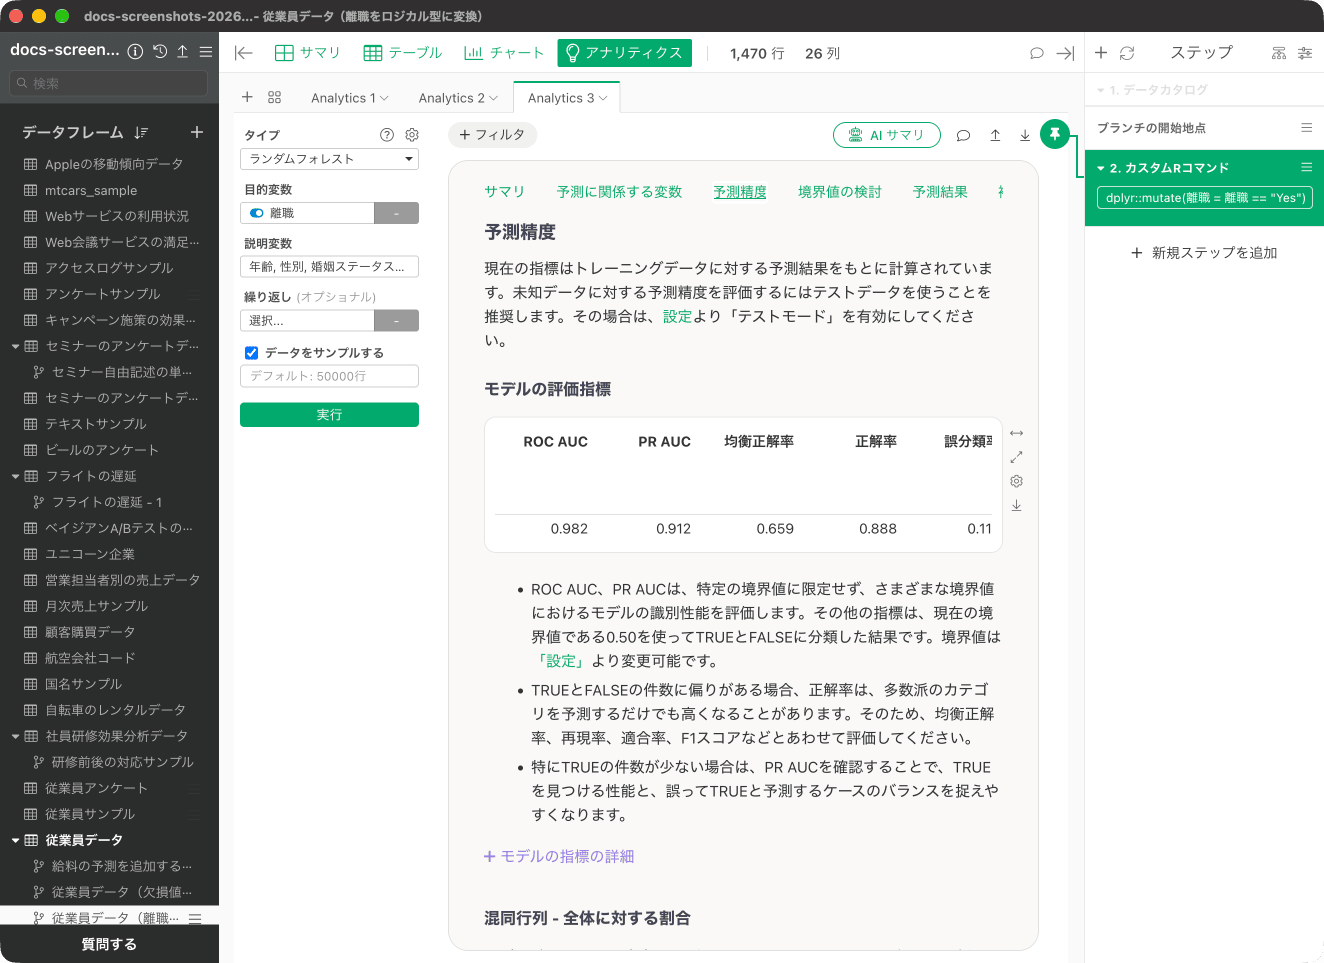
予測確率の分布
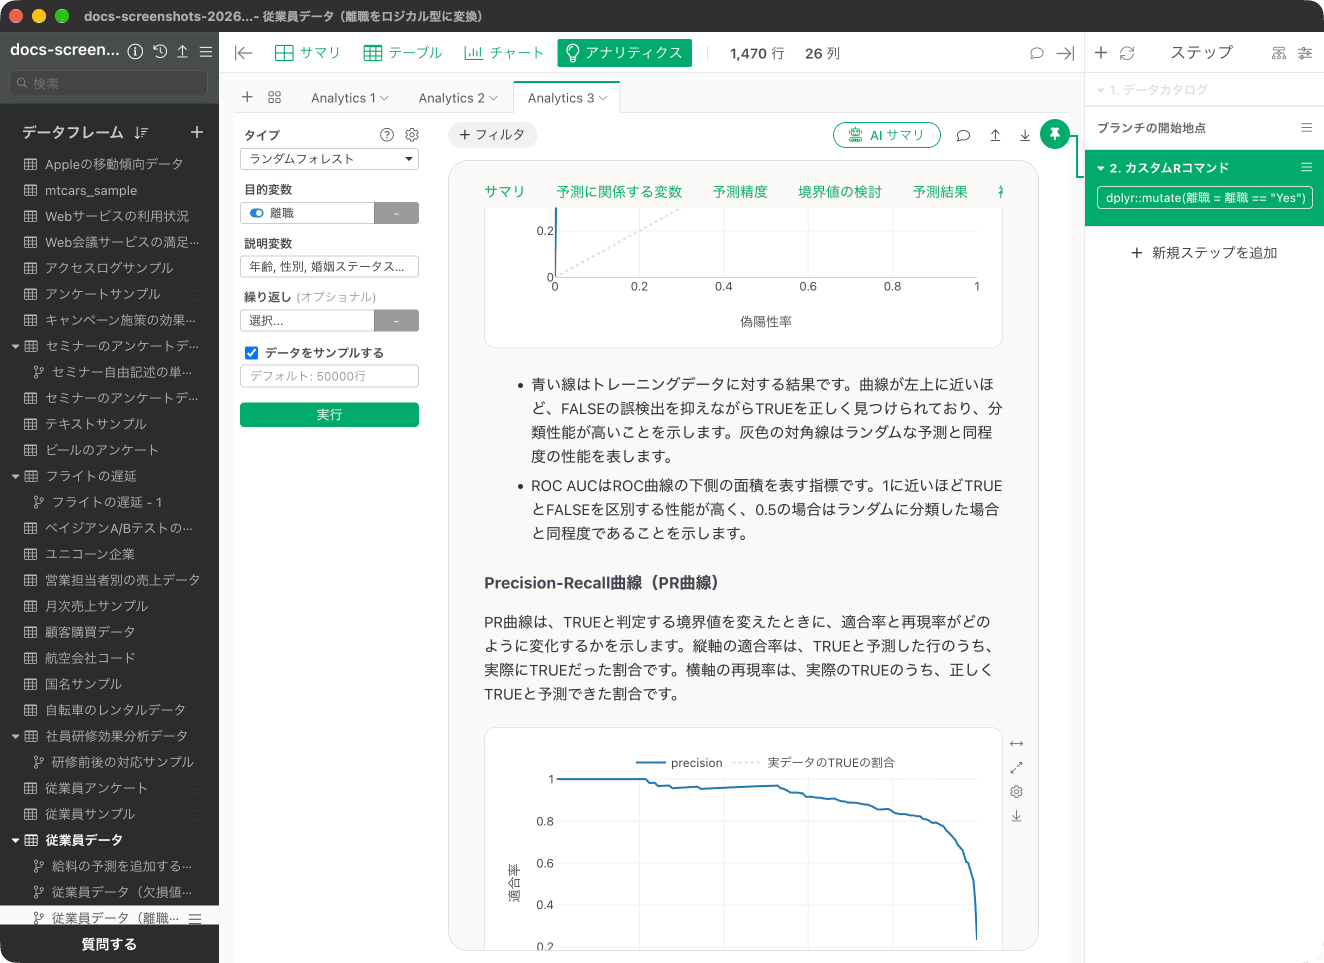
「予測確率の分布」では、このランダムフォレストのモデルで離職を予測した確率を、実際のデータでTRUEだったとき、FALSEだったときに分けて、それぞれ分布(密度曲線)にして可視化しています。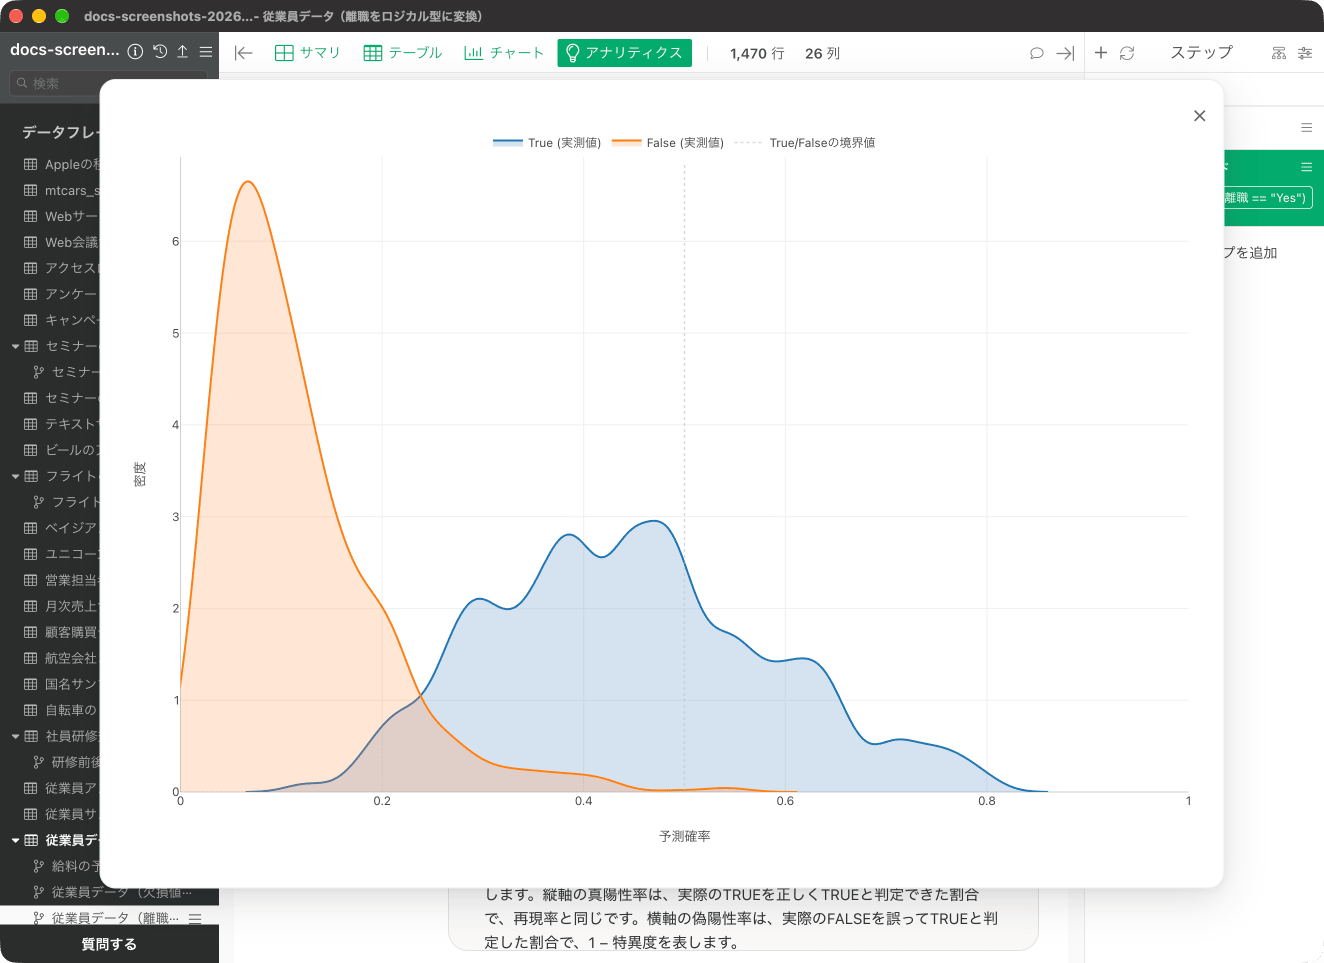
ROC曲線
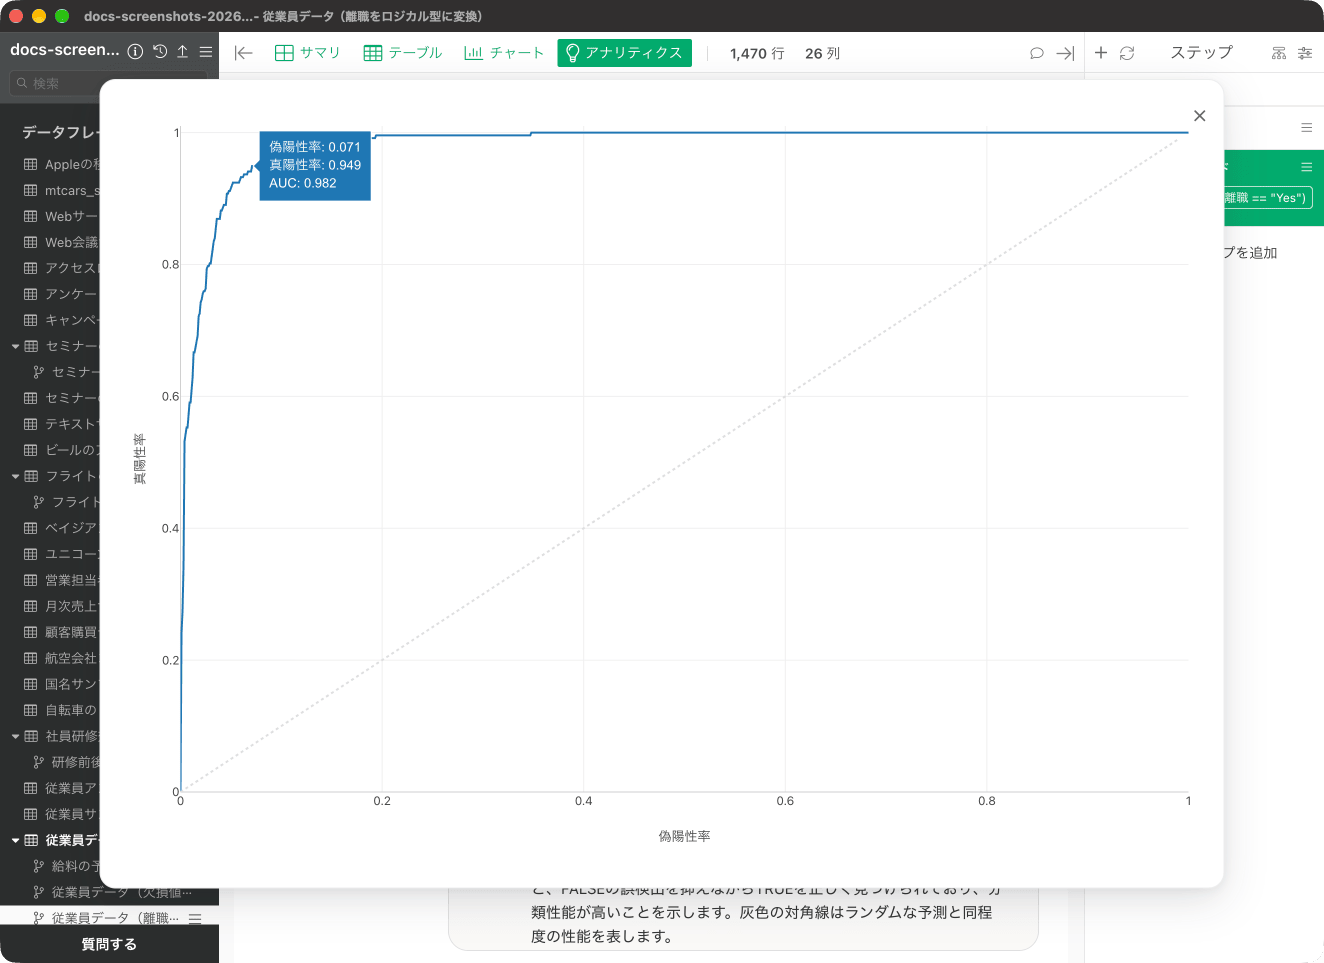
「ROC曲線」では、ROC AUCの元となる面積をROC曲線から確認できます。青い線は曲線が左上に近いほど、FALSEの誤検出を抑えながらTRUEを正しく見つけられていて、分類性能が高いことを示します。灰色の対角線はランダムな予測と同程度の性能です。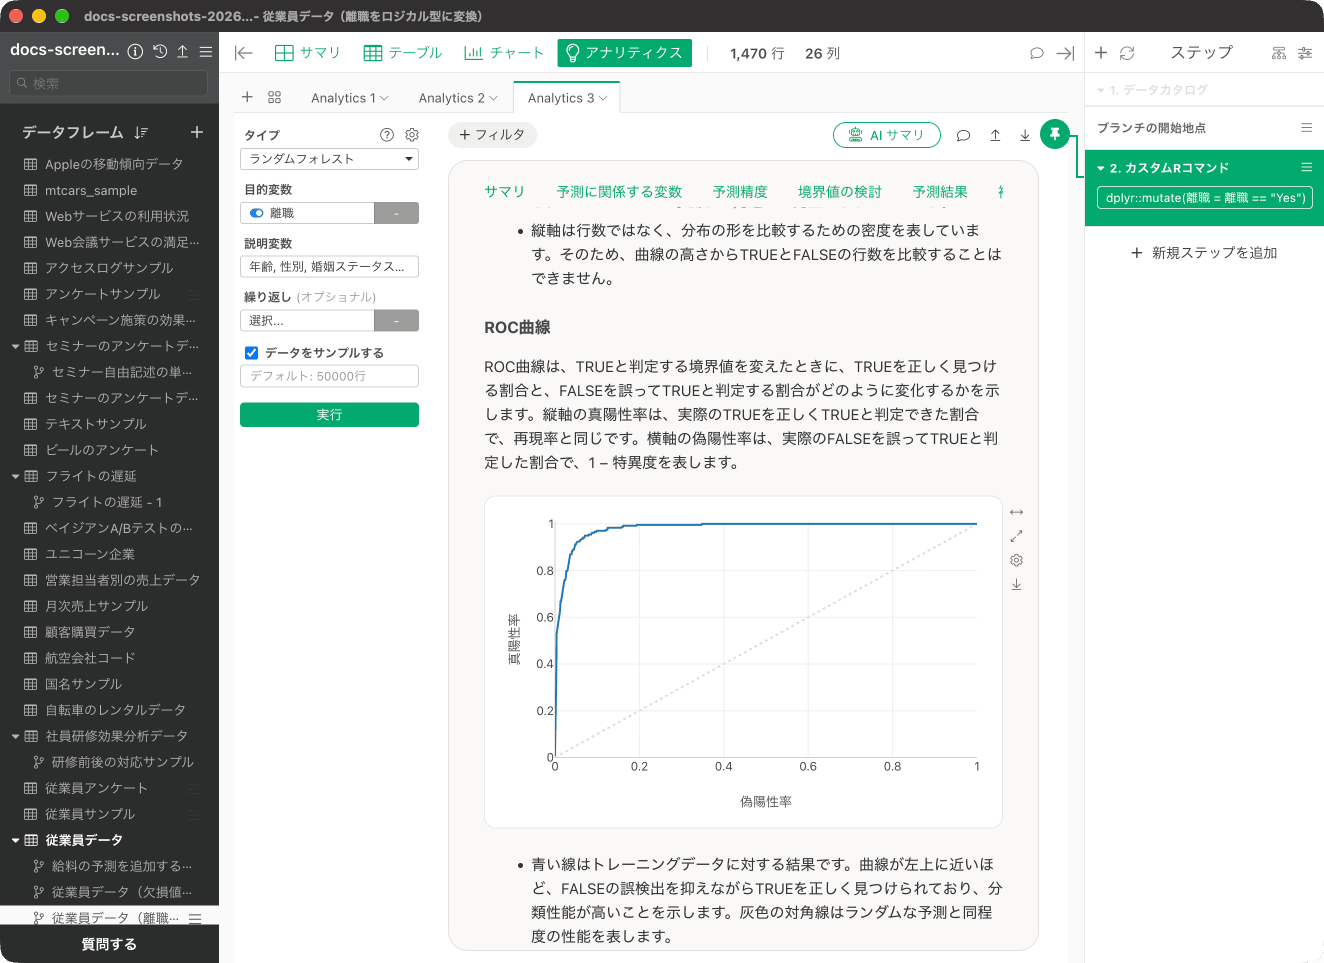
予測結果
「予測結果」では、目的変数である離職と、このモデルで算出された予測ラベル(Predicted Label)、予測確率(Predicted Probability)を確認できます。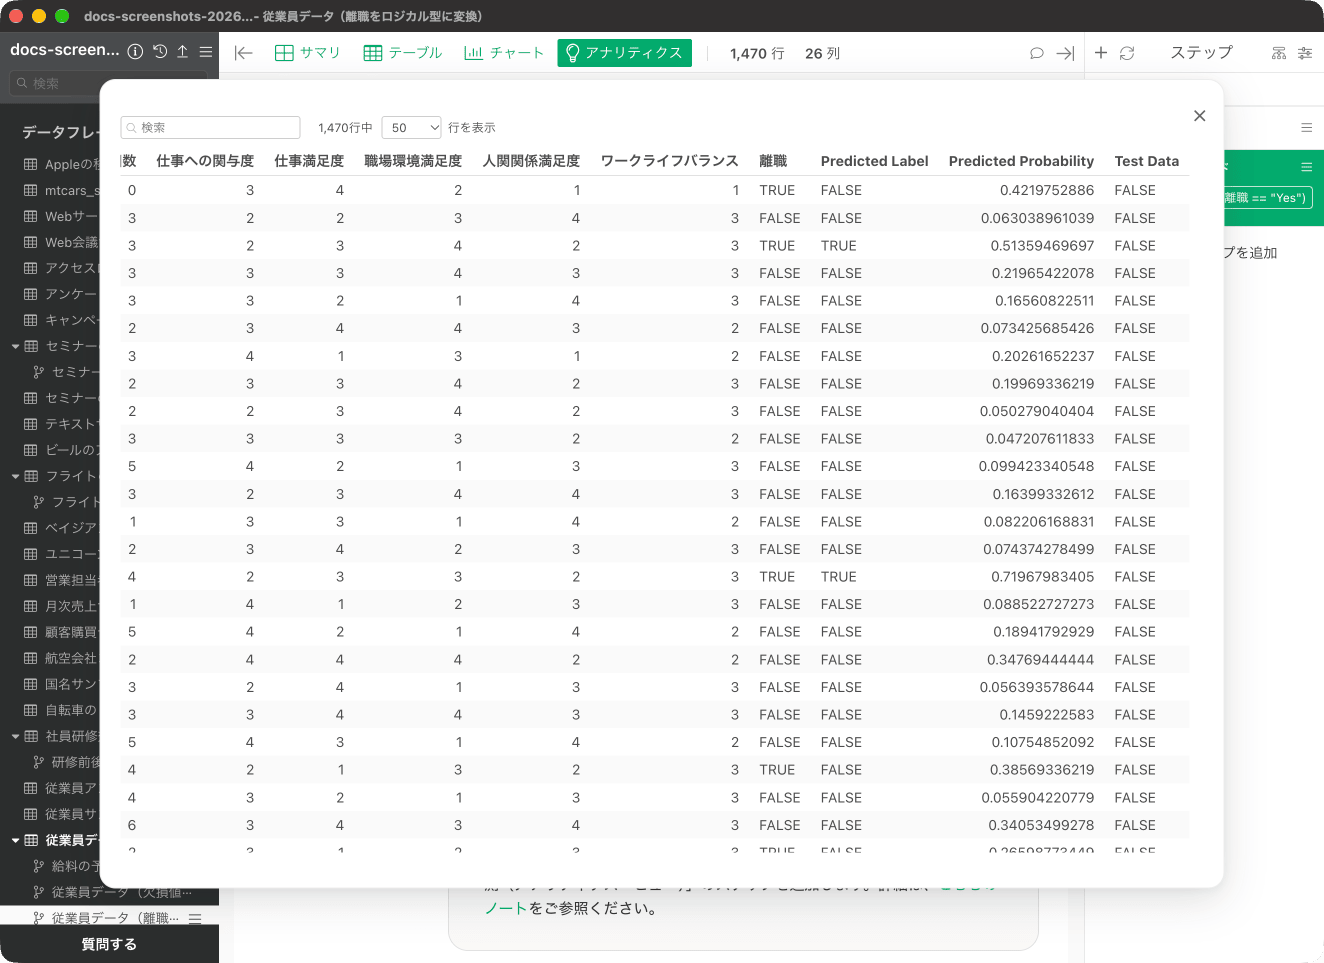
ランダムフォレストに関するよくある質問
Q: 「変数の値と予測値」で表示されている実測値はどのように求められているのですか?
「変数の値と予測値」の実測値はそれぞれの説明変数のデータタイプによって表示が異なります。 詳しくはこちらのノートをご覧ください。Q: 「変数の値と予測値」で表示されている予測値はどのように求められているのですか?
予測値のチャートはPartial Dependence Plot(PDP)と呼ばれるもので、注目している変数の値を変化させたときに、予測結果がどう変わるかを可視化したチャートとなります。詳しくはこちらのノートをご覧ください。Q: 機械学習と統計学習の違いで、統計学だと少ないサンプルで予測する、機械学習だと大きなデータで予測する。なにかデータ数の基準はありますか?
特にありません。Q: ランダムフォレストには多重共線性の問題は関係ないのでしょうか?
多重共線性という名前で呼ばれることはないのですが同様の問題はあって、同じような情報が複数の列から得られると、変数重要度などの分析結果が不安定になることがあります。Q: ランダムフォレストで決定木を作る回数などは分析者がチューニングするのでしょうか?
予測する際にはチューニングしすぎると、オーバーフィッティング(過学習)が起きる可能性があるのでテストが必要になります。Q: 変数重要度がマイナスになってしまう時はどう解釈すれば良いでしょうか?
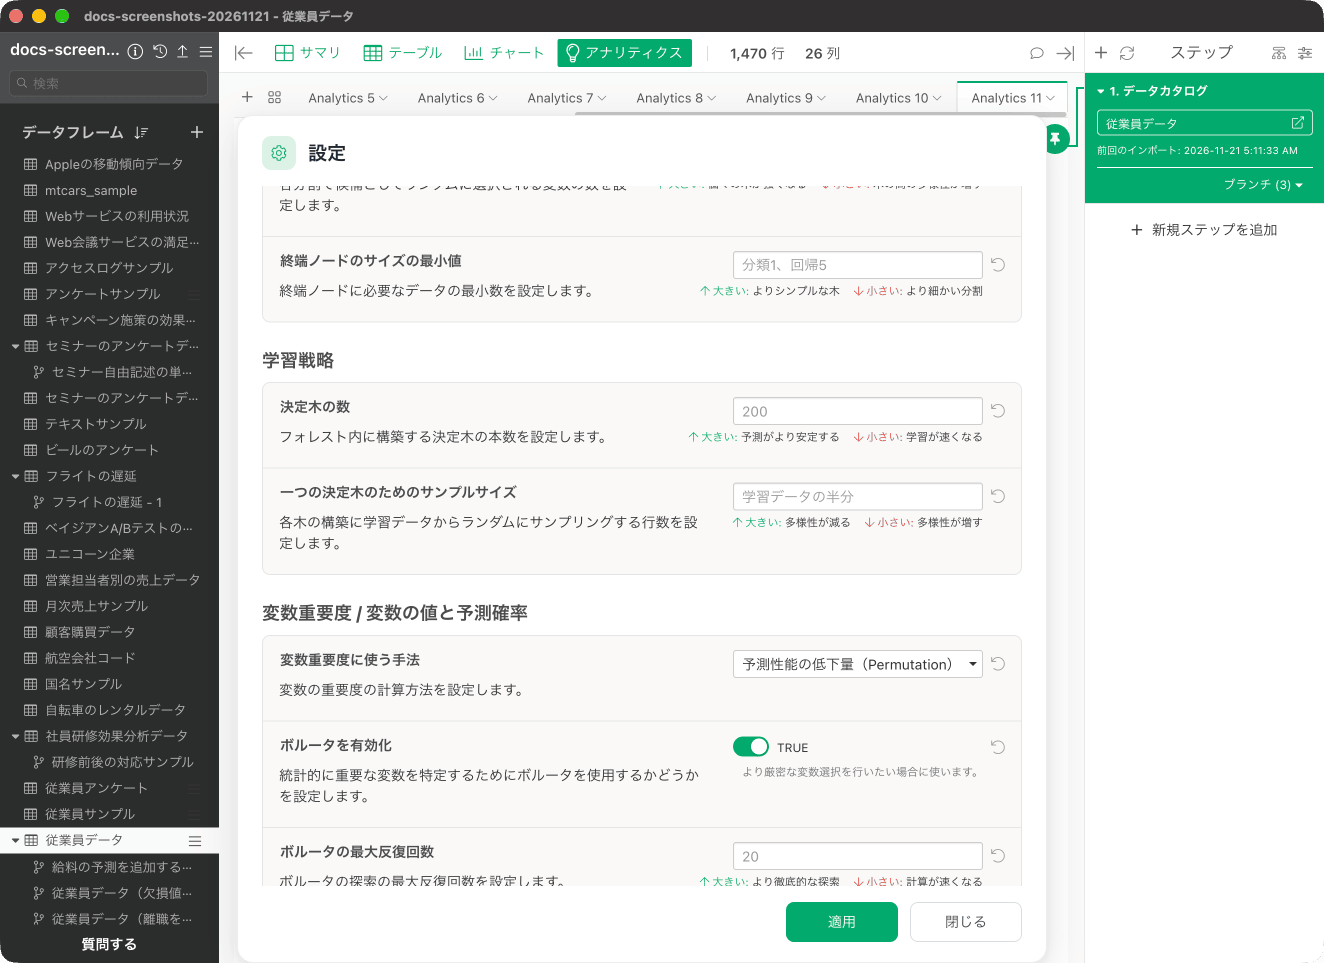
変数重要度ではPermutationという手法を使用しており、下記のような仕組みになっています。- 学習済みのモデルは固定したまま、評価用のデータで1つの説明変数の列の値をランダムに並べ替え(シャッフルし)、予測し直す。
- 並べ替える前に比べて、予測性能がどれだけ下がったか(予測誤差がどれだけ増えたか)を計算する。
- これを全ての変数で繰り返す。
- 予測性能の低下量をもとに、それぞれの変数の相対的な重要度を評価する。
- プラスの時: 並べ替えると予測性能が下がるため、その変数が予測に役立っていると考えられます。
- マイナスの時: 並べ替えた方が、元の列を使った時よりも予測性能が良くなっています。
Q: ランダムフォレストでボルータを使用した時に変数重要度がマイナスになるのはなぜでしょうか?
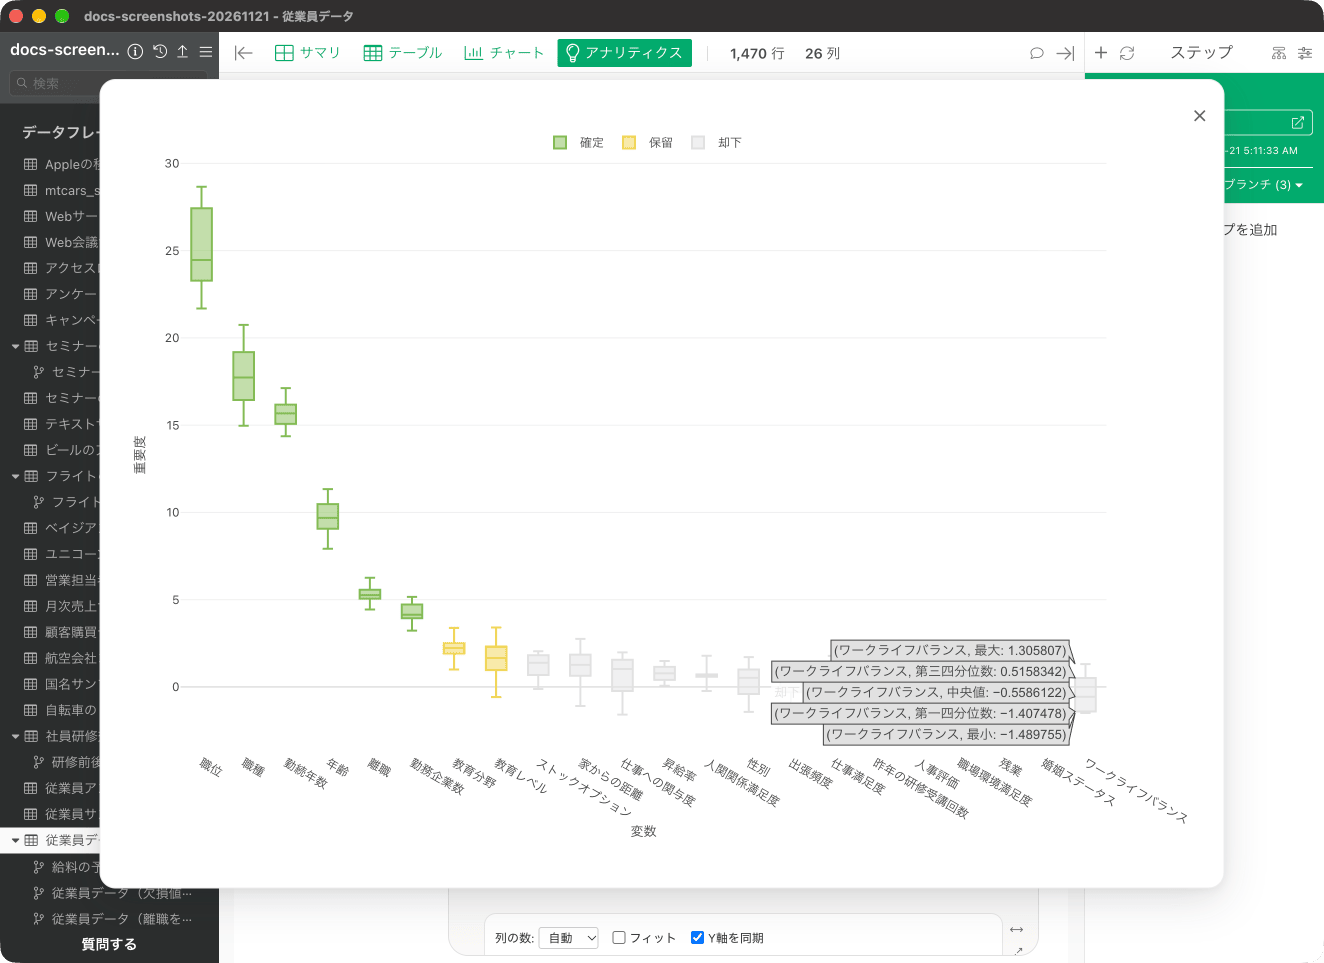
ボルータを有効にすると、変数重要度のチャートは箱ひげ図になり、変数が「確定」「保留」「却下」のどれかに分けて表示されます。下位の変数では、重要度が0を下回るものもあります。