メインコンテンツへスキップ
アナリティクス・ビューで作ったモデルを使うと、新しいデータフレームに対して予測し、その予測精度を評価できます。 予測できる値は、モデルに応じて次の 4 種類です。

使い方

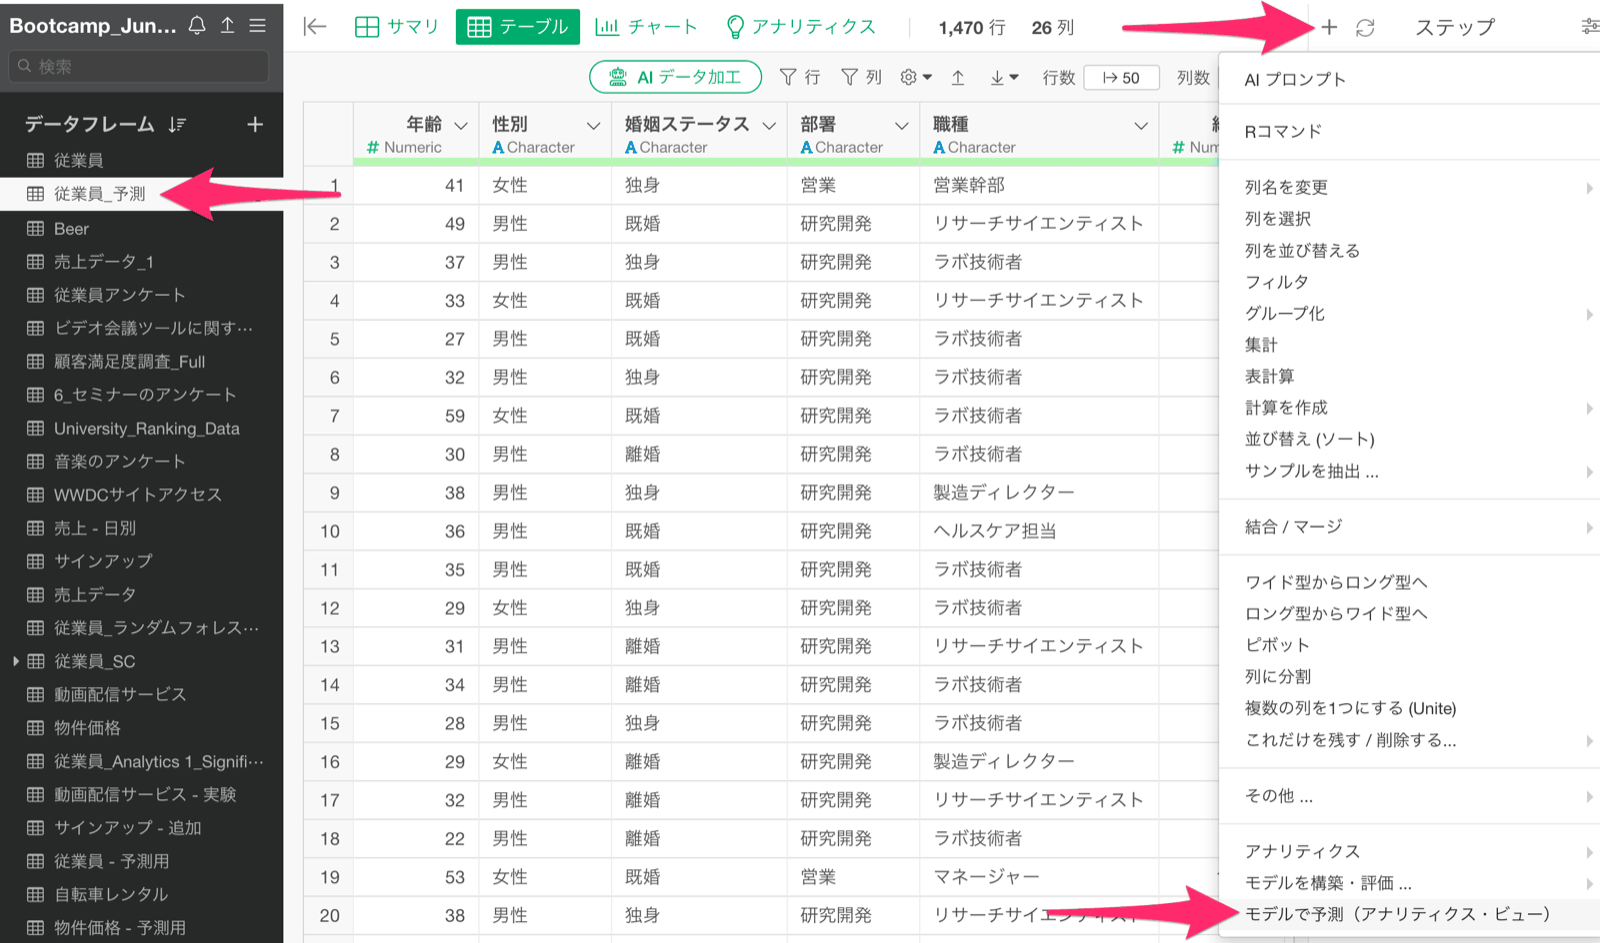
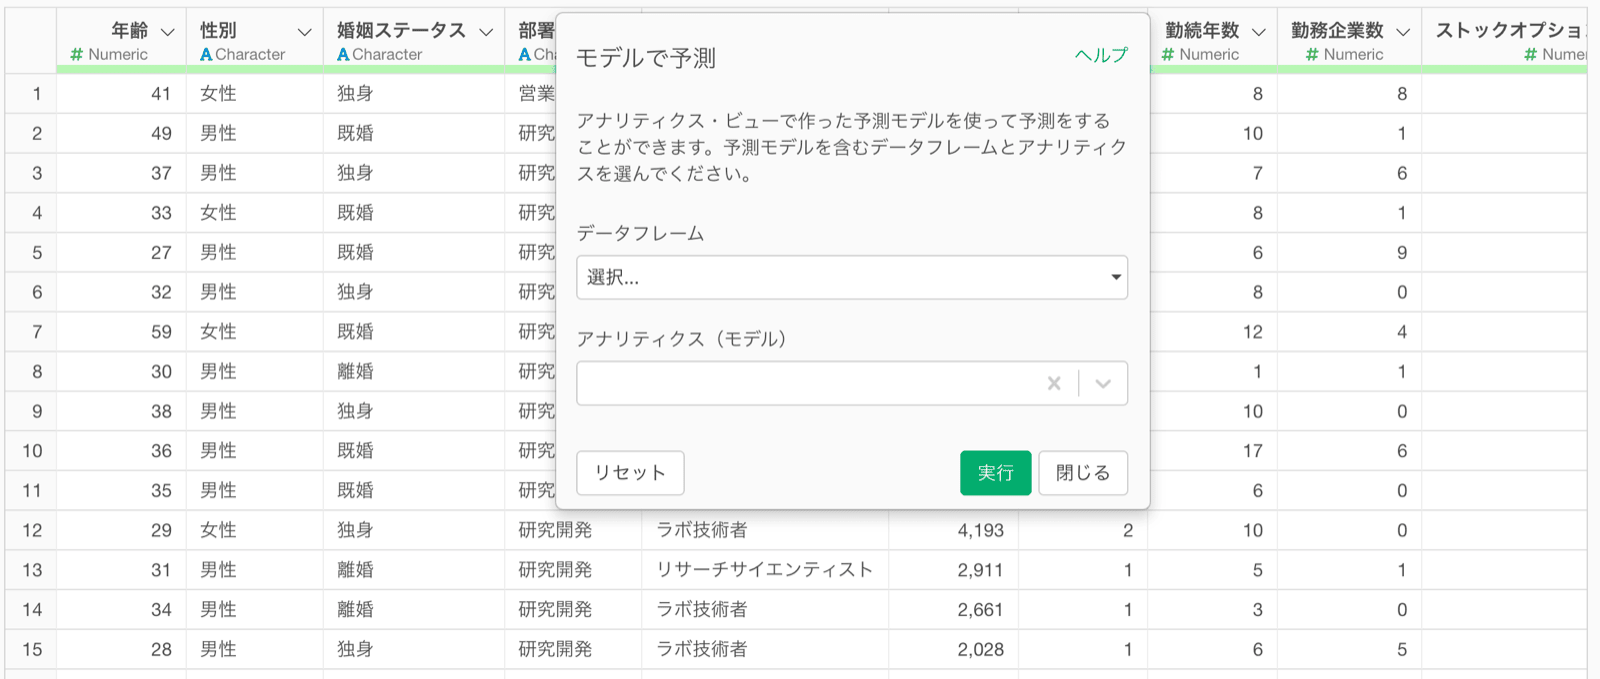
どの種類の値を予測する場合も、操作は共通です。予測したい新しいデータフレームを開き、ステップメニューから「モデルで予測(アナリティクス・ビュー)」を選びます。 予測のダイアログが表示されます。
数値・カテゴリを予測する

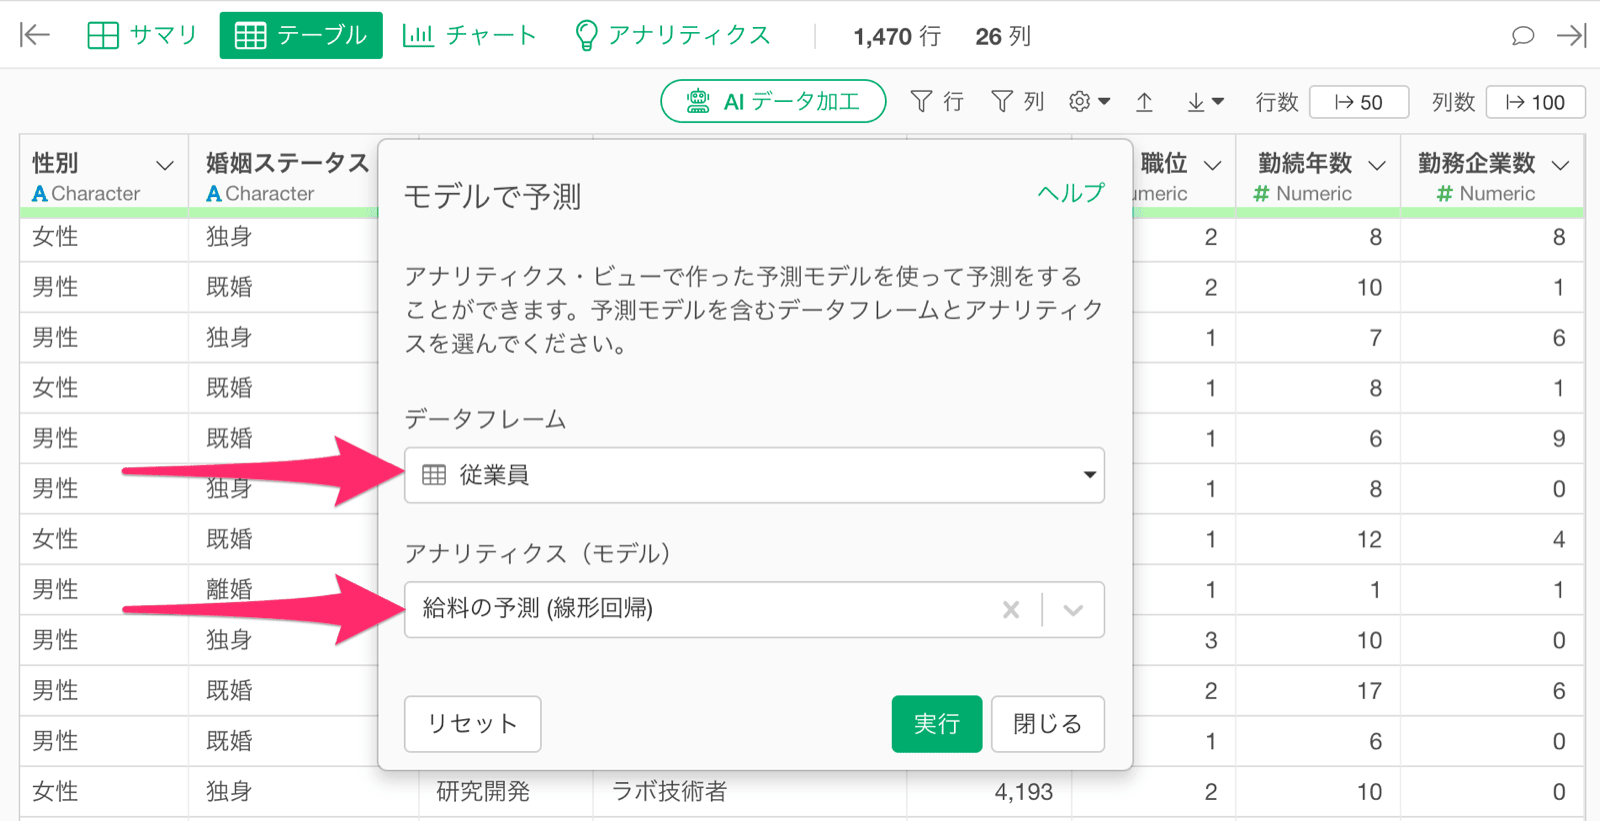
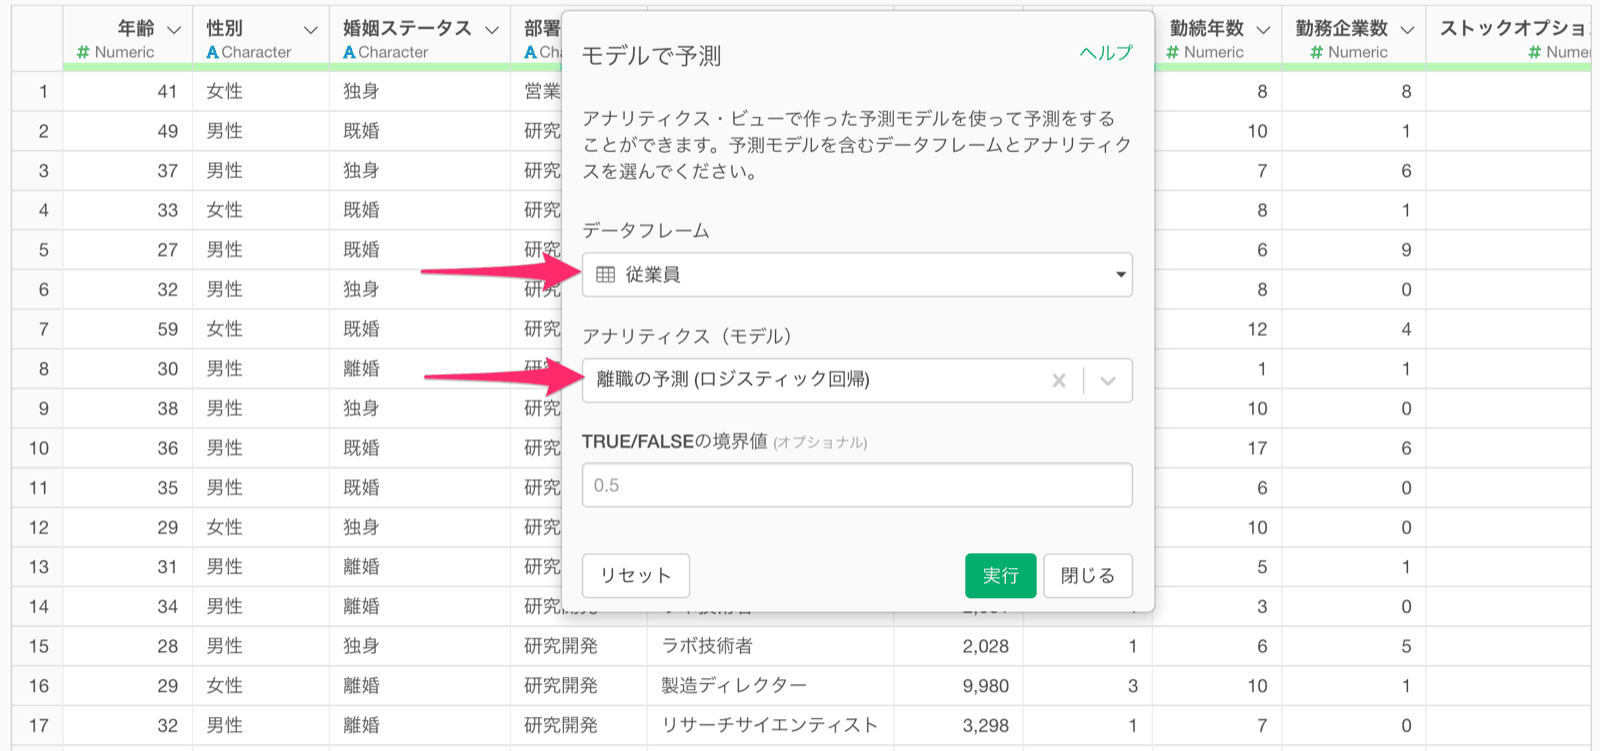
ダイアログで、予測モデルを作ったデータフレームと、アナリティクス名(アナリティクス・ビューで作ったモデルのタブ名)を選び、実行します。 予測する対象に応じた結果が返ります。
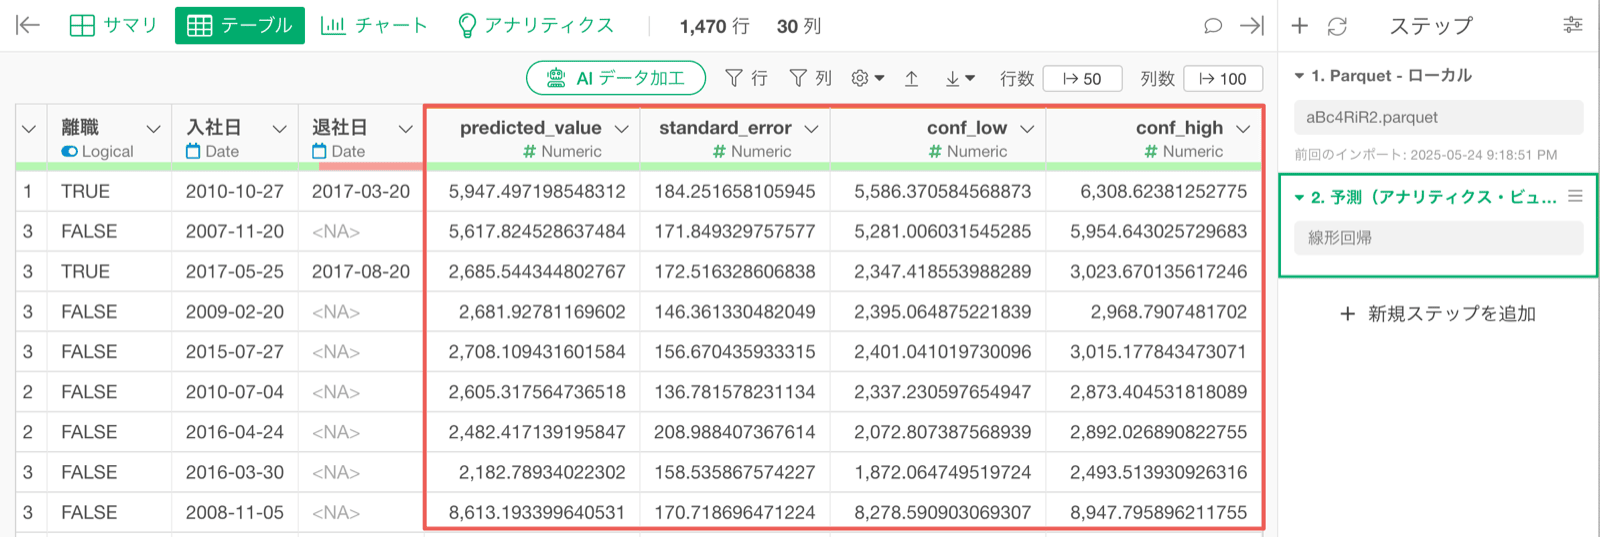
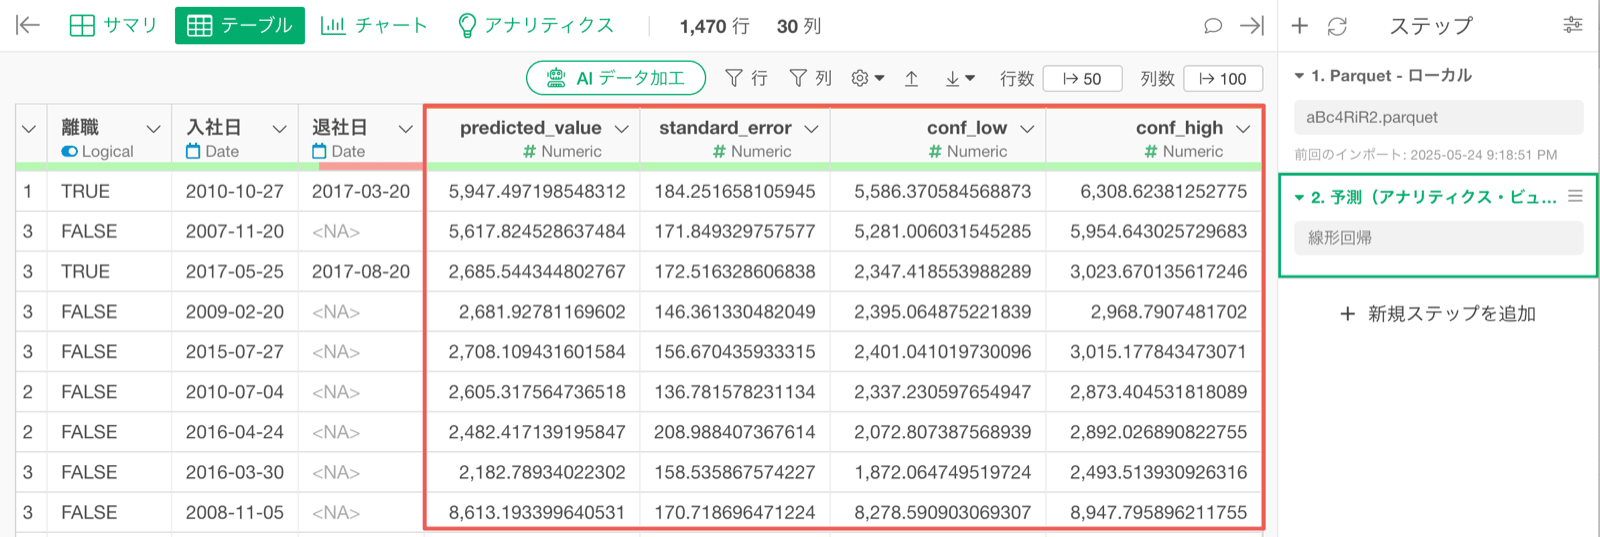
  • 数値型の場合は、数値型の予測値と関連する指標が、データフレームに追加されます。
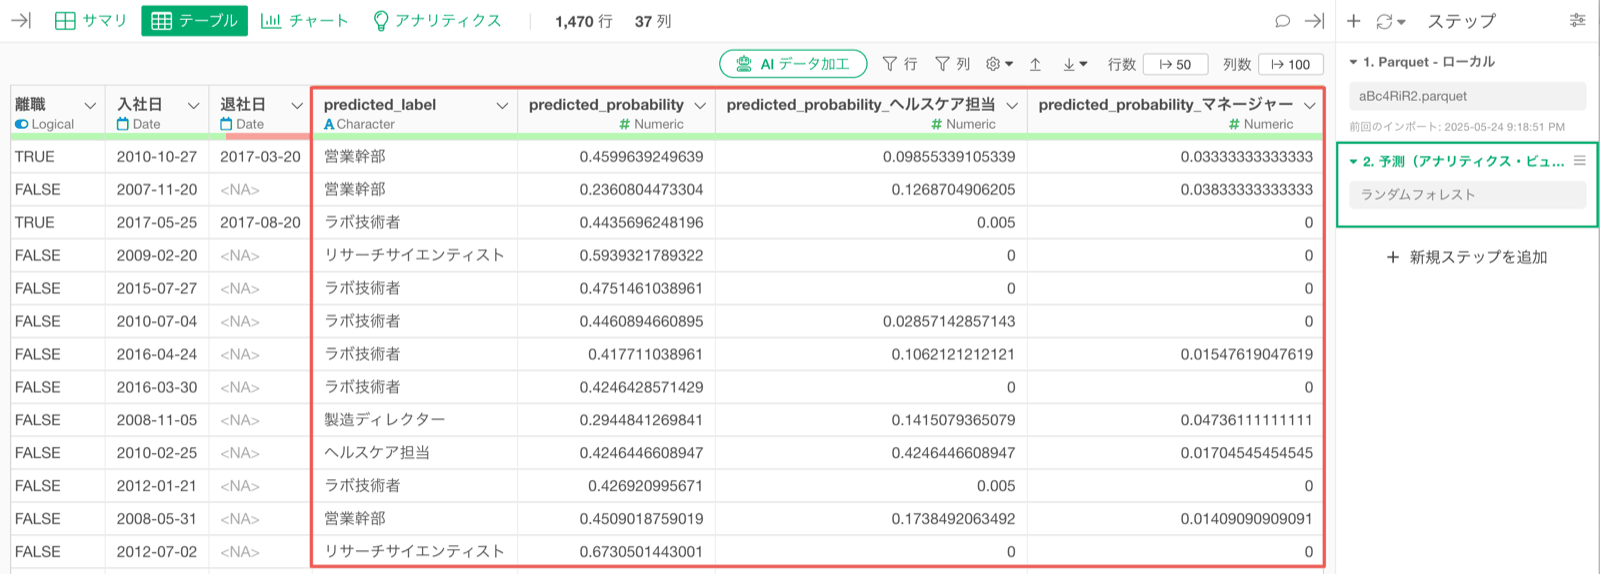
  • カテゴリ型の場合は、予測されたカテゴリ、そのカテゴリである予想確率、すべてのカテゴリの予測確率が、データフレームに追加されます。
論理値(TRUE/FALSE)を予測する

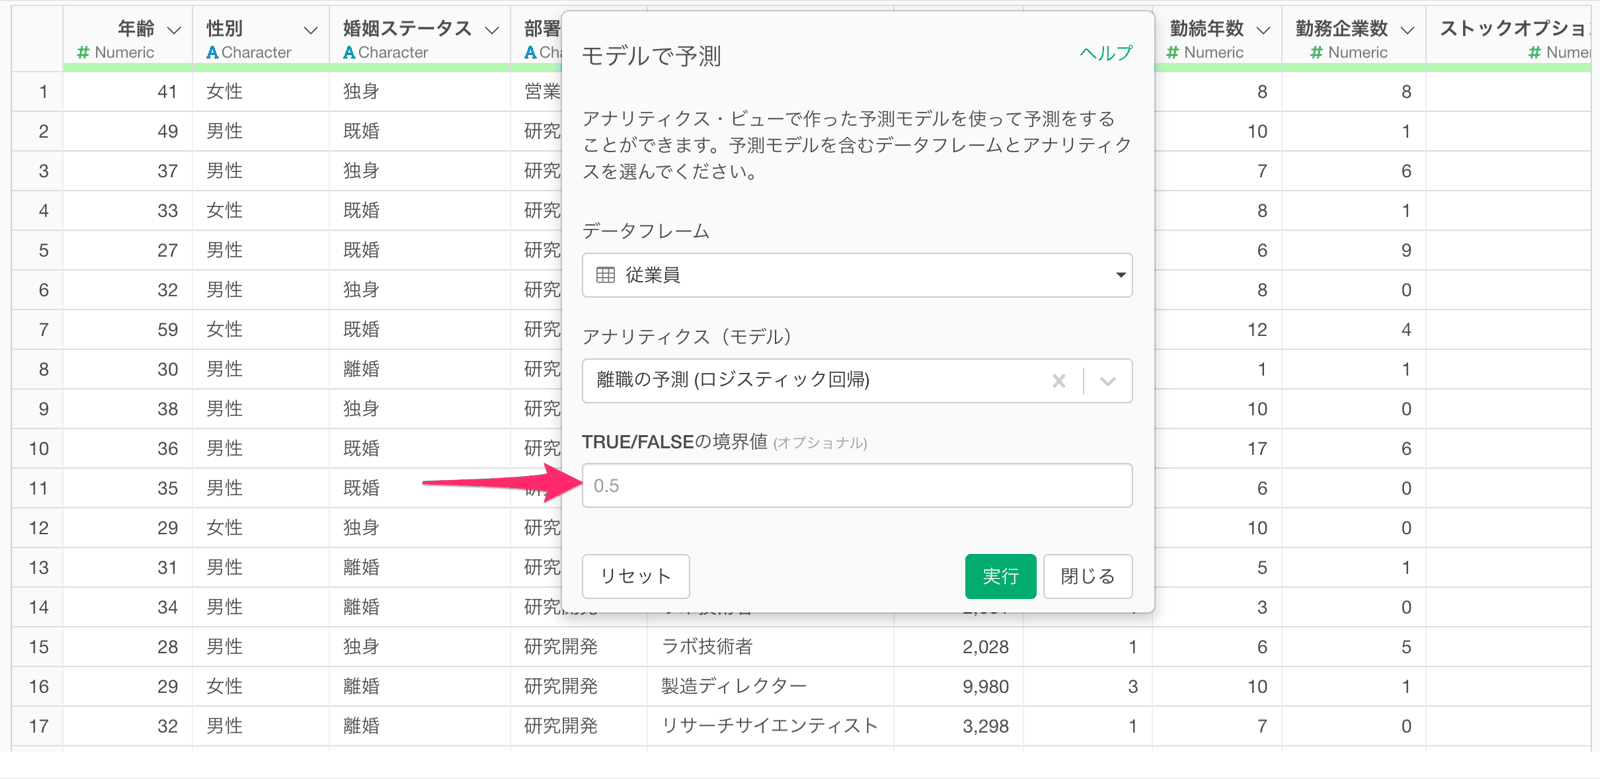
ダイアログで、予測モデルを作ったデータフレームと、アナリティクス名を選びます。 論理値を予測するモデルを選ぶと、「TRUE/FALSEの境界値」というオプションが表示されます。 論理値を予測するモデルは、論理値そのものではなく、TRUE になる確率を予測しています。そのため、TRUE と返すときの境界値(しきい値)を自分で設定できます。初期値は 0.5(50%)で、0 から 1 の間で自由に設定できます。
元のデータの全列に予測値を付ける

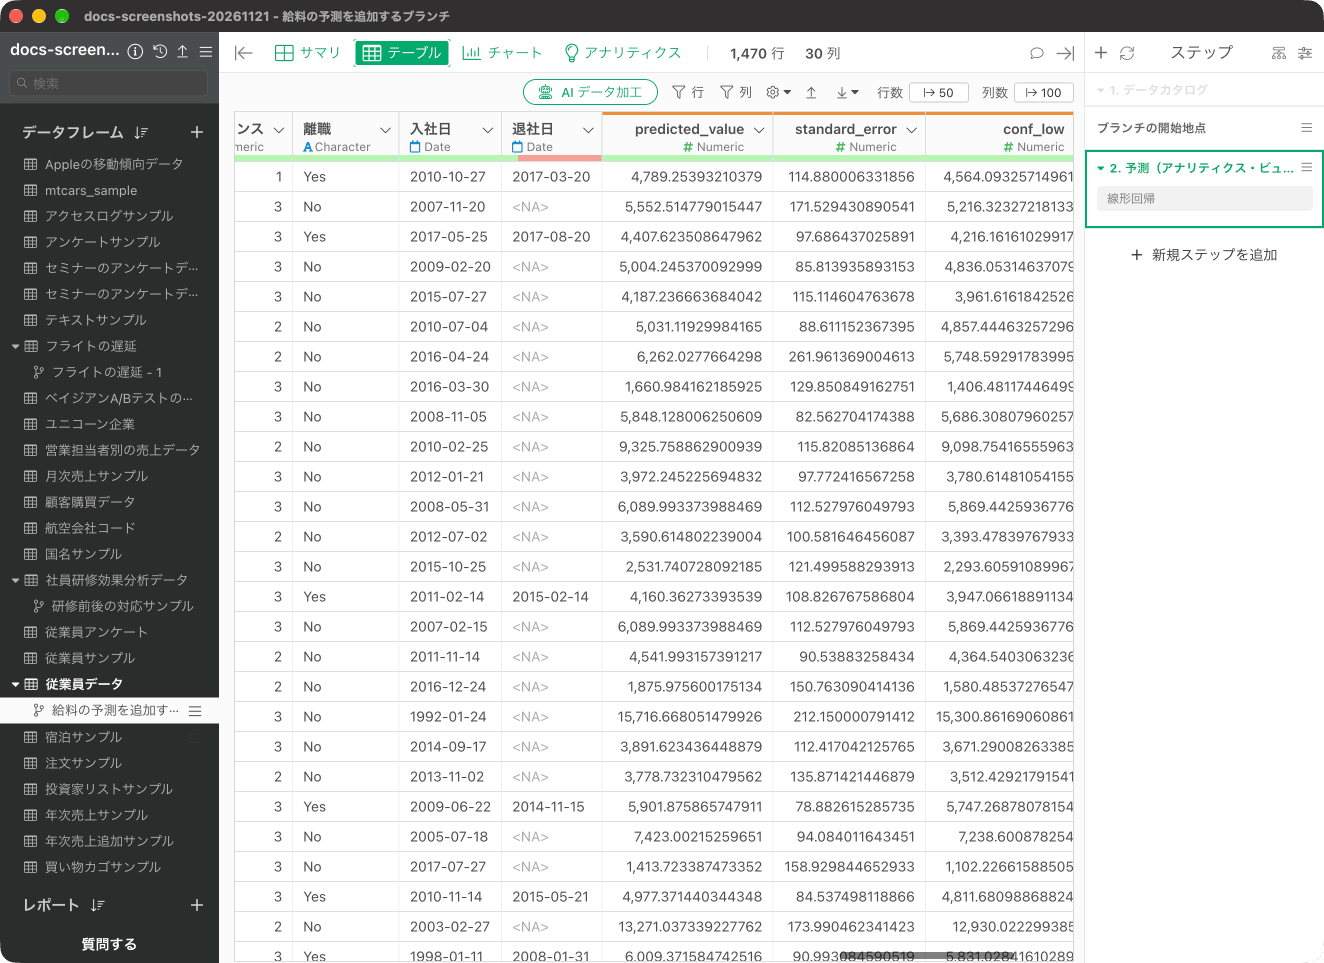
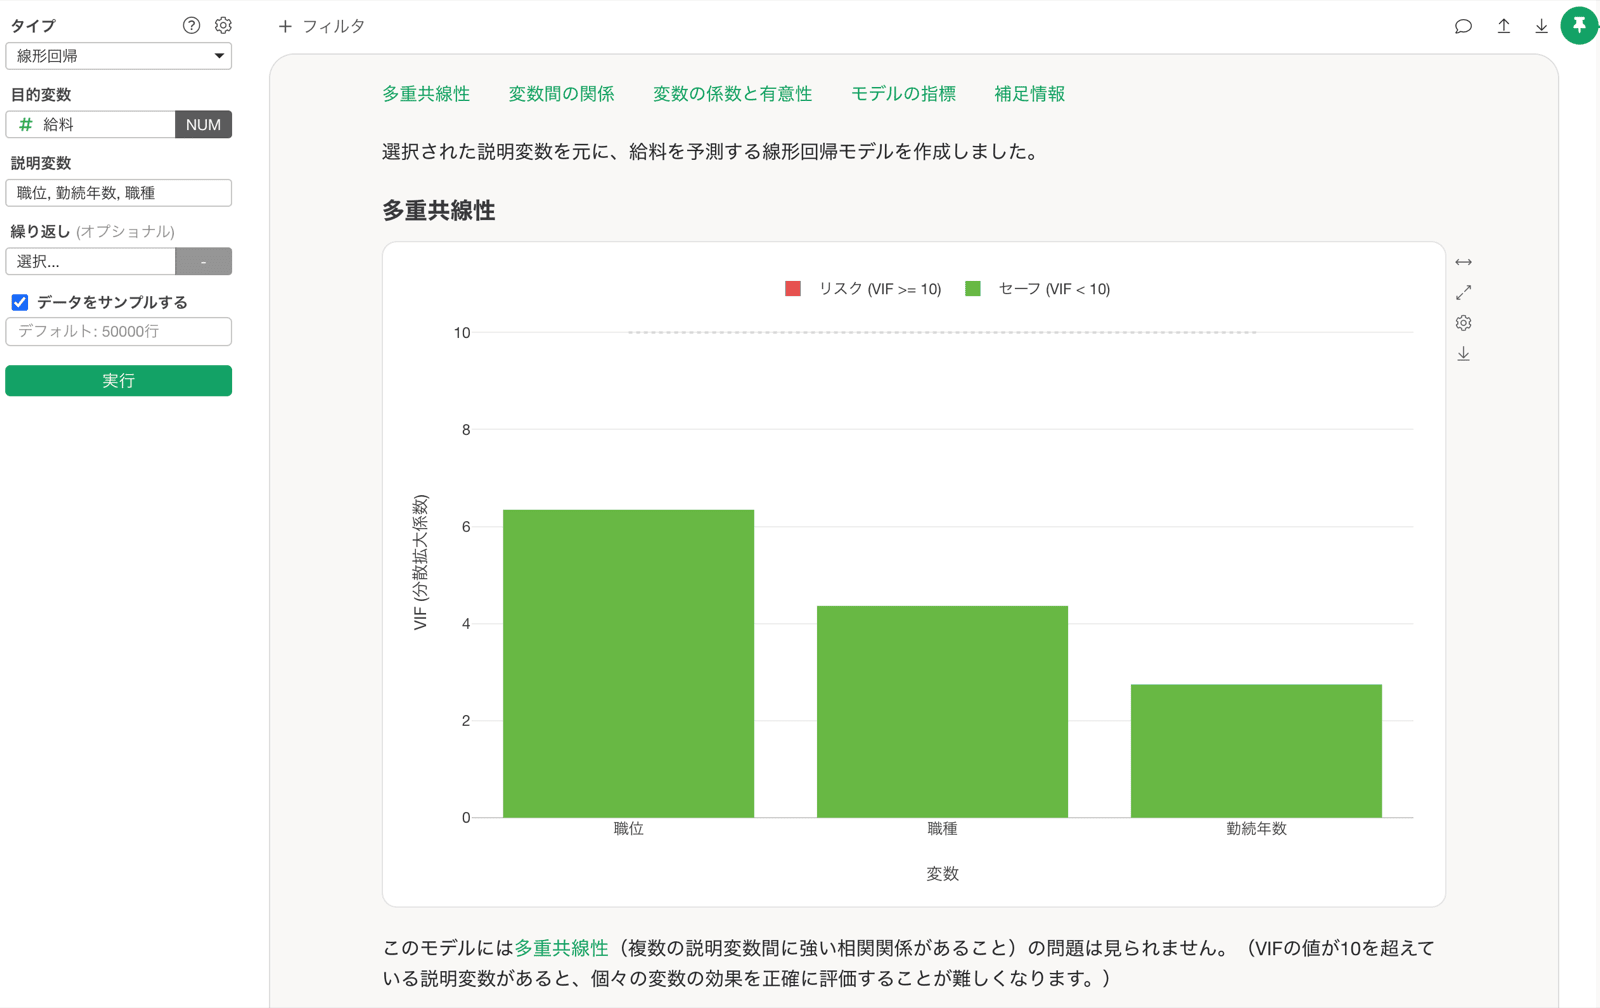
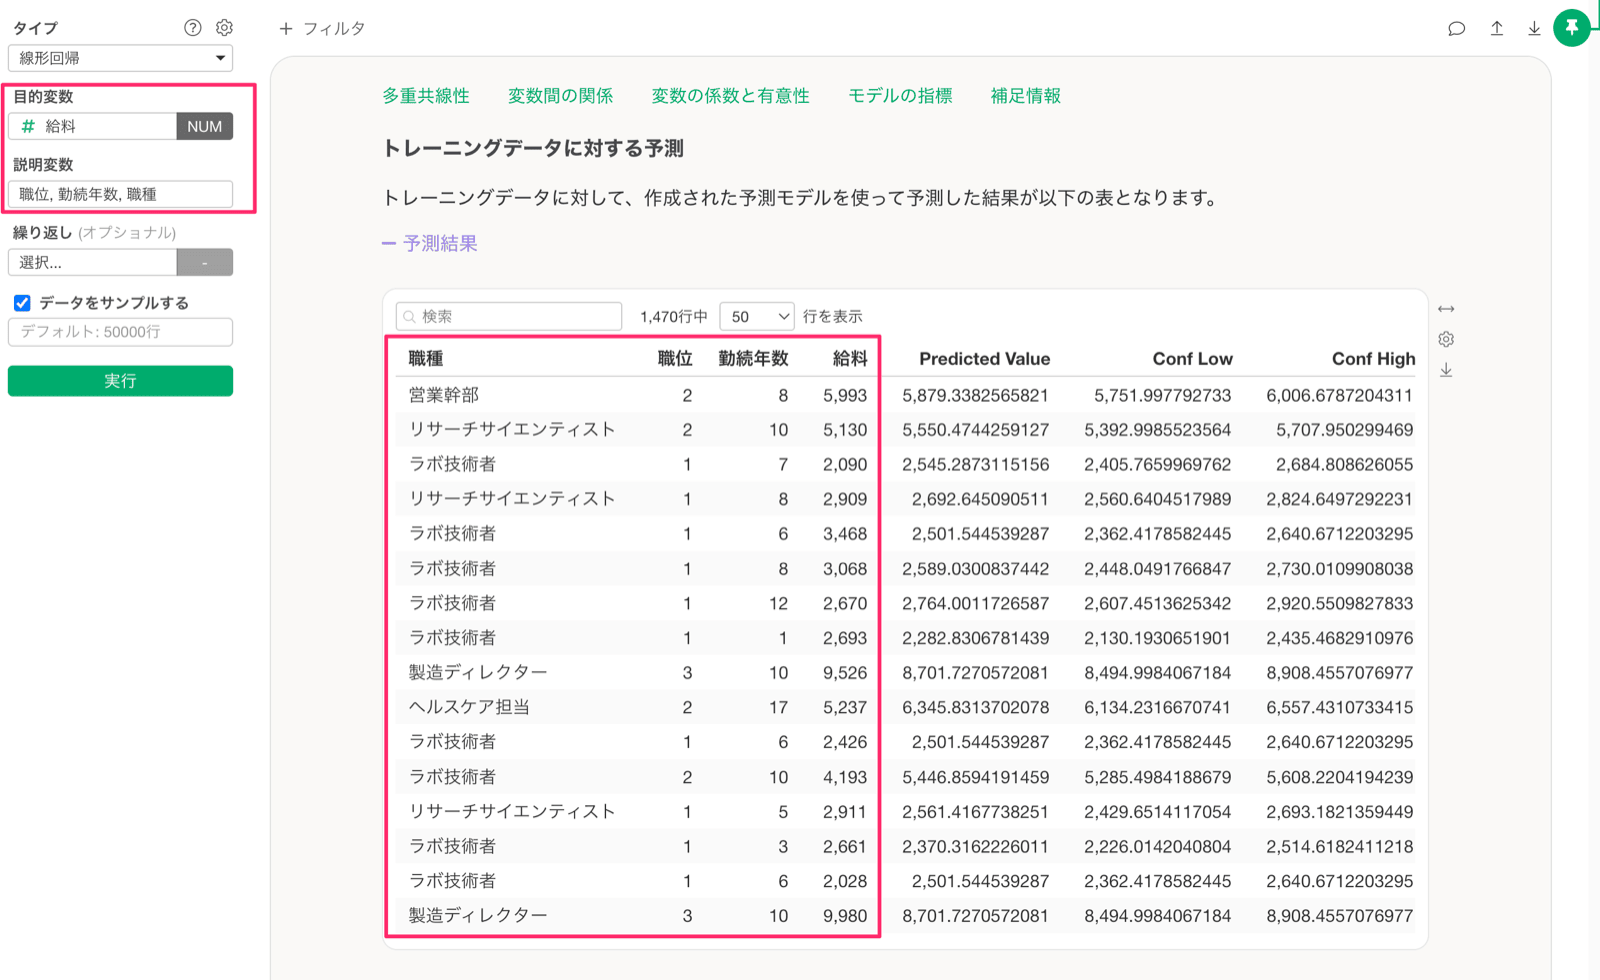
アナリティクス・ビューで作った予測モデルは、アナリティクス・ビューのチャートで確認できます。 アナリティクス・ビューの「トレーニングデータに対する予測」の表には、モデルに使った列と予測結果が表示されます。モデルに使わなかった元の列も残すには、元のデータのブランチに予測ステップを追加します。 元のデータの全列を残したまま、各行に予測値を付けるには、次の手順にします。元のデータフレームのブランチを作って、別のデータフレームを用意します。そのデータフレームのステップから、アナリティクス・ビューで作ったモデルを指定して予測します。 この例(従業員データの線形回帰)では、ブランチの予測ステップを実行すると、元の 26 列に 4 列が加わって 30 列になります。テーブルビューの右側に predicted_value、standard_error、conf_low などの予測の列が並び、元の列はそのまま残ります。
新しいデータに対する予測精度を評価する

新しいデータに対する予測結果について、答え(実測値)の列がある場合は、予測精度を評価できます。

数値の場合

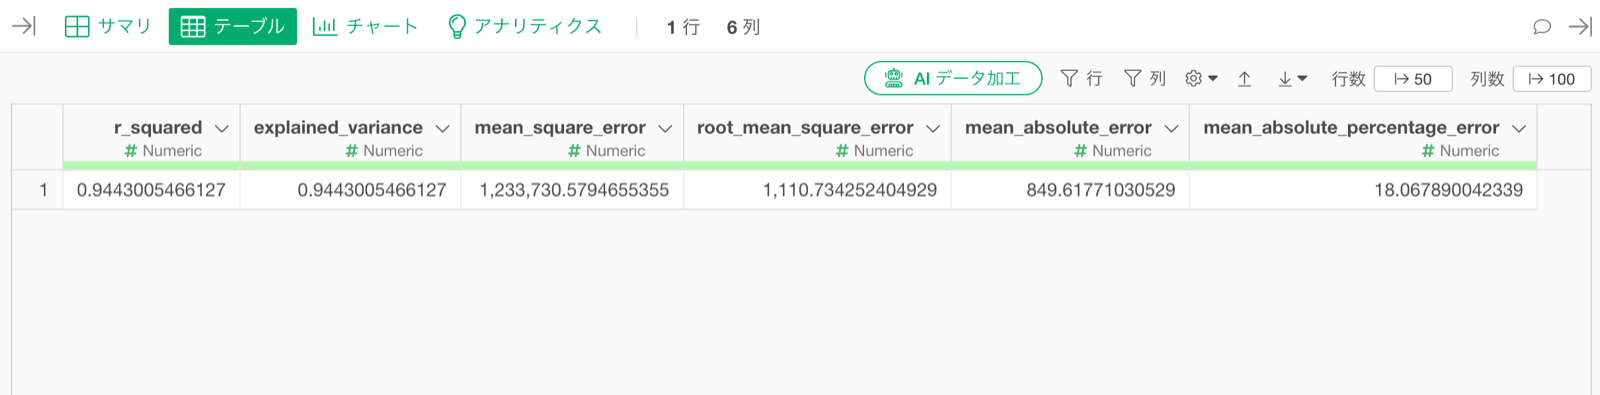
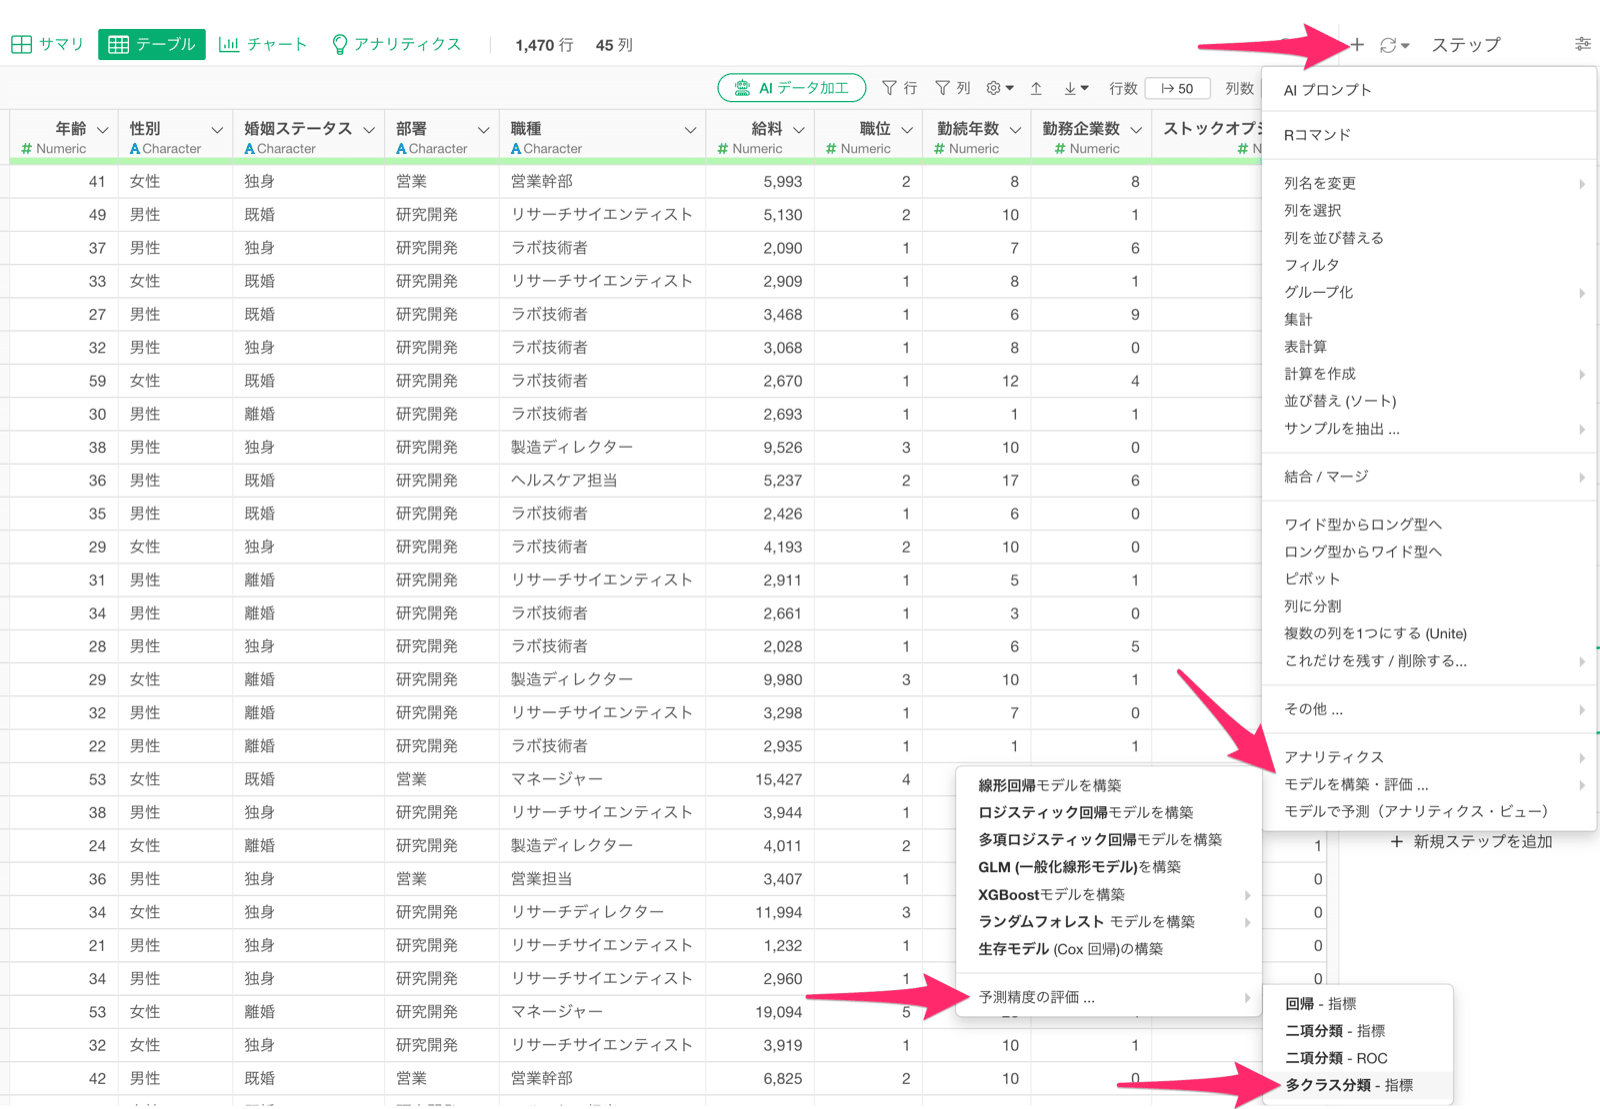
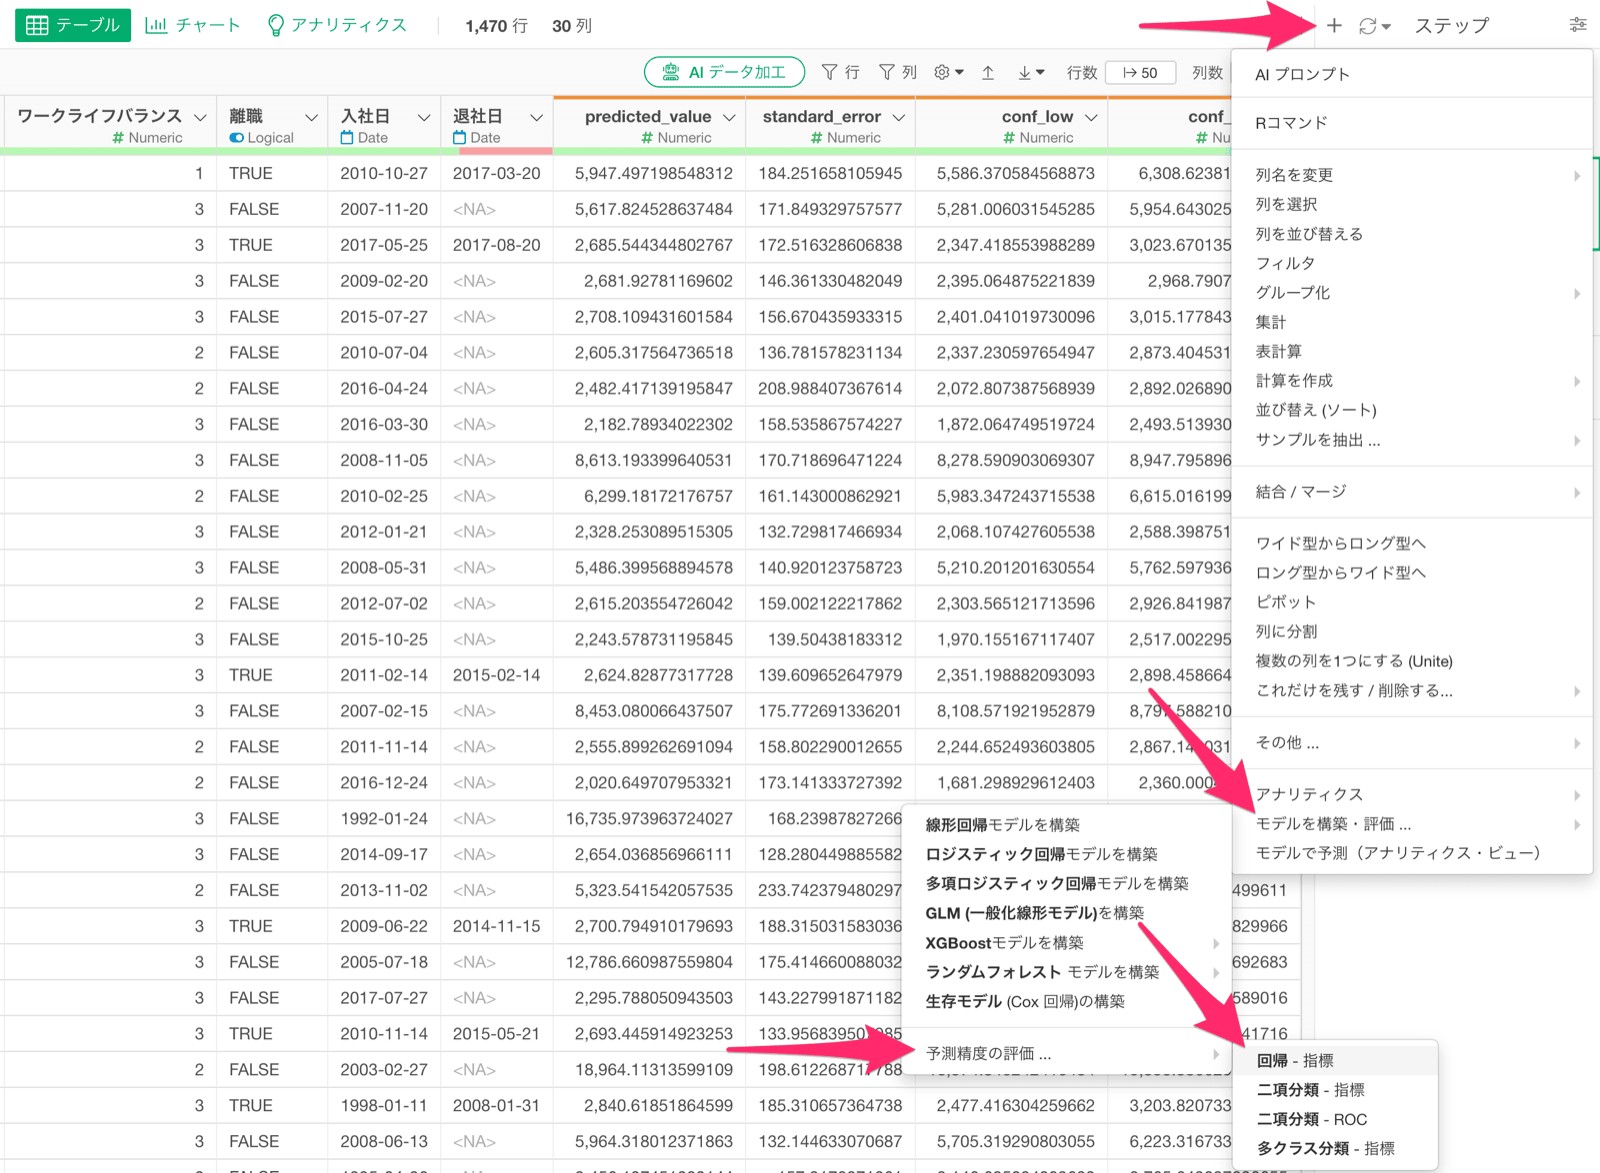
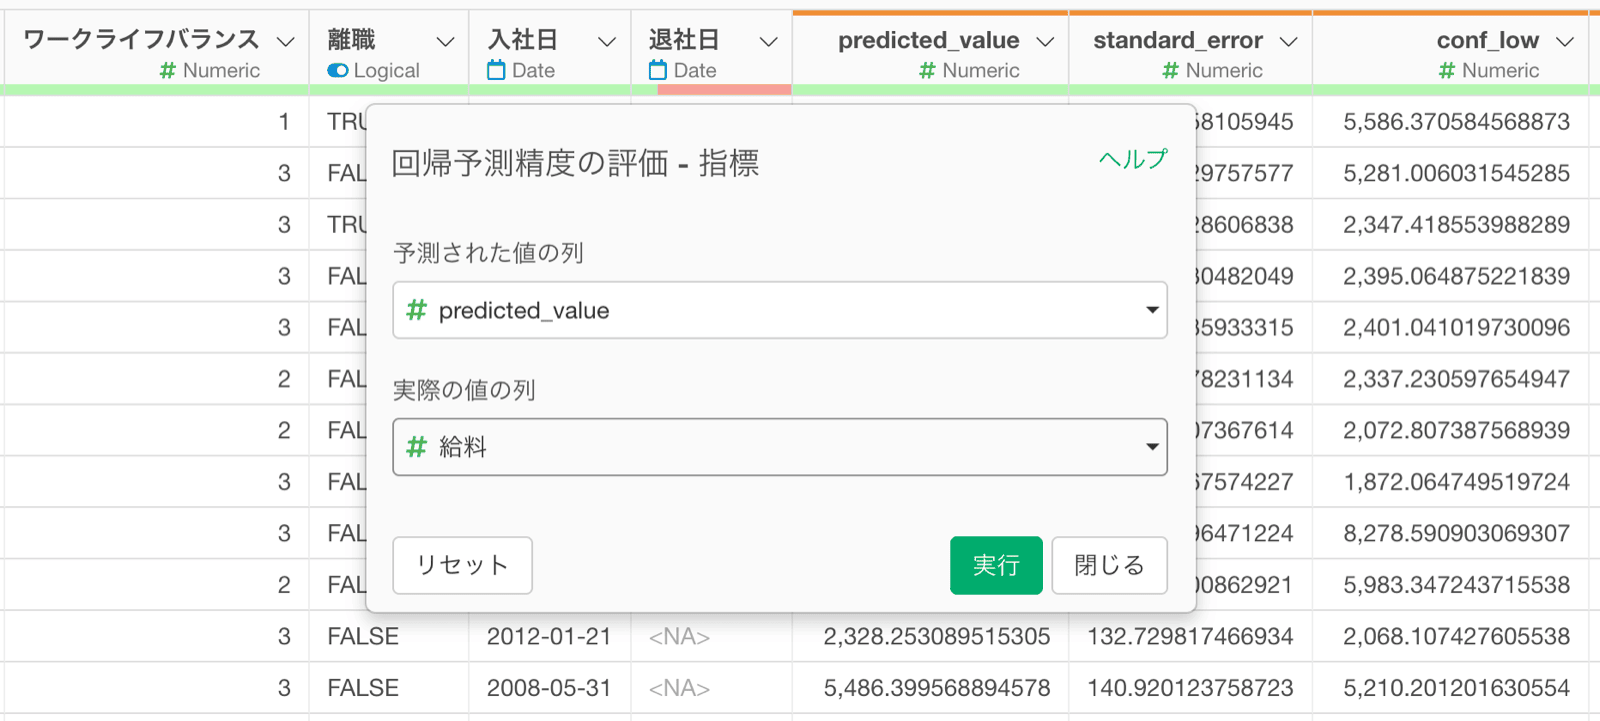
ステップメニューから「モデルを構築・評価」、「予測精度の評価」、「回帰 - 指標」を選びます。 ダイアログの「予測された値の列」に predicted_value を、「実際の値の列」に実際の数値の列(この例では「給料」)を選び、実行します。 数値の予測精度を評価する指標が計算されます。
論理値の場合

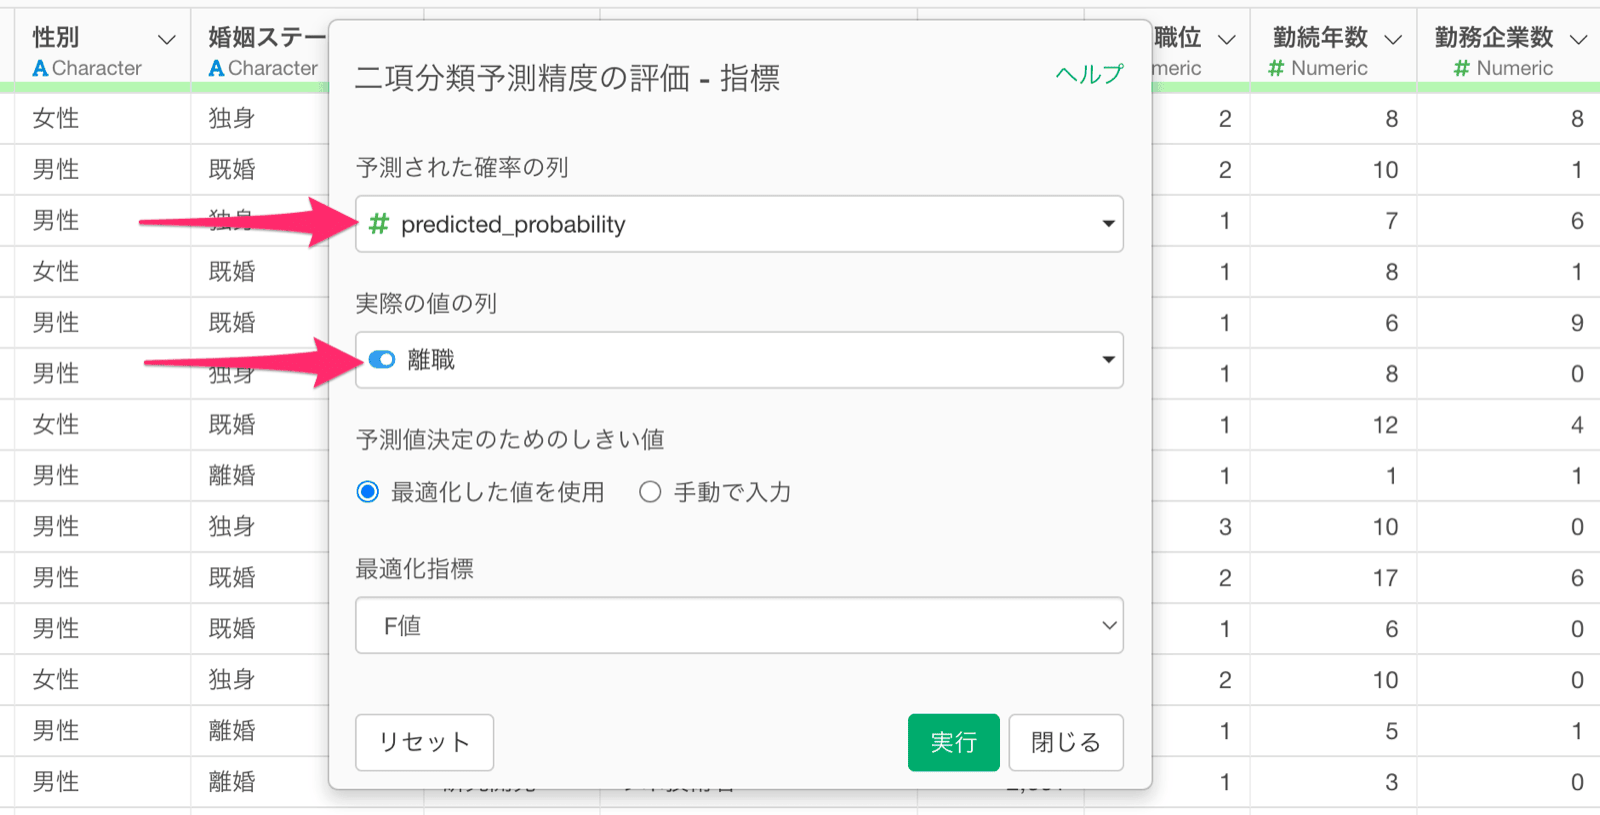
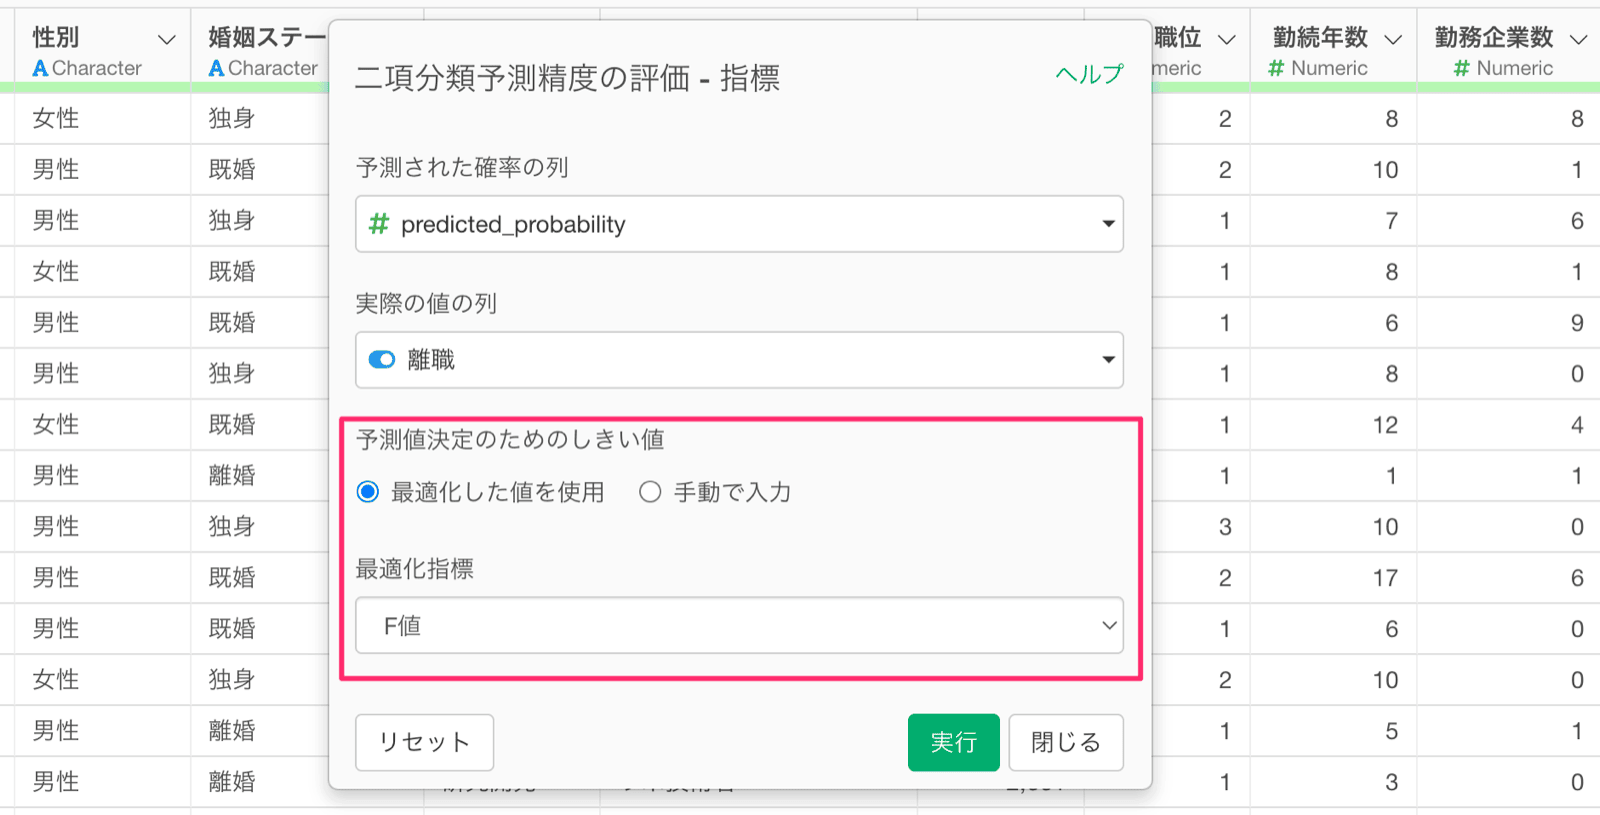
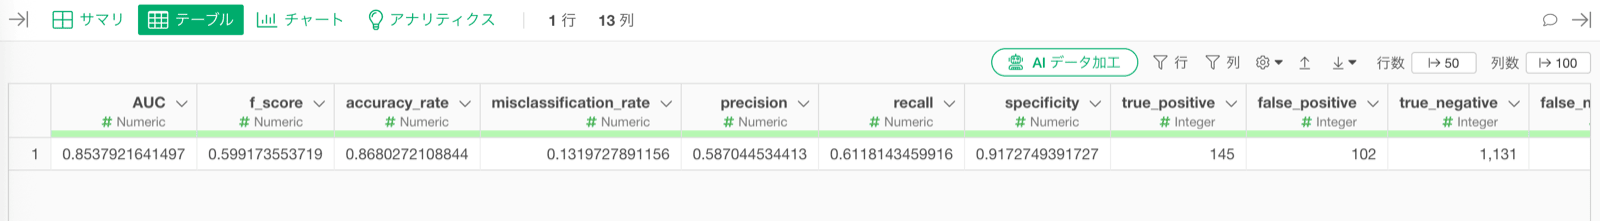
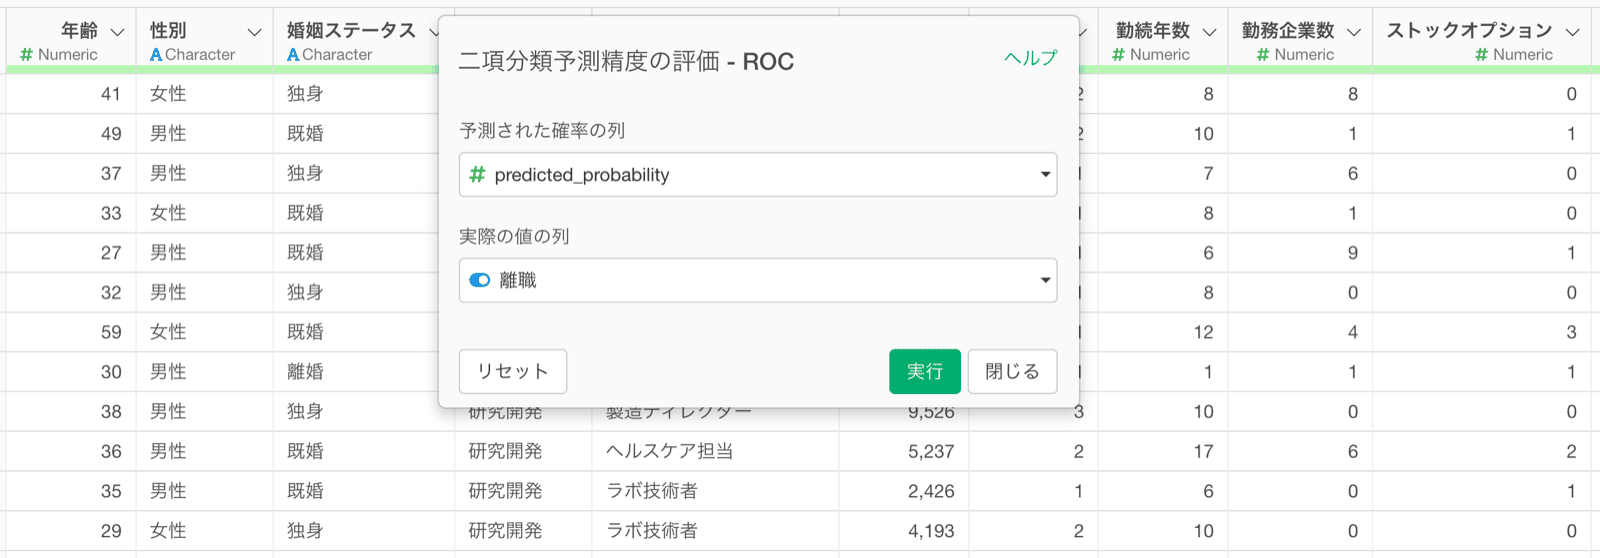
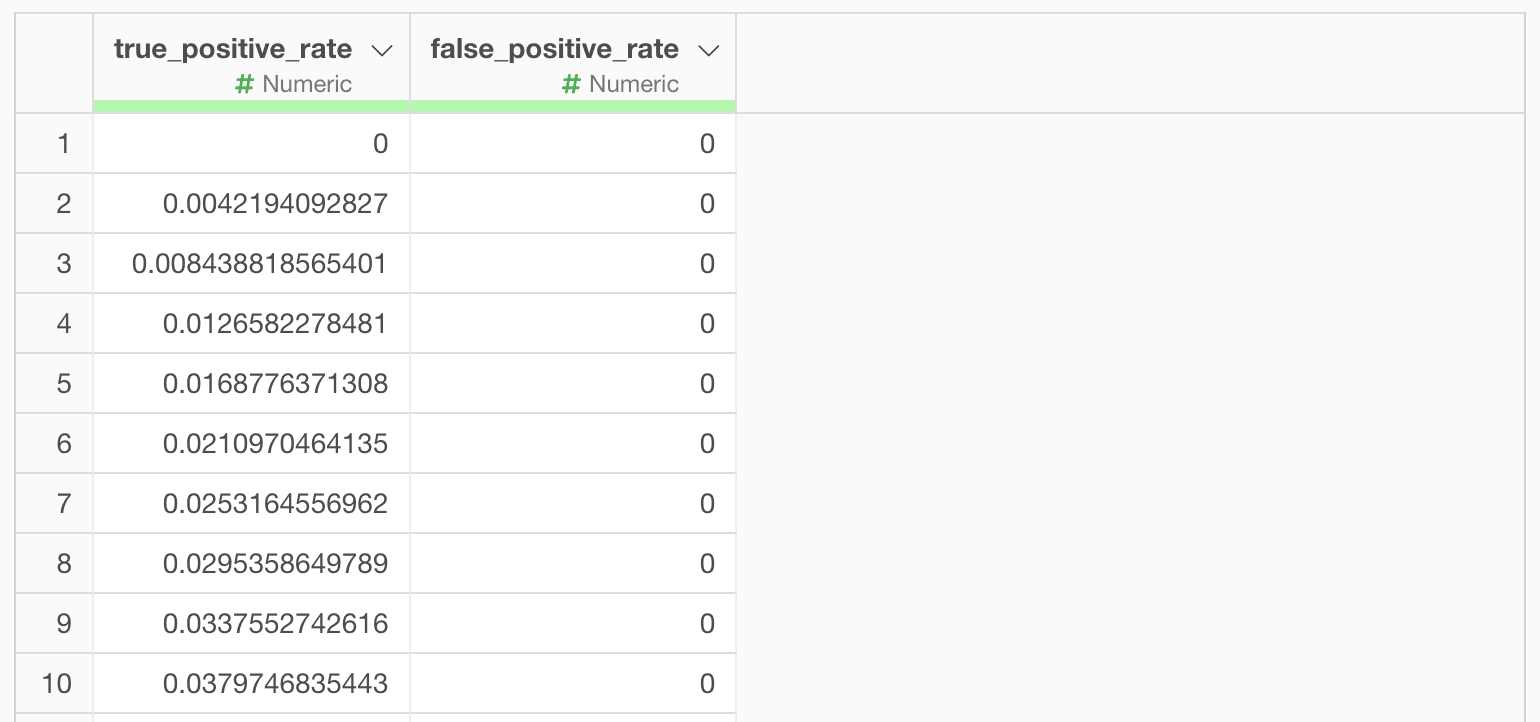
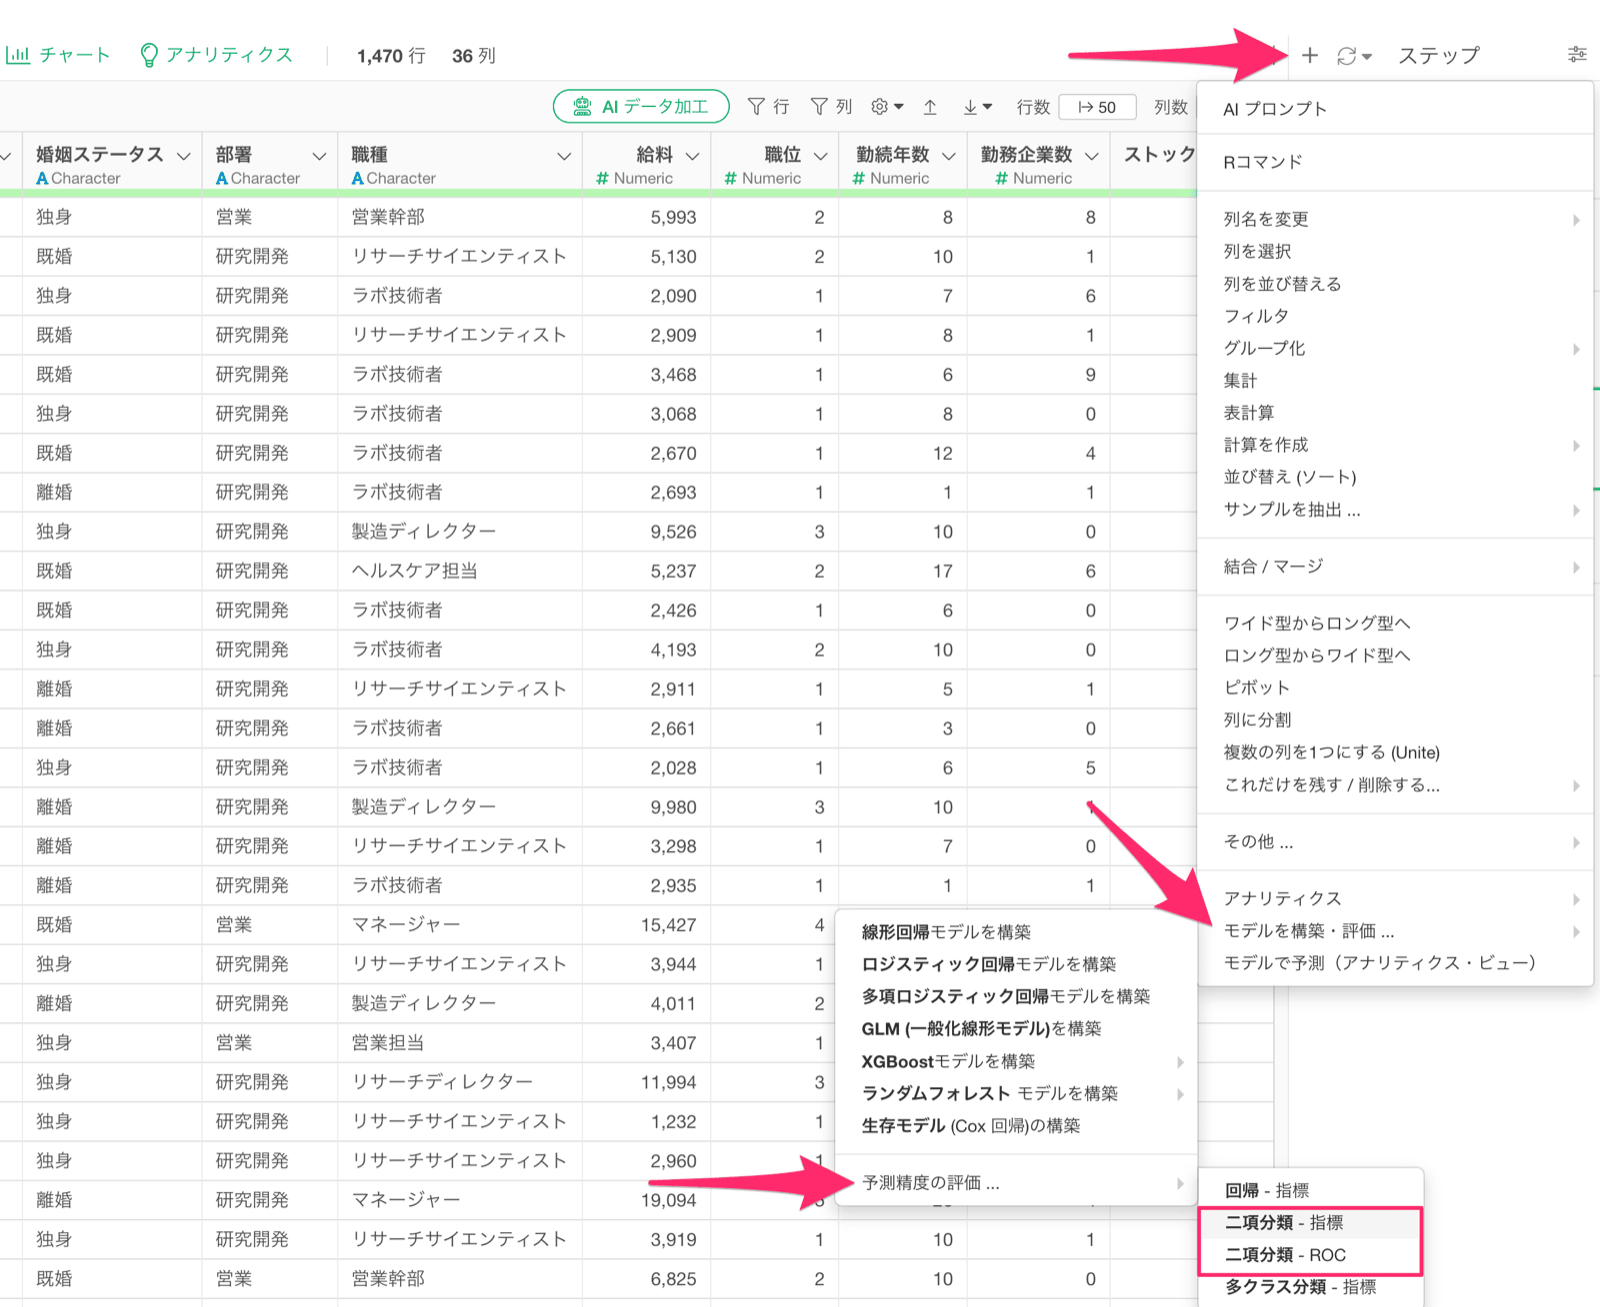
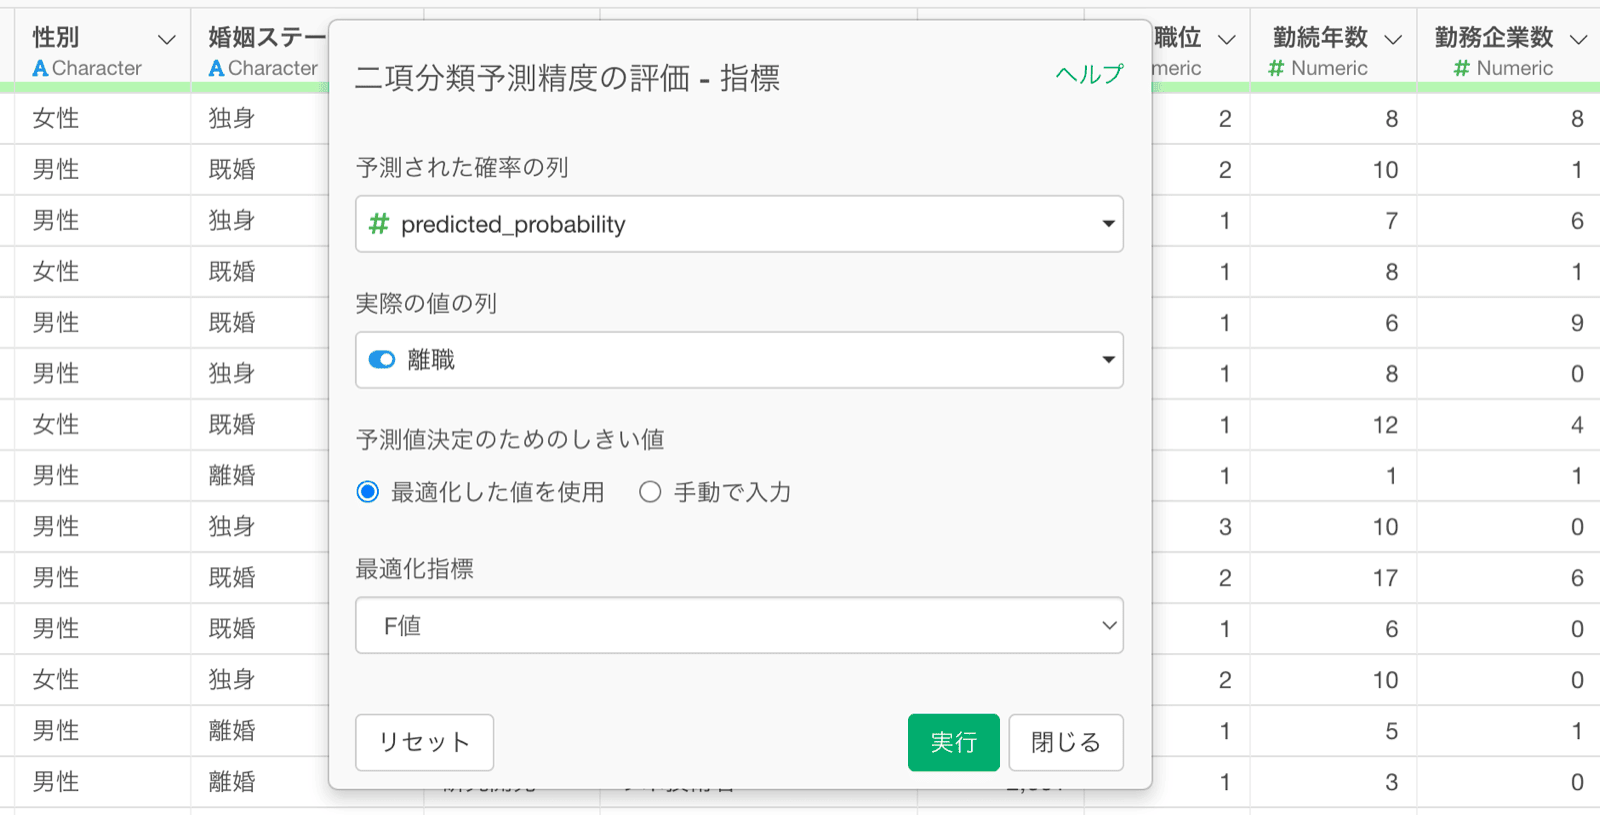
ステップメニューから「モデルを構築・評価」、「予測精度の評価」を選び、「二項分類 - 指標」または「二項分類 - ROC」を選びます。 二項分類 - 指標 次のダイアログが表示されます。 「予測された確率の列」に predicted_probability を、実際の値の列に実際の論理値の列を選びます。 二項分類のモデルは、評価指標が TRUE/FALSE を決める境界値(しきい値)によって変わるため、境界値を手動で入力するか、最適化する指標を選べます。 設定して実行すると、論理値の予測精度を評価する指標が計算されます。 二項分類 - ROC 次のダイアログが表示されます。「予測された確率の列」に predicted_probability を、実際の値の列に実際の論理値の列を選びます。 論理値を予測するモデルの精度を評価する、ROC 曲線が計算されます。
カテゴリの場合

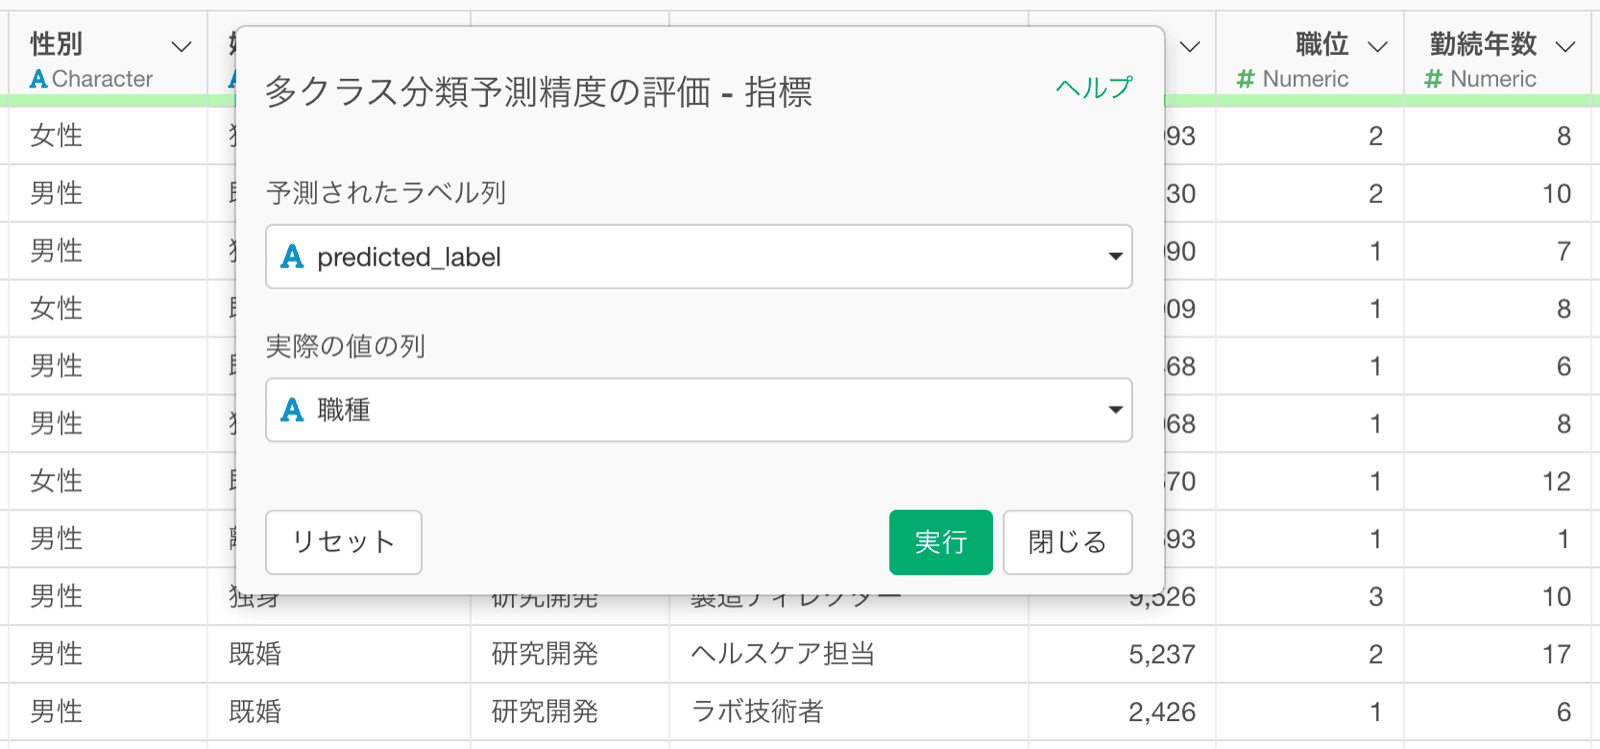
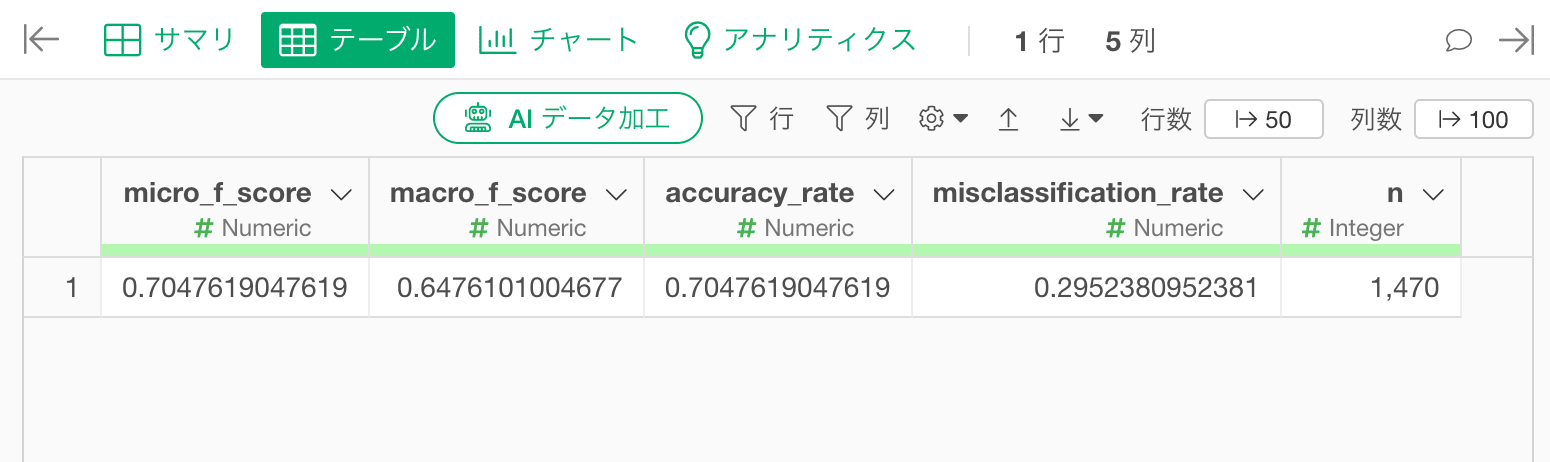
ステップメニューから「モデルを構築・評価」、「予測精度の評価」、「多クラス分類 - 指標」を選びます。 ダイアログの「予測されたラベル列」に predicted_label を、実際の値の列に実際のカテゴリの列を選び、実行します。 カテゴリの予測精度を評価する指標が計算されます。