1. 使用するデータコネクションを作成する
この手順に従って、接続を作成します。2. Redshift インポートダイアログを開く
データフレームの横にある「+」ボタンをクリックし、「Database Data」を選択します。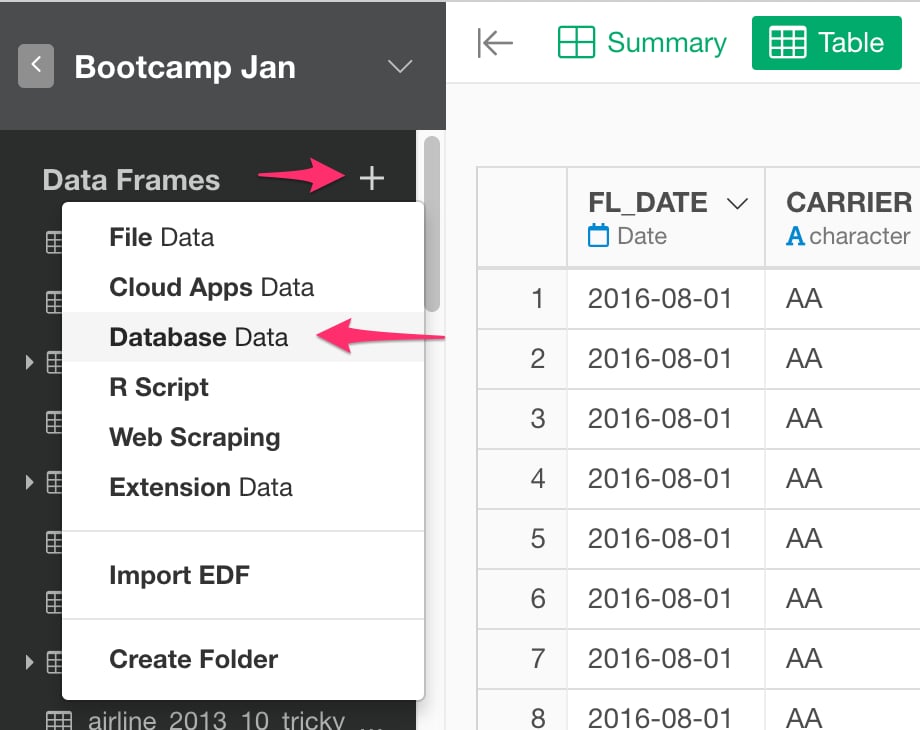
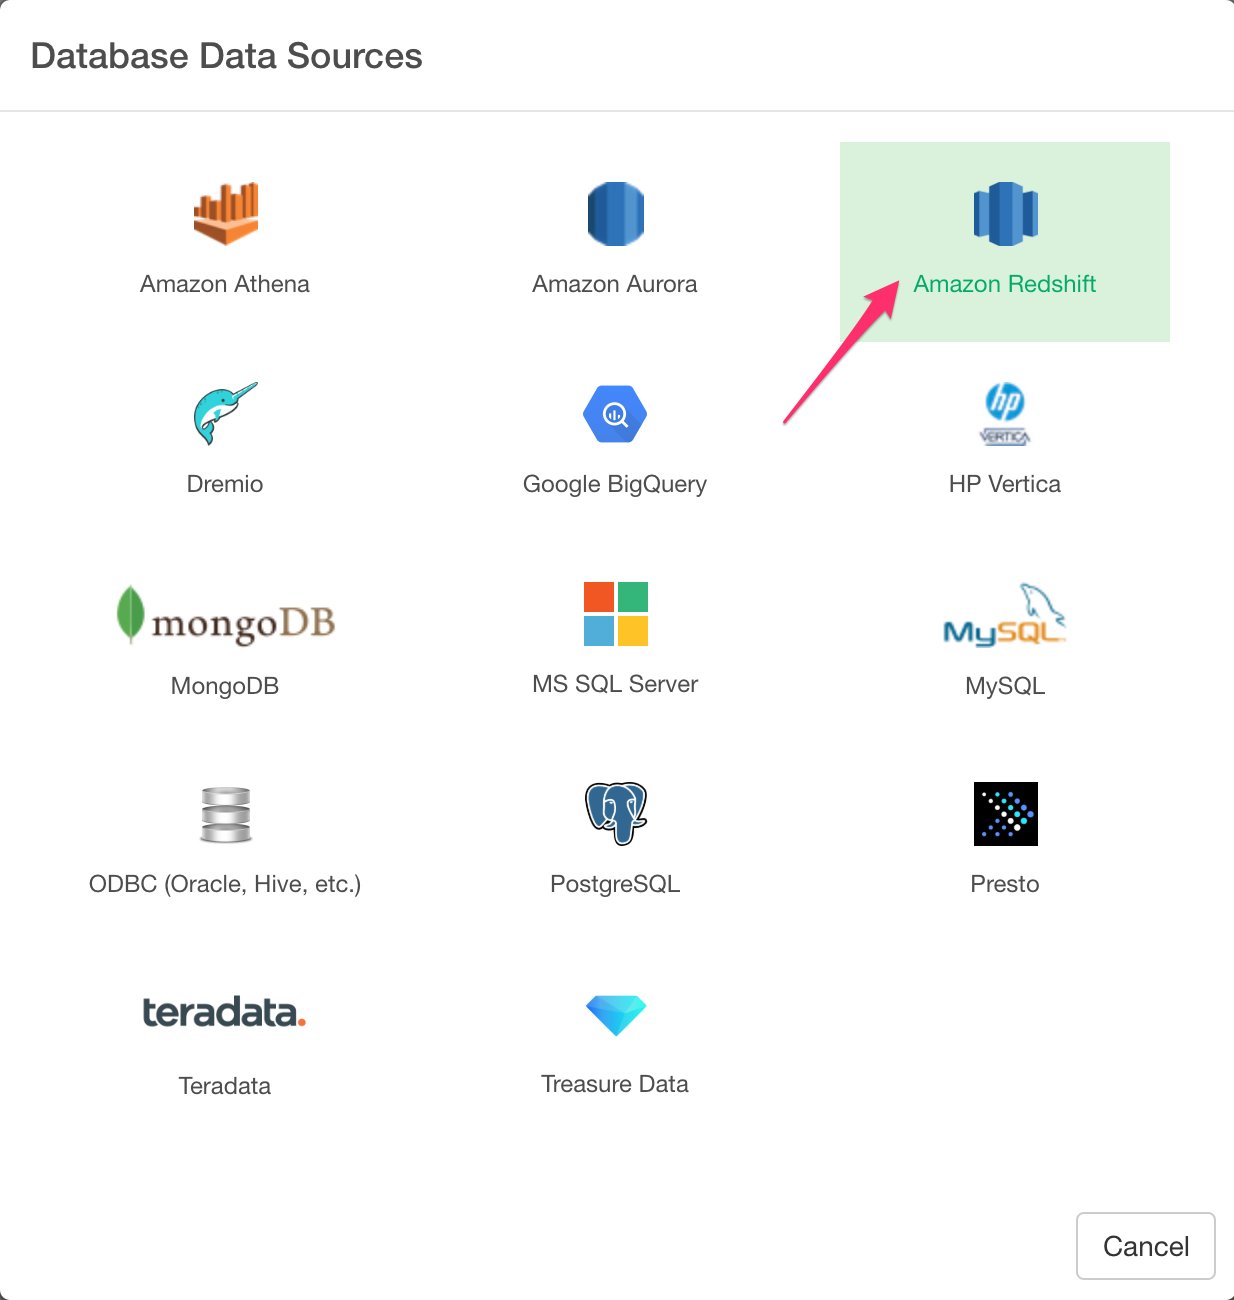
3. プレビューとインポート
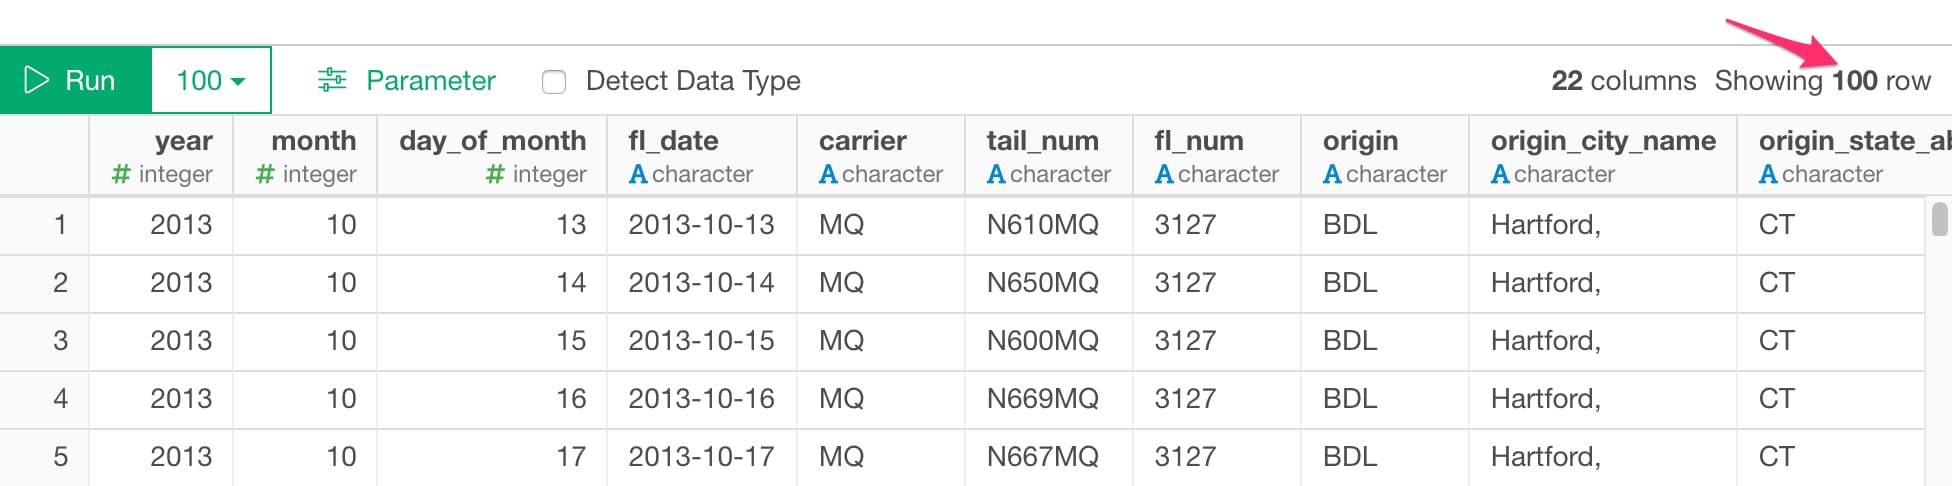
実行ボタンをクリックすると、Redshift データベースから取得してきたデータを確認することができます。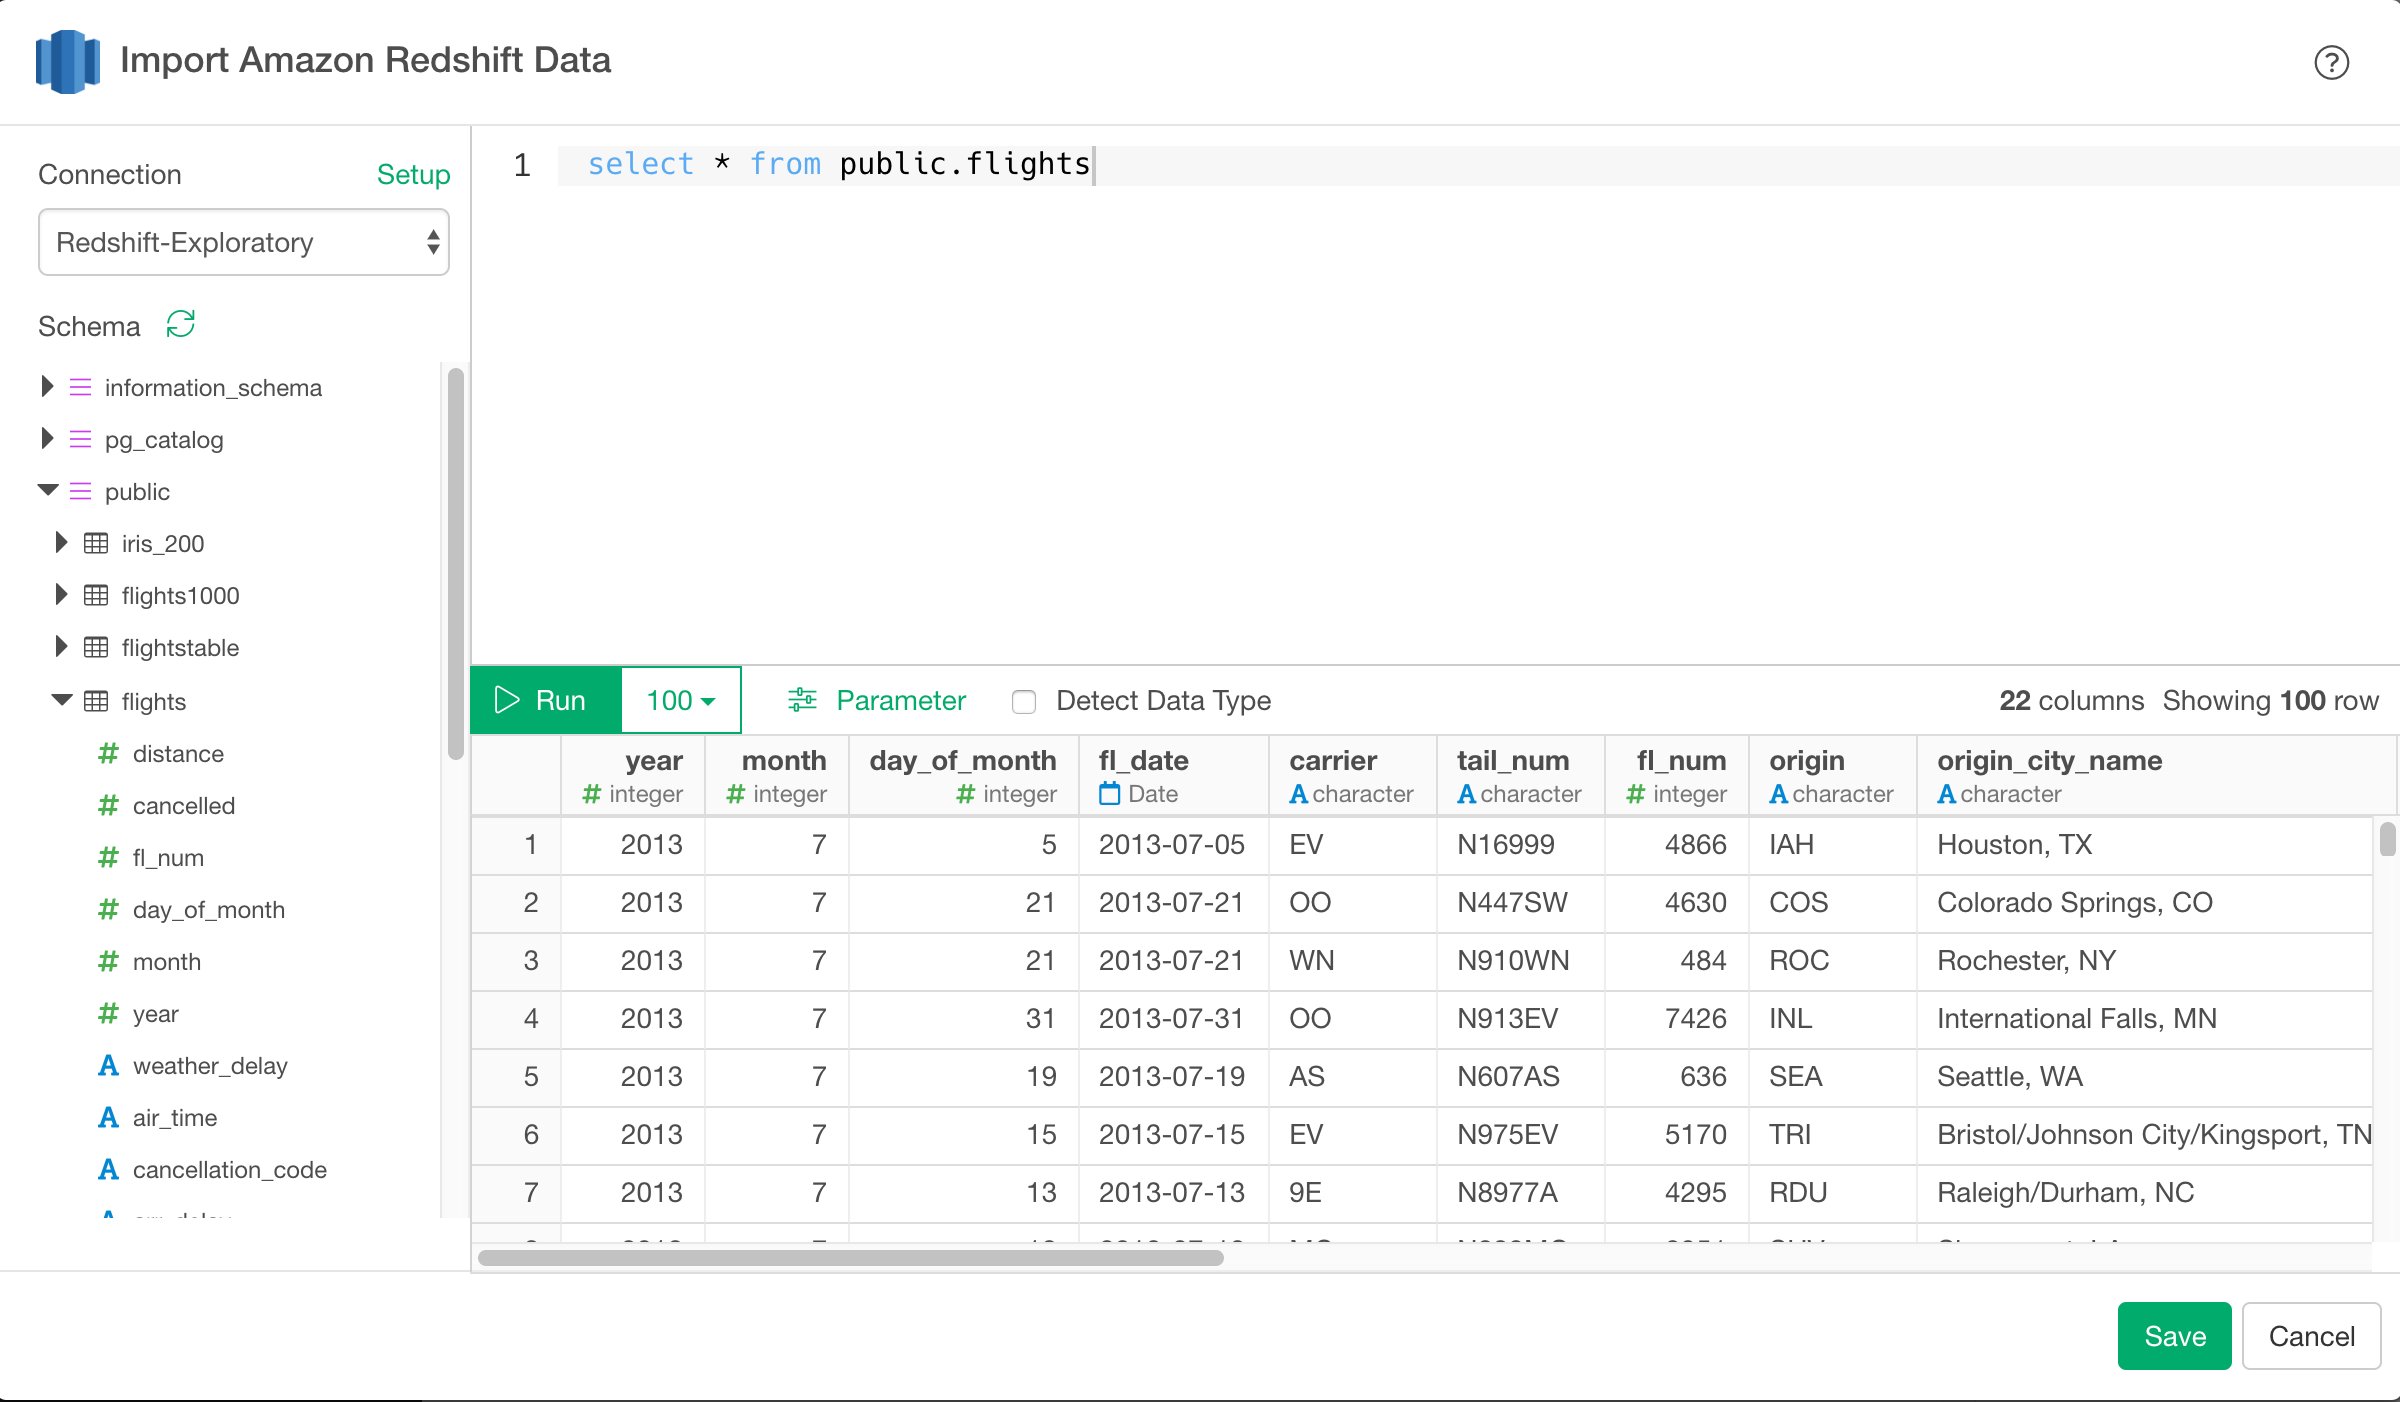
4. ランダムサンプルデータのクエリ
分析に適したサイズのデータからランダムにサンプルを取りたい場合があります。 md5関数を使って乱数を生成し、以下のように使用することでデータのランダムサンプルを得ることができます。5. SQLでパラメータを使用する
まず、SQL データインポートダイアログのパラメータリンクをクリックします。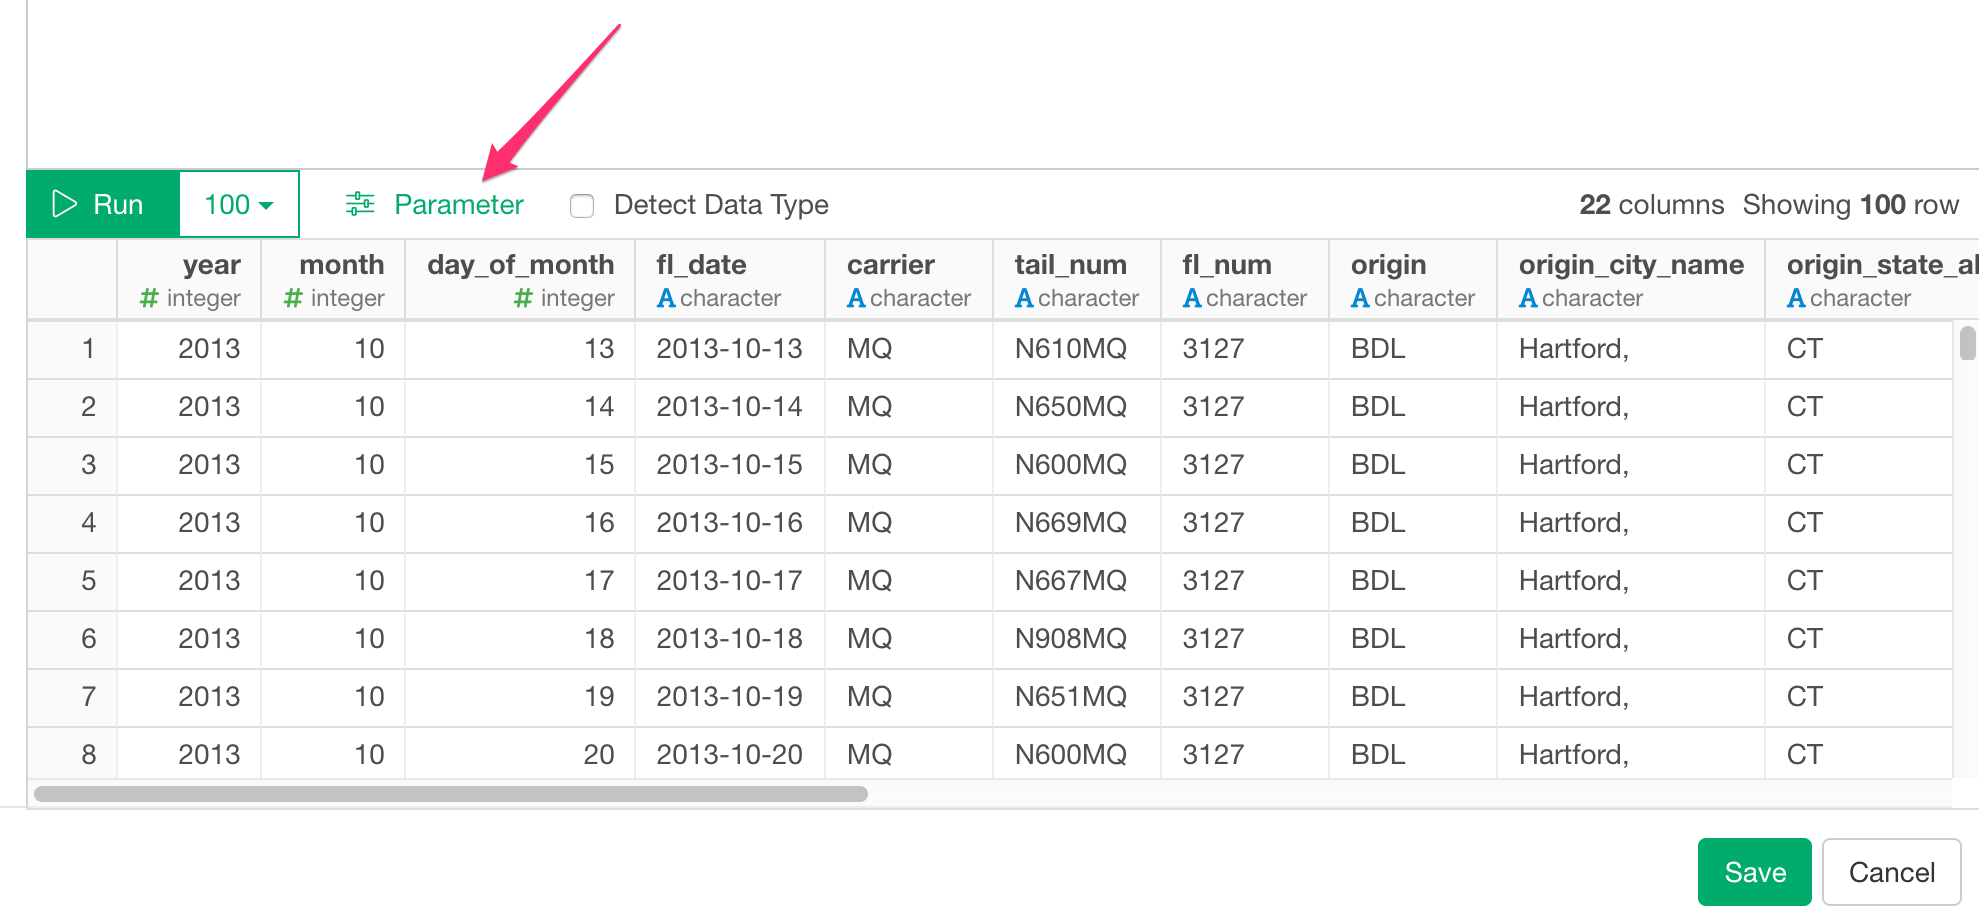
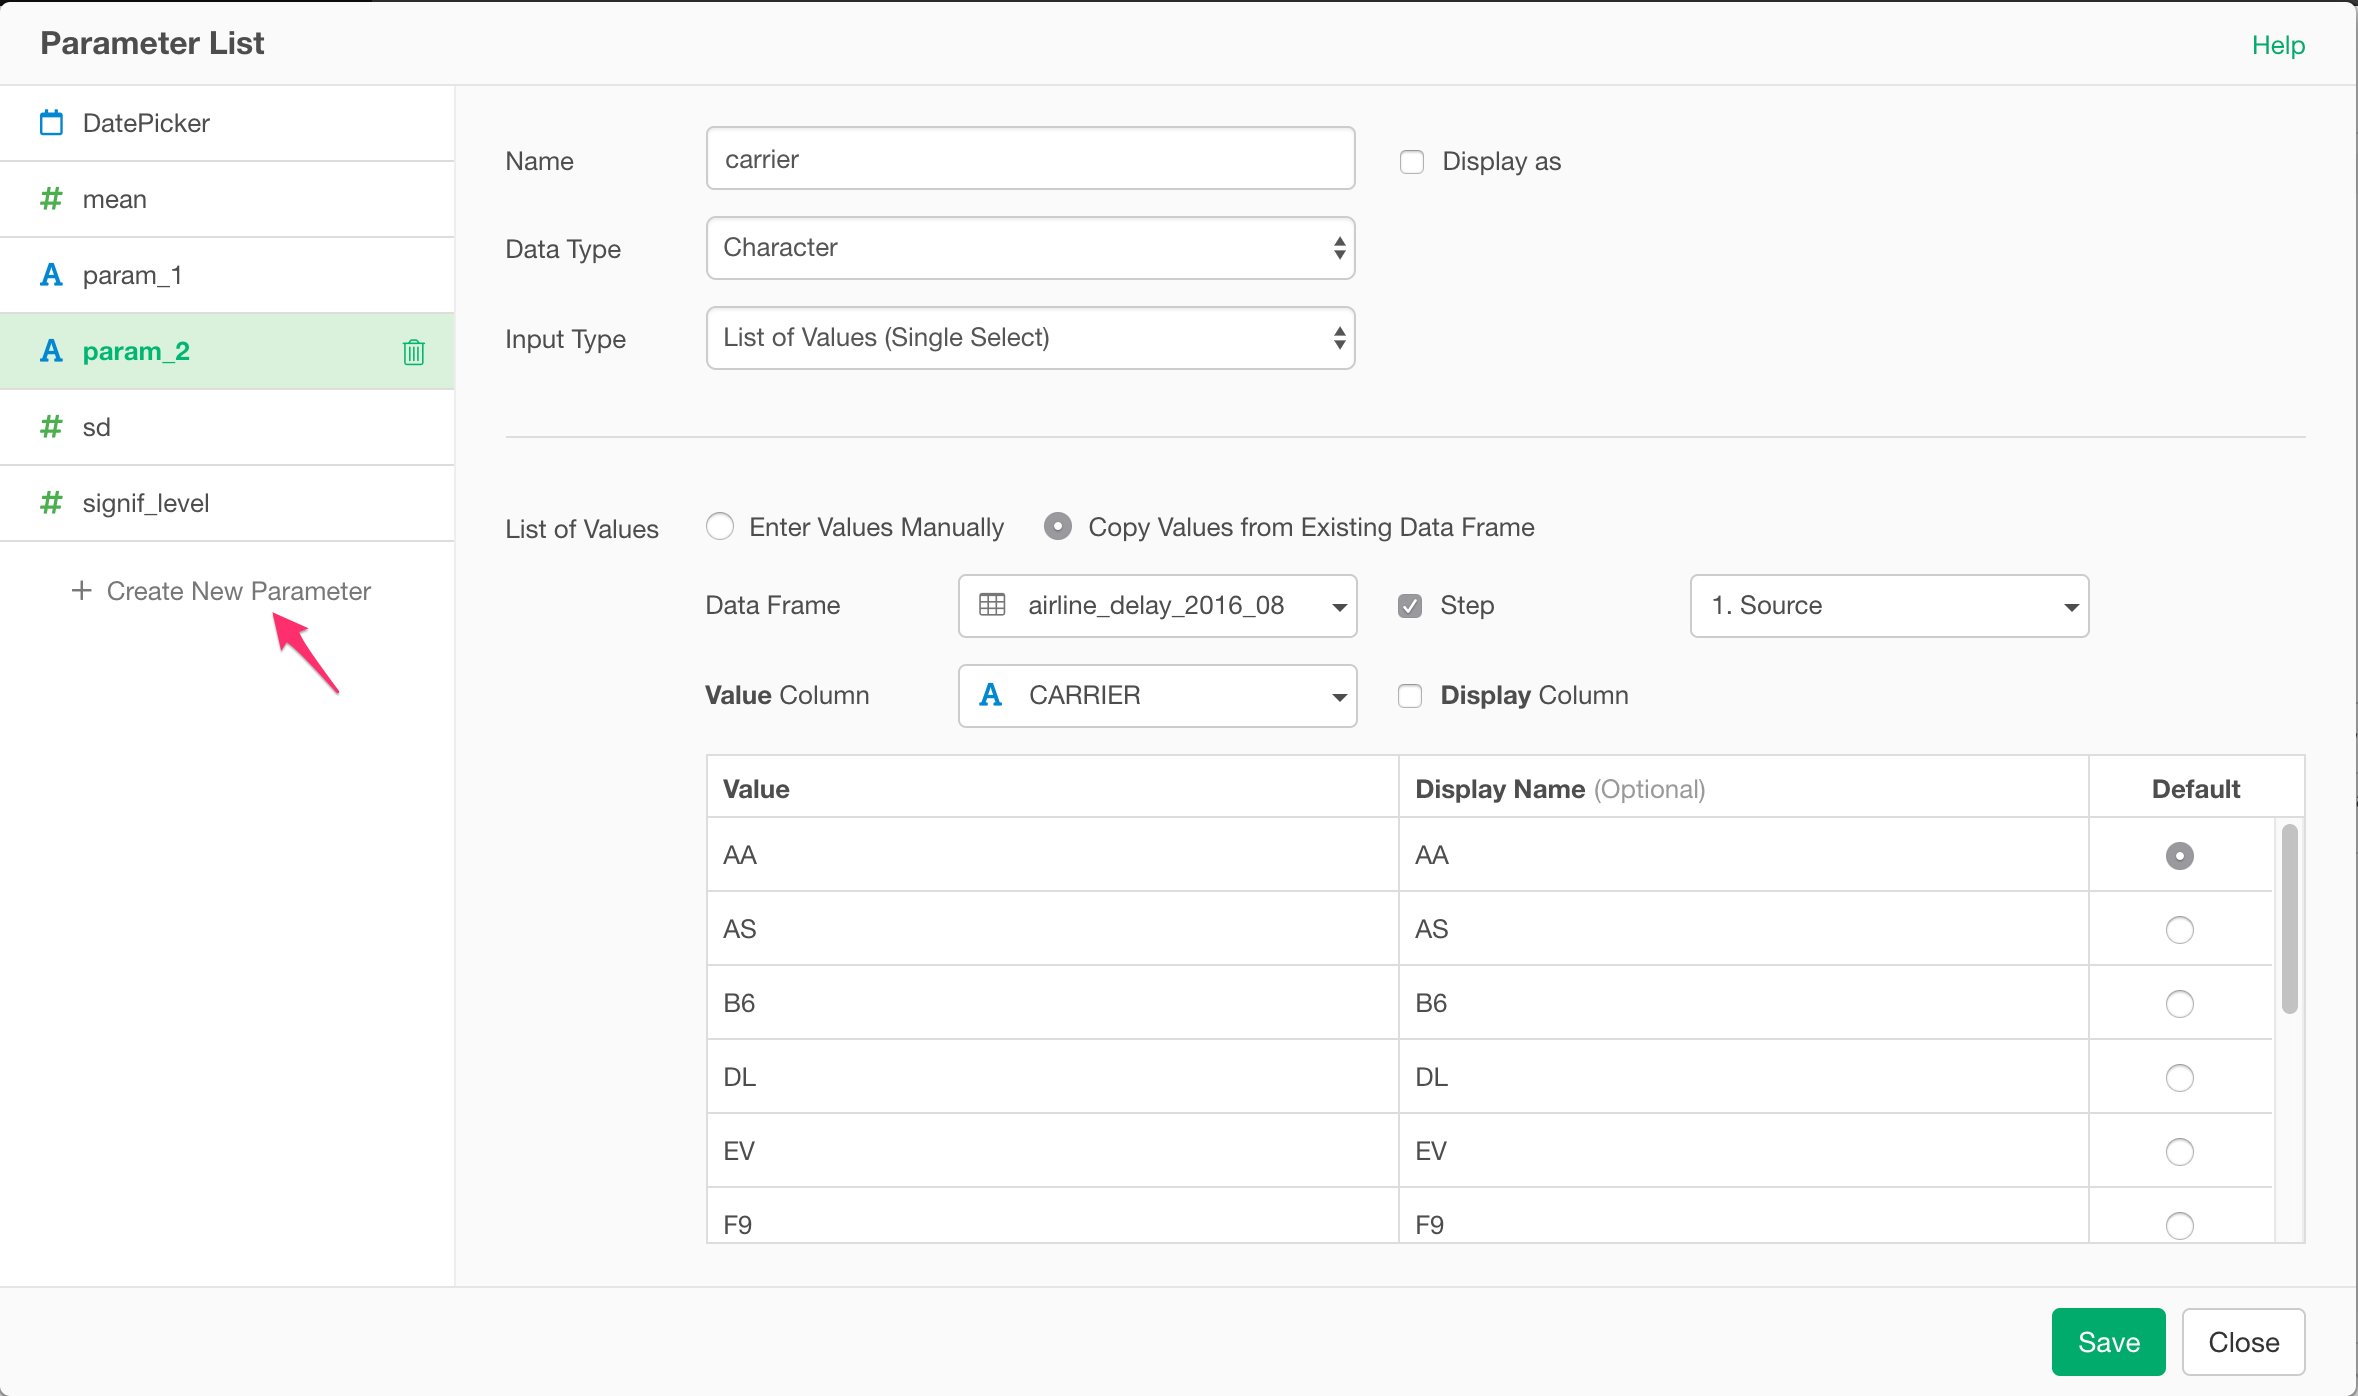
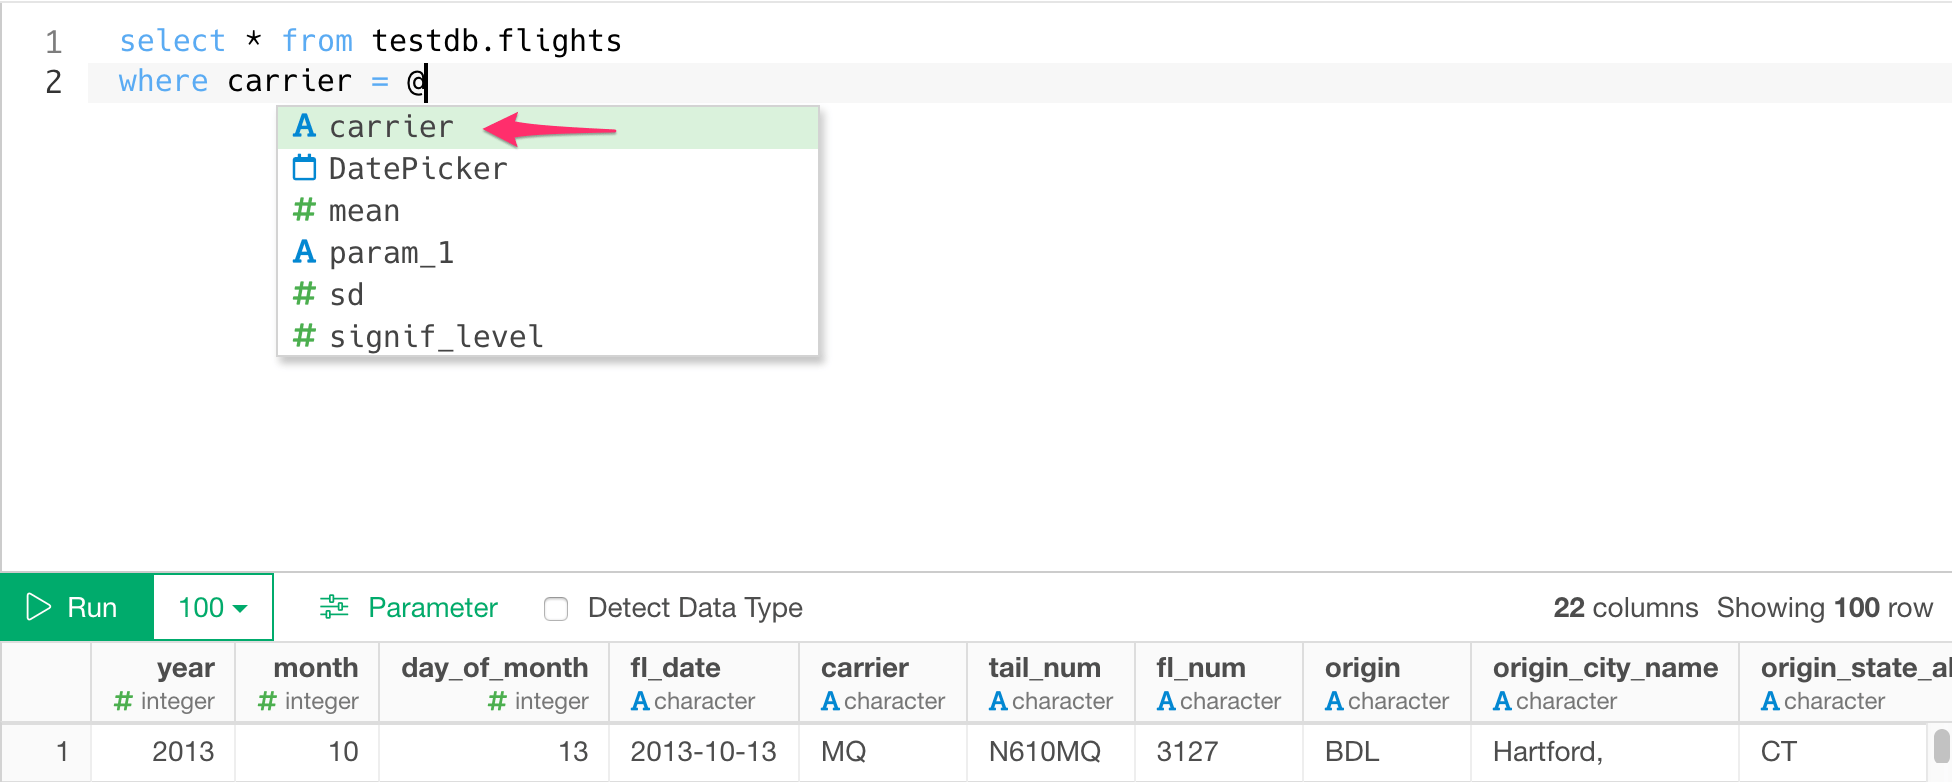
6. AWSセキュリティグループの設定
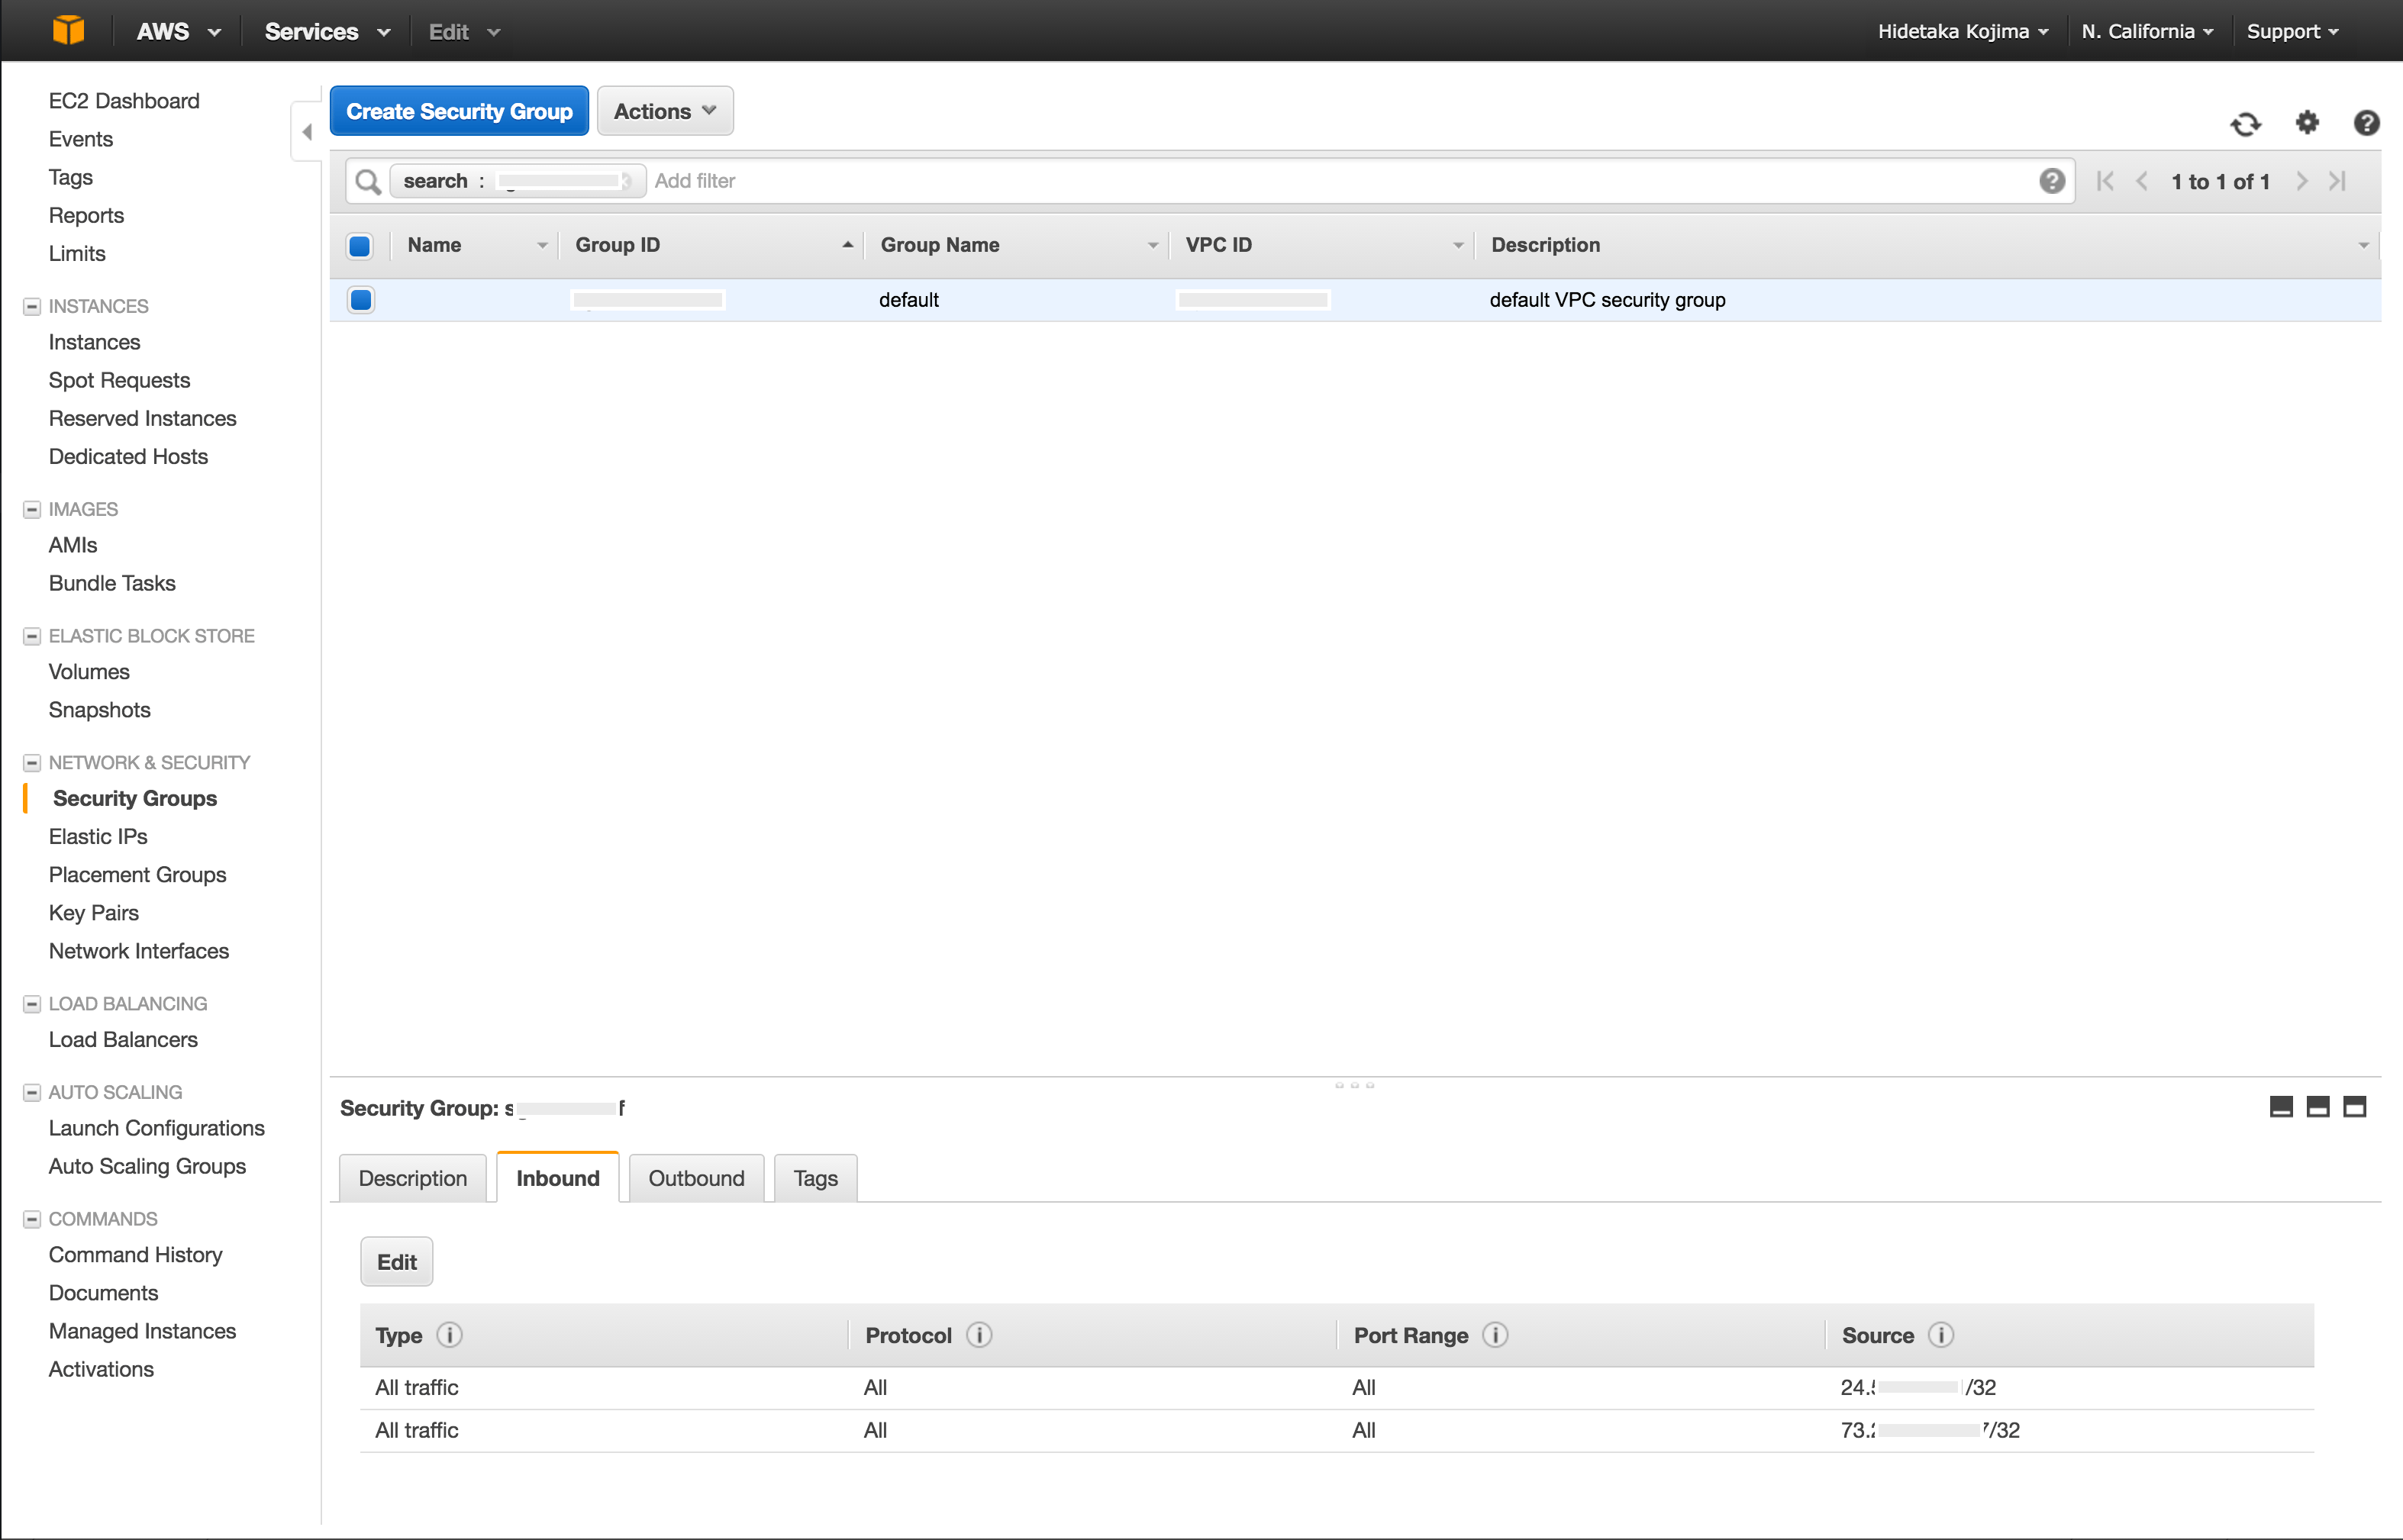
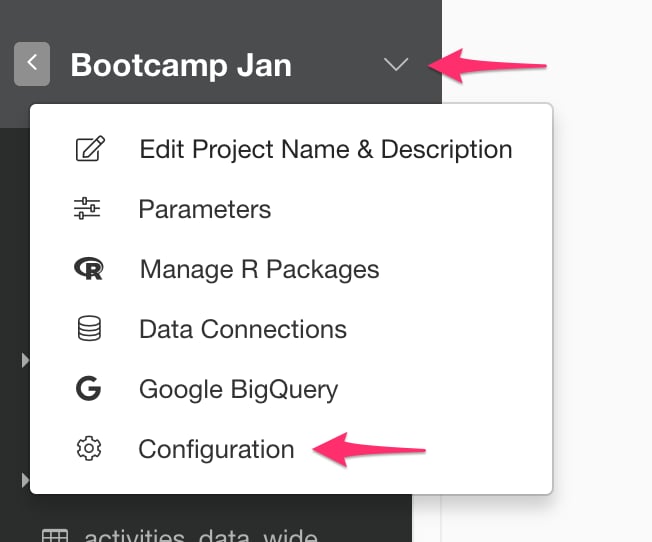
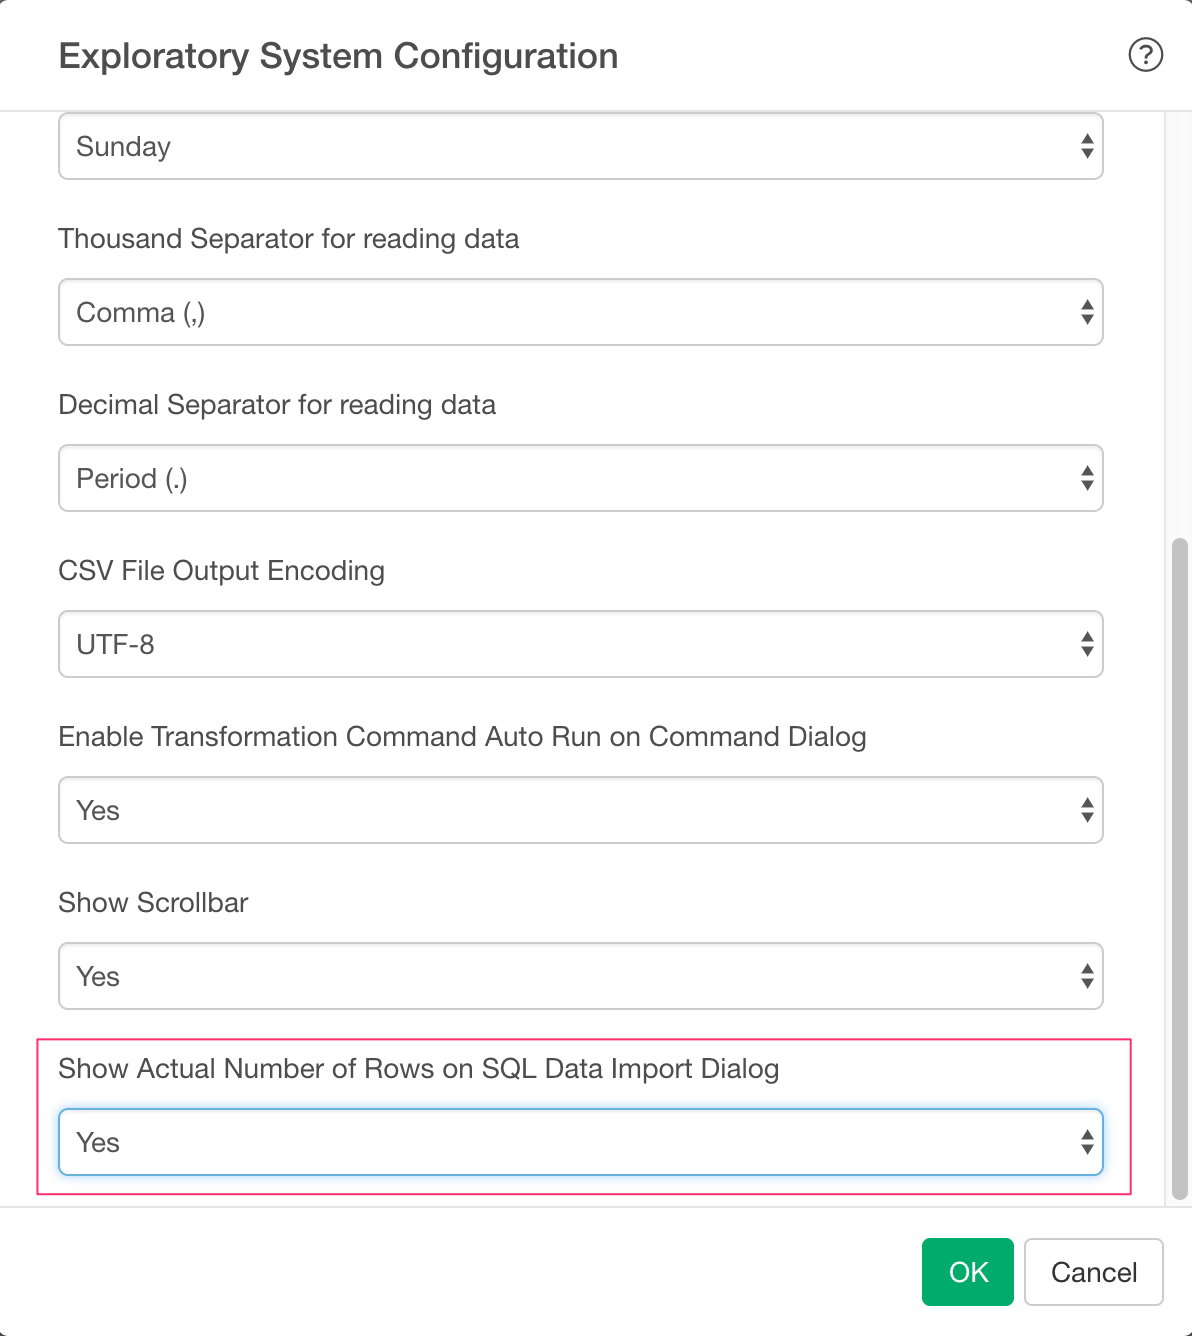
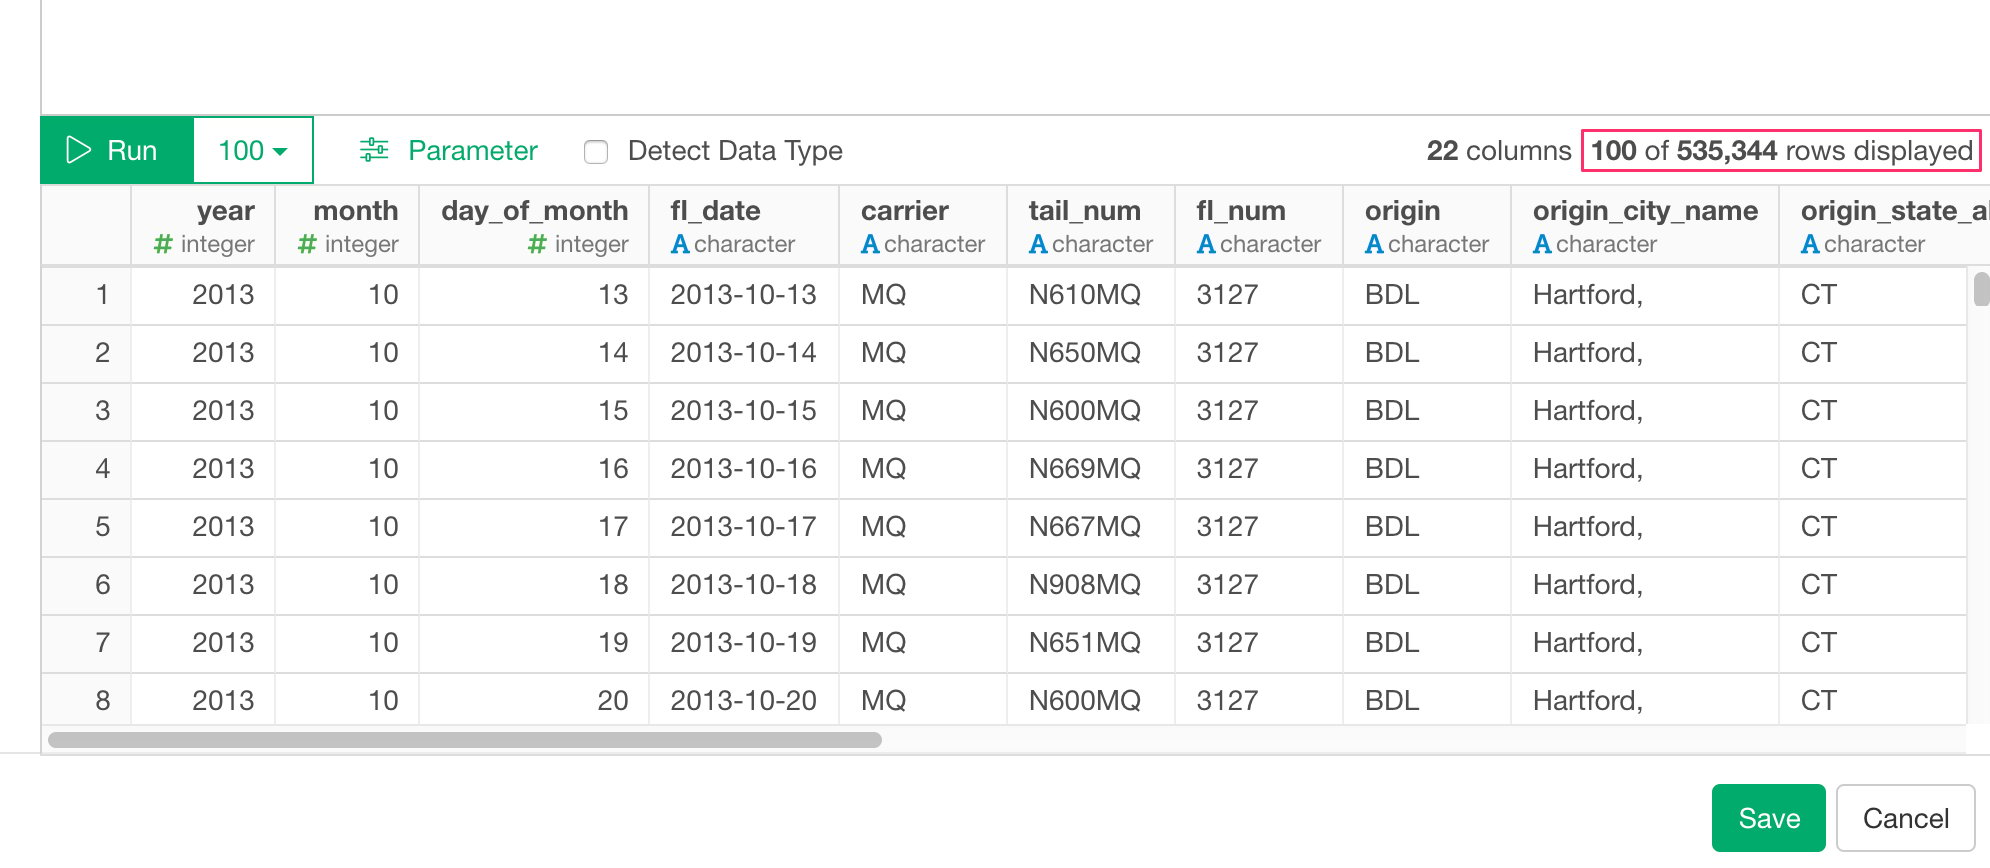
7. 実際の行数
パフォーマンスの観点から、クエリ全体を再実行しないと取得できない、実際の行数を表示しないようにしました。