
画面の構成
AI データは、Exploratory に組み込まれたチャット形式のデータ取得画面です。画面は3つに分かれています。- 左: チャット — 欲しいデータを書く場所。AI とのやりとりがそのまま履歴として残る
- 右上: R スクリプト — AI が生成した取得用のスクリプト
- 右下: データプレビュー — そのスクリプトを実際に実行した結果(先頭100行まで)
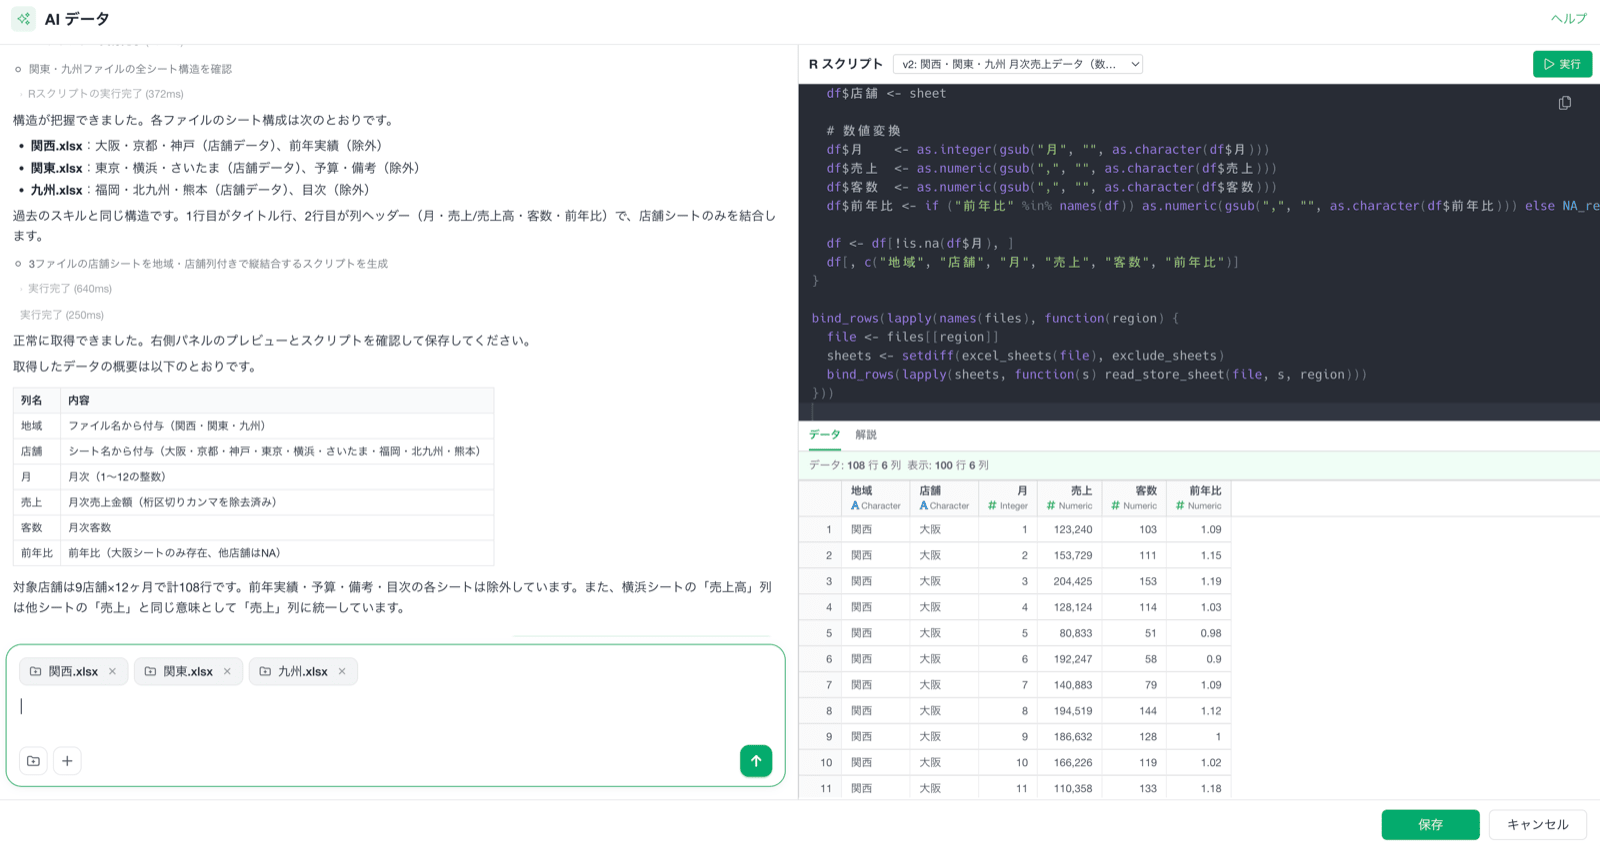
- 中身が見える — 何をやっているかスクリプトで確認できる。不安なら読めばよい
- 直せる — チャットで直すことも、スクリプトを自分で書き換えることもできる
- 再現性がある — 保存後は通常のデータソースと同じで、更新時は保存されたスクリプトが実行できるため、再現性があります。
サポートしているデータの種類
画像以外であれば、基本的にどんなデータでもインポートできます。 R から取得できるものは AI データの守備範囲だと考えて構いません。 AI データの内部には、データソースごとの取得手順を書いたリファレンスが 110 種類以上用意されていて、AI はまずそれを参照してから R スクリプトを組み立てます。だから「なんとなく書いてみる」のではなく、そのデータソースの正しい取り方に沿ったスクリプトが出てきます。1. 手元のファイル
Excel の複数シートや、フォルダ内の複数 CSV を「1つのデータにまとめて」と頼めるのが、手作業との大きな違いです。
2. データベース
PostgreSQL、MySQL / MariaDB、SQL Server、Oracle、Snowflake、BigQuery、Amazon Redshift、Amazon Athena、Amazon Aurora、Presto / Trino、MongoDB、SQLite、Treasure Data、Vertica、Teradata、MS Access など。ODBC / DBI 経由の汎用 DB にも対応しています。3. クラウドストレージ・SaaS
Amazon S3、Google Drive、Google Sheets、Google Cloud Storage、Dropbox、Box、SharePoint、Microsoft Azure Storage、Salesforce、Stripe、Intercom、GitHub、Google Analytics など。4. 公的統計・オープンデータの API
ここは AI データがとくに効く領域です。API の仕様を読まなくても、名前を出すだけで取りにいってくれます。以下は代表例で、これ以外にも各国の統計機関や分野別のオープンデータ API に対応しています。- 国際機関: World Bank、OECD、Eurostat、IMF、ECB、BIS、UN Comtrade、WHO
- 各国の公的機関: FRED(米国連邦準備制度)、SEC EDGAR、米国財務省、米国労働統計局、USGS、カナダ統計局、英国国家統計局など。国内では e-Stat、e-Gov データポータル、EDINET(有価証券報告書)、気象庁 防災情報、不動産情報ライブラリ
- その他: Wikipedia / Wikidata、Open-Meteo(気象)、OpenStreetMap、CoinGecko(暗号通貨)、Our World in Data、株価データ
5. Web ページ・Web 検索
特定のページから表を取ってくる、あるいは「Web を検索して探してくる」こともできます。チャットの進行表示に「Web を検索」「Web ページを取得」というステップが出てきたら、この動きをしています。AI データの使い方
ステップ1: AI データを開く
データフレーム一覧の 「+」ボタンをクリックし、メニューのいちばん上にある 「AI データ」 を選びます。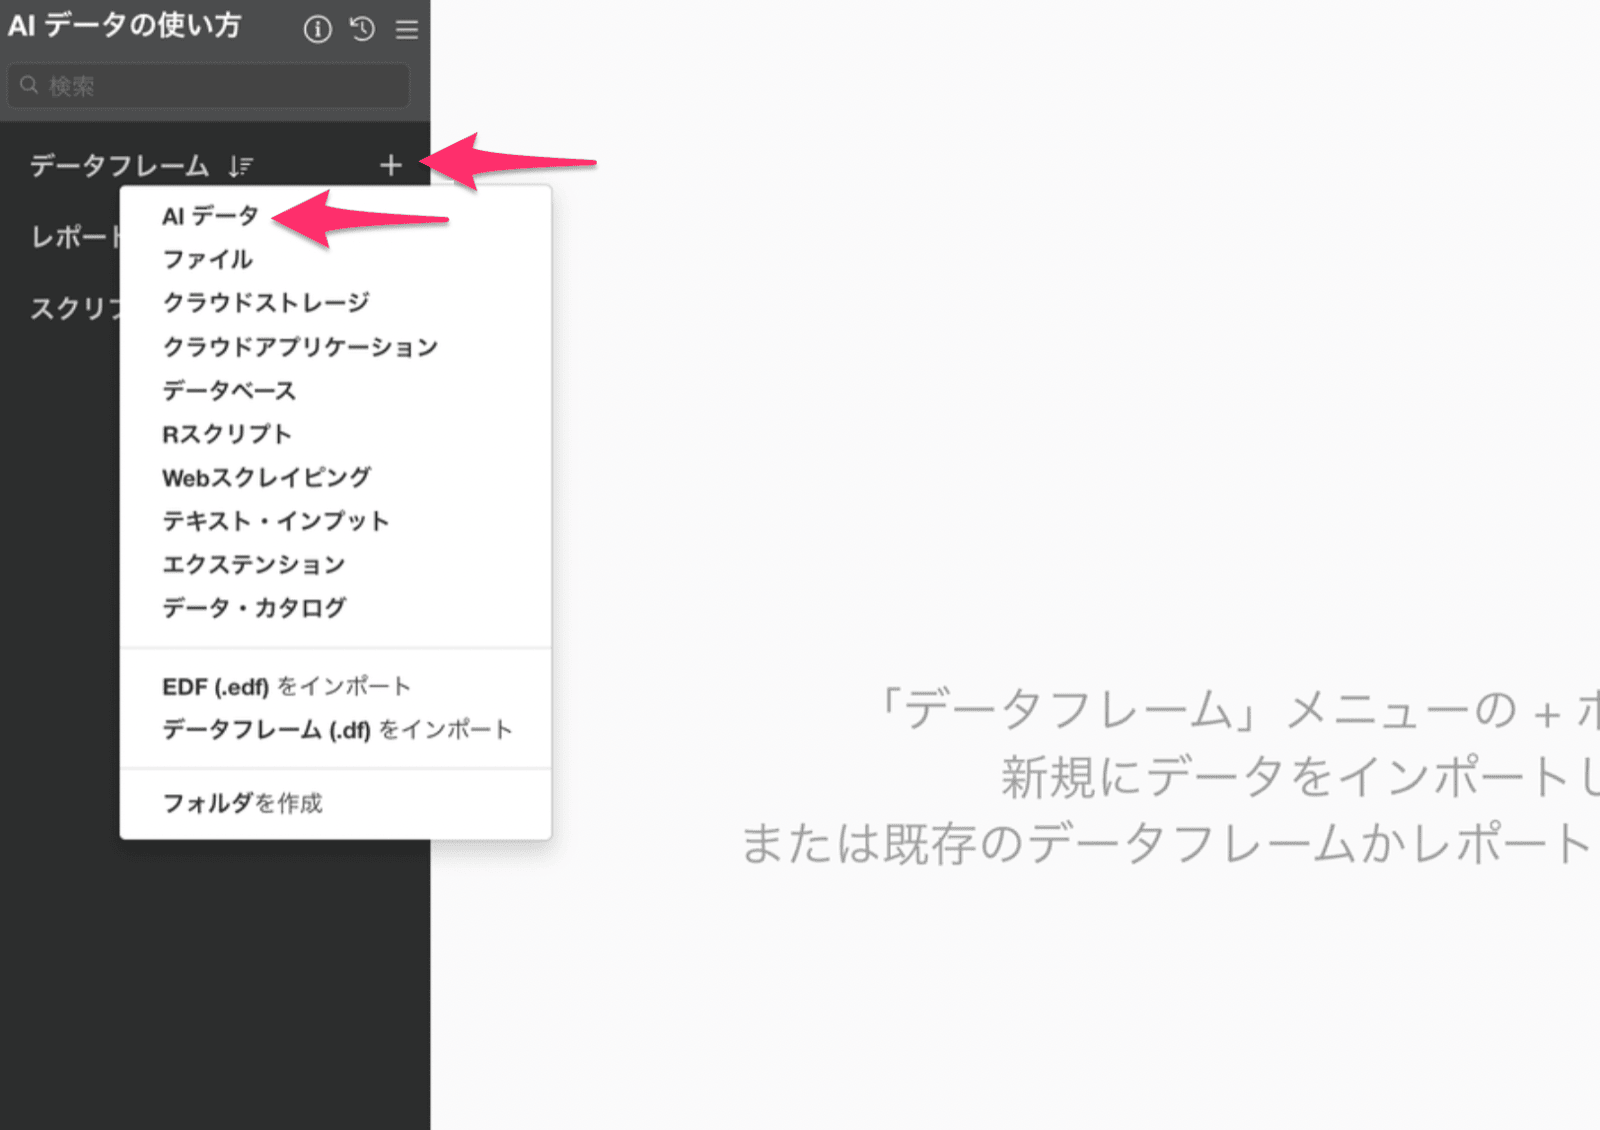
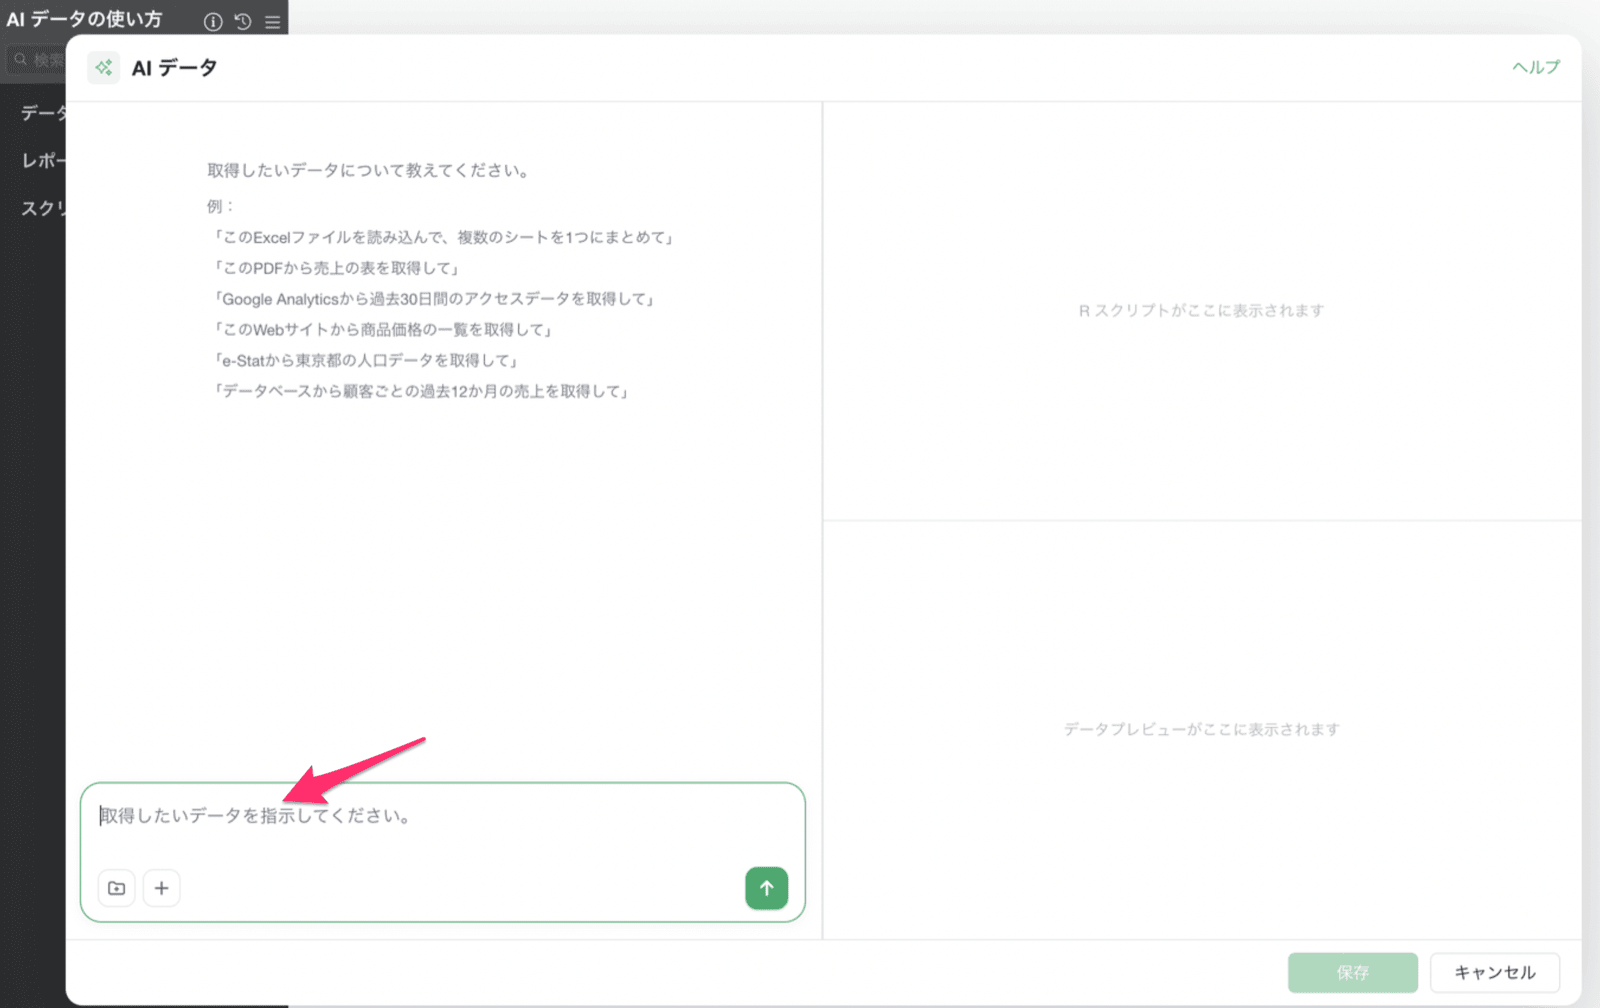
ステップ2: ファイルから取る - ドラッグ&ドロップで指示する
ここからは、実際の例で流れを追っていきます。手元にあるのは、地域ごとに分かれた3つの売上ファイルです。関西.xlsx… 大阪・京都・神戸、前年実績関東.xlsx… 東京・横浜・さいたま、予算と備考九州.xlsx… 福岡・北九州・熊本、目次
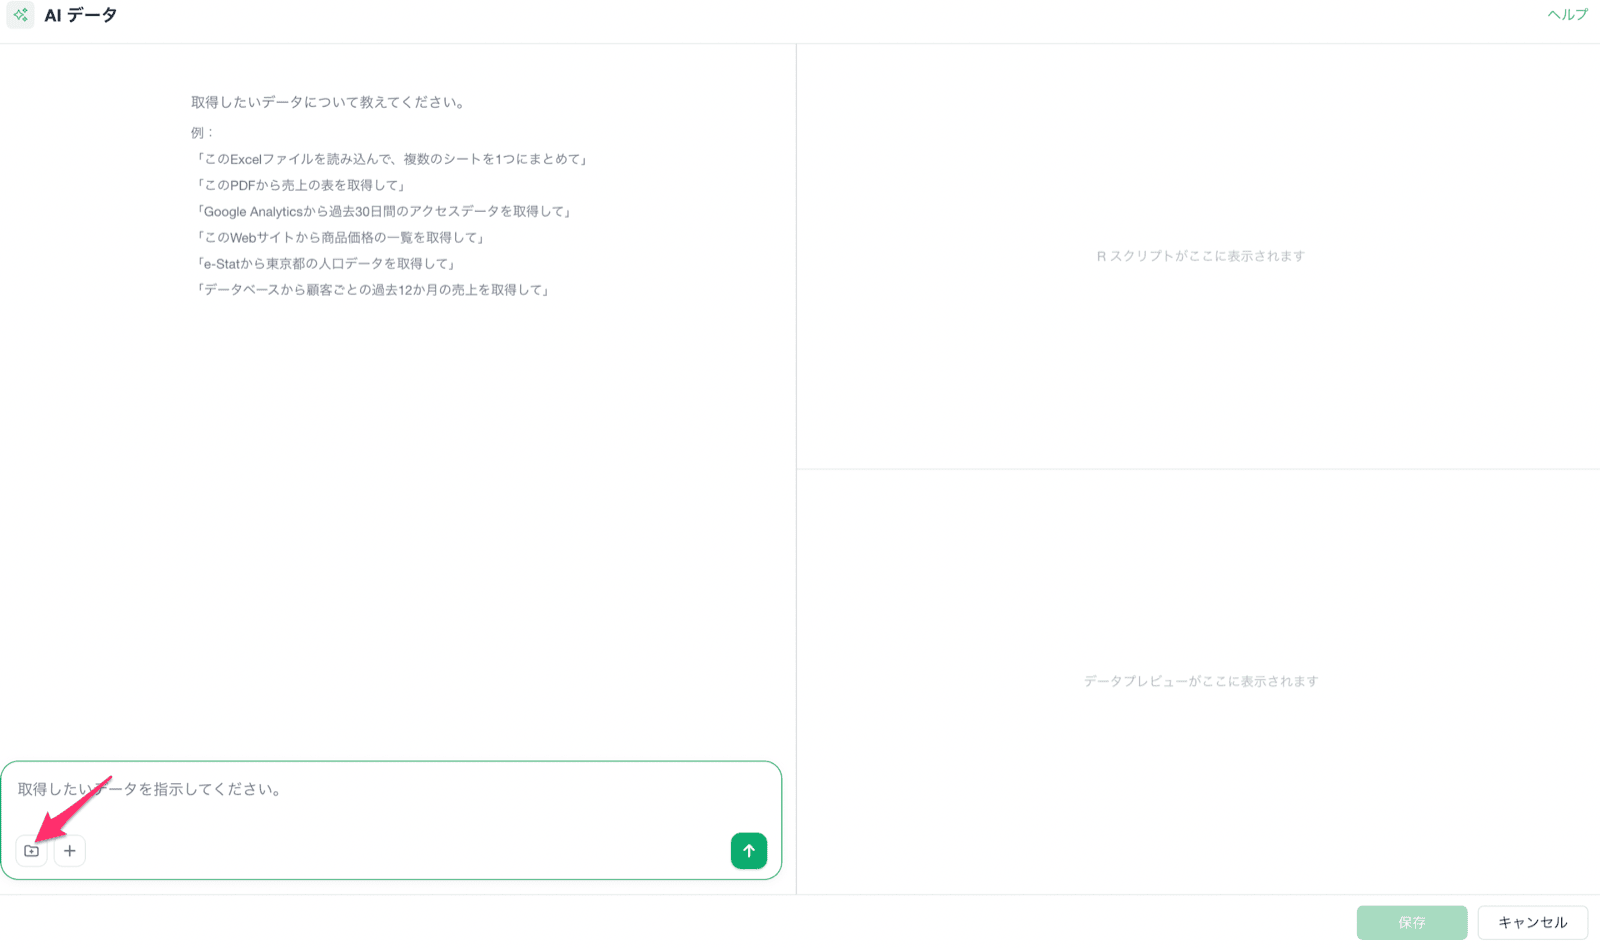
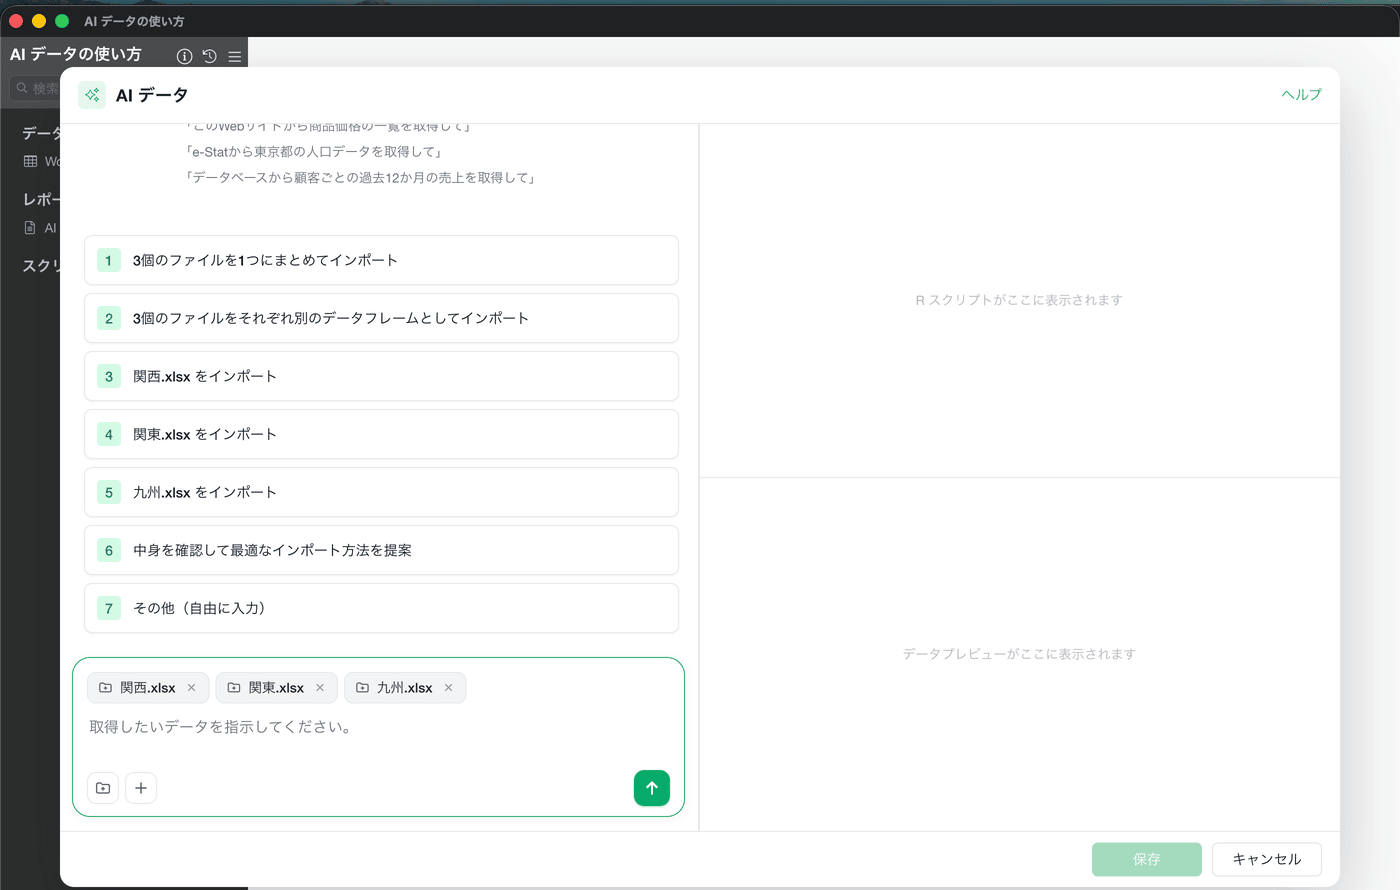
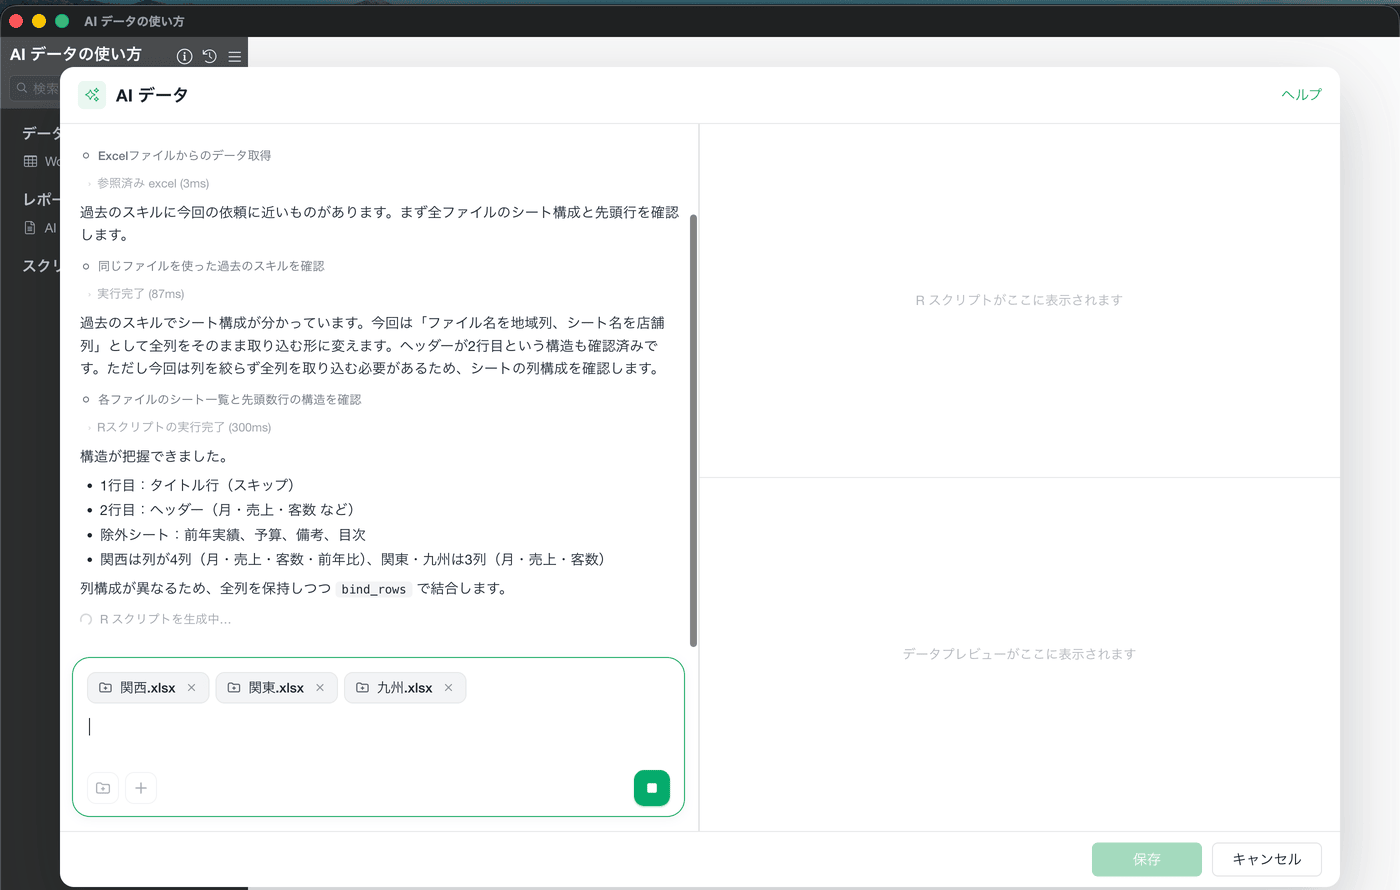
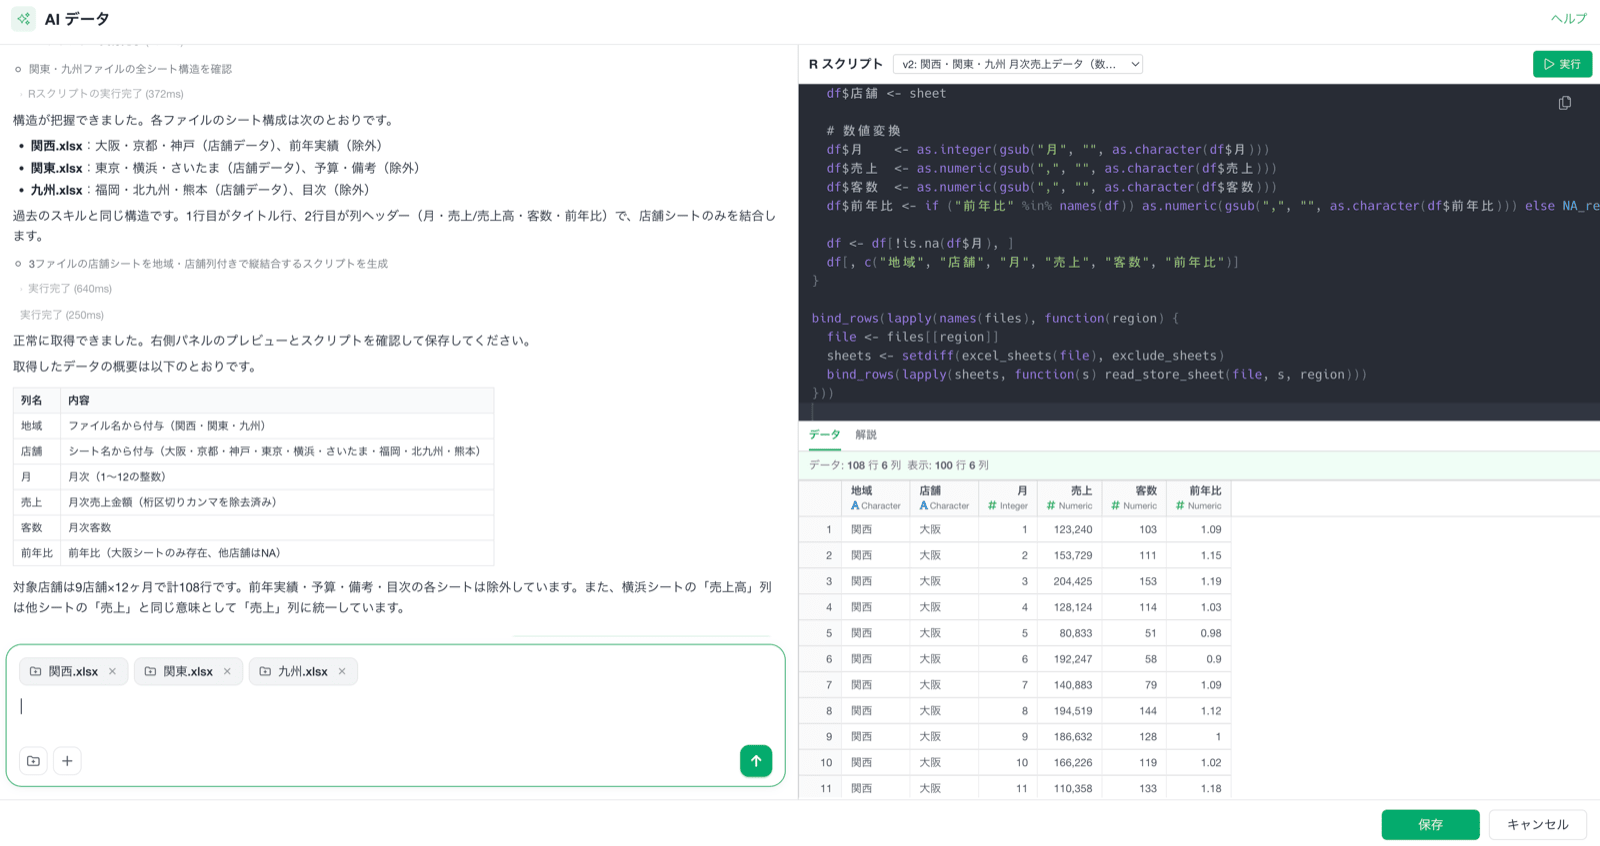
地域、シート名から 店舗 の列ができています。除外したシートも「前年実績(関西)・予算(関東)・備考(関東)・目次(九州)」と明示されました。ファイルによって列構成が違う点も、AI 側が気づいて説明しています。
ステップ2: データベースやAPIから取る - コネクションを選ぶ
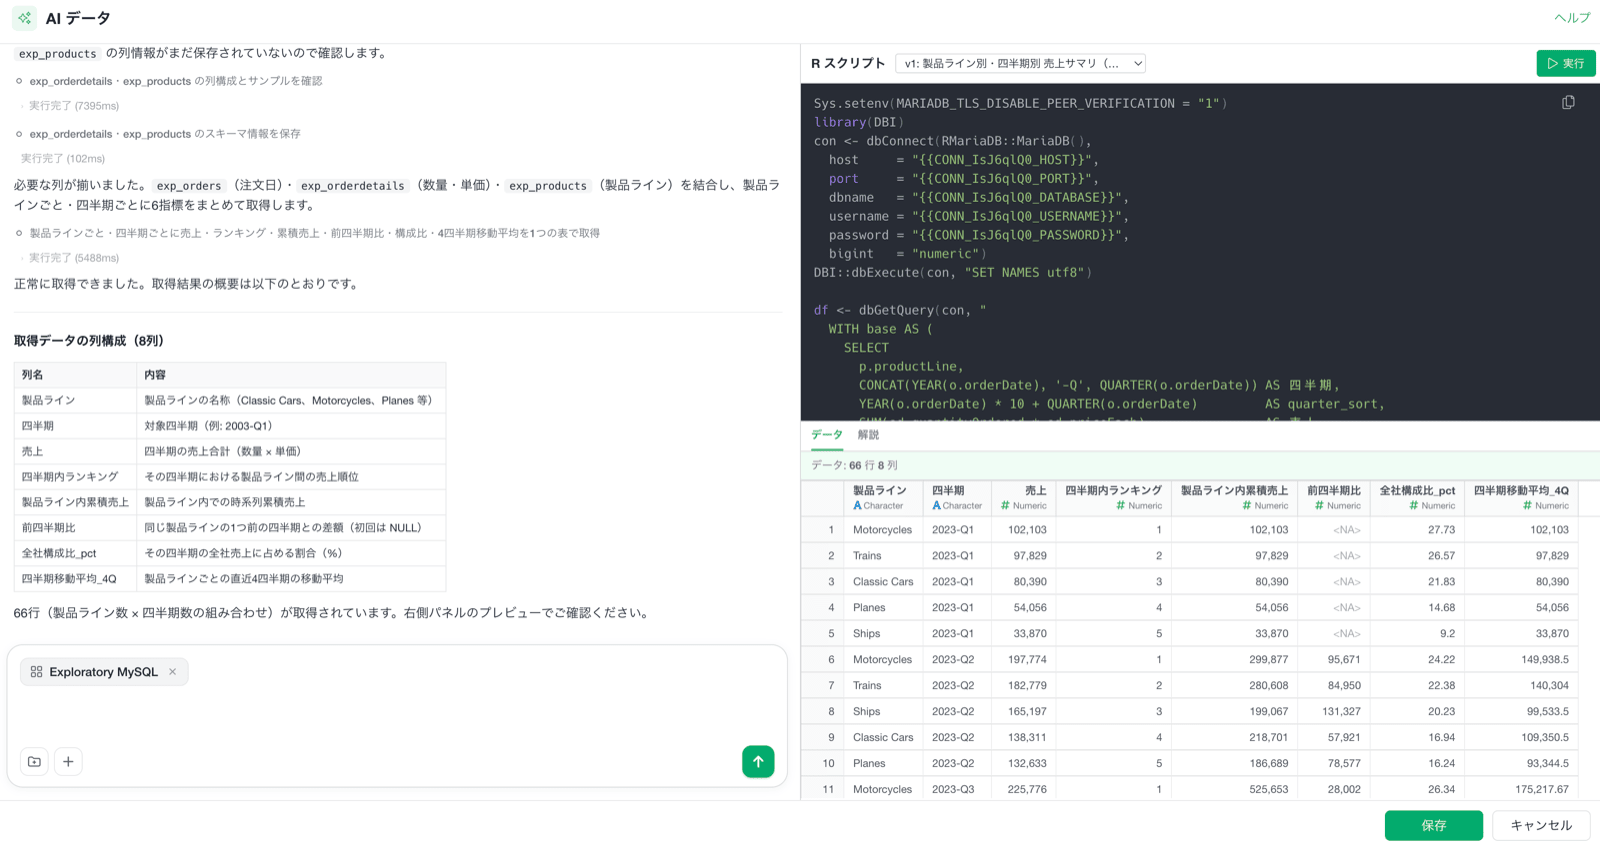
データベースや API のように認証が必要なデータソースは、コネクションを選んでから依頼します。入力欄の「+」ボタンから「データコネクション」を選ぶと、登録済みのコネクションが一覧で出てきます。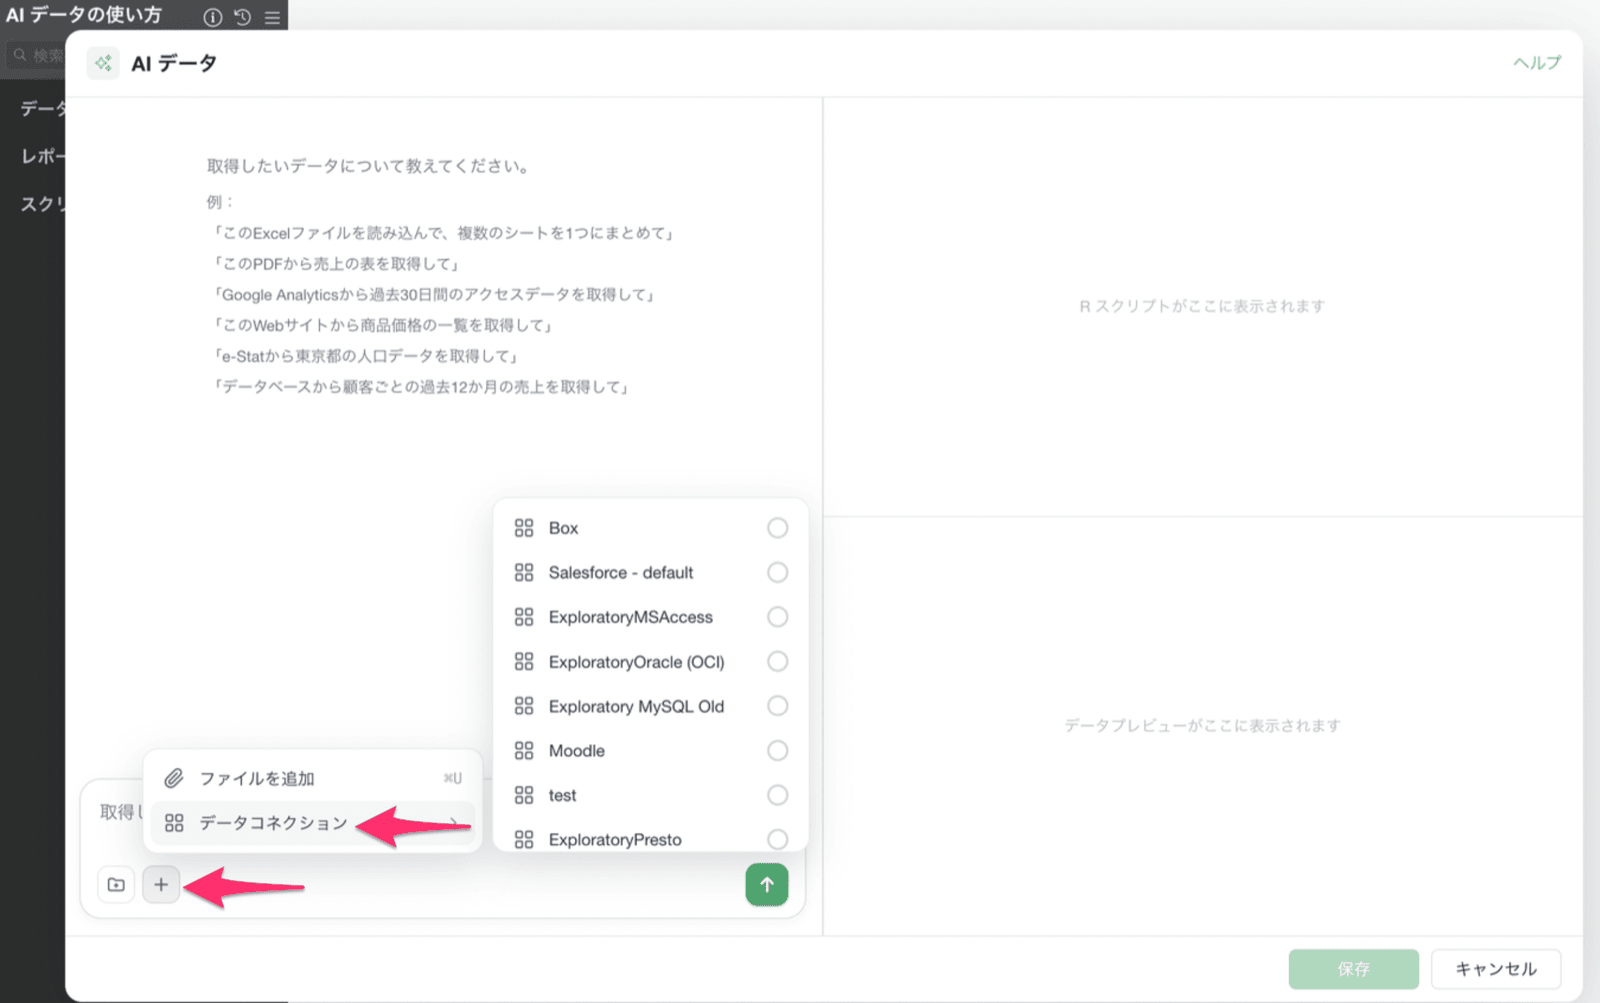
ステップ2: コネクションが無いとき - チャットから作る
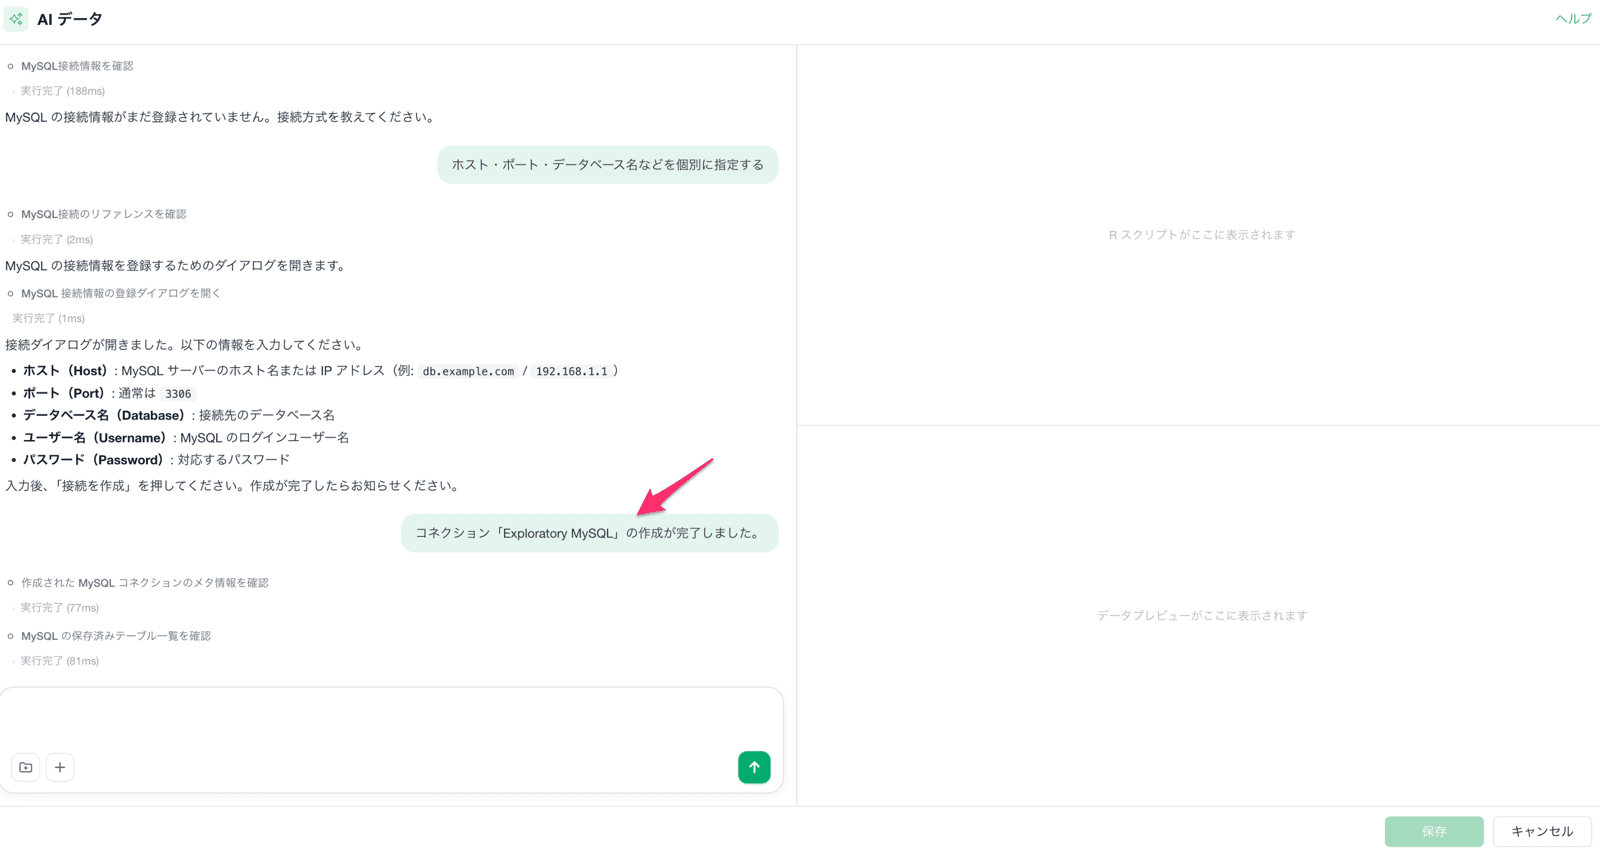
まだコネクションを作っていないデータソースでも、いきなり依頼して構いません。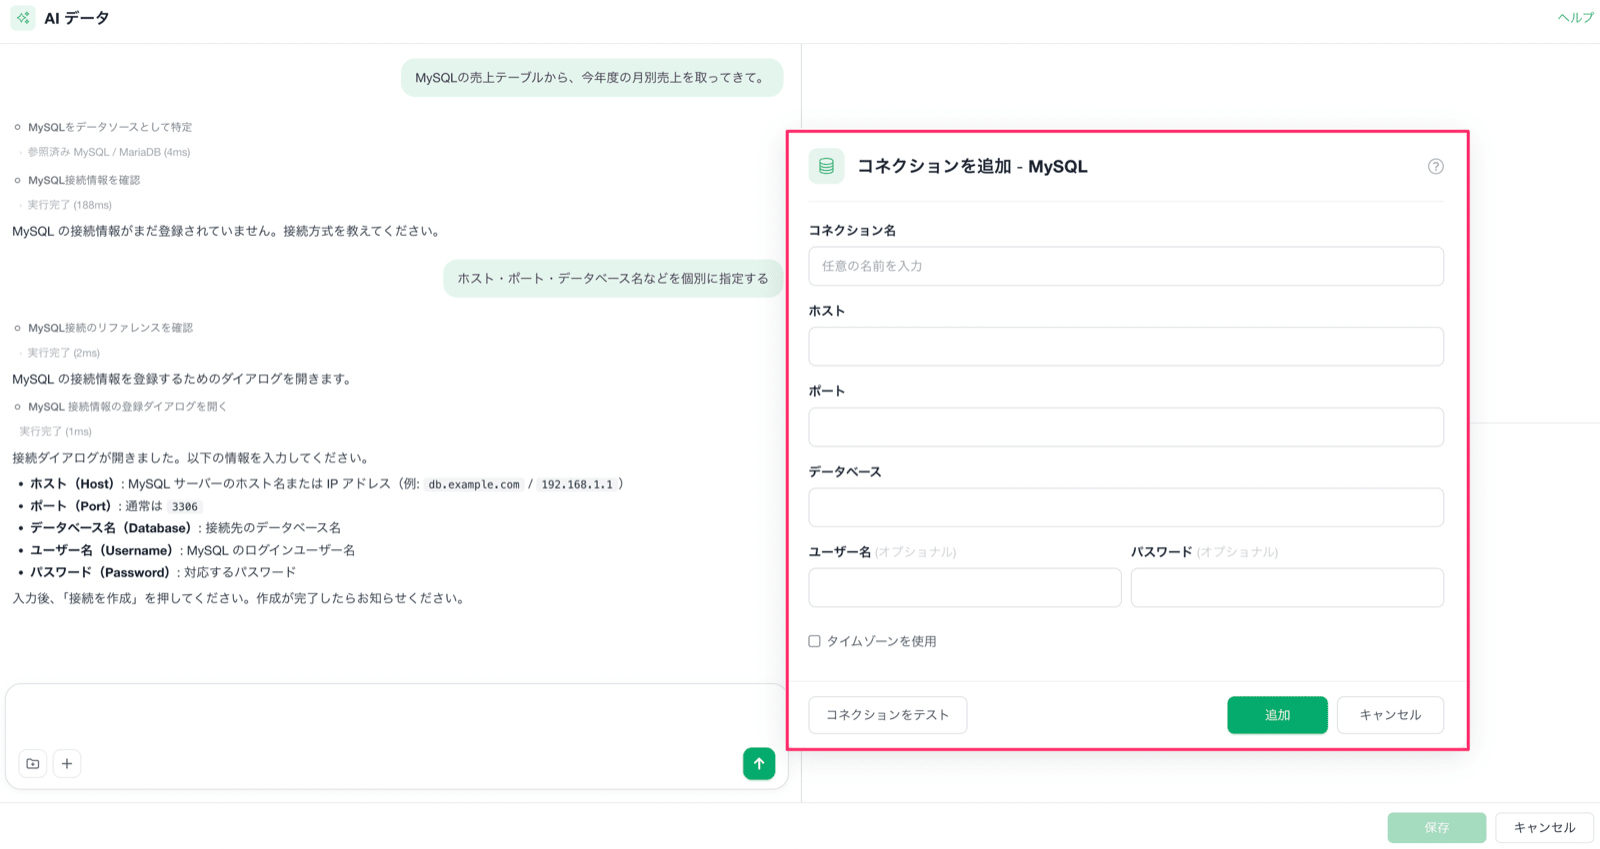
ステップ3: プレビューを確認して、チャットで直していく
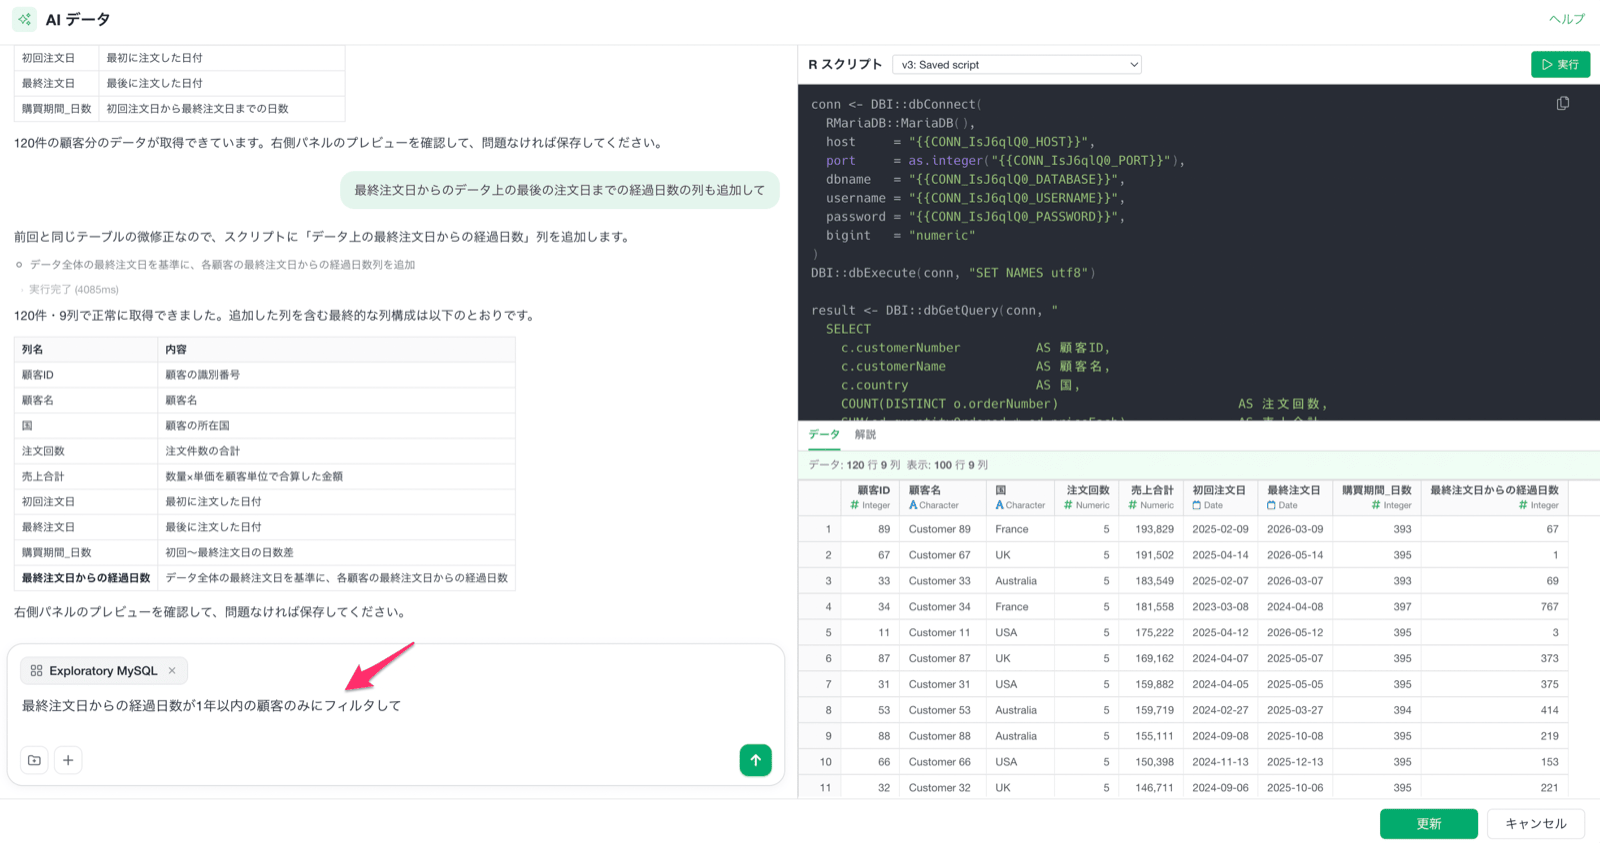
AI データはチャット形式のため、出てきたプレビューを見て、気になるところを追加で指示をして修正していけます。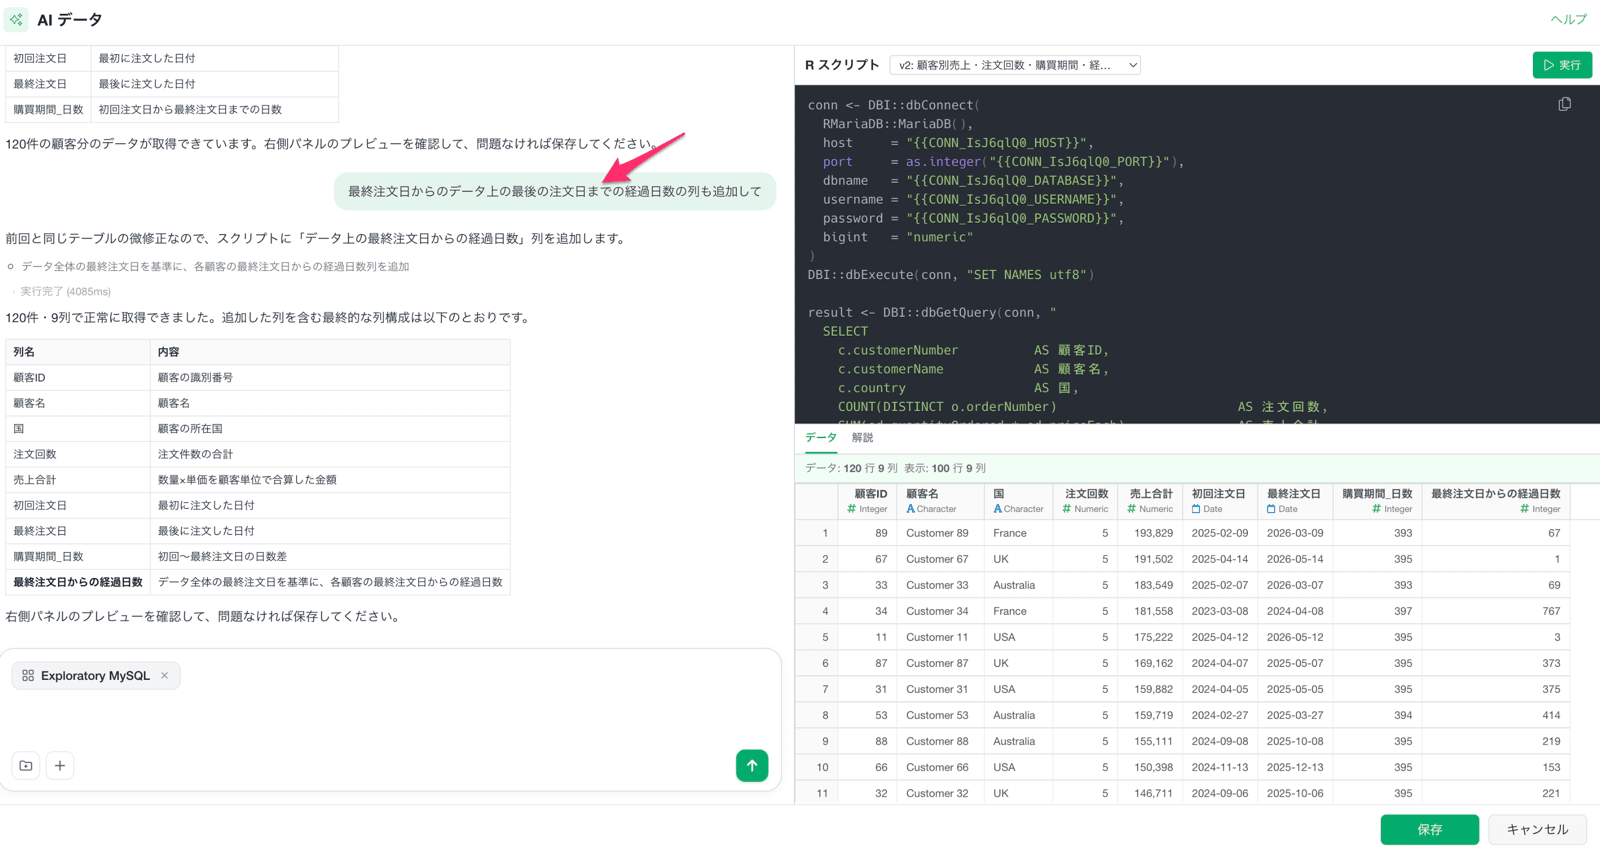
ステップ4: 保存する
プレビューの内容に納得したら 「保存」 を押します。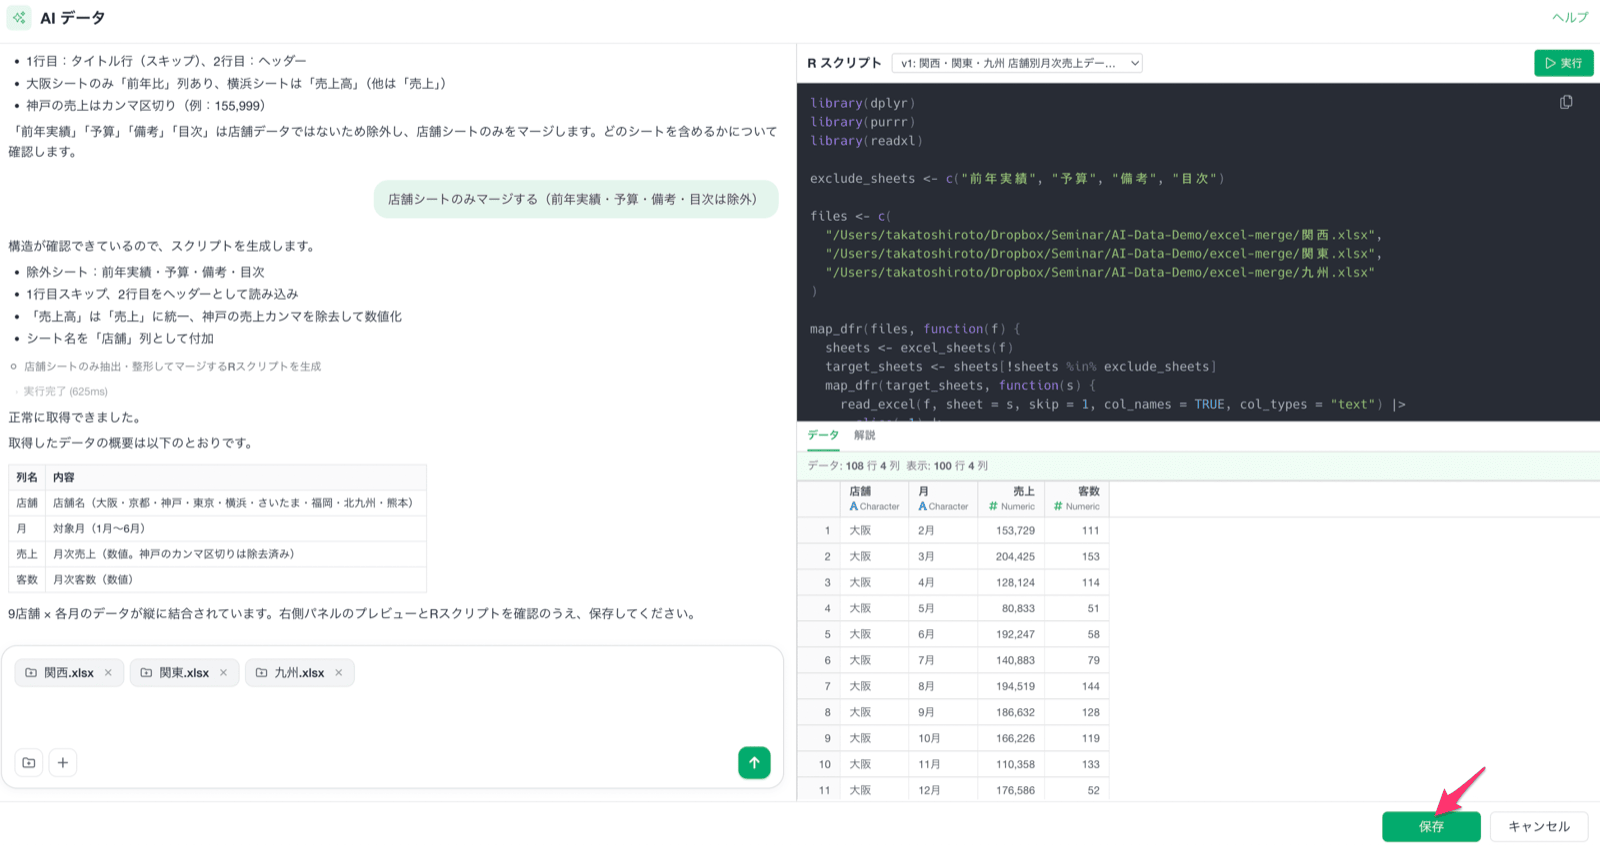
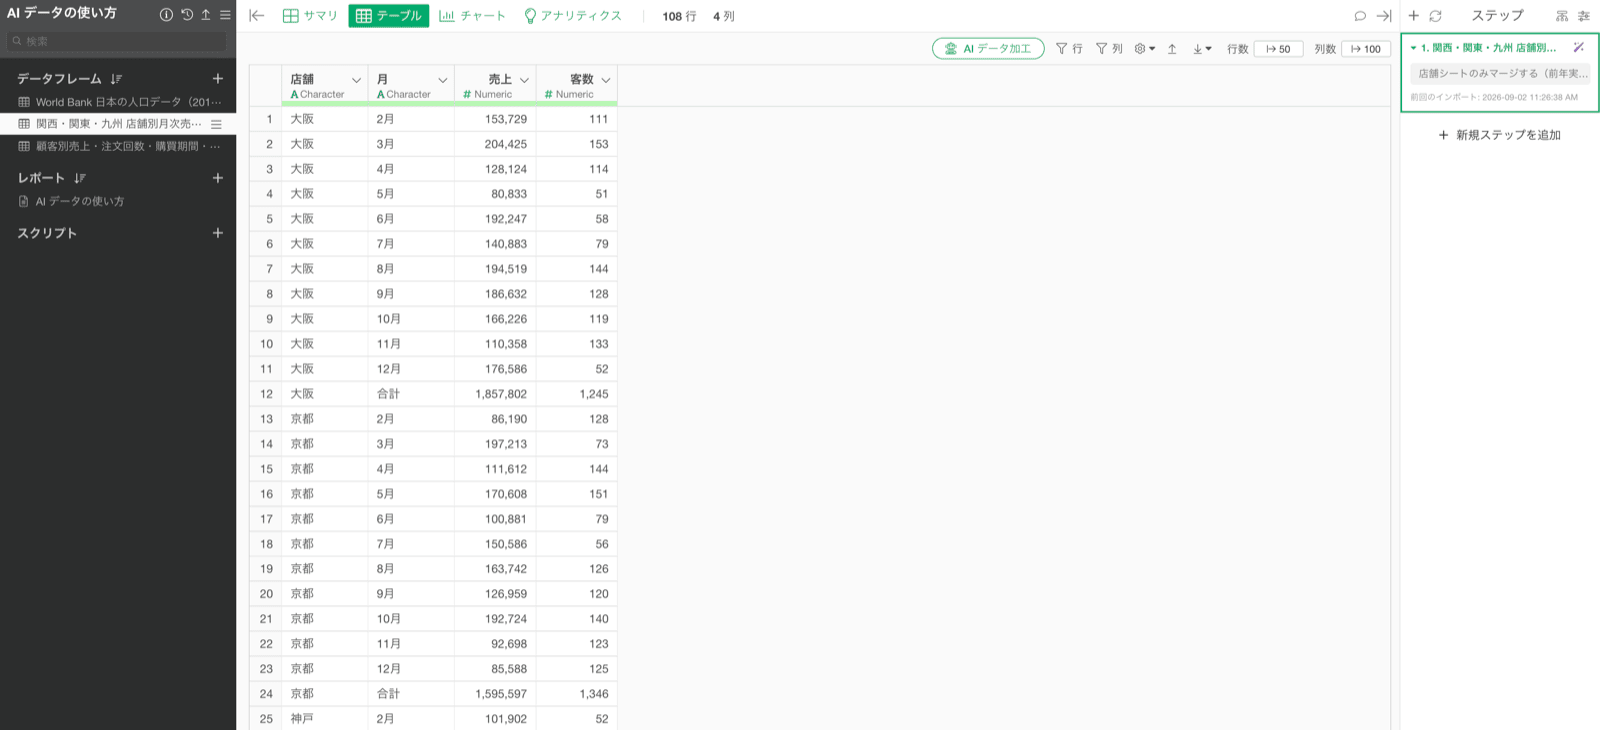
ステップ5: あとから直す
保存したあとでも、ステップに表示されている指示のボックスをクリックすると、それまでの会話ごとチャットが開きます。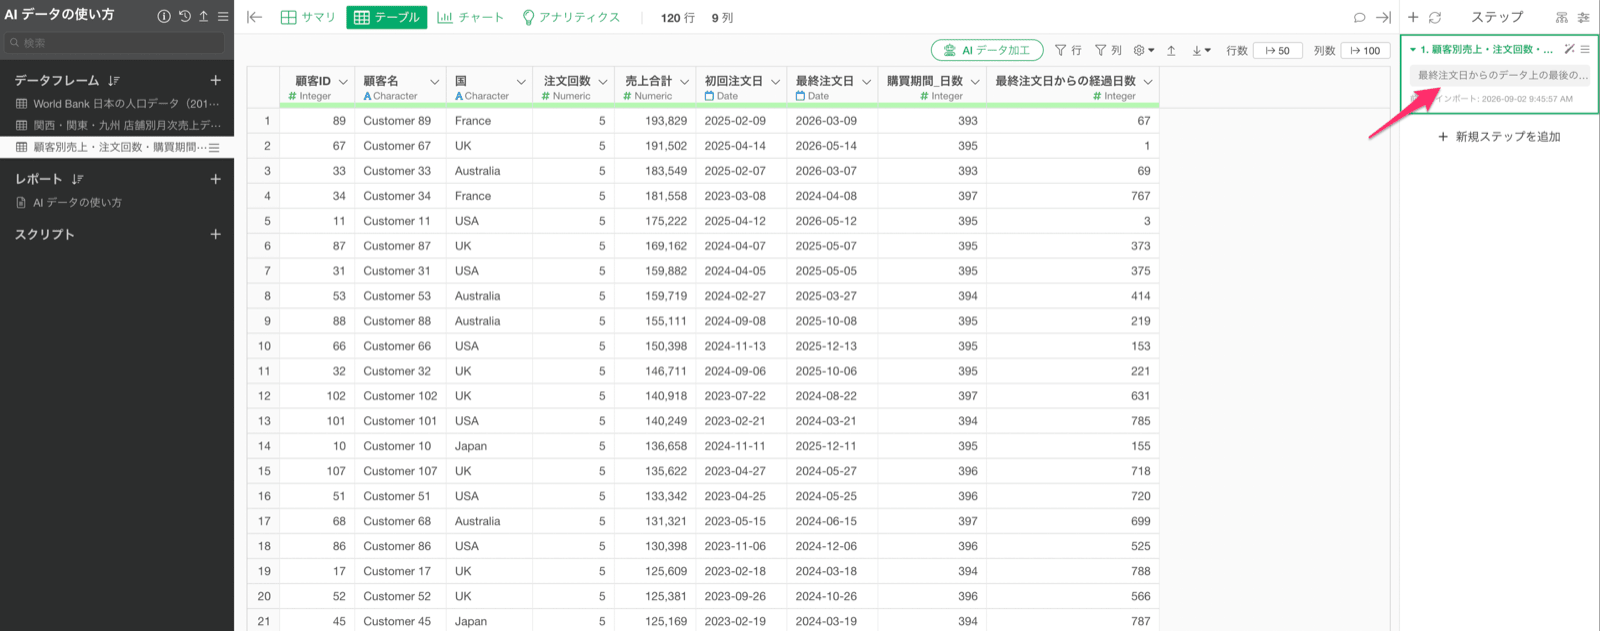
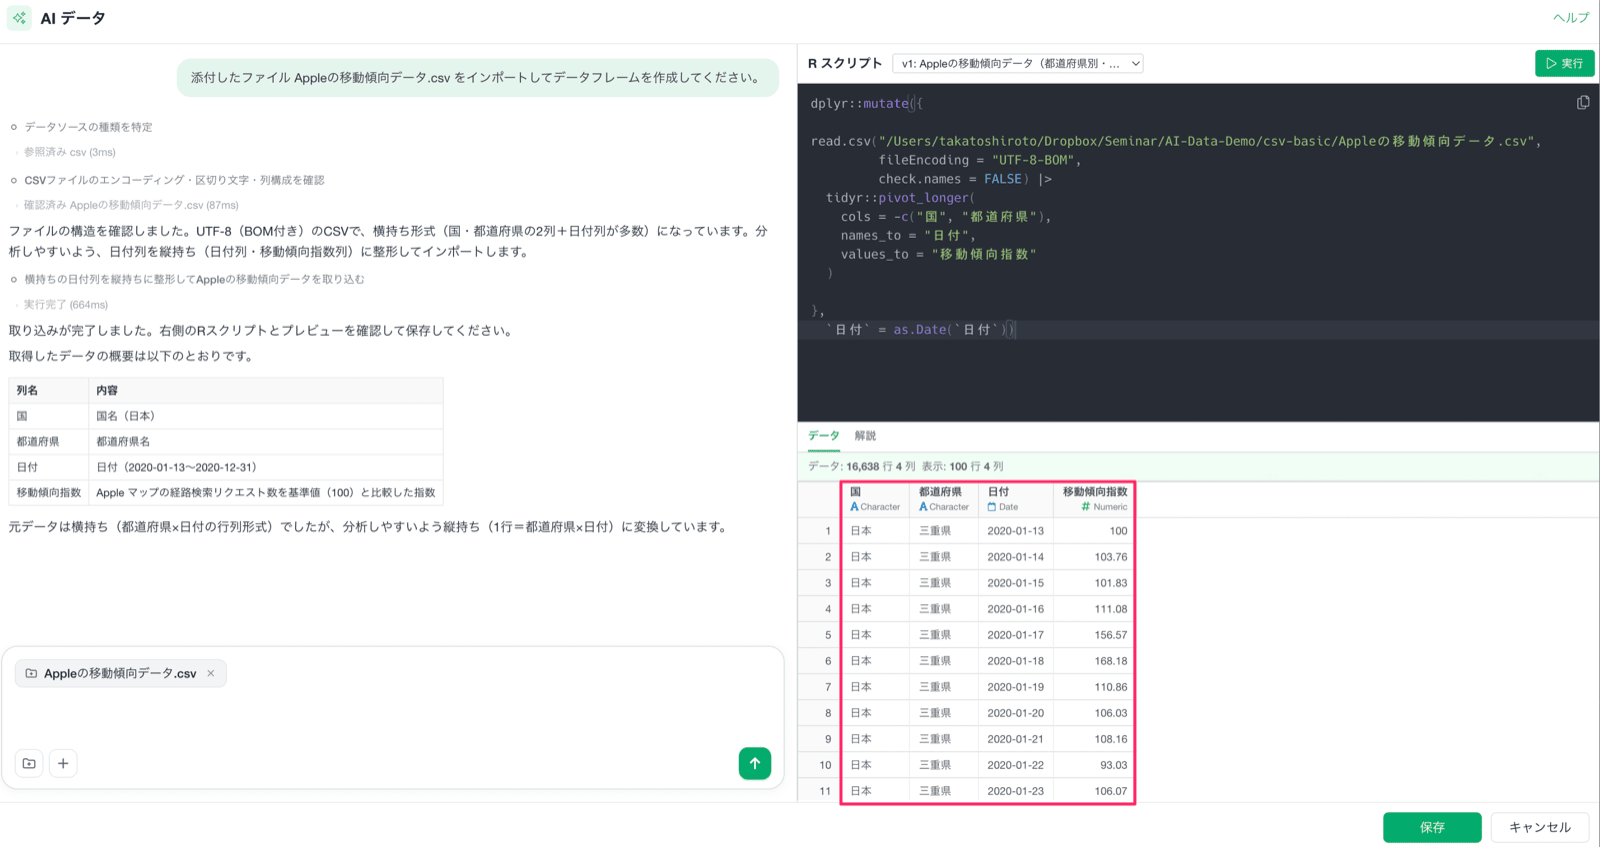
データを扱いやすい形(整然データ)に自動的に整える
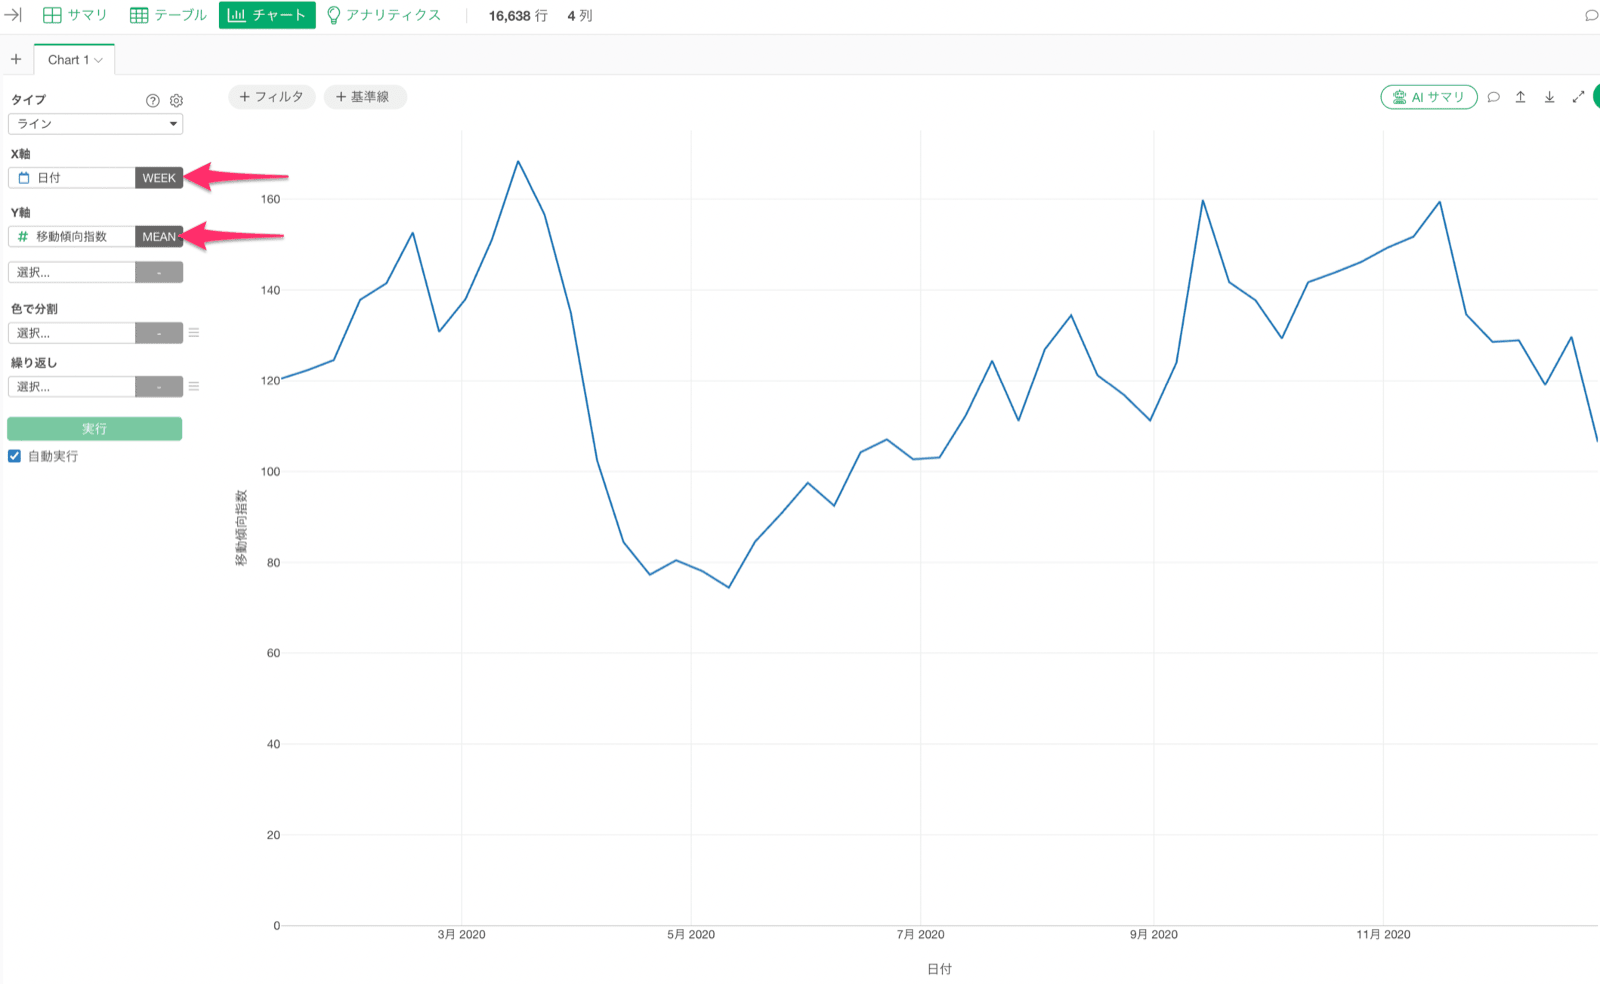
取得したいデータが必ずしも綺麗な状態になっているとは限りません。例えば、以下はAppleの移動傾向データですが、日毎に列を持つワイド型のデータになっています。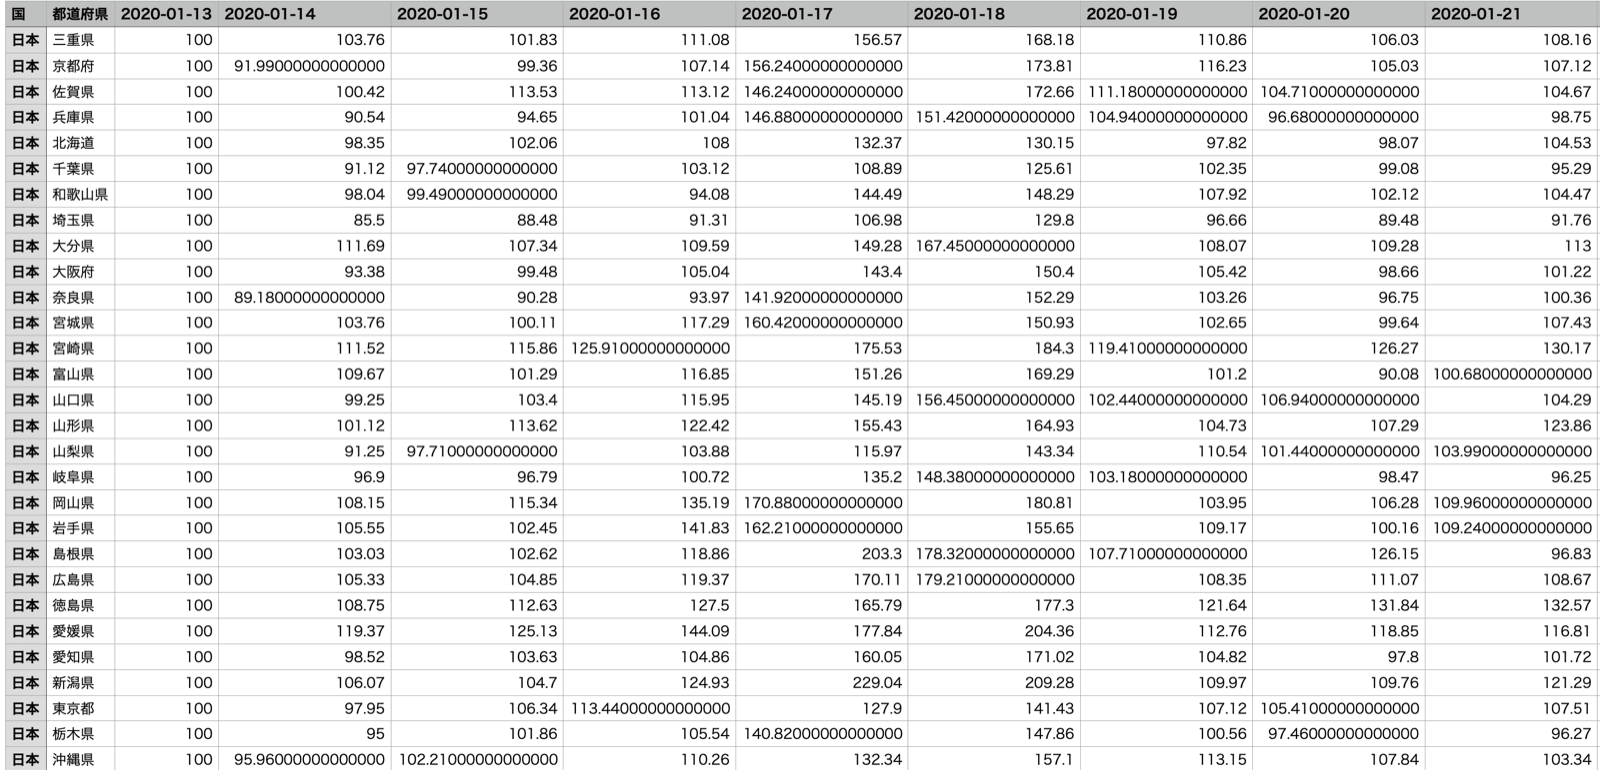
取得方法の知識を蓄積できるユーザースキル
AI データを保存すると、その取得手順が ユーザースキル として自動的に保存され、データの取得手順の知識を使うたびに蓄積していけます。何が保存されるのか
スキルの実体は Markdown ファイルで、~/.exploratory/ai_skills/data_source/ の下に保存されます。中身は次のような構成です。
何が起きるのか
次に同様のデータ取得を依頼したとき、AI データは保存済みのスキルを検索して、前回の手順を下敷きにします。 同様のリクエストが送られた時には、「過去のスキルが複数見つかりました」と判断してスキルを読み込み、過去に使われたRスクリプトを参考にしたデータの取得が行われます。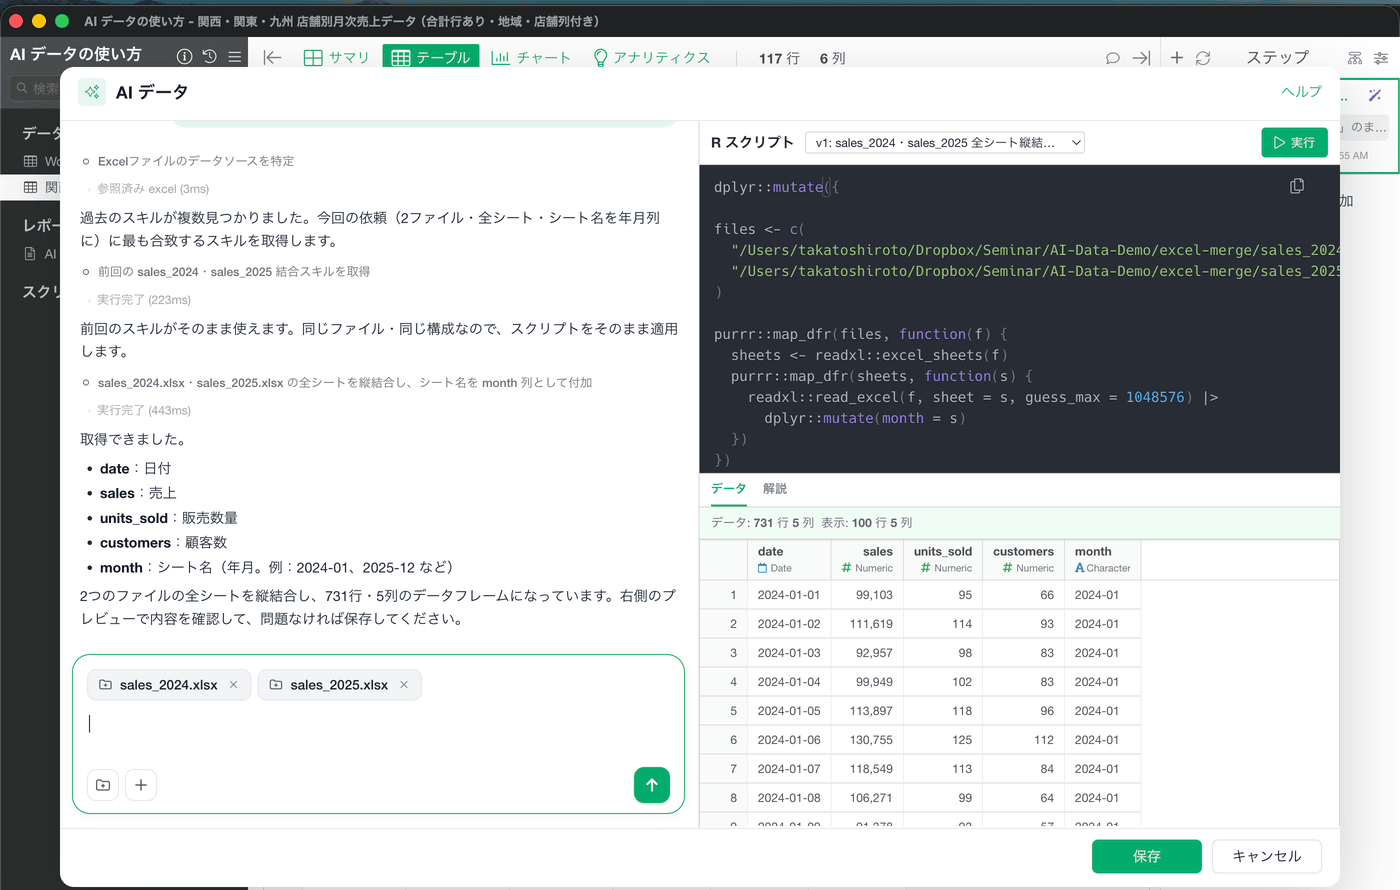
- 2回目以降が速くなる - テーブル構造の調査やスクリプトの試行錯誤をやり直さずに済む
- 手順が形として残る - 前回うまくいった手順をそのまま踏襲するので、毎回違うものが出てくるのを防げる
よくある質問
AI データのよくある質問については、こちらのノートをご覧ください。 このよくある質問のノートには、AI データに関するたくさんの質問に対して、それぞれ回答をしています。以下は、その一つの例として、セキュリティ面に関する質問を取り上げています。セキュリティについて
API キーやデータベースの接続情報は、AI に渡りますか
渡ることはございません。認証情報の取り扱いについては、次のとおり設計しています。- API キーやパスワードなどの認証情報を、チャットでお伺いすることはありません
- 認証情報を R スクリプトに直接書き込むことはありません
- データベースに接続する場合、R スクリプトの先頭では、Exploratory 側が保持している接続情報を変数として差し込む形になります。ホスト名やポート番号が AI に渡ることはありません